공통 · 모델 · 2026-09-27
Local과 Sparse Attention: 읽을 토큰 범위 줄이기
Sparse Attention의 한 종류인 Sliding Window Attention부터 시작해, 고정된 연결 패턴과 층을 통한 정보 전달을 살펴보고 읽는 범위와 KV 캐시 보관량을 구별합니다.
앞선 글에서는 KV를 저장하는 표현과 계산 순서를 바꿨습니다. 이번에는 각 Query가 읽는 토큰의 범위를 줄여 보겠습니다. 모든 과거 위치에 Attention을 적용하는 대신 일부 위치에만 적용하는 방식을 Sparse Attention이라고 합니다. 가까운 위치만 읽는 Sliding Window Attention(SWA)은 그중 한 종류입니다.
먼저 SWA가 읽을 위치를 어떻게 정하는지 살펴보고, 멀리 있는 일부 위치도 함께 읽는 패턴으로 확장하겠습니다. 이어 여러 층을 거쳐 정보가 전달되는 과정과, 읽는 위치를 줄였을 때 KV 캐시도 줄일 수 있는 조건을 살펴보겠습니다. 이번 편은 토큰의 내용과 관계없이 위치에 따라 연결 규칙이 정해지는 방식을 다룹니다.
가까운 위치만 읽는 SWA
토큰이 부터 까지 여덟 개 있고, 현재 을 처리한다고 하겠습니다. 한 Attention 층의 한 쿼리 헤드를 기준으로 보면, 일반적인 causal Attention은 부터 까지 여덟 위치의 Key와 점수를 계산하고 그 위치들의 Value를 가중합합니다. 여기서 causal은 미래 위치를 읽지 않는다는 뜻입니다. 현재 위치와 모든 과거 위치를 읽는 이 방식을 그림에서는 Full causal이라고 표시했습니다.
SWA는 여기에 거리 제한을 추가합니다. 이 글에서는 window 3을 현재 위치와 직전 두 위치, 총 세 위치로 정의하겠습니다. 따라서 에서는 ··만 읽습니다. 다음 을 처리할 때는 읽는 범위가 ··로 이동합니다. 이처럼 현재 위치를 따라 범위가 움직이기 때문에 sliding window라고 부릅니다.
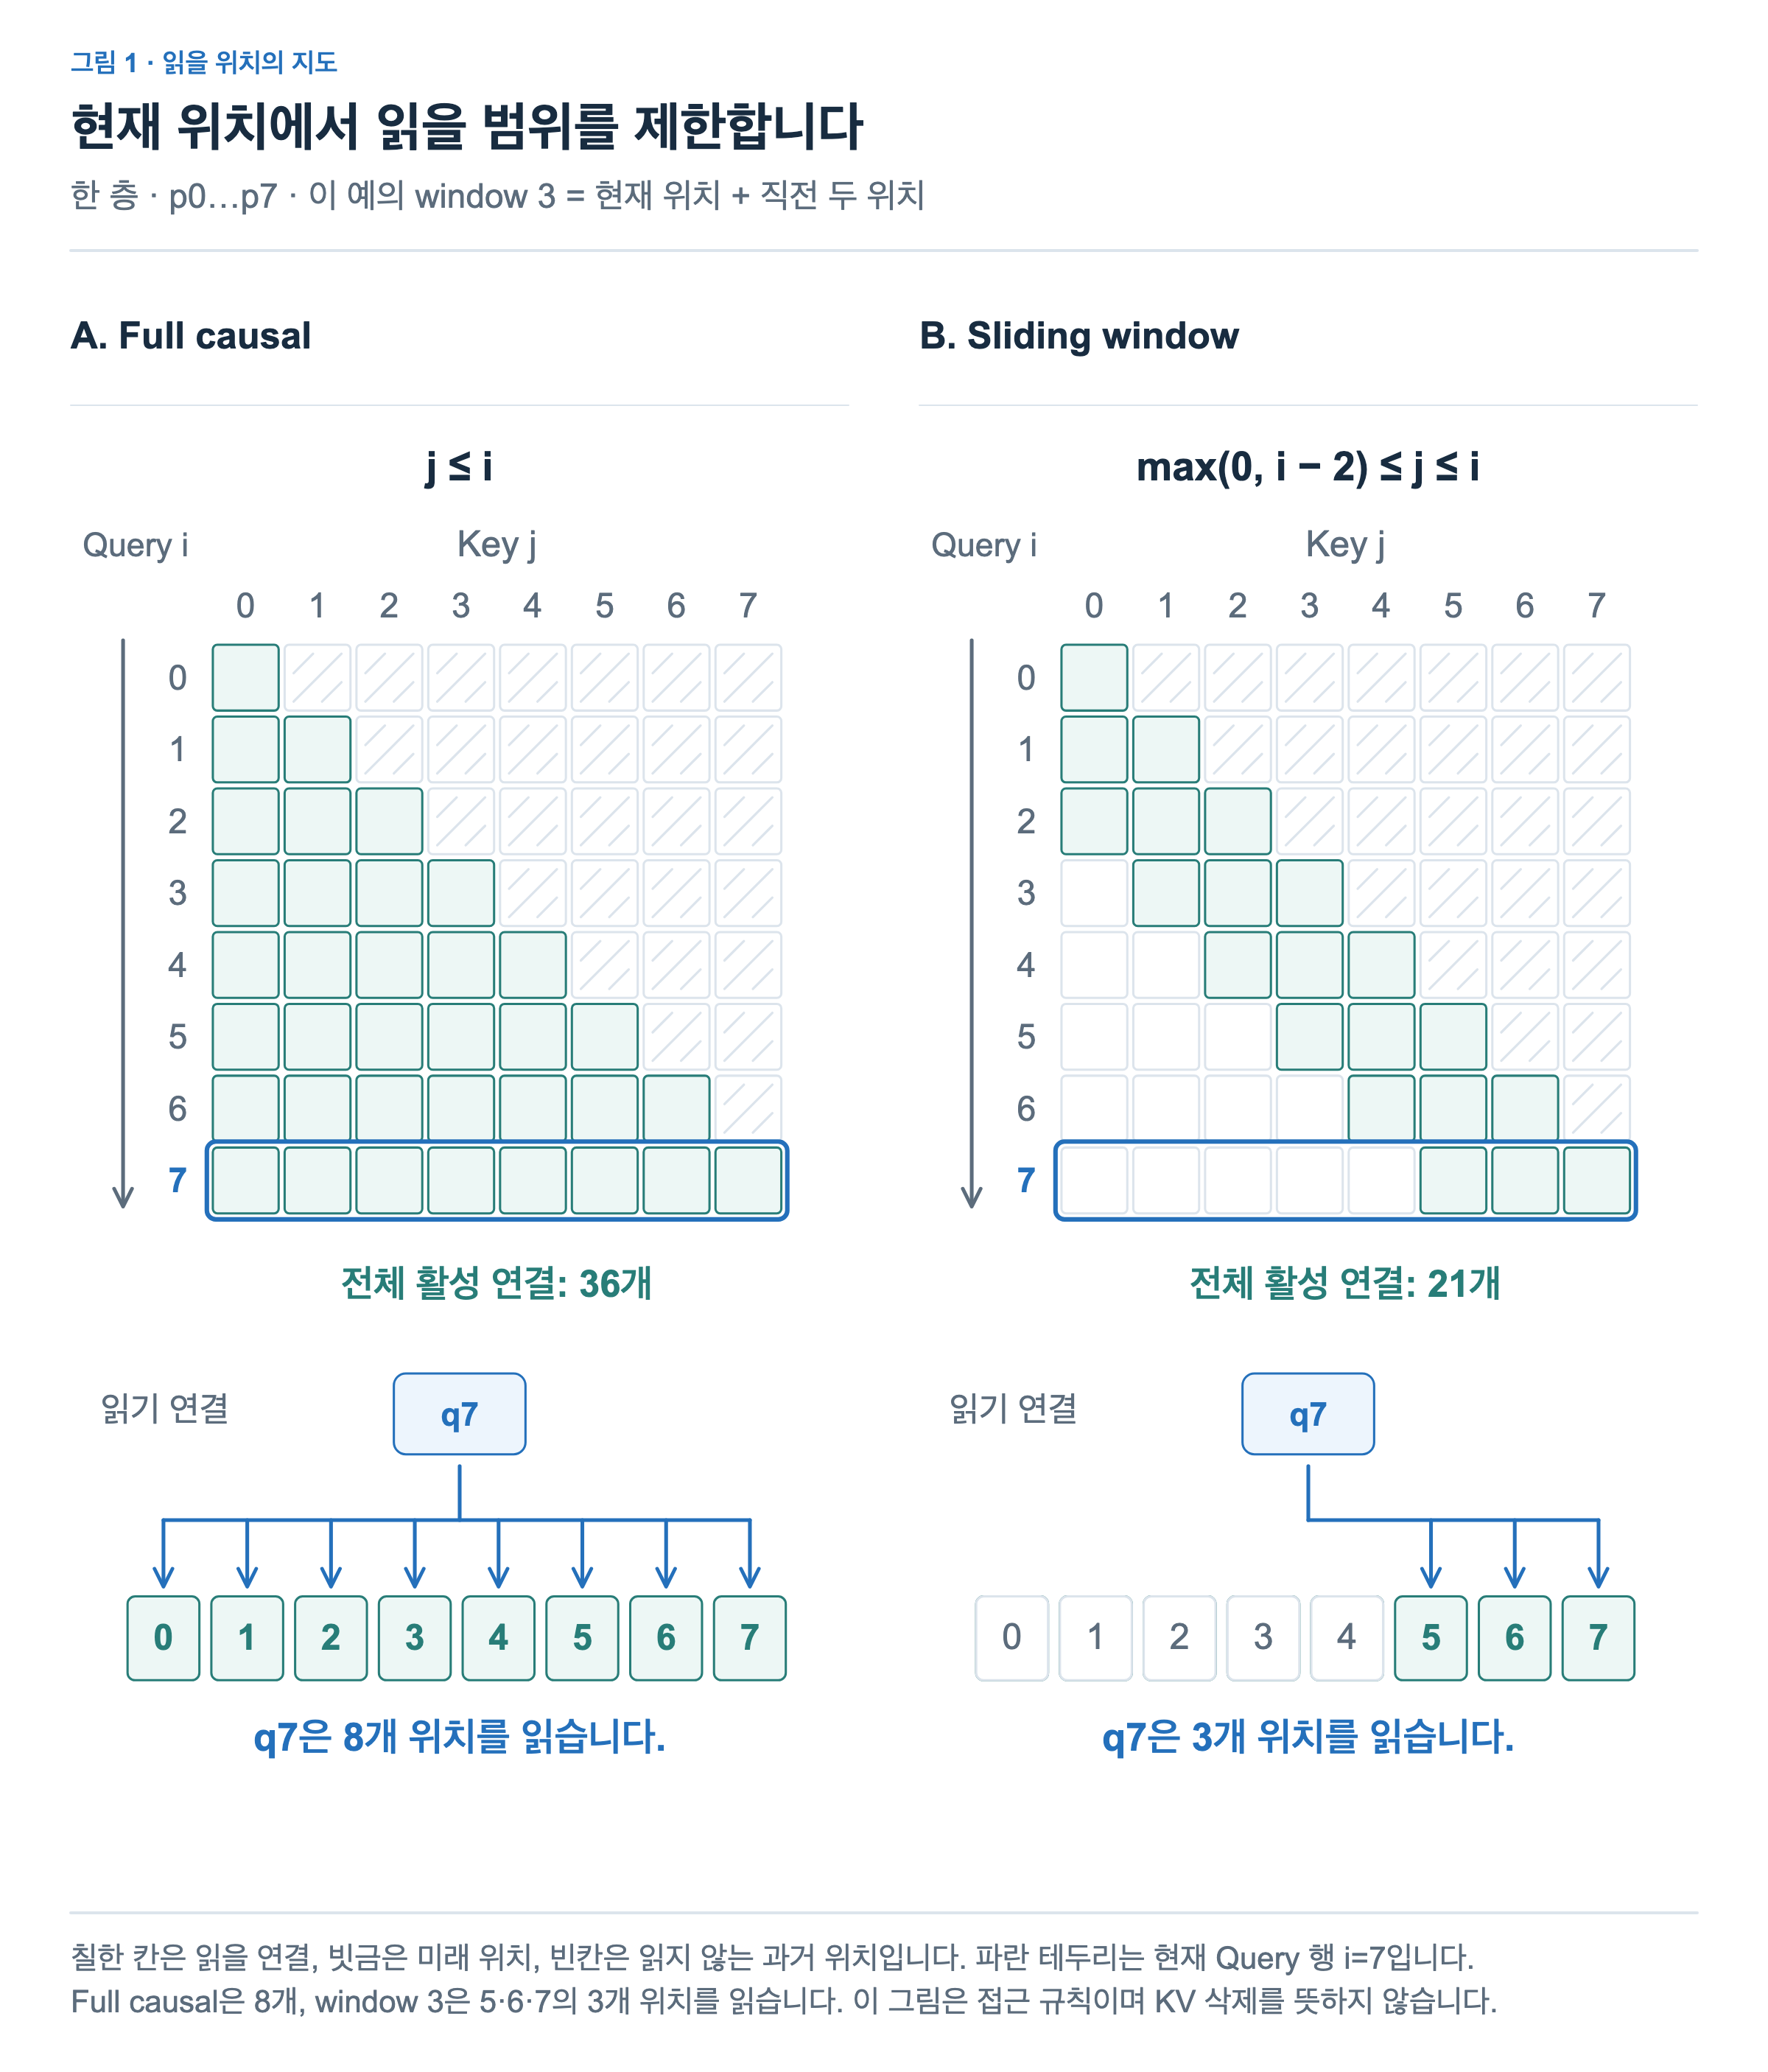
그림 1의 세로축은 Query의 토큰 위치, 가로축은 읽을 Key의 토큰 위치입니다. 헤드나 벡터 성분을 나타낸 축이 아닙니다. 한 행의 색칠된 칸은 그 Query가 읽는 위치를 뜻하며, 색의 진하기로 Attention 가중치를 표시한 것도 아닙니다. 파란 테두리의 마지막 행에서 Full causal은 여덟 칸, SWA는 세 칸을 읽습니다.
읽을 위치를 정한 뒤의 계산은 익숙한 Attention과 같습니다. 과 선택된 세 Key로 점수를 계산하고, 그 세 위치에 대해 softmax를 적용한 뒤 세 Value를 가중합합니다. 제외한 위치는 이 가중합에 참여하지 않습니다. 마스크로 표현한다면 제외할 위치의 점수에 softmax 전 음의 무한대를 적용해 가중치가 0이 되도록 합니다. 단순히 점수를 0으로 바꾸는 것은 softmax 이후에도 양의 가중치가 남으므로 다른 계산입니다.
여기서 고정된 것은 어느 위치와 연결할지에 대한 규칙입니다. 선택된 위치의 Attention 점수와 가중치는 Query와 Key의 내용에 따라 매번 달라집니다. 또한 SWA는 Full Attention의 결과를 그대로 유지하는 계산 재배치가 아닙니다. 읽을 정보를 제한하므로 출력도 달라질 수 있습니다.
그림의 전체 격자는 여덟 토큰을 처리할 때의 연결을 함께 보여 줍니다. Full causal은 1 + 2 + … + 8 = 36개, window 3은 1 + 2 + 3 + 3 + 3 + 3 + 3 + 3 = 21개입니다. 현재 하나의 8개 대 3개 비교와, 전체 여덟 토큰의 36개 대 21개 비교는 구별해야 합니다. 문맥이 길어져도 window가 일정하면 Query 하나가 읽는 위치 수는 일정하게 제한됩니다.
Mistral 7B 논문의 구조 설명은 SWA를 사용한 실제 모델의 예입니다. 논문이나 구현마다 window를 세는 경계가 다를 수 있으므로, 여기서는 그림과 일치하도록 현재 위치를 포함한 세 칸이라는 정의를 유지하겠습니다.
가까운 위치와 먼 위치를 함께 읽기
SWA에서는 현재 위치에서 충분히 멀어진 토큰을 직접 읽을 수 없습니다. 이를 보완하는 한 방법은 가까운 위치를 읽는 연결에 지정한 먼 위치를 읽는 연결을 추가하는 것입니다. Sparse Attention의 패턴이 반드시 하나의 연속된 window일 필요는 없습니다.
그림 2는 두 가지 규칙을 비교합니다. 왼쪽은 최근 세 위치에 첫 위치 을 추가하고, 오른쪽은 최근 세 위치에 ·처럼 네 칸 간격의 위치를 추가합니다. 두 그림 모두 특정 모델의 구조를 그대로 옮긴 것이 아니라, 연결 규칙의 차이를 보여 주는 교육용 예시입니다.
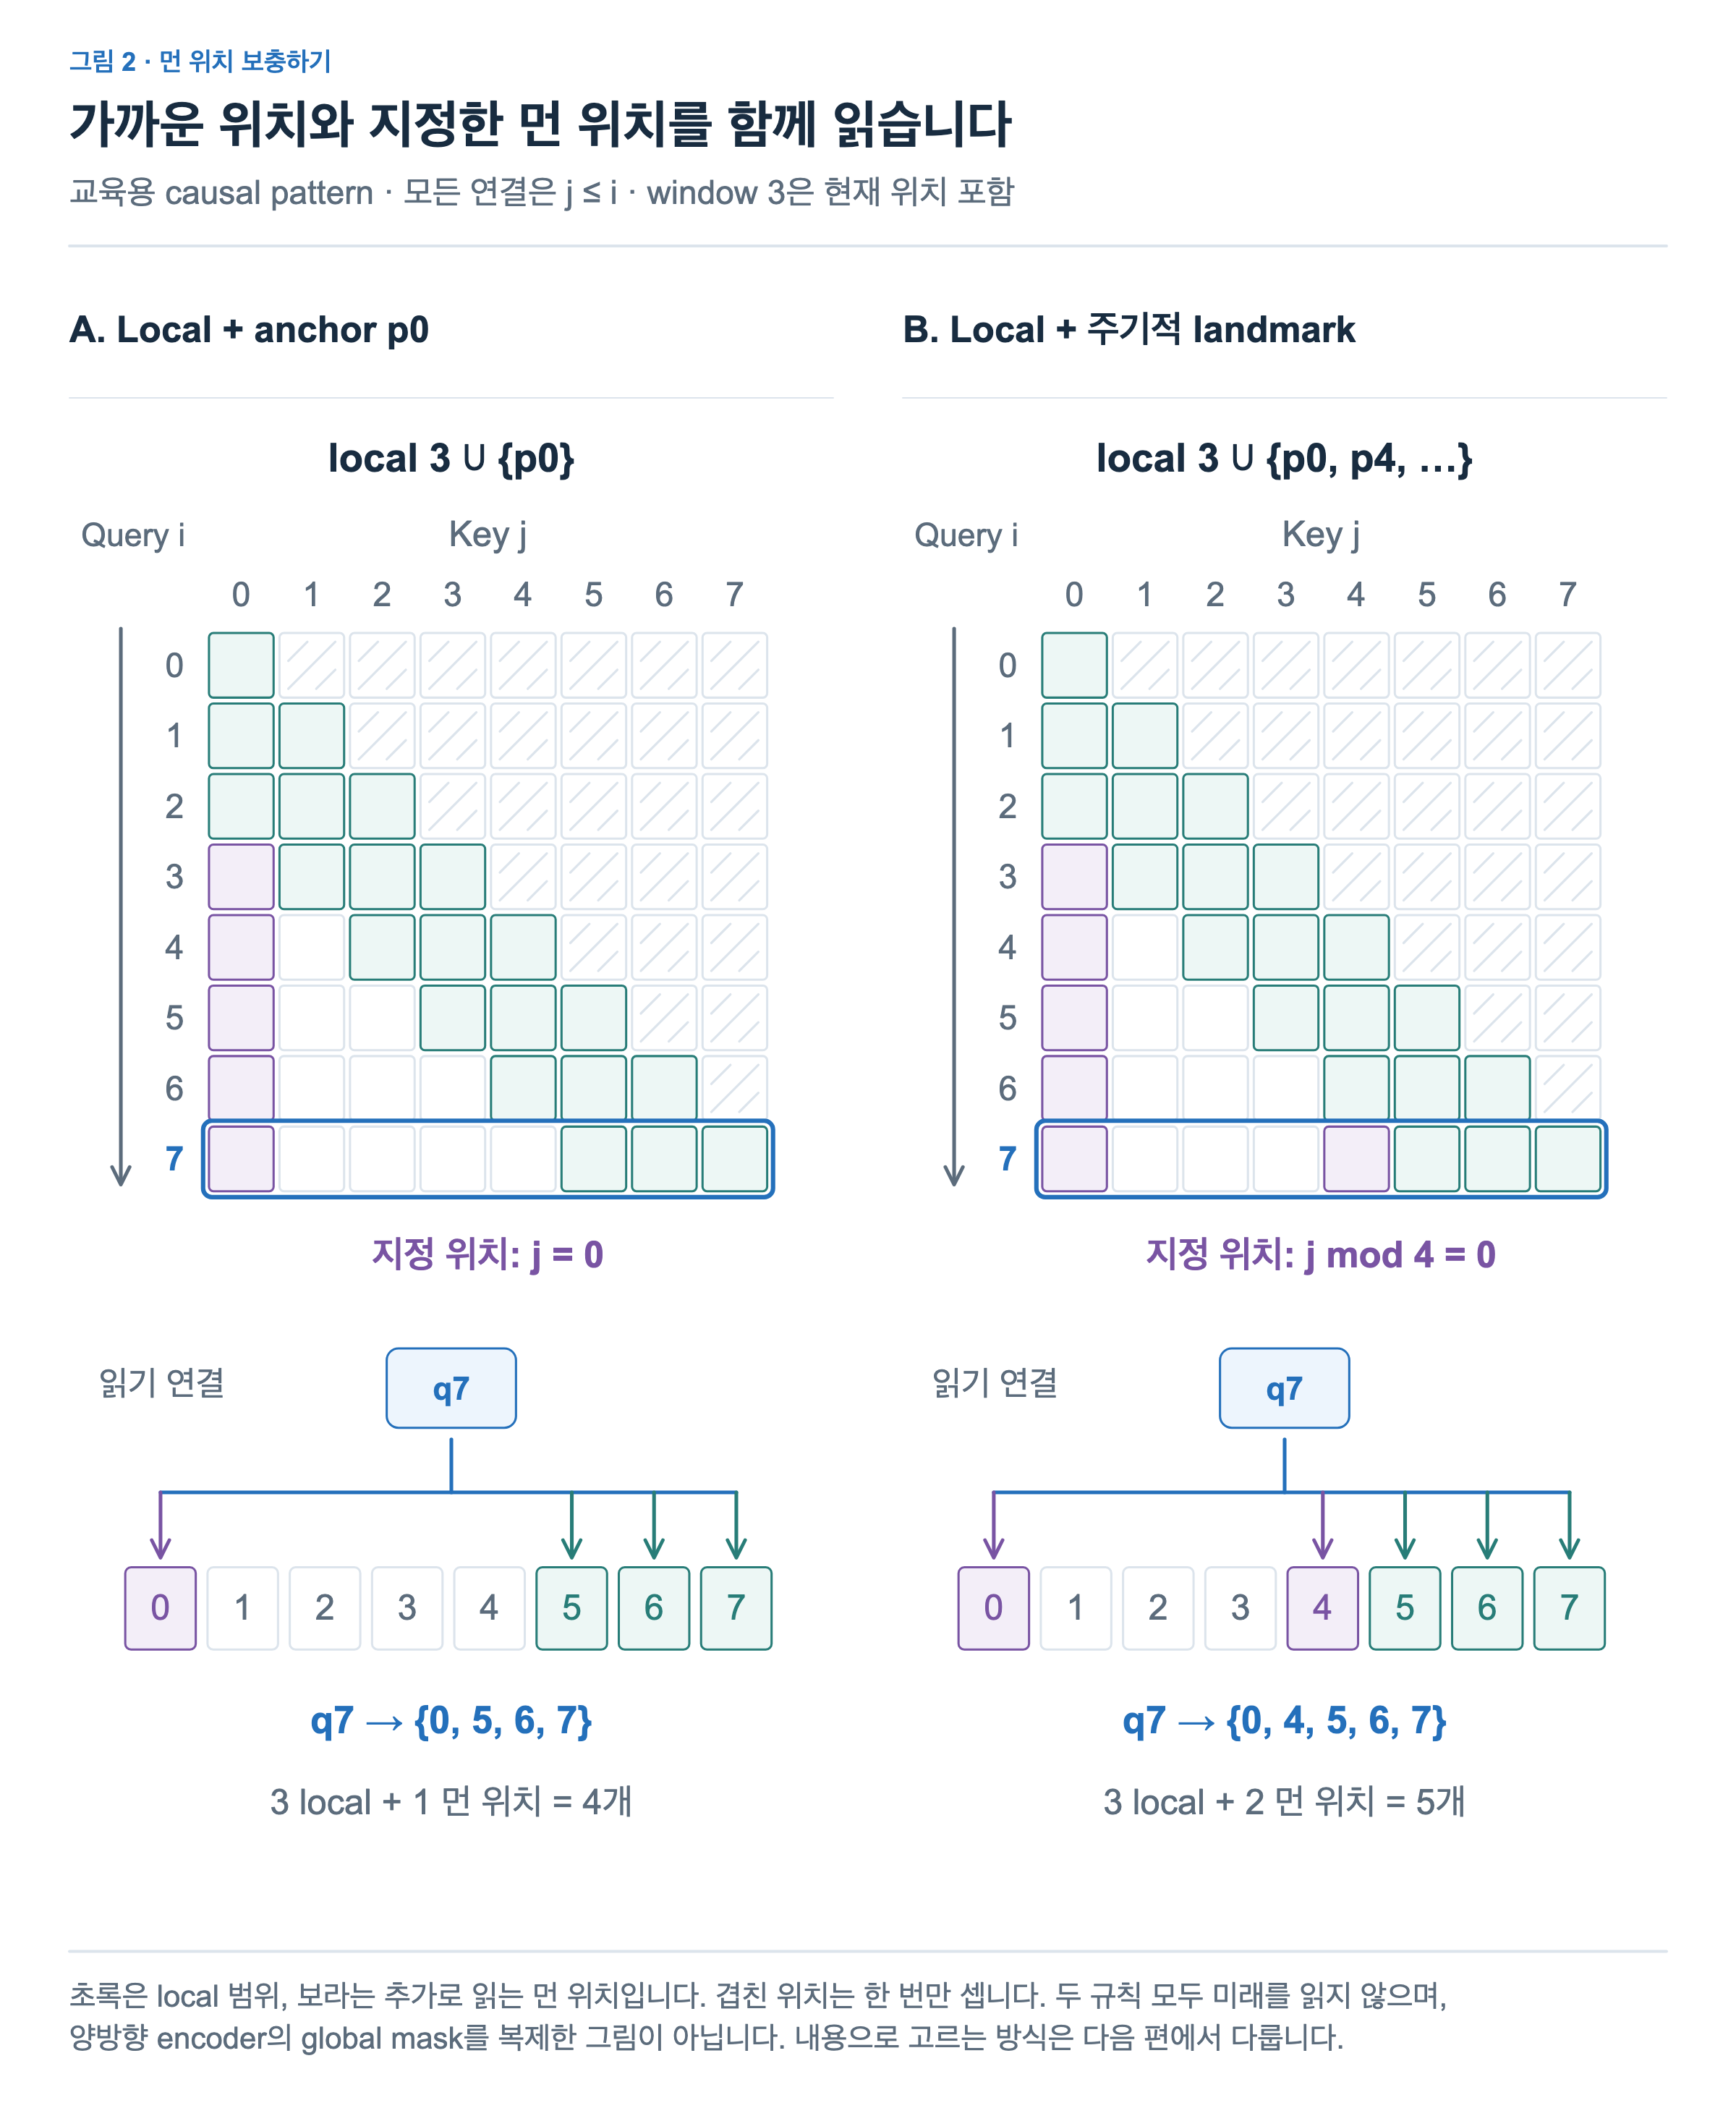
왼쪽에서 현재 은 ··과 함께 을 읽습니다. 그림의 anchor는 이렇게 계속 읽을 수 있도록 지정한 위치를 뜻합니다. 첫 위치의 정보에 직접 접근하는 연결은 유지되지만, 그 사이의 모든 위치까지 읽는 것은 아닙니다. 부터 는 여전히 선택되지 않습니다.
오른쪽의 landmark는 일정한 간격으로 지정한 위치를 뜻합니다. 이 읽는 위치는 ····, 총 다섯 개입니다. 를 처리할 때는 가 window와 지정 위치 양쪽에 속하지만 한 번만 읽습니다. 두 규칙 모두 미래 위치는 제외하므로, 에서 아직 미래인 를 읽는 연결은 생기지 않습니다.
첫 위치를 추가하는 방식은 window가 충분히 이동한 뒤에도 추가 위치가 하나뿐입니다. 반면 일정 간격의 위치를 모두 추가하는 방식은 문맥이 길어질수록 그 수가 늘어납니다. 따라서 고정된 규칙을 쓴다고 Query 하나가 읽는 위치 수도 반드시 일정한 것은 아닙니다. 지정 간격이나 보관할 위치 수에 따라 계산량이 달라집니다.
Longformer도 가까운 범위의 연결과 global 연결을 결합하는 구조를 제시합니다. 다만 그림 2는 미래를 읽지 않는 causal 예시이며, Longformer의 양방향 연결을 재현한 그림은 아닙니다. 여기서 익힐 핵심은 가까운 위치와 일부 먼 위치의 연결을 함께 설계할 수 있다는 점입니다.
여러 층을 거쳐 전달되는 정보
먼 위치를 직접 읽는 연결이 없는 순수 SWA에서는 window 밖의 정보가 전혀 전달되지 않을까요? 한 층에서 직접 읽는 범위와 여러 층을 거친 뒤 영향을 받을 수 있는 입력 범위는 다릅니다. 이전 층의 벡터에는 그 층에서 읽은 다른 위치의 정보도 반영되어 있기 때문입니다.
다시 모든 Attention 층이 window 3을 사용하는 예시로 돌아가겠습니다. 그림 3의 가로축은 토큰 위치이고, 세로축은 모델의 층 깊이입니다. L0은 입력, L1부터 L3는 각 층을 통과한 표현을 나타냅니다. 위로 이동하는 것은 새로운 토큰을 생성하는 시간이 아니라, 모델의 다음 층으로 진행하는 과정입니다.
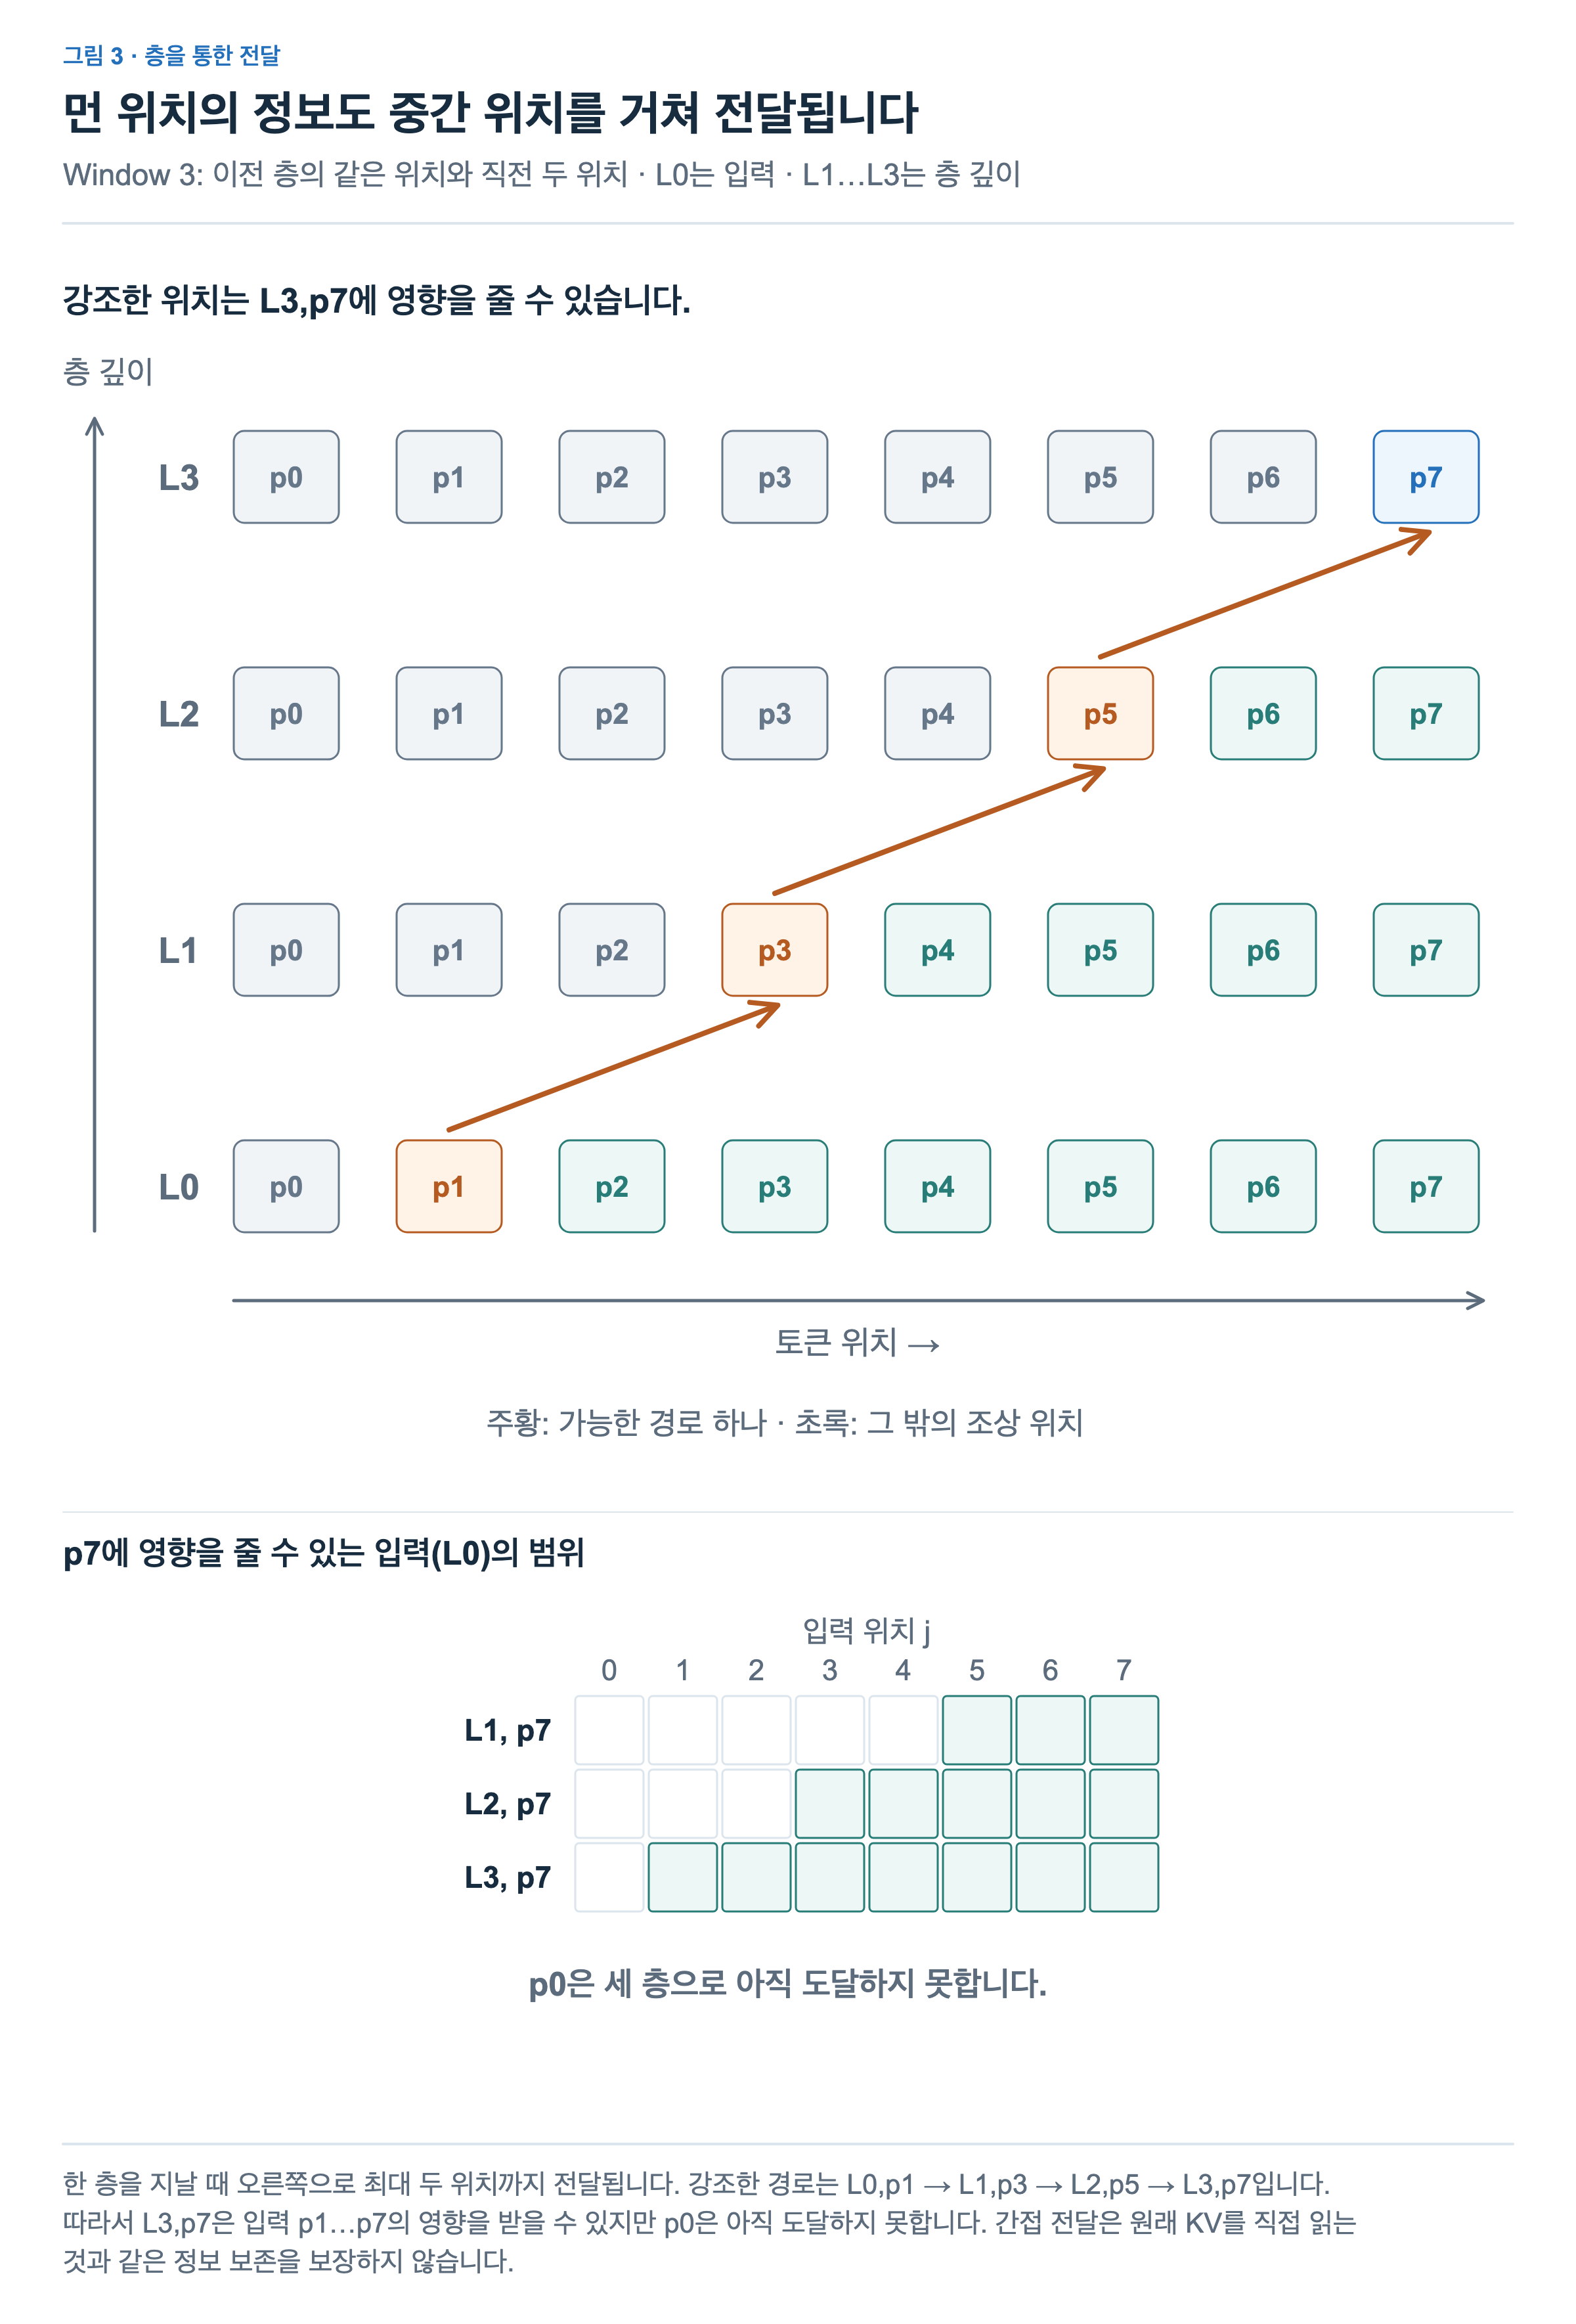
L1의 은 L0의 ··을 읽습니다. L2의 도 바로 아래 층에서는 ··만 읽지만, L1의 에는 이미 L0의 ·· 정보가 반영될 수 있습니다. 이 경로까지 따라가면 L2의 에 영향을 줄 수 있는 입력 범위는 부터 까지 넓어집니다. L3에서는 부터 까지 넓어집니다.
주황색 화살표는 그중 가장 먼 위치에서 오는 경로 하나를 보여 줍니다. 입력 → 첫 번째 층의 → 두 번째 층의 → 세 번째 층의 입니다. 한 층마다 최대 두 위치 앞으로 전달될 수 있으므로, 세 층을 거치면 최대 여섯 위치 떨어진 입력까지 연결됩니다. 은 과 일곱 위치 떨어져 있어 이 예시의 세 층으로는 아직 도달하지 못합니다.
이렇게 연결된 범위를 흔히 수용 영역(receptive field)이라고 합니다. 하지만 경로가 존재한다는 사실이 그 안의 모든 정보가 온전히 보존된다는 뜻은 아닙니다. 여러 위치의 정보가 중간 벡터에 섞이고 변환되므로, 현재 Query가 먼 위치의 원래 KV를 직접 읽는 것과는 다릅니다. 층을 쌓아 영향 범위가 넓어지더라도 Full Attention과 같은 출력을 보장하지는 않습니다.
읽는 범위와 캐시 보관량
읽는 위치를 줄였다면 KV 캐시에서도 나머지를 지워도 될까요? 판단 기준은 지금 읽었는지가 아니라 이후에도 다시 읽을 수 있는지입니다.
그림 4의 왼쪽은 window 밖의 위치를 다시 읽지 않는 층입니다. 을 처리할 때 필요한 KV는 ··이고, 을 처리할 때는 ··입니다. 이 층에서는 가 이후의 window에 다시 들어오지 않으므로, 처리가 끝난 뒤 그 KV를 버릴 수 있습니다.
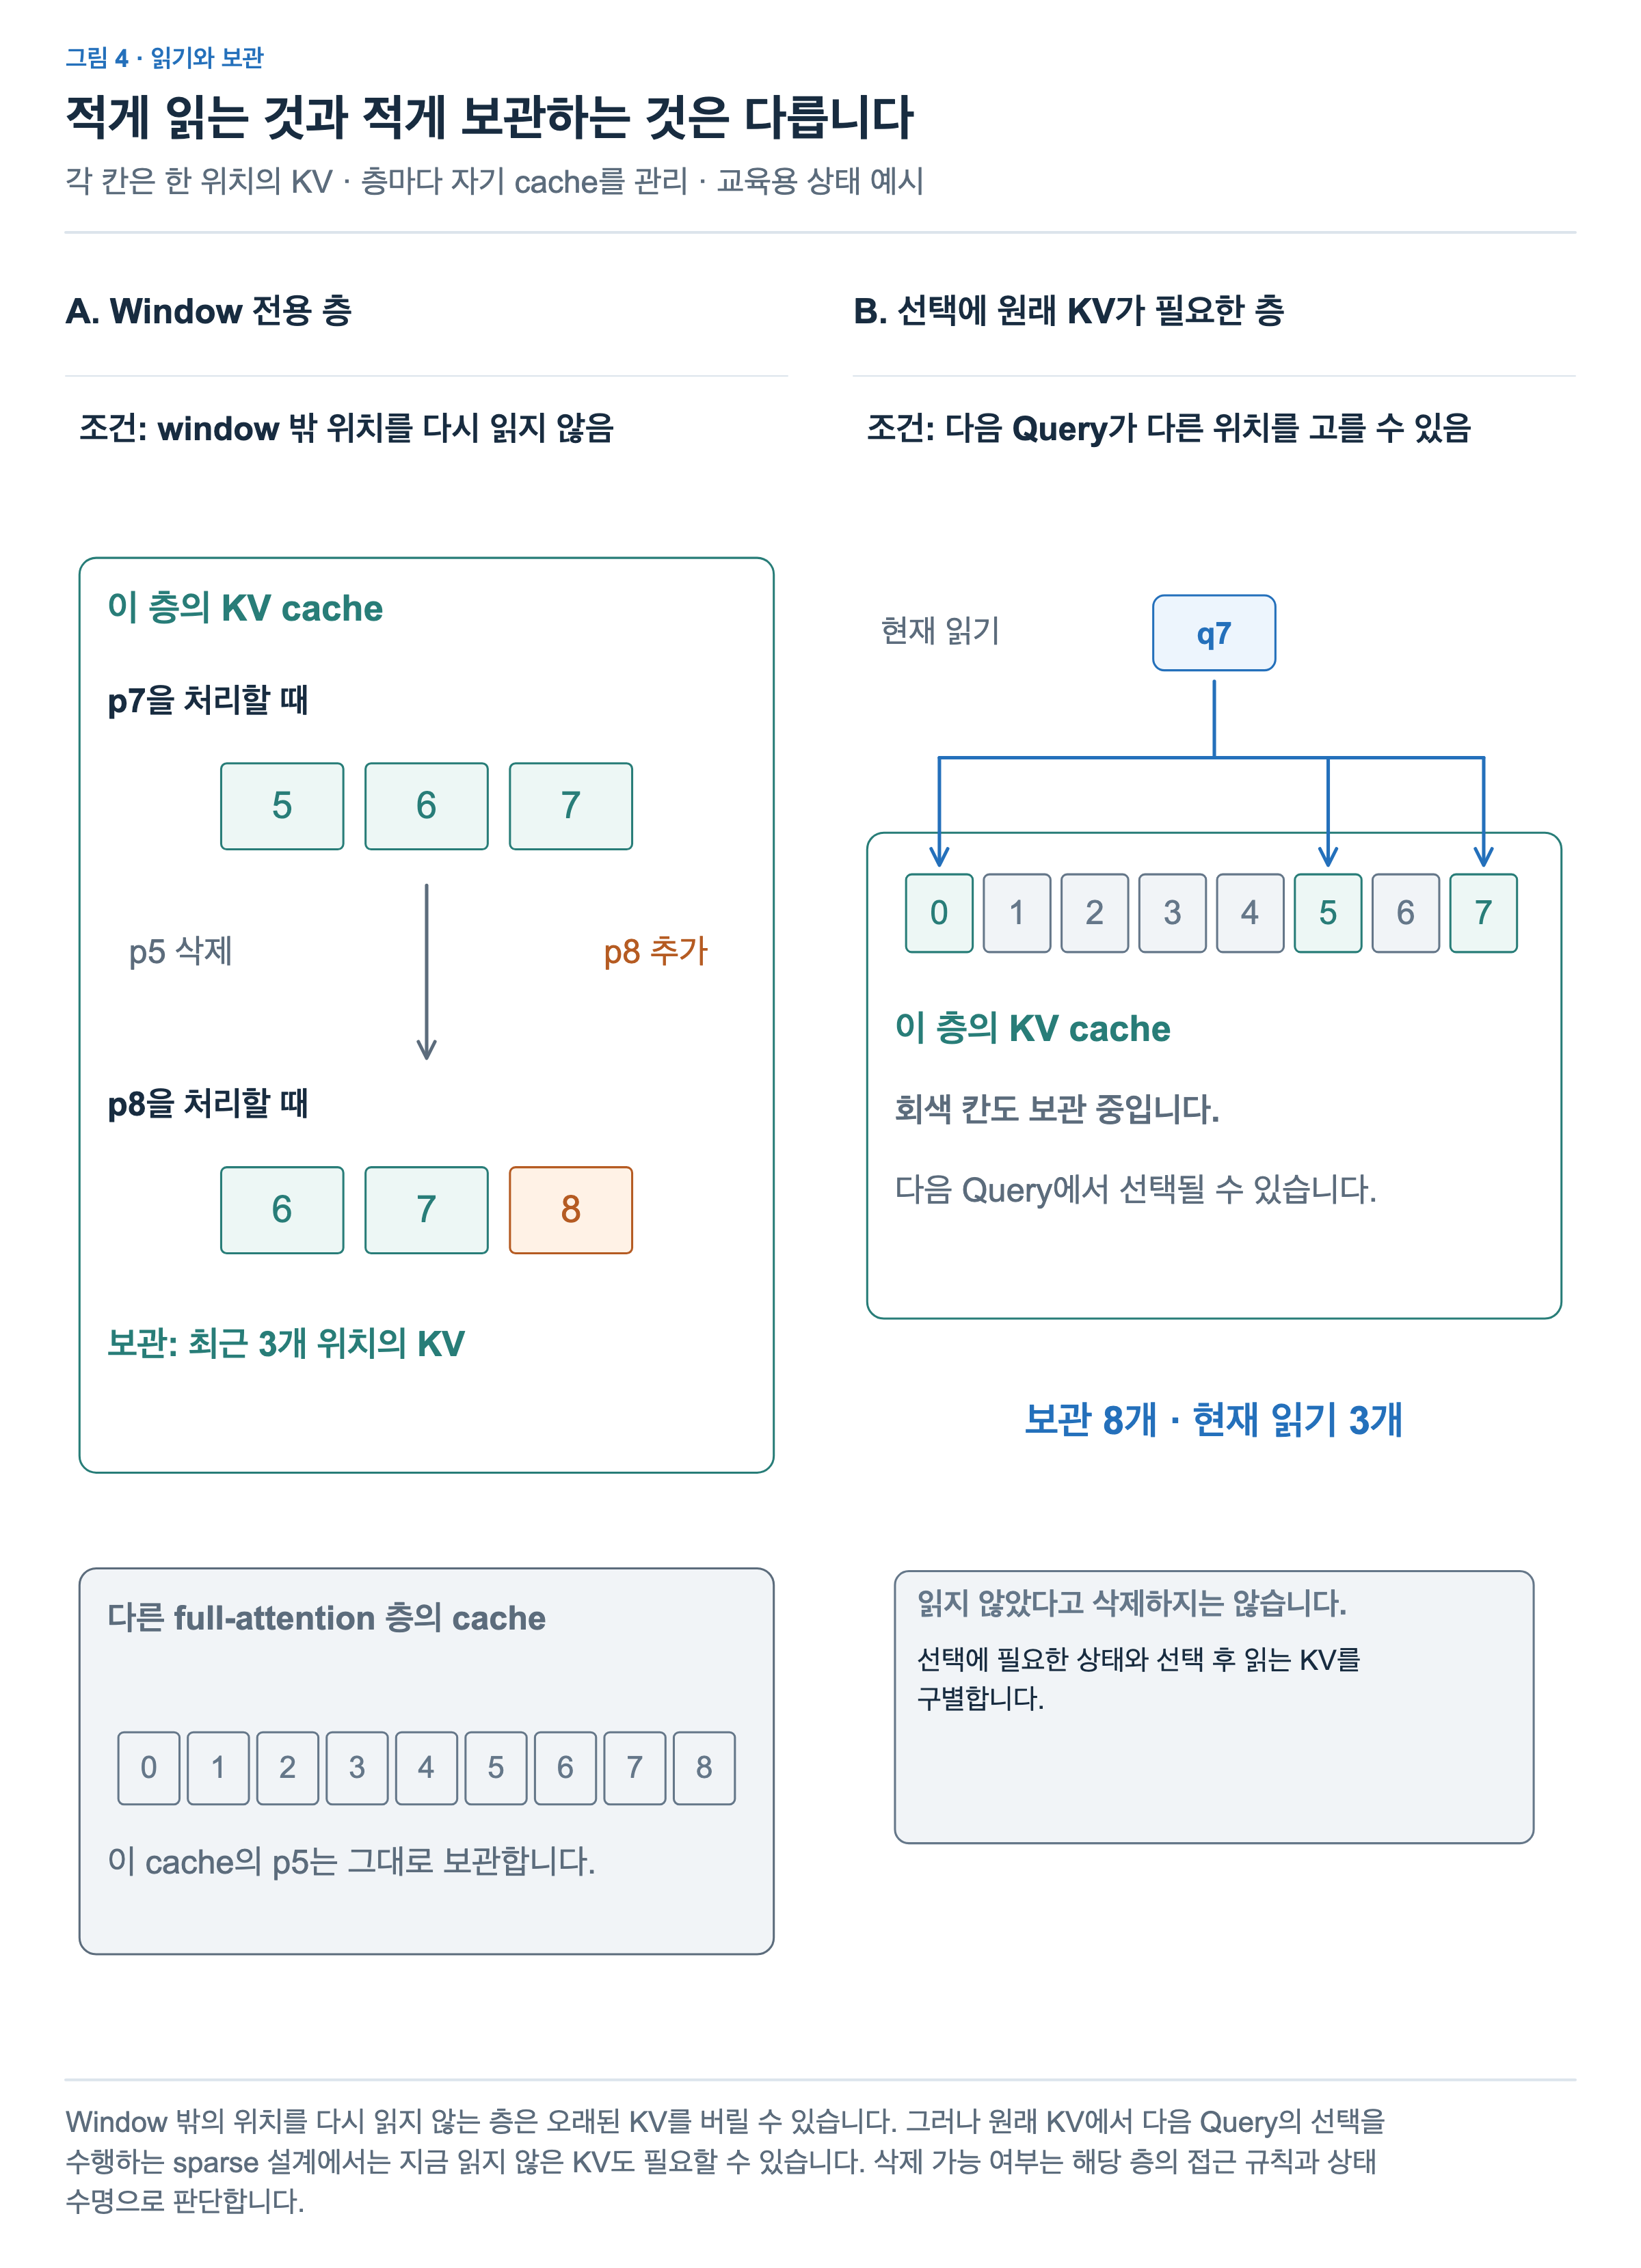
새 위치의 KV를 추가하면서 오래된 KV를 교체하면 이 층의 캐시는 최근 세 위치를 담는 크기로 유지할 수 있습니다. 실제 메모리에서는 기존 칸을 순환하며 덮어쓰는 방식으로 구현할 수 있습니다. 다만 그림은 토큰을 하나씩 처리할 때의 상태를 보여 주며, 여러 토큰을 묶어 처리하는 중간 버퍼까지 나타낸 것은 아닙니다.
캐시는 층마다 구별해야 합니다. 같은 모델의 다른 층이 Full Attention을 사용한다면, 그 층은 미래 Query가 를 다시 읽을 수 있으므로 자신의 KV를 계속 보관해야 합니다. SWA 층에서 지울 수 있다는 이유로 다른 층의 KV까지 함께 지우지는 않습니다.
오른쪽은 현재 Query가 일부 위치만 선택하지만, 다음 Query가 다른 위치를 선택할 수 있는 경우입니다. 지금 은 ··만 읽더라도, 선택에 원래 KV가 필요한 이 예시에서는 나머지 위치도 보관합니다. 읽는 위치는 세 개지만 캐시에 있는 위치는 여덟 개입니다. 내용에 따라 위치를 선택하는 구체적인 과정은 다음 편에서 살펴보겠습니다.
그림 2의 고정 패턴도 규칙에 맞춰 보관해야 합니다. 첫 위치를 항상 읽는다면 의 KV는 window 밖으로 나가도 남겨야 하고, 일정 간격의 위치를 계속 읽는다면 해당 위치들도 남겨야 합니다. Sparse Attention이라는 이름만으로 캐시 크기를 정할 수는 없습니다.
연결을 줄였을 때 달라지는 것
이번 편에서는 KV 벡터 자체의 크기 대신, Query가 읽는 위치를 바꿨습니다. SWA는 가까운 위치로 범위를 제한하고, 다른 고정 패턴은 일부 먼 위치를 추가합니다. 여러 층을 거치면 한 층의 window보다 넓은 입력 범위에서 정보를 받을 수 있지만, 직접 읽는 연결을 모두 유지하는 것과 같지는 않습니다.
선택된 연결만 실제로 계산하는 구현에서는 Attention 점수와 Value 가중합에 필요한 연산을 줄일 수 있습니다. 반대로 전체 점수를 모두 계산한 뒤 마스크만 적용한다면 연결이 드물다는 이유만으로 그 계산을 생략한 것은 아닙니다. 실행 속도는 선택한 패턴을 커널이 얼마나 효율적으로 처리하는지에도 달려 있습니다.
따라서 구조를 읽을 때는 어떤 위치를 읽는지, 그 위치 수가 문맥 길이에 따라 어떻게 늘어나는지, 나중에 다시 읽을 KV를 얼마나 보관해야 하는지를 함께 확인해야 합니다. 다음 편에서는 위치를 미리 지정하는 대신, 현재 Query와 토큰의 내용을 바탕으로 Indexer가 읽을 위치를 고르는 방식으로 넘어가겠습니다.