공통 · 모델 · 2026-09-27
MLA의 저장 구조: KV를 작은 잠재 벡터로 표현하기
공동 잠재 벡터로 헤드별 Key·Value를 표현하는 원리와 별도로 저장하는 위치용 Key를 살펴보고, 헤드 간 공유 범위와 KV 캐시 저장량을 계산합니다.
앞선 글에서는 여러 쿼리 헤드가 KV를 공유해 캐시 저장량을 줄이는 MQA와 GQA를 살펴봤습니다. 이번에는 저장하는 표현 자체를 바꿔 보겠습니다. 헤드별 Key와 Value를 모두 보관하는 대신, 이들을 만드는 데 필요한 작은 벡터를 저장할 수 있을까요?
MLA(Multi-head Latent Attention)는 여러 헤드의 Key와 Value를 하나의 작은 잠재 벡터에서 만들도록 학습하는 구조입니다. 잠재 벡터는 입력을 더 적은 성분으로 나타낸 중간 표현입니다. 저장할 때는 이 작은 표현을 보관하고, 헤드마다 서로 다른 투영을 사용해 필요한 표현을 얻습니다.
먼저 잠재 벡터 하나에서 헤드별 K·V가 어떻게 나오는지 살펴보겠습니다. 이어 RoPE를 위한 위치용 Key를 별도 경로로 만들고 저장하는 이유를 설명하겠습니다. 두 경로를 합쳐 무엇이 헤드마다 달라지고 무엇이 공유되는지 확인한 뒤, 토큰 수에 따른 캐시 저장량을 계산하겠습니다. 이번 편은 Key·Value의 표현과 저장 구조에 집중합니다. Query를 만드는 과정과 Attention 점수 계산은 다음 편에서 다룹니다.
작은 벡터에서 헤드별 K·V 만들기
한 층에서 현재 위치 의 입력을 처리한다고 하겠습니다. 그림의 부터 까지 블록 하나는 각 위치의 입력 벡터 전체입니다. 이번 예시에서는 입력 차원을 8, 잠재 벡터 차원을 3, 헤드 수를 2로 두겠습니다. 각 헤드의 content Key와 Value는 두 성분씩 사용합니다. 앞선 글의 네 헤드 예시와 달리, 이번에는 두 헤드로 줄여 잠재 벡터와 투영의 관계를 살펴봅니다. 모든 차원과 숫자는 교육용입니다.

현재 위치의 입력 벡터를 이라고 쓰면 크기는 1×8입니다. 여기에 8×3 가중치 행렬 를 곱해 1×3 잠재 벡터 를 만듭니다. 그림에서는 그 결과를 [1, 2, 3]이라고 가정했습니다. 가중치는 학습되는 값이며, D는 차원을 줄이는 down-projection을 구별하기 위한 표기입니다.
의 하첨자 3은 토큰 위치입니다. 잠재 벡터의 세 번째 성분이나 헤드 3을 뜻하지 않습니다. 반면 아래쪽 과 의 하첨자 1은 헤드 번호이며, 위첨자 K와 V는 어느 표현을 만드는 투영인지를 구별합니다. 현재 위치가 고정된 그림에서는 헤드별 출력에 위치 하첨자를 생략했습니다.
두 헤드는 같은 를 사용하지만 서로 다른 가중치로 투영합니다. 예를 들어 헤드 1의 Key 투영 은 그림의 3×2 행렬입니다. [1, 2, 3]에 이 행렬을 곱하면 첫 출력은 1×1 + 2×0 + 3×0 = 1, 두 번째 출력은 1×0 + 2×1 + 3×0 = 2가 되어 [1, 2]를 얻습니다.
헤드 1의 Value 투영 은 첫 번째 출력에 잠재 벡터의 첫 성분과 세 번째 성분을 함께 반영합니다. 그래서 [1 + 3, 2] = [4, 2]가 됩니다. 헤드 2에서는 다른 투영을 사용해 Key [2, 3]과 Value [1, 5]를 얻습니다. 잠재 벡터를 공유해도 헤드별 K·V가 같아지는 것은 아닙니다.
그림의 , 는 전체 Key up-projection에서 각 헤드에 해당하는 출력 부분이고, Value 투영도 같은 방식으로 나눠 볼 수 있습니다. U는 잠재 표현을 여러 헤드의 표현으로 펼치는 up-projection을 뜻합니다. 그림에서 헤드별로 구분했다고 실제 구현에서도 행렬 곱을 반드시 따로 실행해야 하는 것은 아닙니다. 이 구성은 DeepSeek-V2 논문의 공동 KV 압축을 작은 행벡터 예시로 나타낸 것입니다. 논문의 열벡터 표기와는 가중치 행렬의 방향이 반대입니다.
여기서 중요한 것은 작은 공동 표현을 거치도록 모델을 학습한다는 점입니다. 임의의 기존 모델에서 만든 K·V를 나중에 세 숫자로 바꾸고 언제나 원래 값으로 복원할 수 있다는 뜻이 아닙니다. 입력에서 잠재 벡터를 만드는 가중치와 잠재 벡터에서 K·V를 만드는 가중치가 함께 학습됩니다. 작은 잠재 차원은 저장량을 줄이는 동시에, 여러 헤드가 표현할 수 있는 K·V 사이에 제약을 줍니다.
위치용 Key를 따로 저장하기
앞 절의 Key에는 위첨자 C가 붙어 있습니다. 이는 content 부분, 즉 별도의 RoPE 경로와 구별되는 Key 부분을 뜻합니다. RoPE를 사용하는 Attention에서는 Query와 Key에 위치에 따른 회전을 적용해 두 위치의 관계가 점수에 반영되도록 합니다. MLA에서도 이 역할이 필요합니다.
MLA는 content Key를 만드는 경로와 별도로 위치용 Key를 만듭니다. 그림 2에서는 같은 의 입력을 두 경로로 보내고, 각 경로의 결과를 캐시의 새 행에 저장합니다.
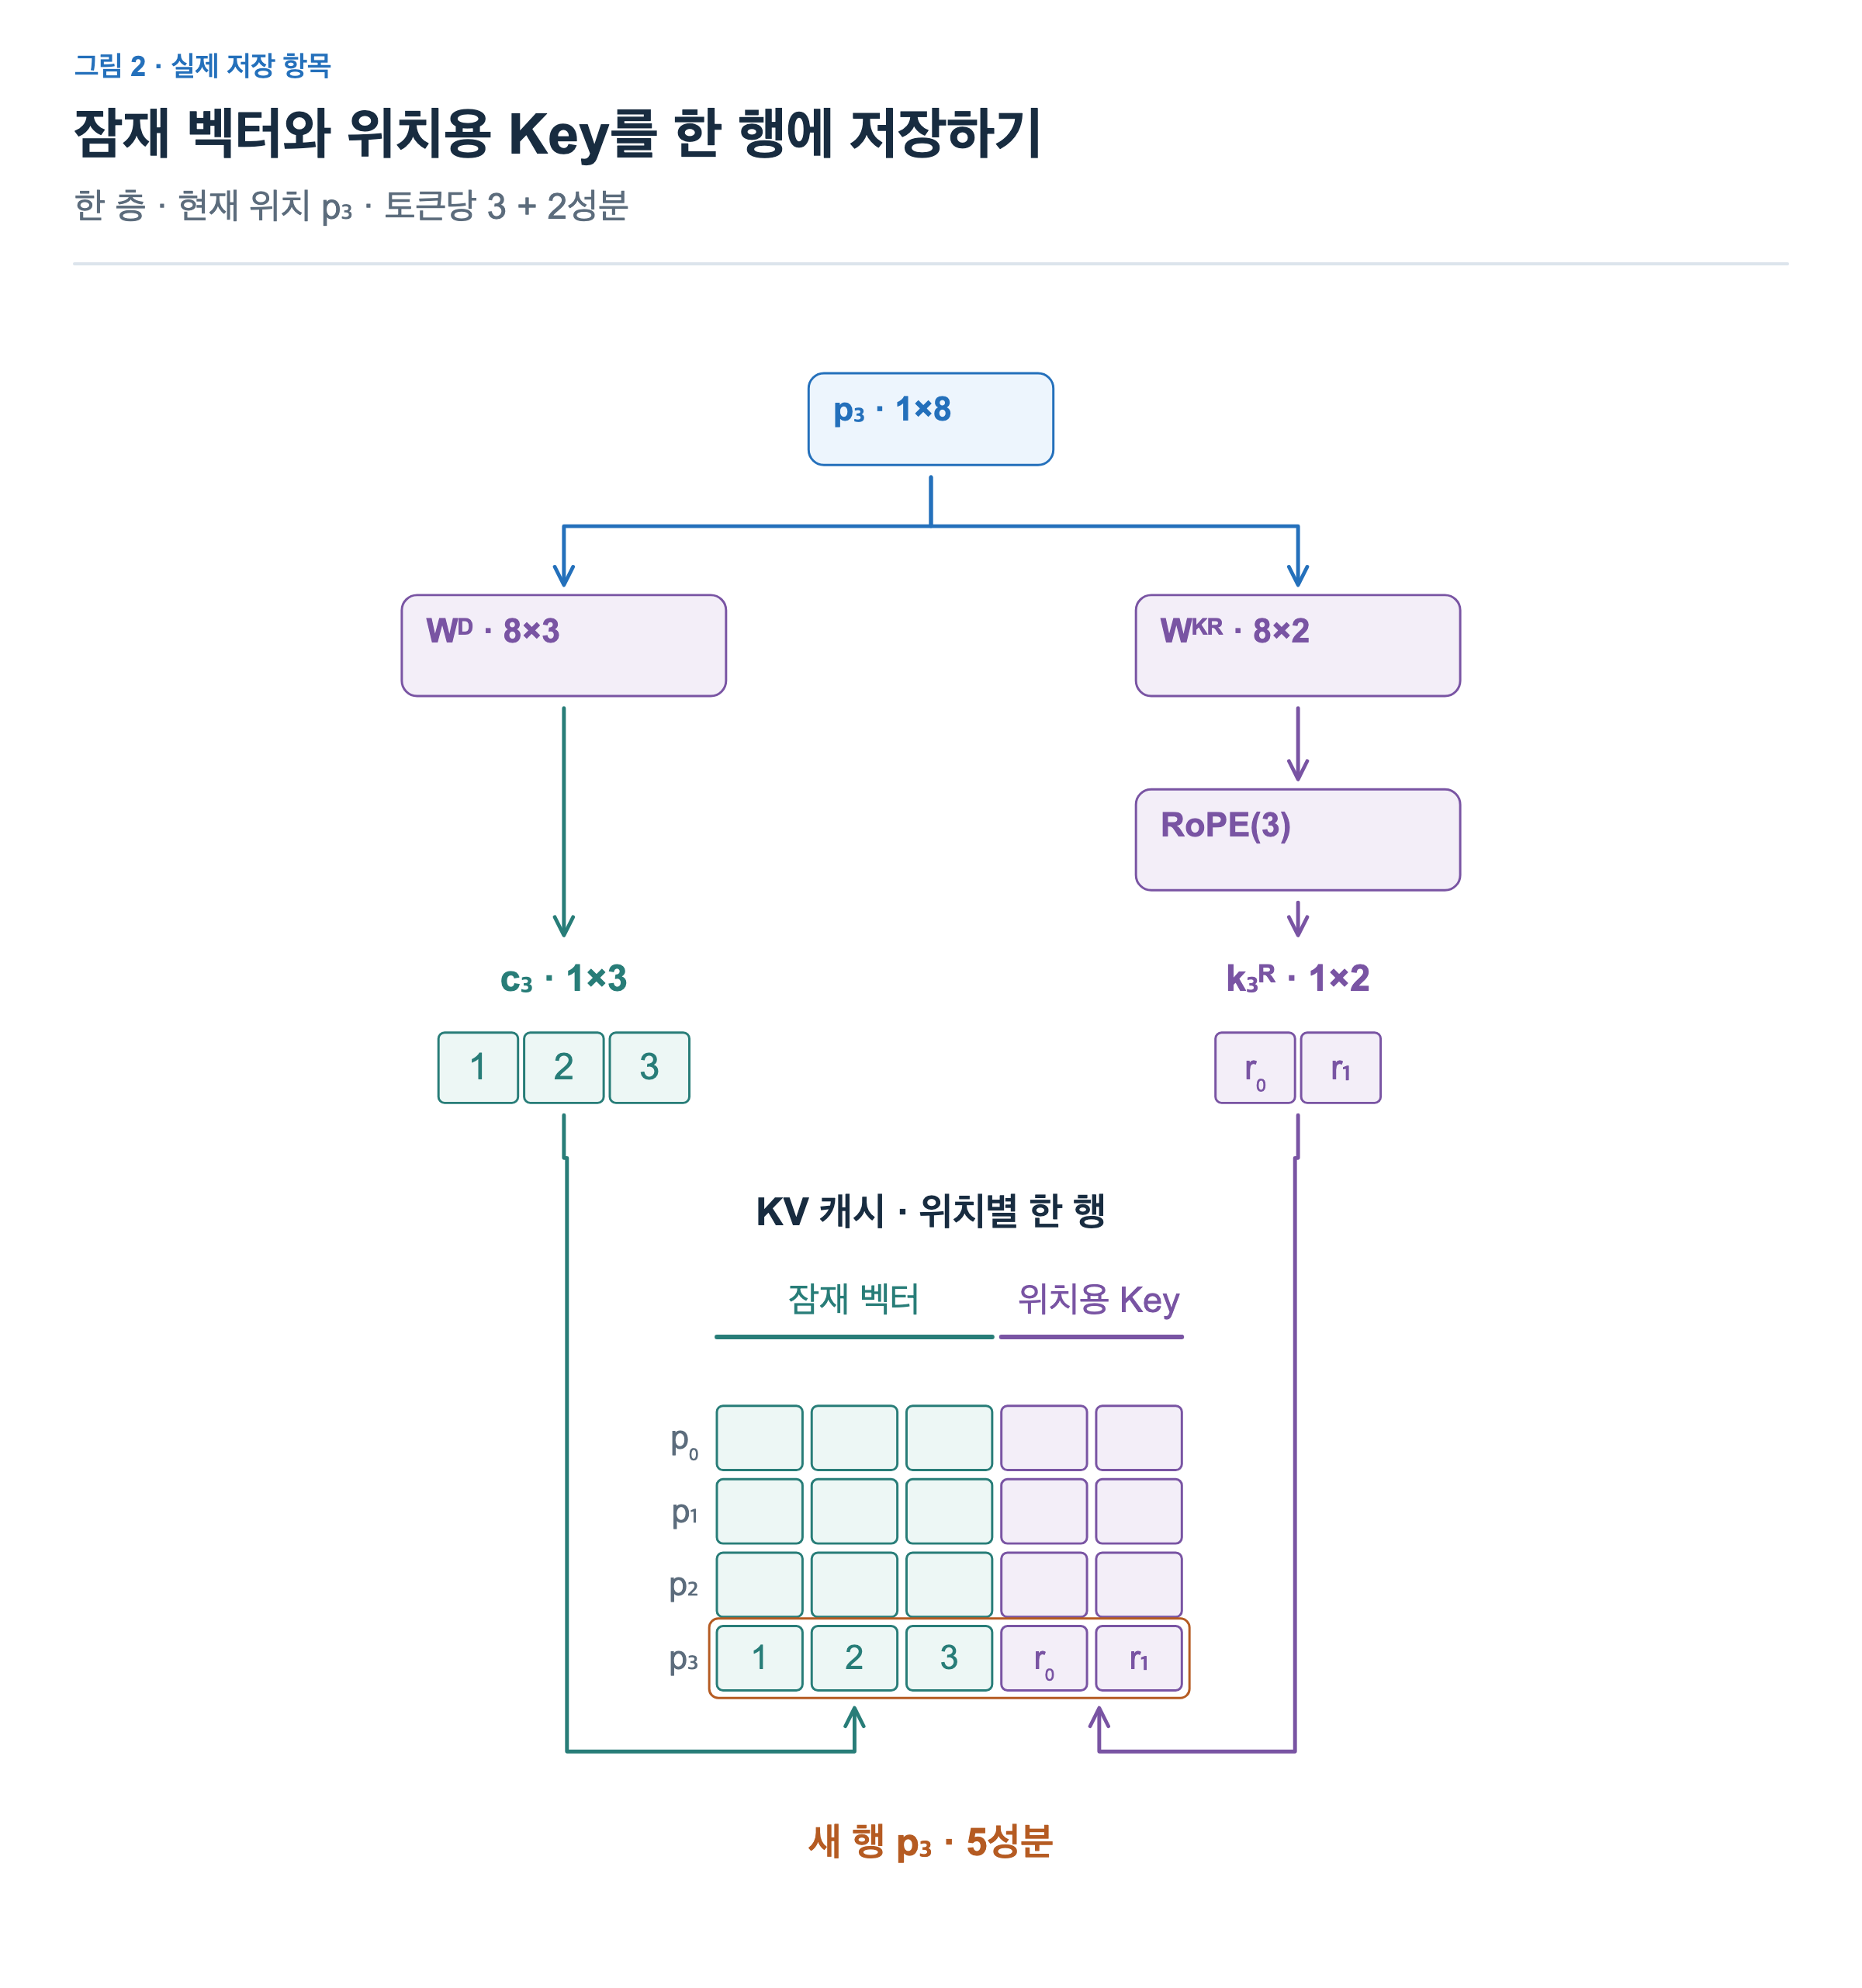
왼쪽 경로는 앞에서 본 를 거쳐 = [1, 2, 3]을 만듭니다. 오른쪽 경로에서는 입력에 별도의 8×2 투영 를 적용한 뒤 현재 위치 3에 해당하는 RoPE를 적용합니다. 그 결과가 두 성분의 위치용 Key 입니다. 위첨자 R은 RoPE 경로를 구별합니다. 그림의 와 은 이 벡터의 두 성분을 나타내는 기호이며, 두 토큰 위치를 뜻하지 않습니다.
위치용 Key는 토큰 위치마다 하나를 만들고, 같은 층의 모든 헤드가 공유합니다. 헤드 1과 헤드 2를 위해 별도의 를 두 개 저장하지 않습니다. 반면 다른 위치 에는 그 위치의 입력과 회전으로 만든 별도의 위치용 Key가 필요합니다. 공유의 기준은 헤드이며, 여러 토큰 위치를 하나로 합치는 것은 아닙니다. DeepSeek-V2 논문 §2.1.3
따라서 현재 위치에서 저장할 값은 잠재 벡터 3성분과 위치용 Key 2성분, 합쳐서 다섯 성분입니다. 앞선 부터 까지의 행은 그대로 두고, 의 [1, 2, 3, , ]을 새 행에 추가합니다. 그림의 다섯 칸은 두 저장 대상을 한 행으로 묶어 보여 주는 표현이며, 실제 메모리에서도 반드시 한 배열에 연속 배치해야 한다는 뜻은 아닙니다.
위치 경로를 분리하는 이유는 저장한 작은 표현으로 효율적으로 계산하기 위해서입니다. content Key에 위치별 RoPE 회전을 직접 끼워 넣으면, Key를 만드는 투영을 Query 쪽 연산과 미리 합치는 계산 재배치가 어려워집니다. 위치와 무관한 고정 투영 사이에 위치에 따라 달라지는 회전이 들어가기 때문입니다. 별도의 위치 경로를 두면 content 경로의 계산 재배치를 유지하면서 위치 관계도 반영할 수 있습니다. 구체적인 식과 계산 순서는 다음 편에서 다룹니다.
이 설명을 “잠재 벡터에는 위치 관련 정보가 전혀 들어갈 수 없다”는 뜻으로 읽으면 안 됩니다. 층의 입력에는 이전 계산에서 얻은 문맥 정보가 담길 수 있습니다. 여기서 분리하는 것은 RoPE 회전을 명시적으로 적용하는 경로입니다. 위치용 Key 역시 입력을 투영한 뒤 회전하므로 위치 번호만으로 정해지는 고정 벡터가 아닙니다.
Key·Value를 만드는 두 경로
그림 1의 헤드별 투영과 그림 2의 위치 경로를 함께 보겠습니다. 그림 3은 Key와 Value를 구성하는 관계를 보여 줍니다. Query와 Attention 전체 계산을 나타내는 그림은 아닙니다.

헤드 1의 content Key는 [1, 2], 헤드 2의 content Key는 [2, 3]입니다. 여기에 같은 위치용 Key [, ]을 이어 붙이면 다음과 같이 네 성분의 Key가 됩니다.
| 헤드 | 전체 Key | Value |
|---|---|---|
| 헤드 1 | [1, 2, , ] | [4, 2] |
| 헤드 2 | [2, 3, , ] | [1, 5] |
두 부분을 성분별로 더하는 것이 아니라 이어 붙입니다. 따라서 Key의 차원은 content 두 성분과 위치 두 성분을 합친 4이고, Value는 잠재 벡터에서 투영한 두 성분 그대로입니다. Value 뒤에는 위치용 Key를 붙이지 않습니다.
위치 부분이 같아도 전체 Key는 헤드마다 다를 수 있습니다. 앞쪽 content 부분이 서로 다른 투영으로 만들어지기 때문입니다. 또한 공유하는 위치용 Key가 있다고 해서 위치에 대한 Attention 점수까지 모든 헤드에서 같아지는 것은 아닙니다. 점수에는 Query도 관여하며, MLA의 위치 Query는 헤드별로 만듭니다. 다음 편에서는 Query의 content 부분과 위치 부분이 각각 어떤 Key와 계산되는지 연결하겠습니다.
캐시 저장 대상과 그림에 펼쳐 놓은 표현도 구별해야 합니다. 캐시에는 위쪽의 와 를 저장합니다. 아래쪽의 헤드별 K·V는 그 작은 표현으로 어떤 Key와 Value를 나타내는지 보여 주기 위해 펼쳐 놓은 것입니다. 이후 토큰마다 과거의 모든 K·V를 반드시 이 형태로 복원해 저장하는 실행 절차를 뜻하지 않습니다.
앞선 MQA와 비교하면 차이가 분명해집니다. MQA는 여러 Query가 완성된 K와 V를 공유합니다. MLA는 공동 잠재 표현에서 헤드별 content K·V를 만들고, RoPE를 위한 Key 부분을 별도로 공유합니다. 무엇을 공유하는지에 따라 헤드별 표현의 관계도 달라집니다.
토큰 수에 따른 캐시 증가
토큰 하나의 저장 형태를 작게 만들어도, 과거의 토큰 위치마다 표현을 남겨 두는 구조는 유지됩니다. 이번 MLA 예시에서는 위치마다 잠재 벡터 3성분과 위치용 Key 2성분을 저장합니다. 토큰 네 개를 저장했을 때는 4×5 = 20성분이고, 다섯 번째 토큰을 처리하면 한 행이 추가되어 25성분이 됩니다.
잠재 벡터 차원을 , 위치용 Key 차원을 , 저장한 토큰 위치 수를 라고 쓰겠습니다. 헤드별로 펼친 K·V 대신 두 작은 벡터를 저장하는 이 구성에서, 한 요청의 한 층에 필요한 값의 수는 다음과 같습니다.
이번 예시에 대입하면 ×(3+2) = 5입니다. 위치용 Key는 헤드 간 공유하므로 그 차원에 헤드 수를 다시 곱하지 않습니다. 공동 잠재 벡터도 위치마다 하나입니다. 다만 이 식에 헤드 수가 직접 없다고 해서 실제 모델에서 잠재 차원을 헤드 수와 무관하게 마음대로 줄일 수 있다는 뜻은 아닙니다. 잠재 차원은 모델이 학습할 표현의 용량과 연결됩니다.
앞선 글에서 본 MHA·GQA도 토큰이 하나 늘 때마다 캐시에 새 행을 추가합니다. 그림 4에서는 1편의 MHA·GQA 설정을 그대로 가져와 이번 MLA 예시와 나란히 비교합니다. 세 구조 모두 위쪽은 토큰 네 개를 저장한 상태, 아래쪽은 다섯 개를 저장한 상태입니다.
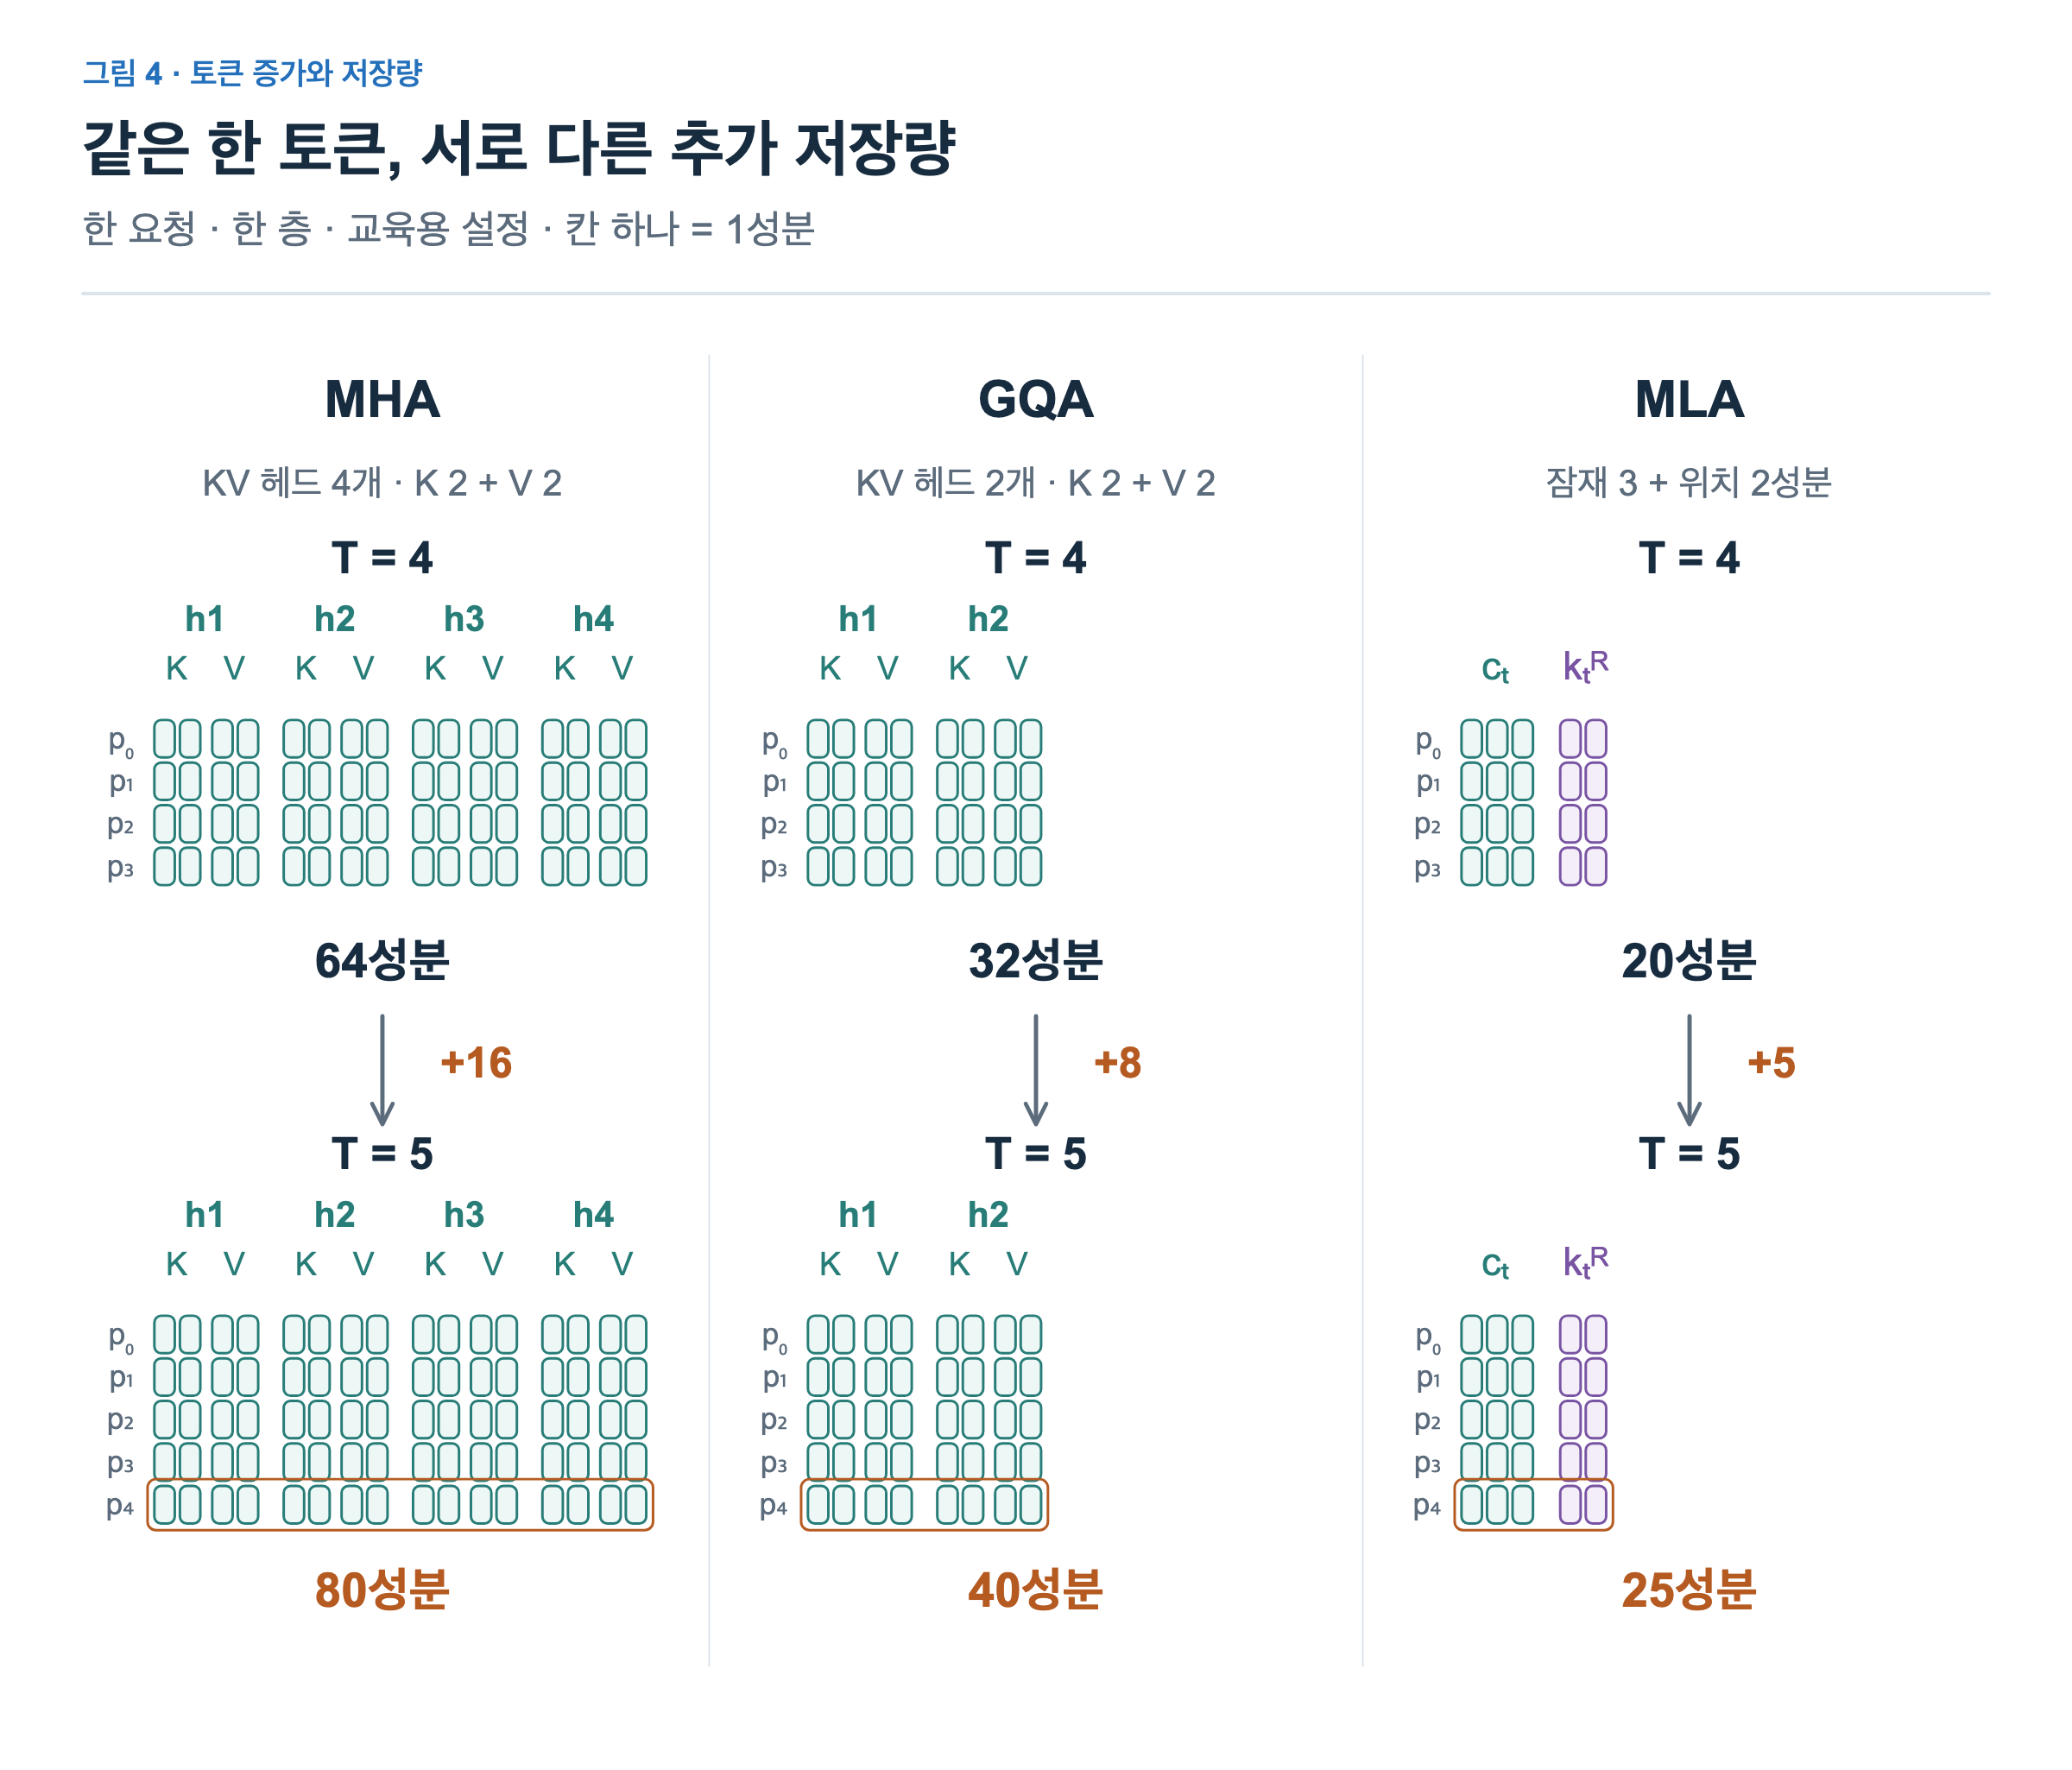
모든 칸은 같은 크기이며, 칸 하나가 저장 성분 하나를 나타냅니다. 주황 테두리는 새로 추가한 행입니다. MHA·GQA의 헤드 표시는 KV 헤드를 뜻합니다.
- MHA는 KV 헤드 4개에 K·V를 각각 2성분씩 저장합니다. 토큰마다 4×(2+2) = 16성분이 추가되어, 총 저장량은 64 → 80성분이 됩니다.
- GQA는 KV 헤드 2개를 공유합니다. 토큰마다 2×(2+2) = 8성분이 추가되어, 32 → 40성분이 됩니다.
- MLA는 공동 잠재 벡터와 공유 위치용 Key를 저장합니다. 토큰마다 3+2 = 5성분이 추가되어, 20 → 25성분이 됩니다.
이 설정에서는 MHA, GQA, MLA 순서로 저장량과 토큰당 추가량이 작아집니다. GQA가 저장할 KV 헤드 수를 줄였다면, MLA는 헤드별 K·V를 만드는 공동 표현을 저장합니다. 그림은 두 글의 교육용 설정에서 저장하는 대상과 크기를 비교한 것입니다. 실제 모델의 절감률은 헤드 수와 각 차원에 따라 달라지며, 같은 품질을 내는 모델끼리의 성능 비교를 뜻하지는 않습니다.
위 식과 그림은 캐시에 담는 값의 수를 나타냅니다. 메모리 크기로 바꾸려면 각 성분의 저장 바이트 수를 반영하고, 모델 전체에서는 층과 요청별 저장량을 더해야 합니다. 가중치, 임시 계산 공간, 메모리 정렬에 필요한 공간은 포함하지 않았습니다.
작은 저장 표현과 남는 계산
MLA는 여러 헤드의 K·V를 위한 공동 표현을 작게 만들어 캐시에 보관합니다. 그 대신 잠재 표현과 헤드별 표현을 연결하는 투영이 필요하고, RoPE를 위한 별도 Key도 저장합니다. 저장량을 줄이는 정도는 잠재 차원과 위치 차원을 어떻게 정했는지에 달려 있습니다.
또한 캐시가 작아지는 비율이 곧 전체 실행 시간이 줄어드는 비율은 아닙니다. 실제 시간은 작은 표현으로 Attention을 계산하는 방식, 커널, 문맥 길이와 실행 환경에 영향을 받습니다. 이제 남은 질문은 저장한 잠재 벡터와 위치용 Key를 현재 Query가 어떻게 읽는가입니다. 다음 편에서는 Q의 두 부분을 먼저 연결하고, 헤드별 KV를 매번 모두 펼치지 않도록 계산 순서를 바꾸는 원리를 살펴보겠습니다.