RL · 2026-09-25
그룹 비교와 Critic으로 어드밴티지 구하기
같은 질문의 응답을 비교하는 GRPO에서 시작해 critic의 예측과 어드밴티지 계산을 살펴보고, SAO와 FlashREINFORCE의 개별 rollout 학습으로 연결합니다.
앞 글에서는 보상에서 구한 어드밴티지가 선택한 토큰을 더 선호할지 덜 선호할지 정하는 신호라고 설명했습니다. 예를 들어 return이 1이고 비교 기준이 0.4라면 +0.6이라는 신호를 얻었습니다. 그렇다면 이 기준값 0.4는 어디에서 올까요?
먼저 같은 질문에 생성한 여러 응답을 비교하는 방법부터 보겠습니다. 다음으로 현재 문맥에서 앞으로 받을 보상을 예측하는 critic을 살펴봅니다. 둘 다 어드밴티지의 비교 기준을 제공하지만 필요한 경험과 계산은 다릅니다. 마지막에는 질문당 하나의 rollout으로 학습하는 시도까지 연결하겠습니다.
같은 질문의 응답들을 비교하는 GRPO
가장 먼저 생각할 수 있는 비교 기준은 실제 생성한 다른 응답의 결과입니다. GRPO(Group Relative Policy Optimization)는 같은 질문에 여러 응답을 생성하고 그 보상들을 비교합니다. 여기서는 응답 마지막의 평가만 사용하는 기본 outcome-only 구성을 보겠습니다. DeepSeekMath §4.1
한 질문에서 응답 네 개를 생성했고, 보상이 [1, 1, 0, 0]이라고 해보겠습니다. 이 네 응답이 하나의 그룹입니다. 평균은 0.5이고, 모집단 표준편차로 계산하면 0.5입니다. 각 보상에서 평균을 뺀 뒤 표준편차로 나눕니다. 평균을 빼면 기준보다 좋은지 나쁜지가 드러나고, 표준편차로 나누면 그 차이를 그룹 점수의 퍼짐을 단위로 표현할 수 있습니다.
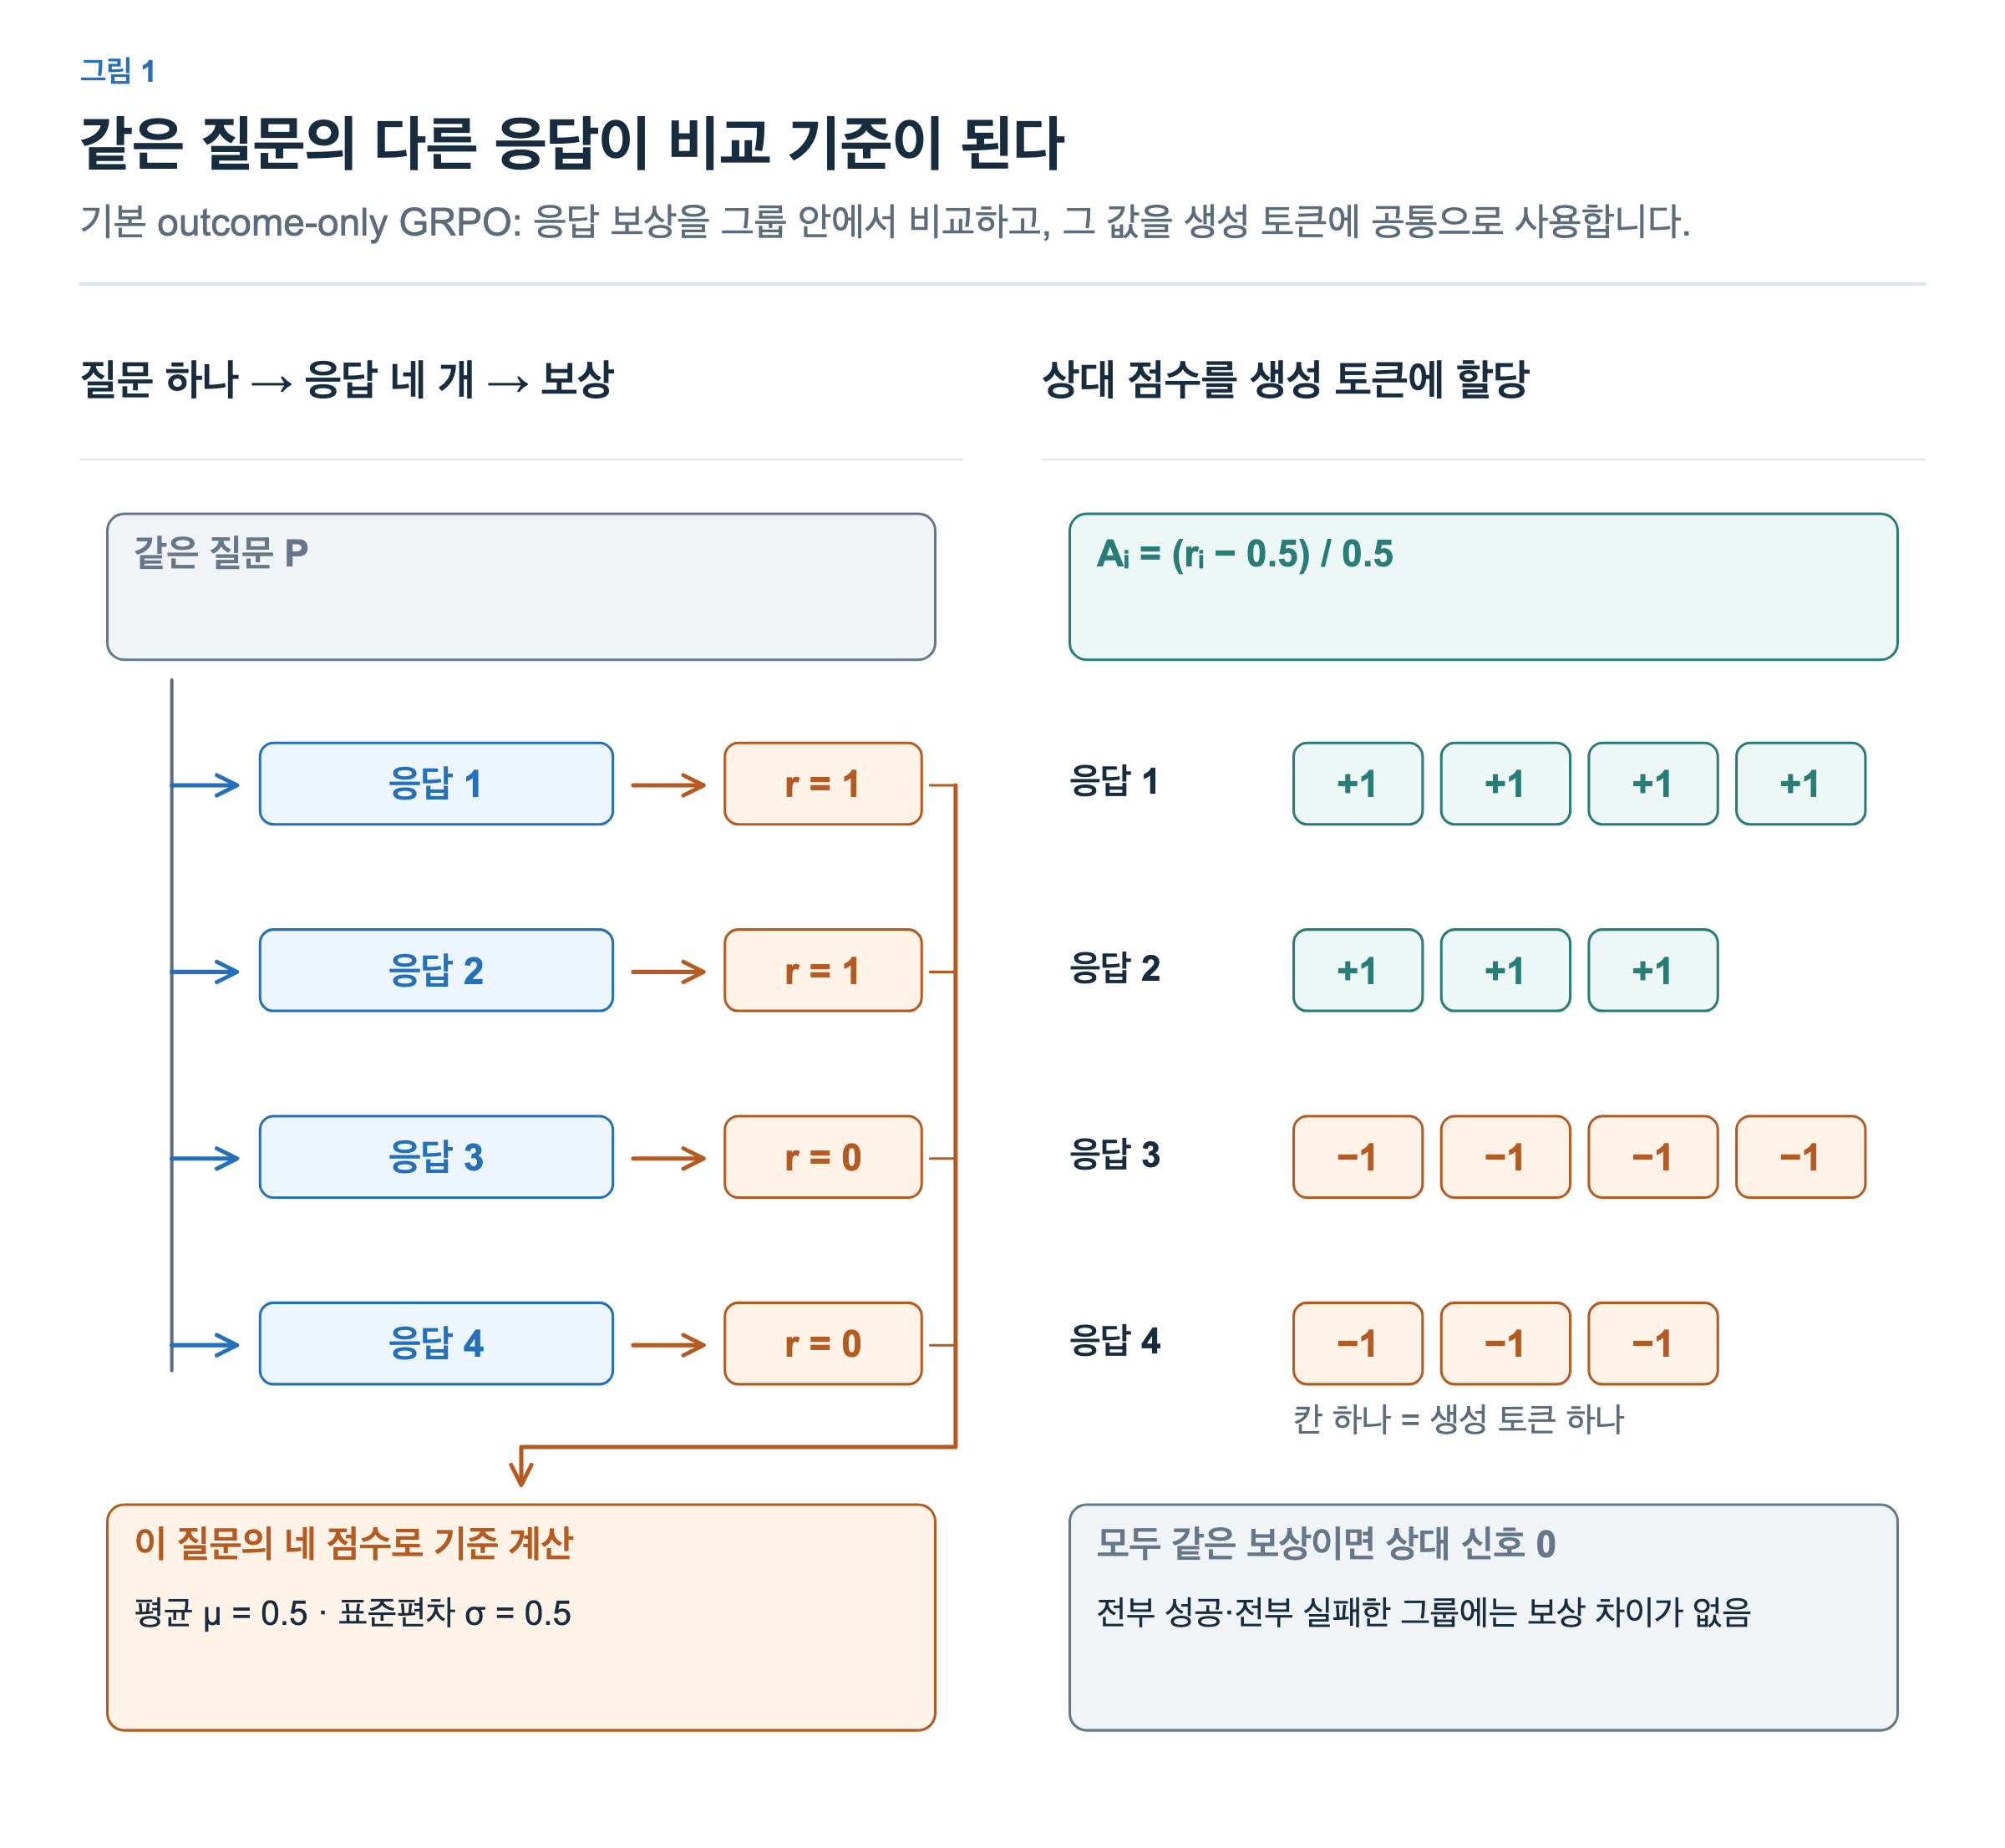
성공한 두 응답은 (1 − 0.5) / 0.5 = +1, 실패한 두 응답은 (0 − 0.5) / 0.5 = −1입니다. 이 구성에서는 응답별로 얻은 값을 그 응답의 생성 토큰들에 공통으로 사용합니다. 입력 질문이나 도구가 반환한 텍스트까지 정책이 선택한 토큰으로 취급하는 것은 아닙니다.
같은 A를 모든 생성 토큰에 쓴다는 것은 모든 토큰의 기여도가 같다는 주장이 아닙니다. 응답의 상대 평가를 각 선택의 정책 손실에 사용하는 방식입니다. 토큰별 현재 확률과 확률비는 여전히 다르므로, 같은 A가 곧 동일한 손실이나 동일한 가중치 변화량을 뜻하지도 않습니다.
다른 질문에서 나온 응답들은 이 그룹 평균에 섞지 않습니다. 쉬운 문제와 어려운 문제의 절대 점수를 곧바로 비교하기보다, 같은 질문에서 어떤 응답이 상대적으로 나았는지 보는 것입니다. 표준편차 계산이나 정규화 방식은 구현에 따라 달라질 수 있으므로, 위의 정확한 +1·−1은 명시한 계산 규약에 따른 예시입니다.
네 응답이 모두 성공하거나 모두 실패했다면 어떨까요? 보상에서 평균을 뺀 값이 모두 0이므로 상대적인 보상 차이가 없습니다. 표준편차도 0이라 단순 나눗셈을 그대로 수행할 수 없습니다. 분모에 작은 ε를 넣는 등의 수치 처리를 하면 이 상대 보상 신호는 0이 되고, 일부 구성은 이런 그룹을 학습 대상에서 제외합니다. 별도로 넣은 KL이나 교사 신호까지 모두 0이라는 뜻은 아닙니다.
Critic은 미래의 결과를 예측한다
수학 답을 생성하는 도중에 모델이 지금까지 작성한 내용을 보고 있다고 해보겠습니다. 아직 최종 답은 나오지 않았지만, 여기에서 계속 진행하면 얼마나 좋은 결과를 얻을지 예상할 수는 있습니다. 그 기대값을 예측하는 역할이 critic, 여기서는 상태 가치를 예측하는 value model입니다.
Critic에 현재 문맥 sₜ를 넣어 얻는 값은 V(sₜ)라고 씁니다. V는 그 문맥에서 정책이 이후 행동들을 선택했을 때 받을 return의 예측값입니다. 보상이 성공 1, 실패 0뿐이고 미래 보상에 별도 가중치를 주지 않는 설정이라면 기대 성공 여부와 연결해 해석할 수 있습니다. 보상에 다른 항이 들어가면 V도 그 return을 예측하므로, 언제나 성공 확률인 것은 아닙니다.
앞서 본 보상 모델과는 역할이 다릅니다. 보상 모델이나 검증기는 생성 결과에 평가 기준을 적용하고, critic은 아직 끝나지 않은 문맥에서 그 이후의 결과를 예상합니다. Critic이 큰 값을 출력했다고 실제 정답 판정이 끝난 것은 아닙니다.
LLM용 critic은 언어 모델의 문맥 표현에서 숫자 하나를 출력하는 층을 붙여 구성할 수 있습니다. 이 글에서는 정책과 별도로 학습하는 critic을 생각하겠습니다. critic도 자기 답변을 끝까지 생성한 뒤 채점받는 것이 아니라, 주어진 문맥에서 V를 계산합니다. 학습 시 전체 토큰 이력을 한 번에 처리하더라도 각 위치의 예측이 미래 토큰을 미리 읽지 않도록 해야 합니다.
같은 최종 보상, 서로 다른 예상
앞 글의 설명용 응답 u → b → d를 다시 보겠습니다. 각 토큰을 고르기 직전의 문맥은 P, P + u, P + u + b입니다. 각 행동 직전 critic의 예측은 0.2, 0.6, 0.4이고, 실제 보상은 마지막에만 1을 받습니다. 이 숫자는 이해를 위한 가상 값입니다. 여기서 P는 입력 프롬프트입니다. 먼저 끝까지 관측한 결과와 각 시점의 예상을 비교하는 가장 단순한 계산을 보겠습니다.
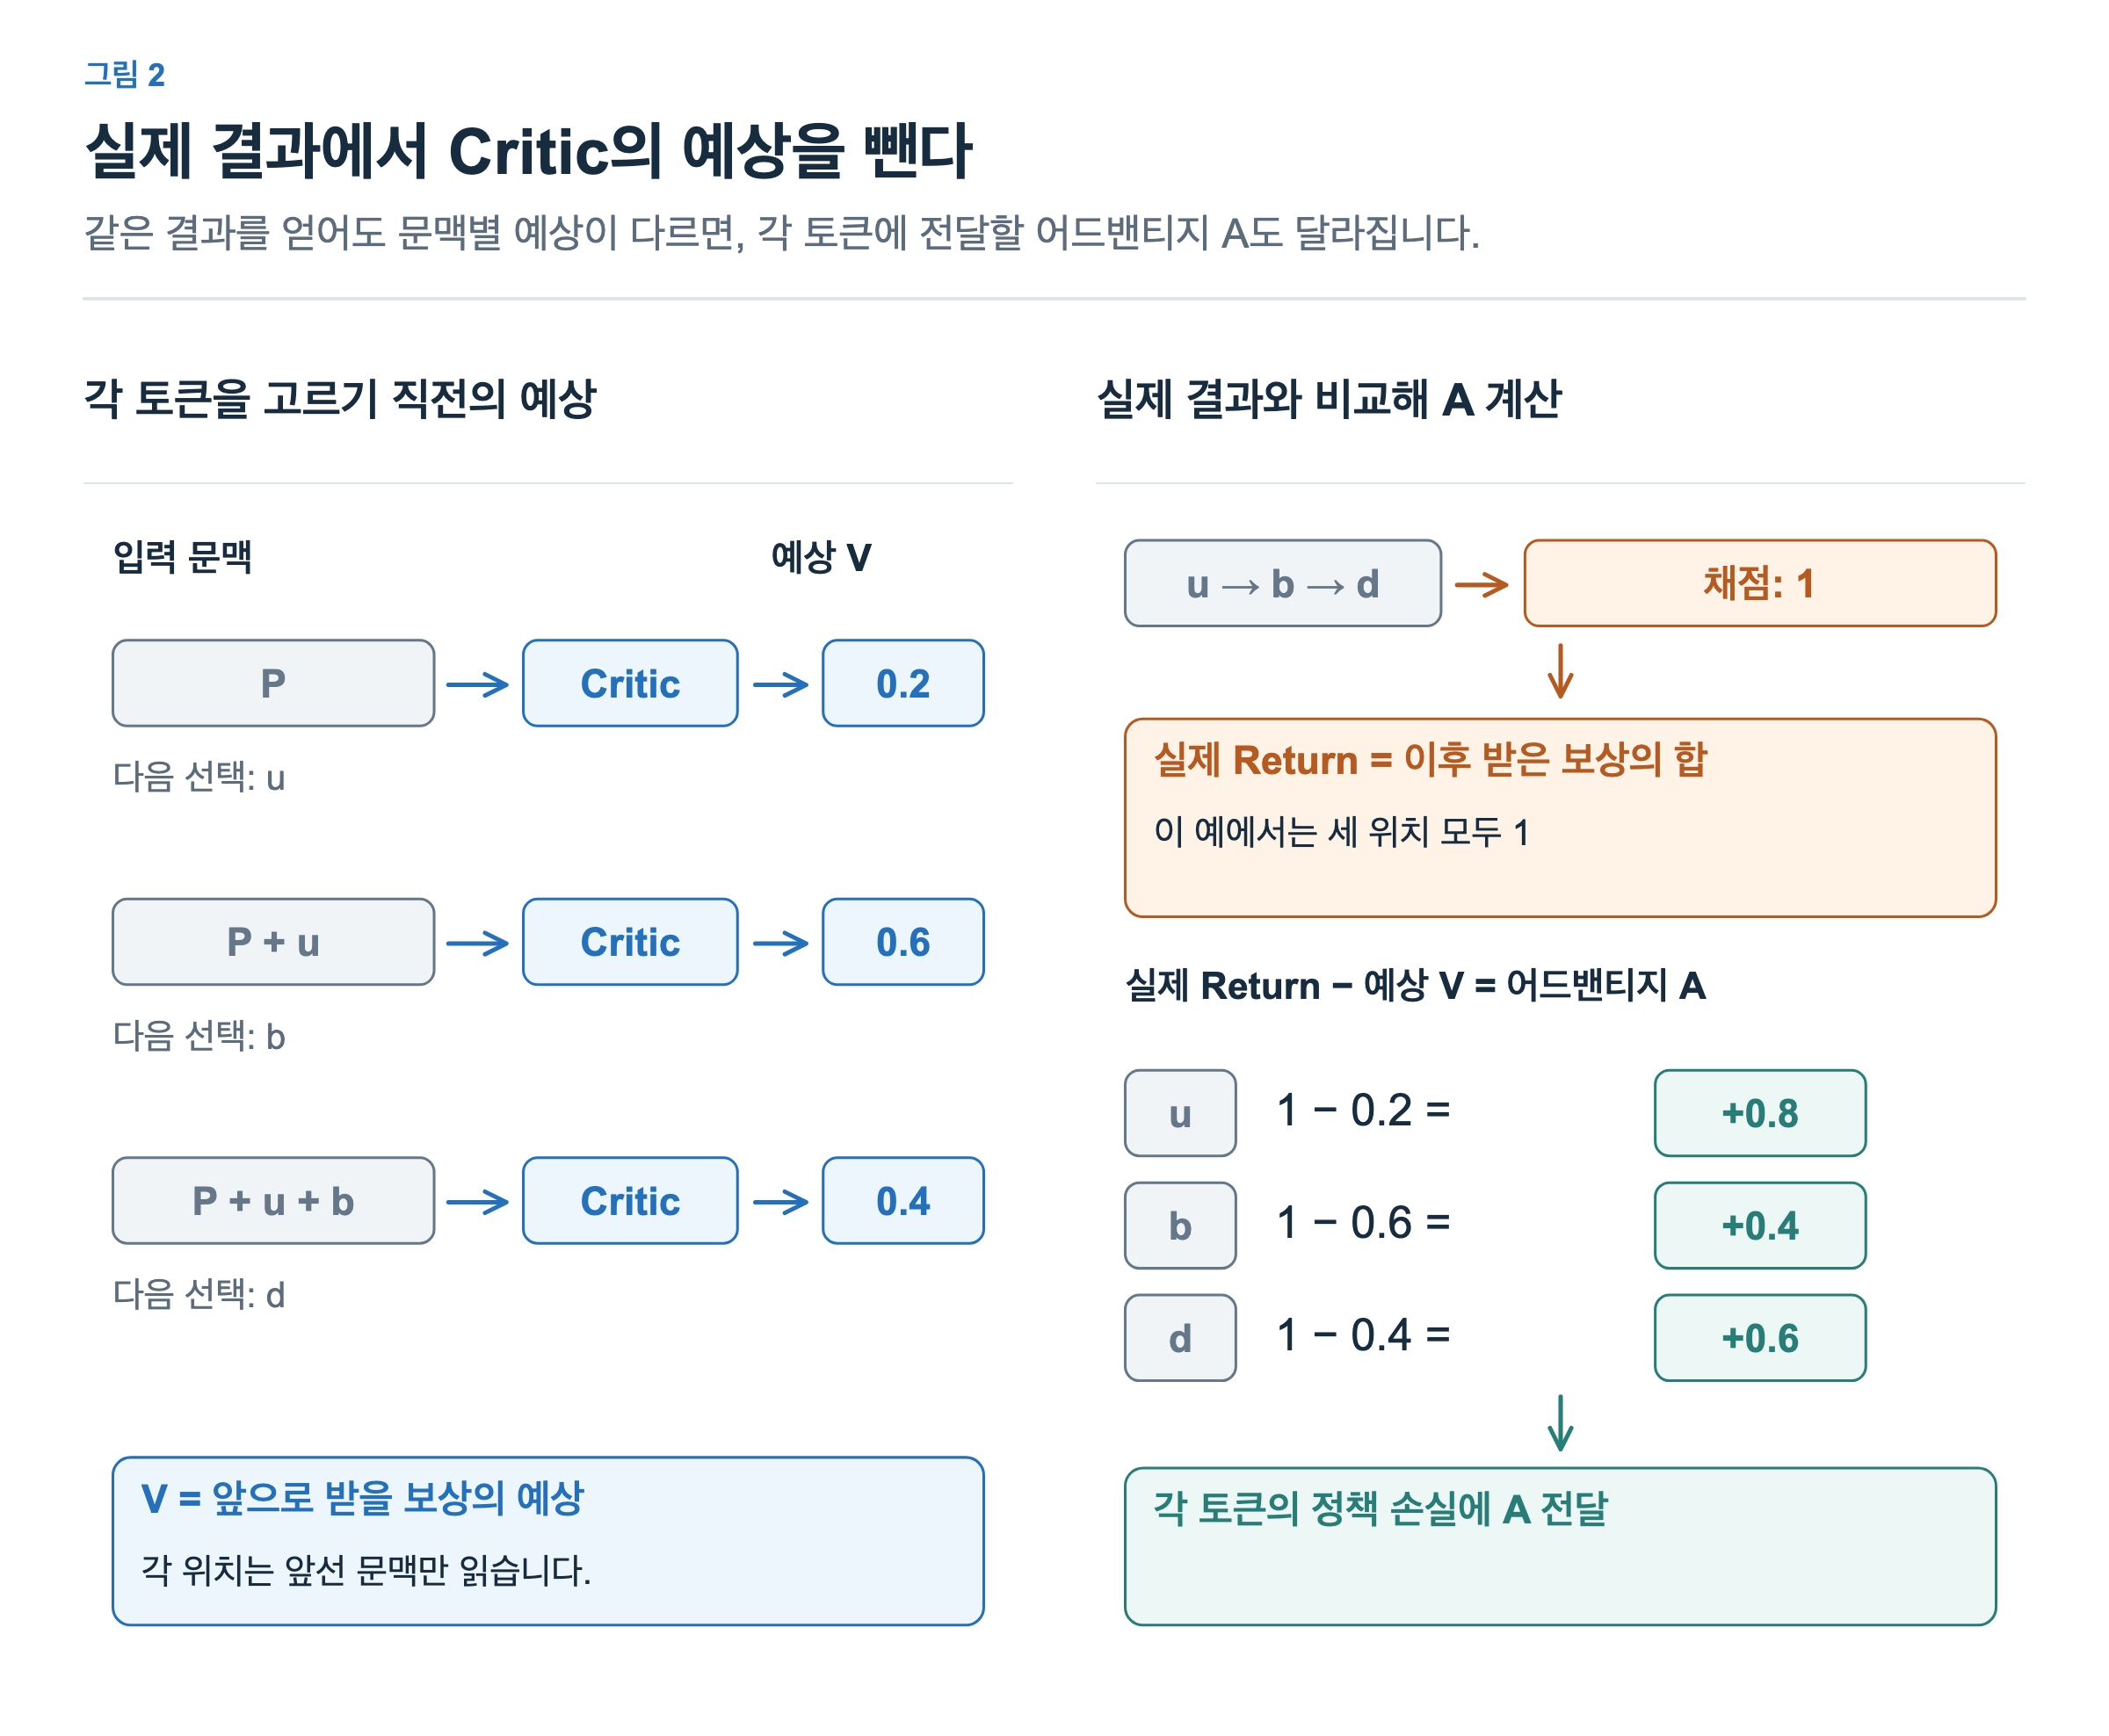
그림 왼쪽의 critic은 각 토큰을 고르기 직전의 문맥에서 앞으로 받을 보상을 예상합니다. P만 보았을 때의 예상은 0.2이고, u까지 생성한 문맥에서는 0.6, b까지 생성한 문맥에서는 0.4입니다. 세 위치에 같은 critic을 적용한 것이며, critic 세 개를 따로 둔다는 뜻은 아닙니다. V는 문맥에 따라 오르내릴 수 있습니다. 지금까지 쌓은 성과가 아니라, 현재 문맥에서 앞으로 받을 보상을 예상한 값이기 때문입니다.
오른쪽은 응답이 완성되고 채점까지 끝난 뒤 알게 된 실제 결과입니다. Return은 해당 시점 이후 받은 보상을 누적한 값입니다. 이 예에서는 할인을 적용하지 않고, 중간 보상은 0이며 마지막에만 1을 받습니다. 따라서 어느 토큰 직전에서 세어도 이후 받은 보상의 합은 1입니다.
이 실제 return에서 예상 V를 빼면 어드밴티지 A, 즉 예상보다 얼마나 좋은 결과였는지를 나타내는 신호를 얻습니다. u에서는 1 − 0.2 = 0.8, b에서는 1 − 0.6 = 0.4, d에서는 1 − 0.4 = 0.6입니다. 이렇게 얻은 A가 앞 글에서 본 각 토큰의 정책 손실에 들어갑니다.
이 값들을 각 위치의 어드밴티지 A₁, A₂, A₃로 사용하면 같은 응답 안에서도 서로 다른 크기의 신호가 생깁니다. 다만 첫 토큰이 정답에 0.8만큼 기여했다는 판정은 아닙니다. 각 문맥에서의 예상과 실현된 결과의 차이를 비교한 것입니다.
Critic 자체도 학습해야 합니다. 이 예에서는 나중에 관측한 return 1을 학습 목표로 두고, 각 문맥의 예측 V가 그 목표에 가까워지도록 오차를 줄입니다. 가장 단순한 가치 손실은 (V − 1)²입니다. 정책 손실이 토큰의 선택 확률을 조정한다면, 가치 손실은 critic의 미래 보상 예측을 조정합니다.
따라서 “PPO의 어드밴티지는 critic이 결정한다”라는 말은 조금 줄여 쓴 표현입니다. critic은 비교에 필요한 예측을 제공합니다. 실제 보상과 그 예측을 어드밴티지 계산식에 함께 넣어야 A가 나옵니다.
더 알아보기: 한 단계의 예상 변화에서 GAE로
매 시점에서 끝까지 관측한 return만 사용하는 대신, 바로 다음 시점의 예측을 이용할 수도 있습니다. 현재의 예측과 방금 받은 보상 + 다음 상태에서 남아 있다고 예상하는 보상을 비교합니다. 이 차이를 TD(Temporal Difference) 오차라고 부르며, δ(델타)라는 기호로 씁니다. A가 정책 손실에 사용할 어드밴티지라면, δ는 그 A를 계산하는 데 사용하는 한 단계의 예상 오차입니다.
TD 오차 δₜ = 방금 받은 보상 + γ × 다음 상태의 V − 현재 상태의 Vγ는 미래 보상을 얼마나 반영할지 정하는 할인 계수입니다. 앞의 예처럼 γ = 1로 두면 다음의 세 계산을 얻습니다.
δ₁ = 0 + 0.6 − 0.2 = +0.4
δ₂ = 0 + 0.4 − 0.6 = −0.2
δ₃ = 1 + 0   − 0.4 = +0.6
마지막의 0은 응답이 실제로 종료되어 앞으로 받을 보상이 없다는 뜻입니다. 실행을 잠시 중단했거나 길이 제한 때문에 계산을 끊은 상황을 모두 같은 종료로 처리해도 된다는 뜻은 아닙니다. 계속 이어질 상태인지에 따라 뒤쪽 가치의 사용 여부가 달라집니다.
PPO에서 널리 사용하는 GAE(Generalized Advantage Estimation)는 이런 TD 오차들을 뒤쪽 시점까지 모아 어드밴티지를 추정합니다. 현재 오차는 그대로 쓰고, 더 먼 오차에는 γλ, 그다음에는 (γλ)²처럼 가중치를 줍니다. λ는 얼마나 먼 시점의 오차까지 반영할지 조절하는 값입니다. GAE 논문
여기서 γ와 λ를 모두 1로 두면 단순히 뒤쪽 오차를 더할 수 있습니다. A₃는 0.6, A₂는 −0.2 + 0.6 = 0.4, A₁은 0.4 − 0.2 + 0.6 = 0.8입니다. 앞서 최종 return에서 각 V를 뺀 결과와 같습니다. b 선택 직후의 TD 오차는 −0.2이지만, 이후의 오차 +0.6까지 반영한 A₂는 +0.4입니다. 한 단계 뒤의 예상으로 비교하는 것과, 이후 결과까지 반영하는 것의 차이입니다. λ = 0으로 두면 뒤의 TD 오차를 더하지 않고 현재 δ 자체를 A의 추정값으로 사용합니다.
이 일치는 끝까지 관측한 응답에서 γ = λ = 1로 둔 조건에서 성립합니다. 일반적인 GAE를 항상 “최종 점수 − V”로 계산하는 것은 아닙니다. 더 먼 관측을 많이 반영할지, 가까운 시점의 critic 예측에 더 의존할지를 조절하면서 추정의 편향과 변동성 사이를 절충합니다. 학습 중 critic의 예측 품질도 함께 중요해지는 이유입니다.
비교 기준을 바꾸면 필요한 작업도 바뀐다
GRPO가 주목받은 이유 중 하나는 별도의 critic 없이도 어드밴티지를 구할 수 있다는 점입니다. critic의 파라미터와 학습 상태를 저장하고, V를 계산하고, 예측 오차를 학습하는 부담을 줄일 수 있습니다. DeepSeekMath도 이 메모리·계산 부담을 주요 동기로 설명합니다. DeepSeekMath §4.1.1
대신 그룹의 비교 기준을 얻으려면 같은 질문에서 여러 응답을 생성하고 채점해야 합니다. PPO에서도 여러 응답을 생성할 수 있으므로, 모든 PPO와 GRPO 실행의 생성량이 반드시 다르다는 뜻은 아닙니다. critic의 비용과 그룹 생성의 비용은 서로 다른 종류의 작업입니다. 어느 쪽이 더 저렴한지는 모델 크기뿐 아니라 응답 길이, 그룹 크기, 자원 배치에도 영향을 받습니다.
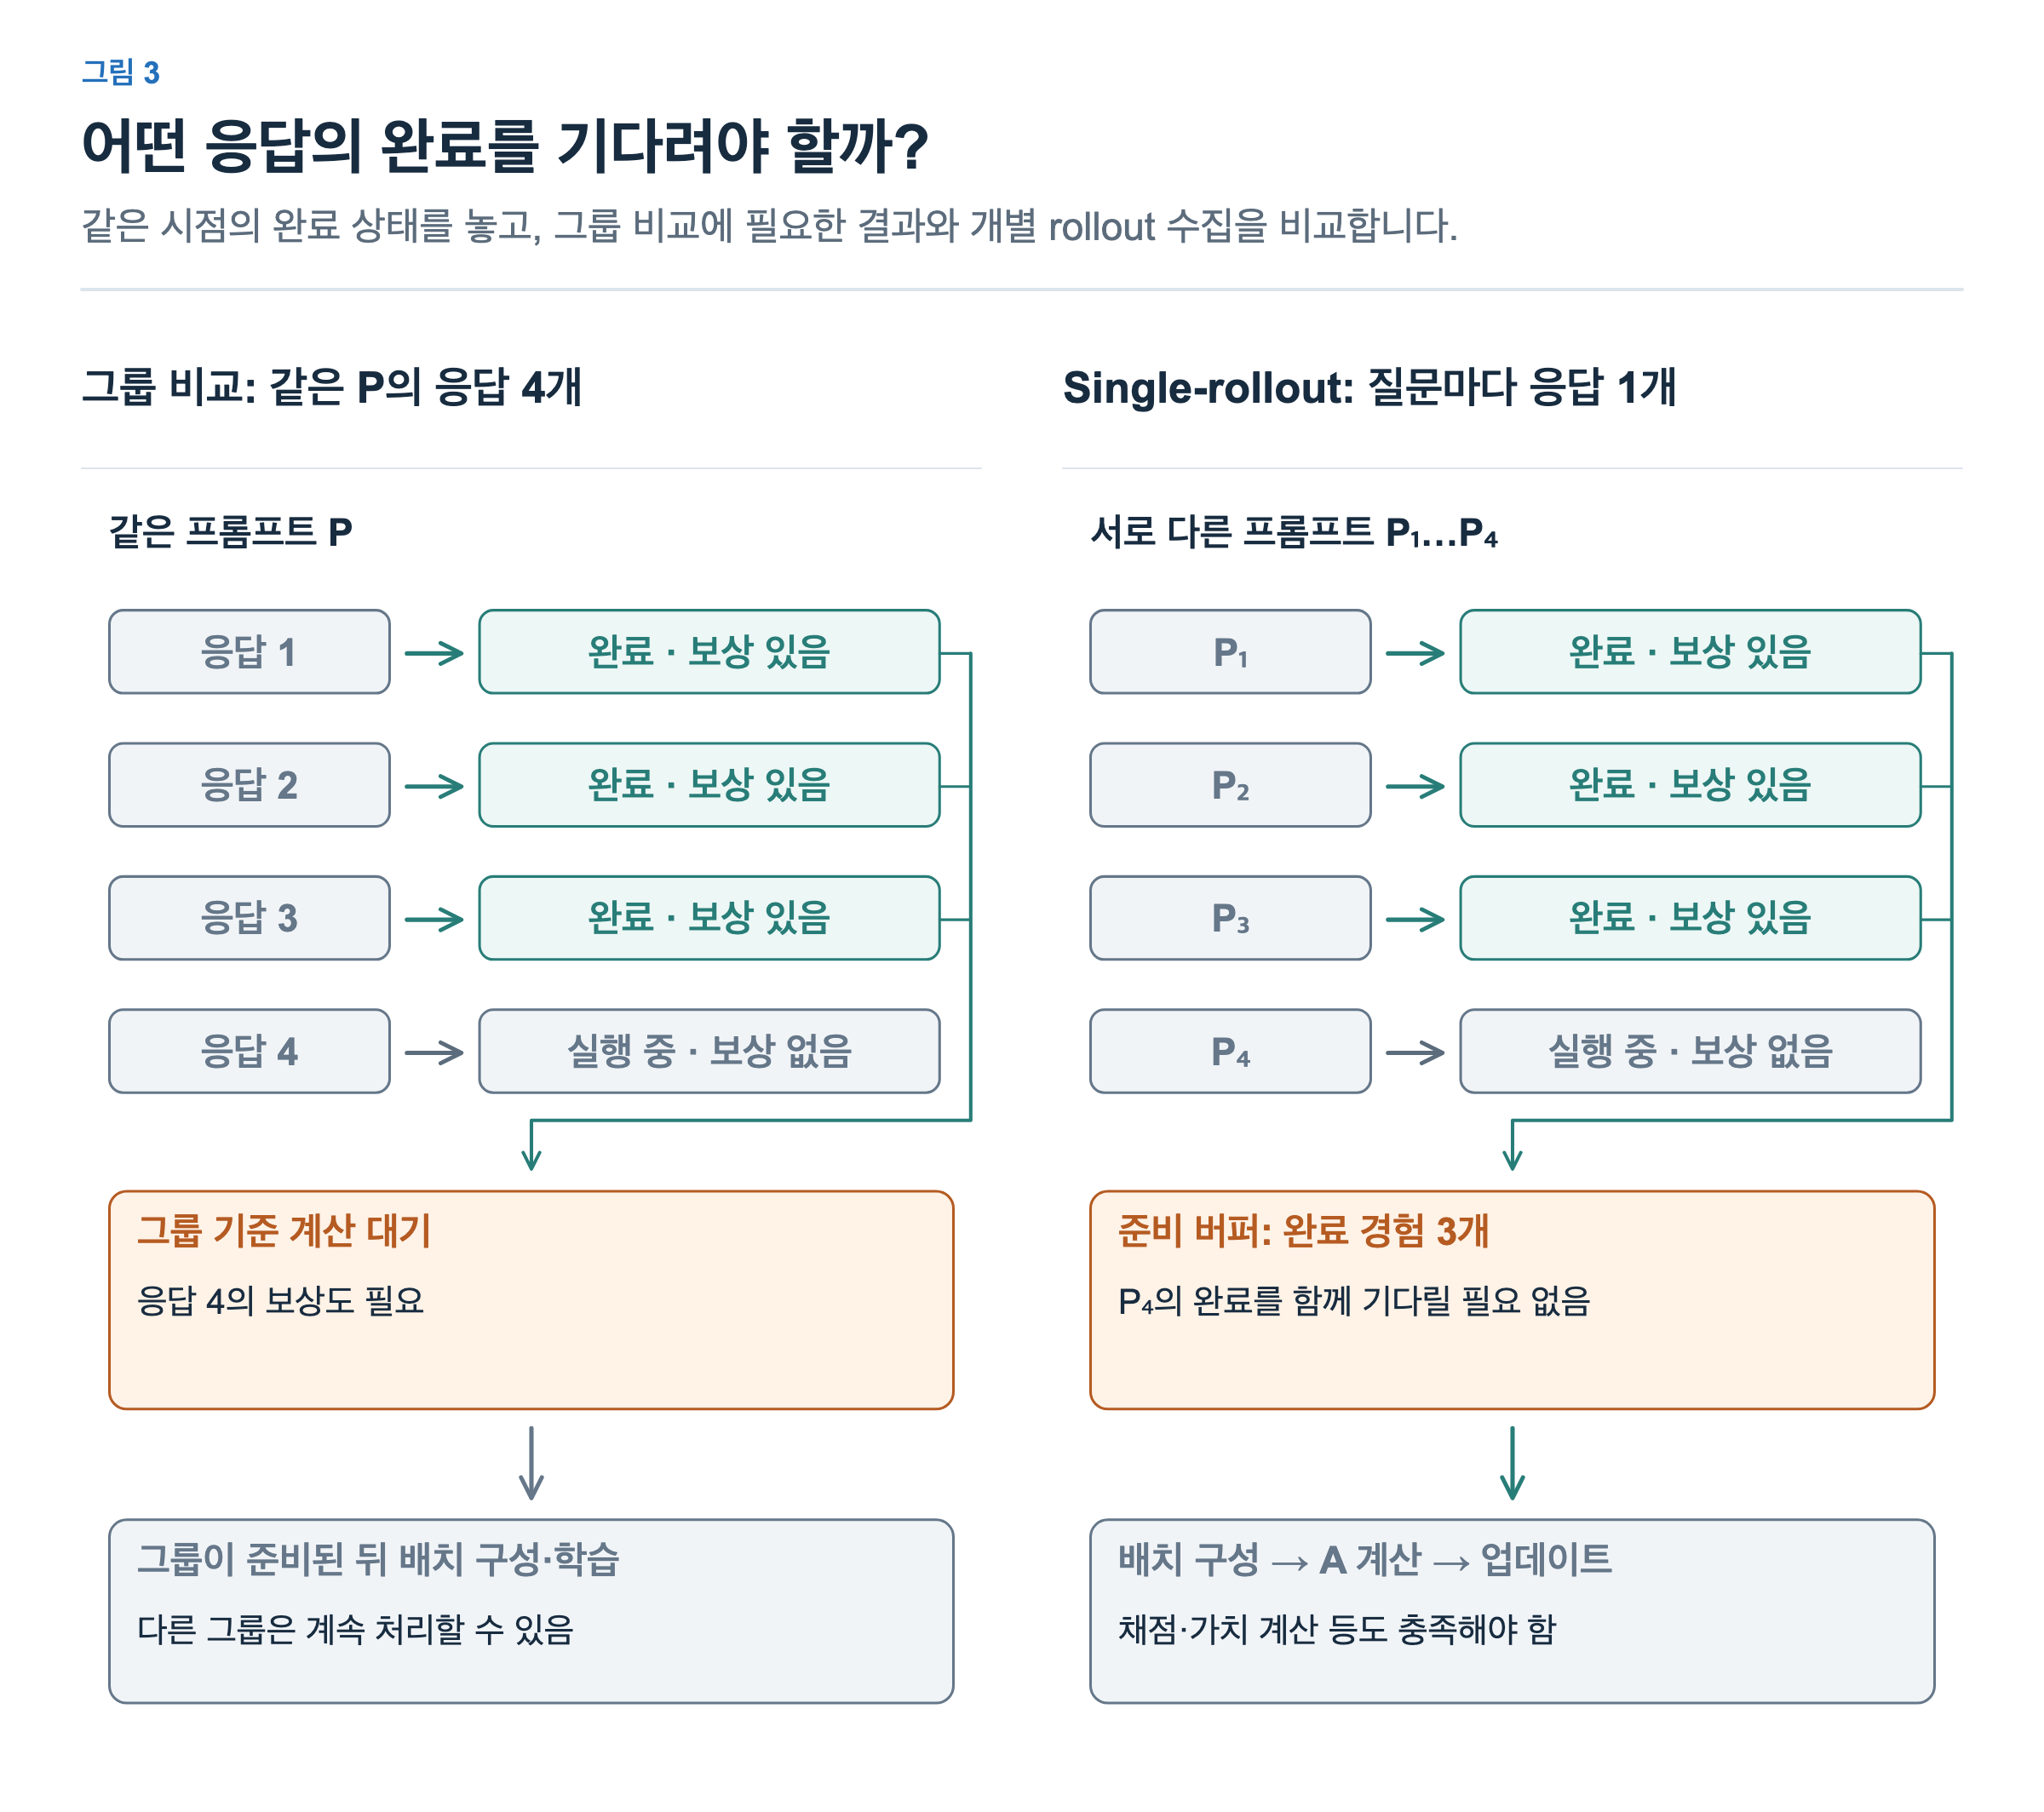
그림 왼쪽은 같은 프롬프트 P에서 네 응답을 생성한 상황입니다. 세 응답은 채점까지 마쳤지만 하나는 아직 실행 중입니다. 네 보상으로 그룹 평균과 편차를 계산하려면 마지막 응답의 결과도 필요합니다. 이 그림은 속도를 측정한 결과가 아니라 어떤 결과에 의존해야 비교 기준을 구할 수 있는지를 보여줍니다.
응답이 먼저 끝났다면 그 생성 슬롯은 다른 작업에 사용할 수 있습니다. 개별 작업이 자원을 반환하는 시점과 그룹의 어드밴티지가 준비되는 시점은 다릅니다. 다른 그룹의 생성이나 준비된 데이터의 학습도 계속 진행할 수 있습니다.
긴 추론 응답에서는 일부 샘플이 훨씬 많은 토큰을 만들 수 있습니다. 멀티턴 에이전트는 코드를 실행하고 결과를 읽어 다시 생성하기도 합니다. 도구 실행이 오래 걸리거나 시도 횟수가 늘면 한 작업의 완료 시간도 길어집니다. 이런 경우에는 생성 속도뿐 아니라 느린 샘플 때문에 언제 어떤 그룹이 준비되는지도 중요해집니다.
같은 질문의 그룹 없이 배우기
그림 3의 오른쪽은 서로 다른 프롬프트 P₁부터 P₄까지 rollout을 하나씩 생성합니다. 완료된 세 실행은 준비 버퍼로 보내고 P₄는 계속 실행할 수 있습니다. 같은 질문에서 나온 나머지 응답을 함께 모아야 하는 의존성이 없기 때문입니다. 세 개라는 수는 설명용이며 배치 크기를 정한 것은 아닙니다. 질문당 하나의 rollout은 batch size 1이나 완료 즉시 optimizer 업데이트라는 뜻이 아닙니다. 실제 업데이트에는 배치 구성과 필요한 채점·가치 계산 등이 여전히 필요합니다.
이때도 어드밴티지를 위한 비교 기준이 필요하지만, 반드시 critic만 쓸 수 있는 것은 아닙니다.
| 접근 | 어드밴티지의 비교 기준 | 같은 질문의 여러 응답 필요 여부 |
|---|---|---|
| 기본 GRPO | 해당 질문의 그룹 보상 평균과 편차 | 필요 |
| SAO | Critic 예측과 실제 보상 | 불필요 |
| FlashREINFORCE | 서로 다른 질문의 완료 배치 보상 평균 | 불필요 |
SAO(Single-Rollout Asynchronous Optimization)는 PPO에서 익숙한 actor–critic 구조를 유지하면서 비동기 에이전트 학습에 맞춘 접근입니다. 질문당 하나의 rollout을 사용해 같은 질문의 나머지 결과를 기다리지 않습니다. 오래된 경험을 다루기 위해 확률비 보정과 critic 학습 방식도 조정합니다. critic은 return을 예측하고, 보상과 예측에서 A를 구하고, actor는 토큰 확률을 바꾼다는 기본 역할은 이어집니다. SAO §§3–3.2
FlashREINFORCE는 critic 대신 서로 다른 질문에서 완료된 실행들의 보상 평균을 빼서 Aᵢ = Rᵢ − 배치 평균을 사용합니다. 보상이 [1, 1, 0]이면 평균은 2/3이고 A는 약 [+0.33, +0.33, −0.67]입니다. 새 완료 배치를 한 번 업데이트에 사용한 뒤 폐기합니다. FlashREINFORCE — One-Batch REINFORCE
그림 4는 같은 완료 경험을 두 방식에 넣었을 때 A를 구하는 경로만 비교합니다. 서로 다른 세 질문의 보상을 1, 1, 0으로 두었습니다.
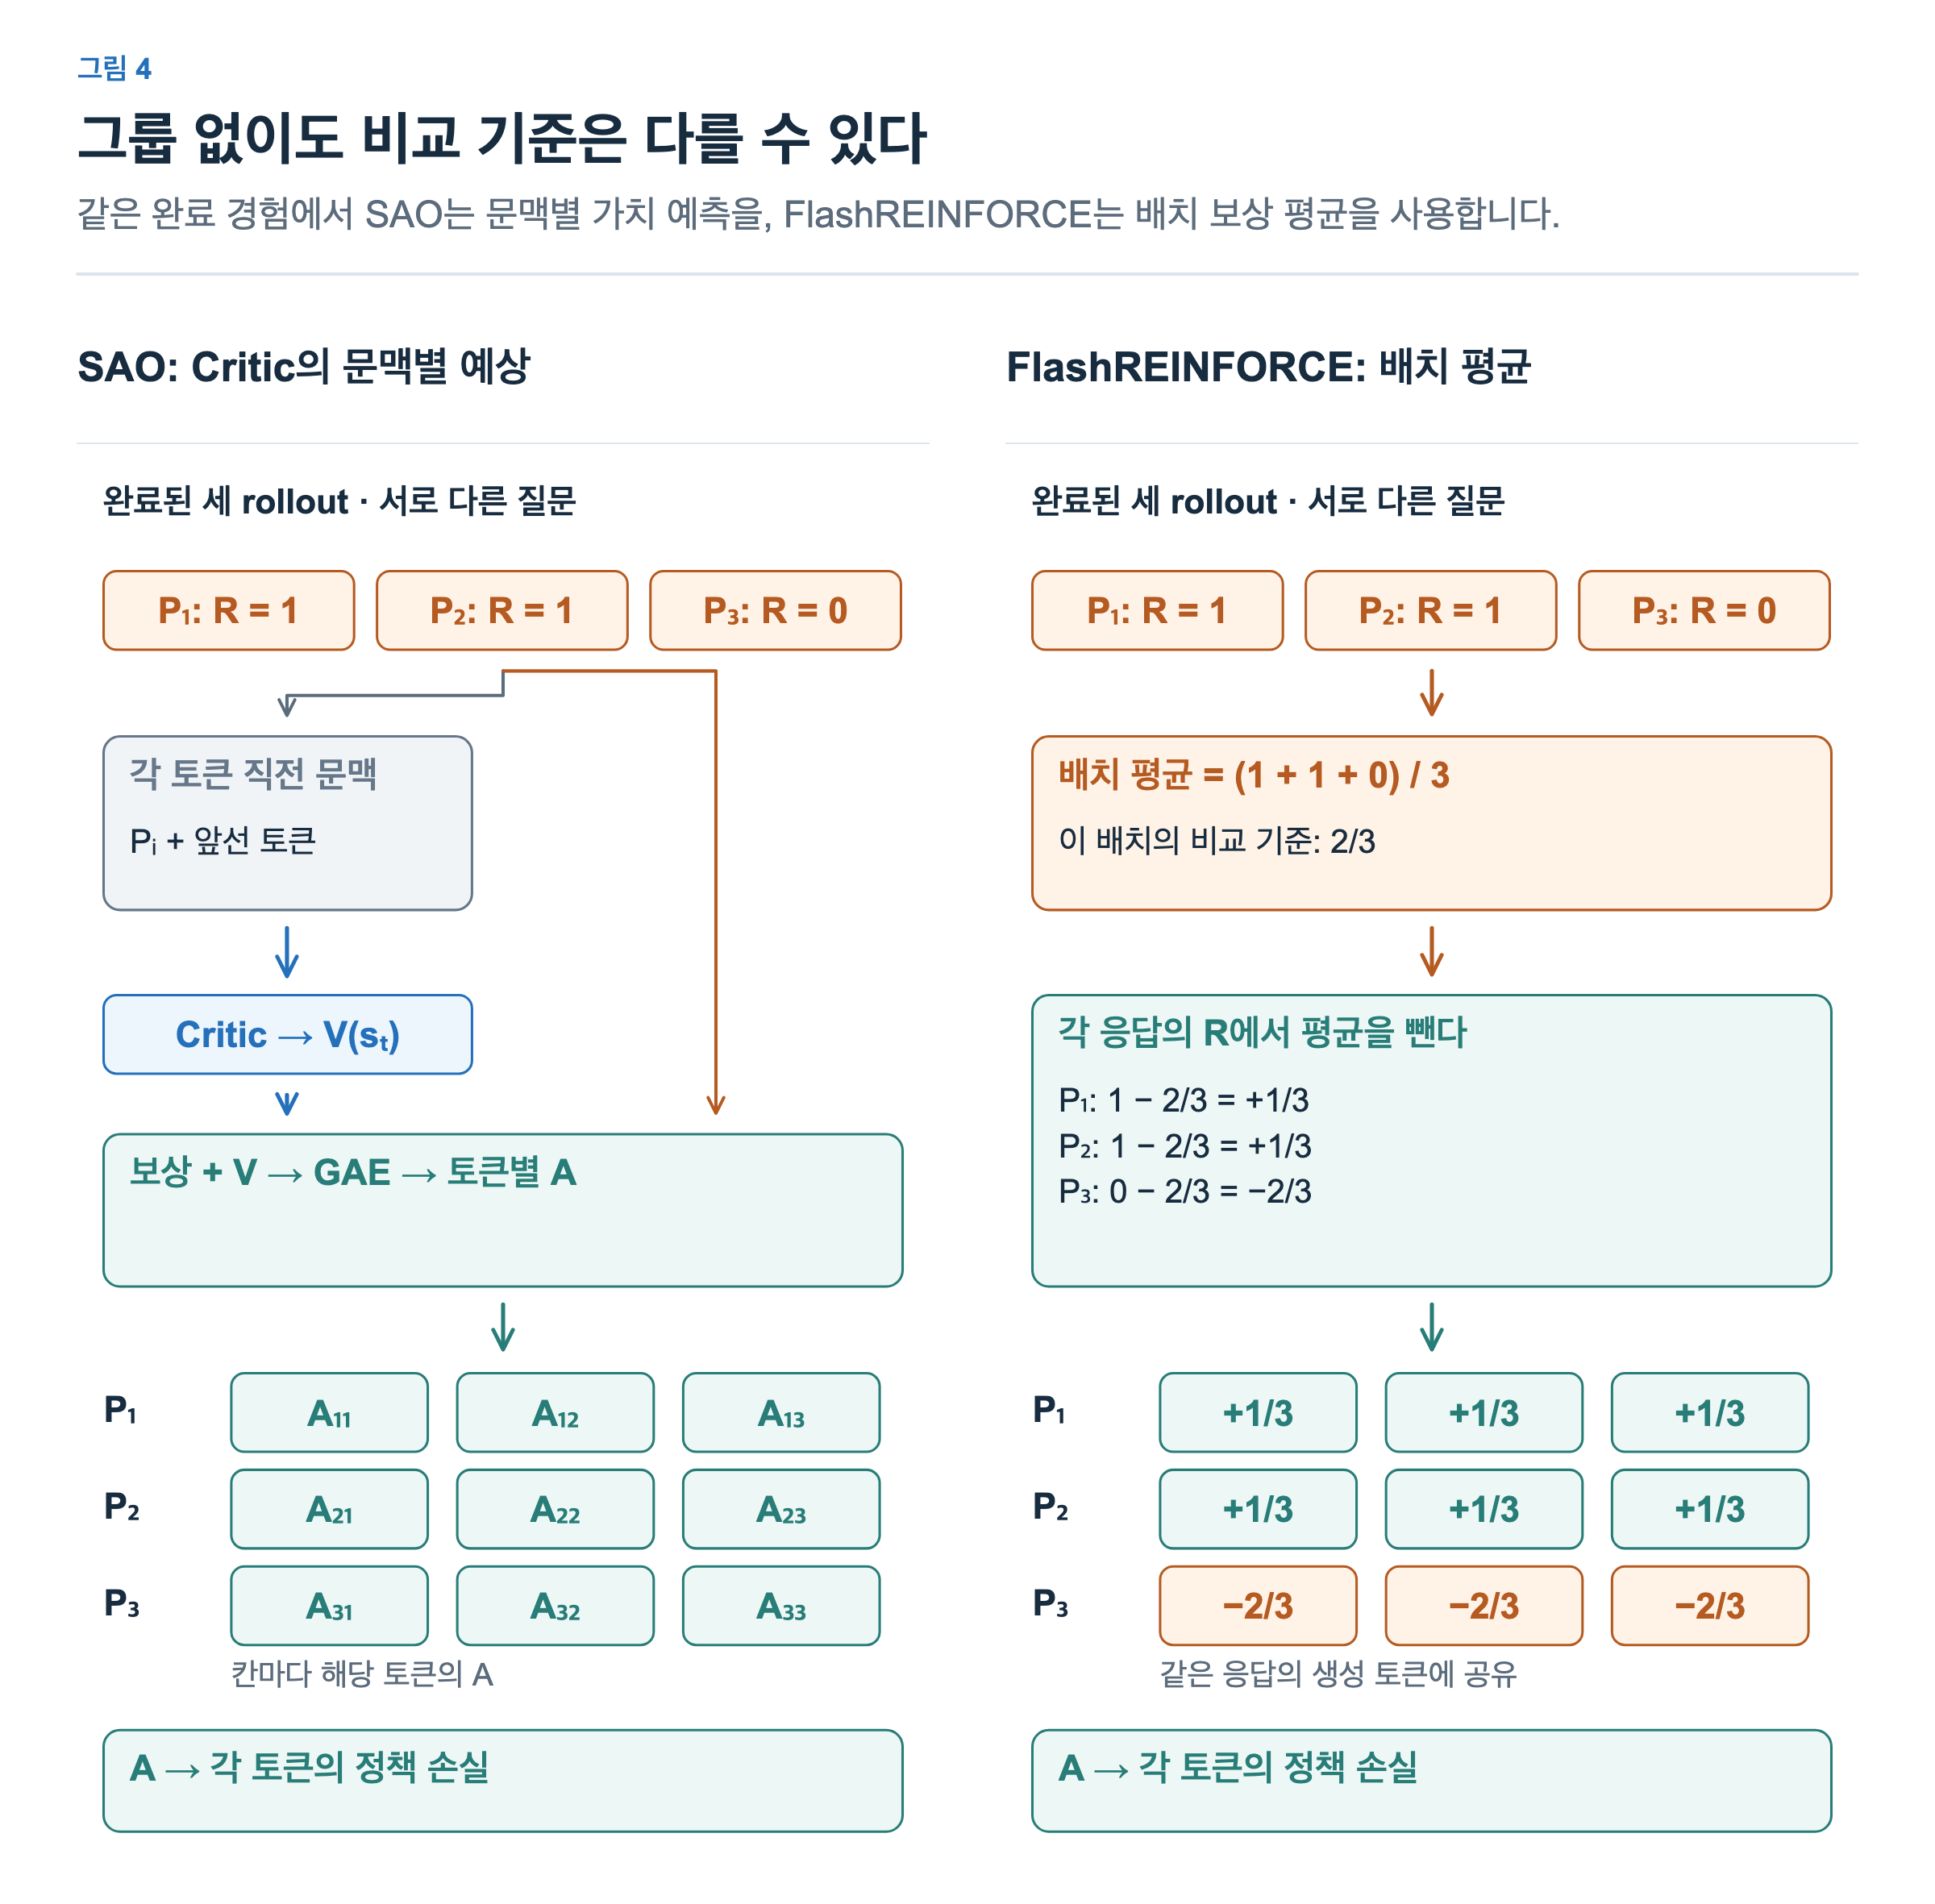
왼쪽에서는 각 rollout의 문맥을 critic에 넣어 V를 얻고, 실제 보상과 함께 GAE로 A를 구합니다. A₁₁은 첫 rollout의 첫 생성 토큰, A₁₂는 그 다음 생성 토큰의 어드밴티지입니다. 같은 응답 안에서도 값이 달라질 수 있습니다. SAO는 도구가 반환한 관측 토큰을 정책의 행동으로 취급하지 않도록 GAE도 조정합니다. SAO §3.2
오른쪽에서는 critic을 거치지 않고 세 보상의 평균 2/3을 뺍니다. 첫 번째와 두 번째 응답은 +1/3, 세 번째 응답은 −2/3이며, 각 응답의 생성 토큰에는 그 응답의 값을 공통으로 사용합니다. 그림 1의 GRPO와 달리 서로 다른 질문의 완료 배치에서 기준을 구한다는 점이 중요합니다. 그림의 세 칸은 생성 토큰을 대표하며 실제 응답 길이가 모두 같다는 뜻은 아닙니다.
두 경로 모두 A를 정책 손실에 전달합니다. 여기서는 비교 기준에 집중했으며, 확률비 보정이나 마스킹까지 두 알고리즘이 같다는 뜻은 아닙니다.
이 배치 평균은 개별 문제의 난이도를 정밀하게 예측한 값이 아닙니다. 같은 질문 안에서 비교하는 정밀함 대신 더 많은 질문을 경험하고 수집을 단순화하는 선택입니다. 쉬운 문제의 성공과 어려운 문제의 실패가 같은 기준을 썼다고 똑같이 유익한 정보가 되지는 않습니다. 이는 추정 방식과 경험 수집 방식의 다른 조합이며, 모든 상황에서 critic이 불필요하다는 증거는 아닙니다.
긴 작업에서는 경험의 단위도 달라집니다. GLM-5.2는 문맥 압축으로 하나의 과제 rollout이 여러 학습 구간으로 나뉘고, 같은 질문의 실행마다 그 수와 길이가 달라진다고 설명합니다. 이때 critic 기반 PPO로 개별 rollout에서 학습하고, 압축으로 나뉜 모든 구간에 토큰 단위 손실을 적용합니다. GLM-5.2 — Long-Horizon RL
예를 들어 한 실행은 두 구간, 다른 실행은 다섯 구간으로 나뉠 수 있습니다. 이는 독립된 답변 일곱 개가 아니라 원래 두 번의 시도에서 나온 부분 이력입니다. 이 숫자는 이해를 위한 예입니다. 길이가 다르다고 GRPO가 수학적으로 불가능해지는 것은 아닙니다. 어떤 구간을 묶고, 성과를 배분하고, 손실에 어느 비중을 줄지 결정해야 한다는 뜻입니다. critic은 구간마다 대응하는 비교 응답을 만들지 않고도 현재 문맥의 예측을 얻는 한 방법입니다.
역사적으로 PPO가 먼저였고 critic 비용을 줄인 GRPO가 주목받았습니다. 그러나 최근 시도를 ‘결국 모두 critic으로 돌아간다’는 흐름으로 읽을 필요는 없습니다. 가치 모델을 학습할 것인가와 같은 질문의 그룹을 요구할 것인가는 별개의 선택입니다. 과제와 경험 구조, 수집 비용에 맞는 조합을 고르는 문제입니다.
생성이 긴 실행에서는 어디에 시간이 쓰이는가
응답을 생성하며 학습할 경험을 얻는 과정을 rollout(롤아웃)이라고 부릅니다. 생성의 비중이 실제로 클 수 있는지 공개 측정 하나를 보겠습니다. Skywork-OR1 보고서는 32B 모델의 1,000 step 실행에 대해 다음 시간을 보고했습니다. 정책 업데이트는 현재 모델의 확률 계산과 역전파, 즉 forward와 backward를 포함하는 업데이트 단계입니다. Skywork-OR1 §5.1, Table 7
| 단계 | 보고된 시간 | 전체 309시간에서의 대략적 비중 |
|---|---|---|
| Rollout | 223시간 | 약 72% |
| 정책 업데이트 | 27시간 | 약 9% |
| 기타 | 59시간 | 약 19% |
표의 시간으로 나누면 rollout은 정책 업데이트의 약 8.3배입니다. 이 실행에서는 업데이트 계산만 빨리 하는 것보다 생성 시간을 줄이는 것이 전체 경과시간에 더 큰 영향을 줄 여지가 있습니다.
이는 해당 보고서의 실행 결과입니다. 모든 LLM RL의 시간 비율을 뜻하지 않으며, 별도 실험의 GPU 구성을 이 표에 붙여 일반화해서도 안 됩니다. 비동기로 생성과 학습을 겹치면 단계별 시간을 단순히 더해 전체 시간을 얻을 수도 없습니다. 이 구분은 이후 시스템과 측정 편에서 이어가겠습니다.
다음 글에서는 비교 신호를 얻는 또 하나의 경로를 살펴보겠습니다. 학생이 실제로 생성한 문맥에서 교사 모델의 토큰 확률을 읽고, 그 차이를 학습 신호로 사용하는 on-policy distillation입니다.