공통 · 모델 · 2026-09-29
CED: 인과적 Encoder와 Decoder로 문맥 이어가기
생성 경로와 global·local KV의 출처를 비교하고, sparse 선택과 세 재사용 모드, 시퀀스 압축률, prefill 재계산의 관계를 설명합니다.
YOCO에서는 앞부분이 만든 공통 KV를 뒷부분이 읽었습니다. 덕분에 첫 출력을 위해 뒷부분의 모든 과거 위치를 계산할 필요는 없었습니다. 이 역할 분리를 이해하면 Causal Encoder–Decoder(CED)도 살펴볼 수 있습니다.
이 글은 DeepSeek-V4.1-Flash 보고서의 CED를 다룹니다. Encoder에서 만든 global 정보와 decoder가 직접 만든 local 정보를 함께 사용한다는 점에 주목하겠습니다. 먼저 생성 경로와 KV의 출처를 확인합니다. 이어서 읽을 위치를 고르는 과정과 실제 attention 계산을 나누어 보고, 층 사이에서 무엇을 재사용하는지 살펴봅니다. 마지막으로 decoder 자체의 local 상태 때문에 prefill에 남는 계산을 설명합니다.
전통 Encoder–Decoder와 생성 경로 비교
Encoder와 decoder라는 이름만으로 새 토큰의 경로가 정해지지는 않습니다. 그림 1의 왼쪽은 별도의 입력열과 출력열을 갖는 T5형 구조이고, 오른쪽은 prompt와 생성 결과가 하나의 열로 이어지는 CED입니다.
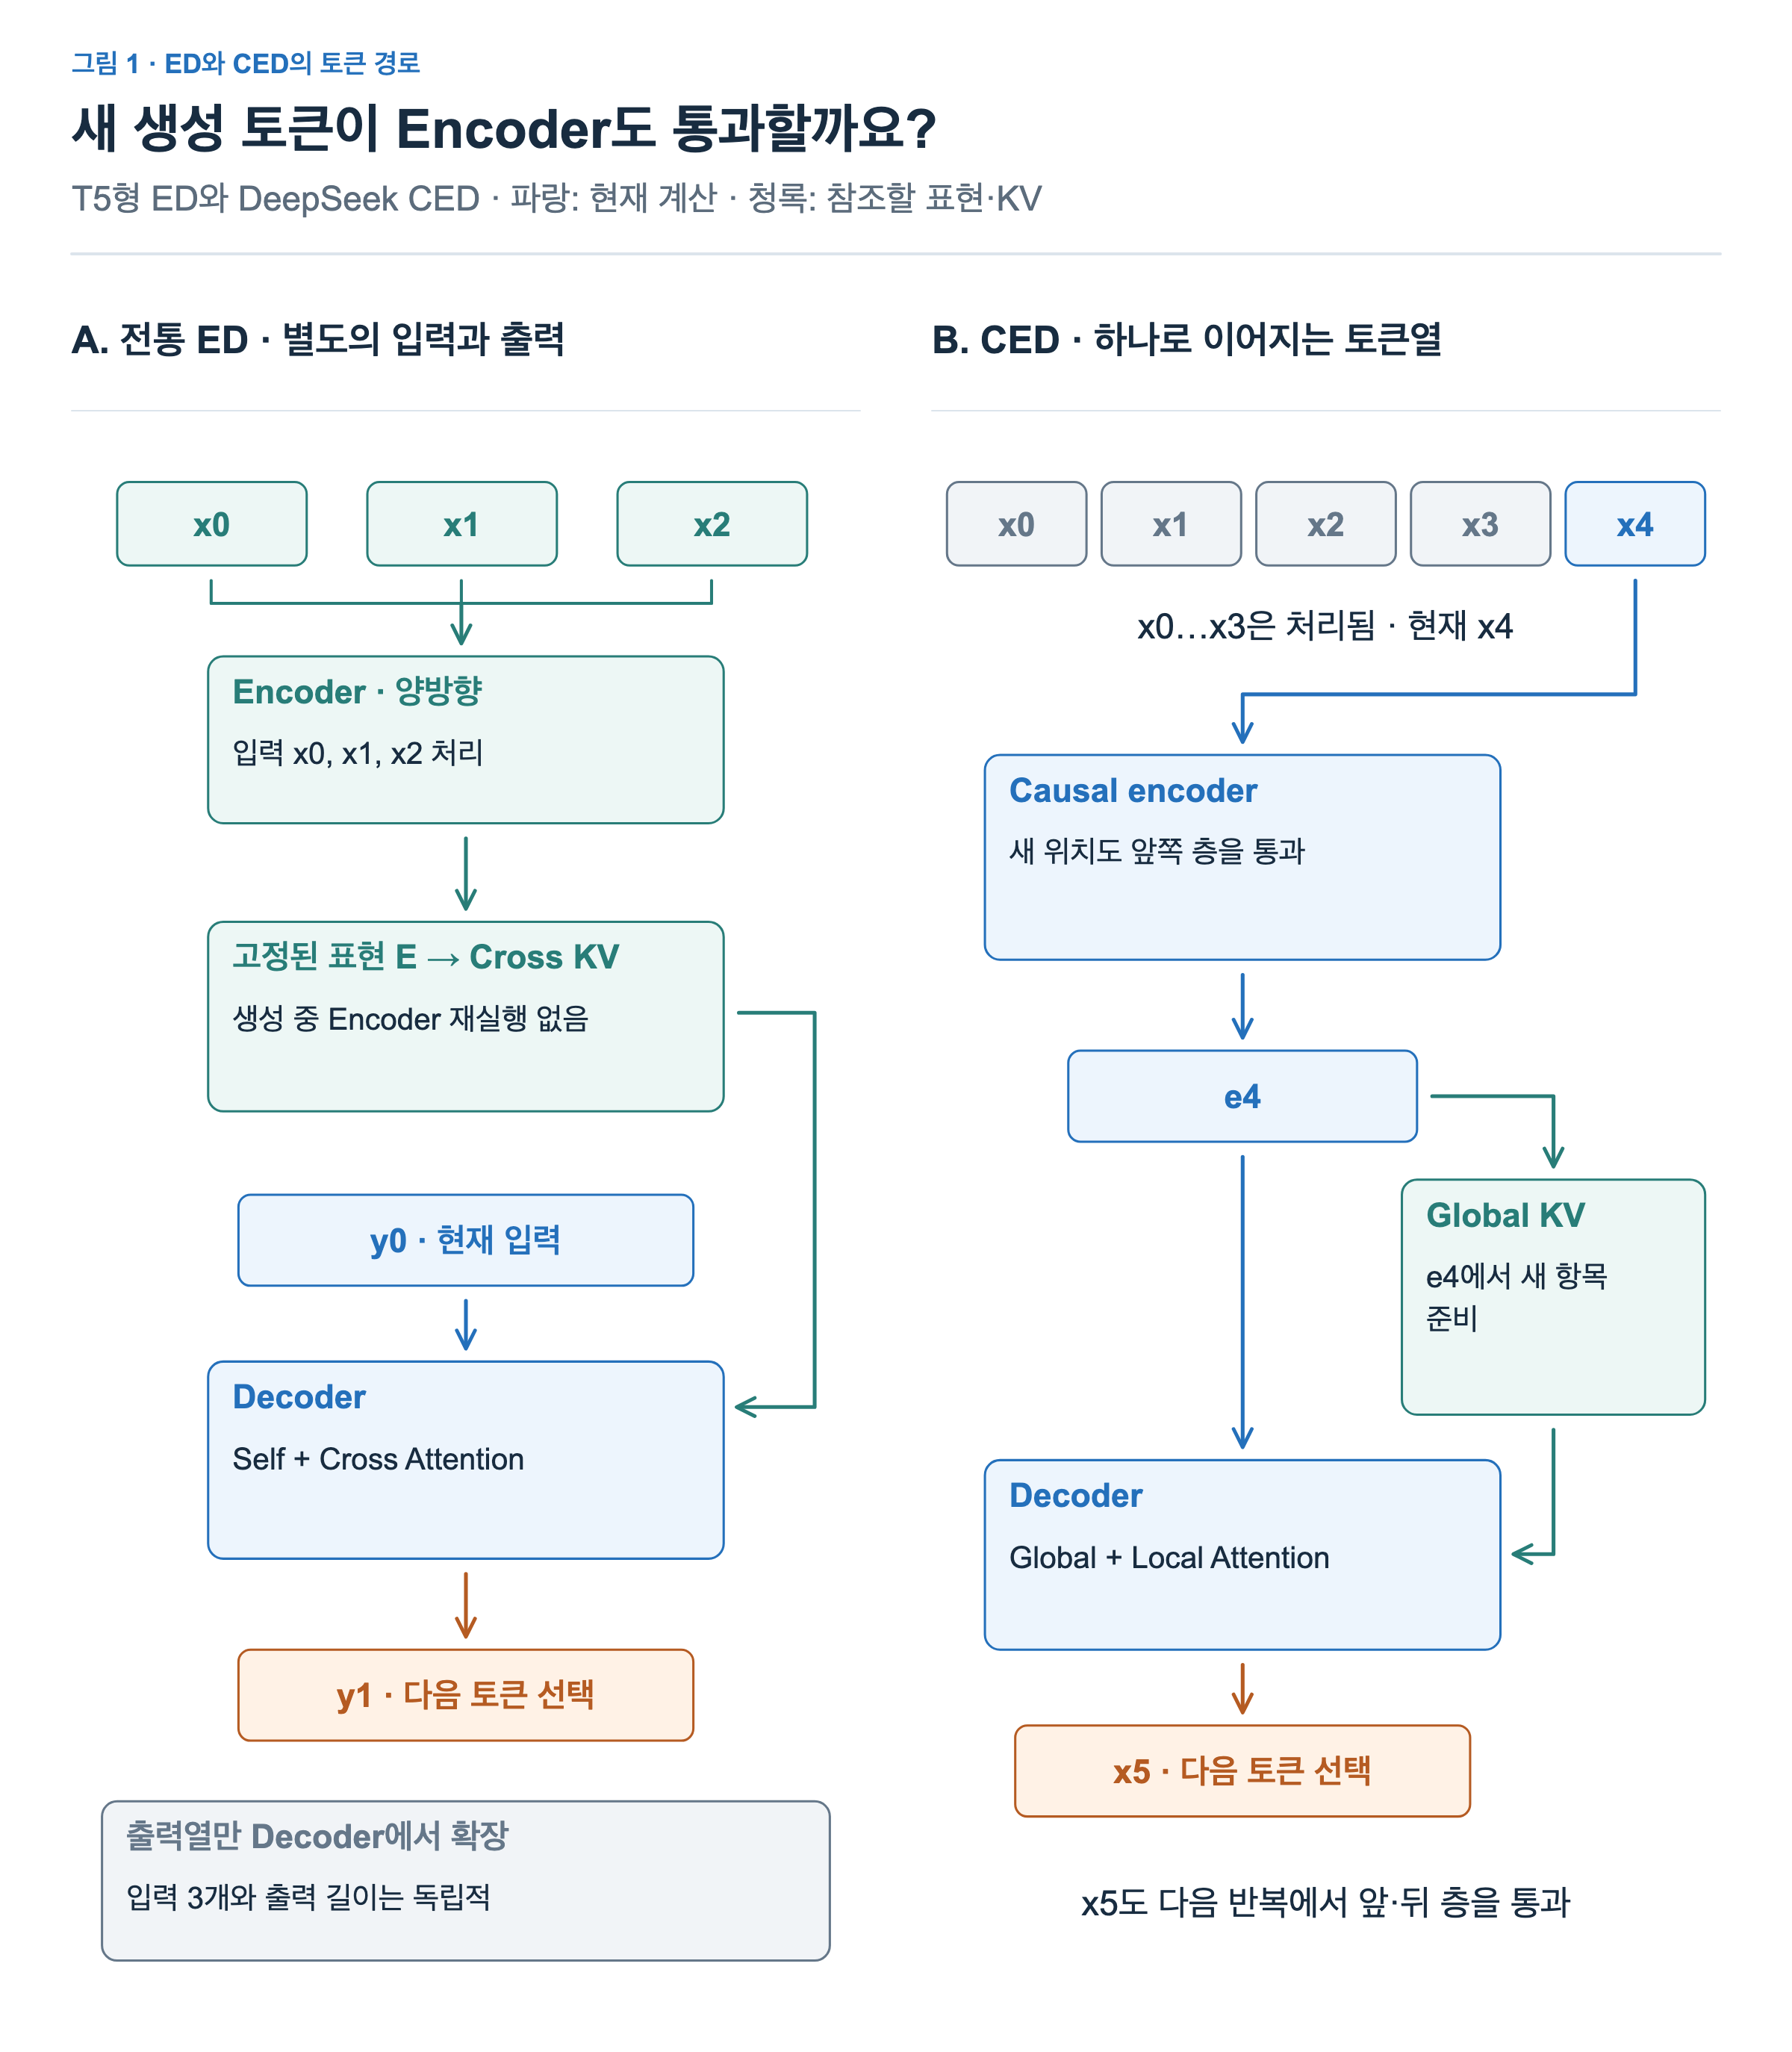
T5형 encoder–decoder의 encoder는 source 전체를 양방향으로 처리합니다. 예를 들어 source의 첫 토큰 표현도 source의 마지막 토큰 정보를 사용할 수 있습니다. 이렇게 만든 source 표현은 target을 생성하는 동안 그대로 참조합니다.
Decoder에는 두 읽기 경로가 있습니다. Causal self-attention은 이전 target 위치들을 읽고, cross-attention은 encoder가 만든 source 정보를 읽습니다. 선택된 target 토큰이 다음 입력이 되면 decoder를 통과합니다. 같은 source를 encoder에서 다시 처리하는 단계가 매 생성 토큰마다 필수로 붙지는 않습니다.
반면 CED에서는 prompt 뒤에 생성 토큰이 이어집니다. 새 토큰이 다음 입력이 되면 causal encoder를 지나고, 그 결과가 decoder로 들어갑니다. 따라서 encoder 쪽에서 만든 문맥도 생성이 진행되면서 확장됩니다. 그림의 회귀 화살표가 돌아가는 위치가 다른 이유입니다.
어느 경우든 토큰을 선택한 시점과 그 토큰을 다음 입력으로 처리한 시점은 다릅니다. 선택 직후에는 새 토큰의 ID만 정해졌습니다. 그 토큰에 대응하는 상태는 다음 실행에서 필요한 층을 지나며 만들어집니다. 그림의 시작 표식과 한 위치씩 이동한 target 표기는 이 예측 순서를 보여주기 위한 것입니다.
하나의 토큰열과 인과적 참조
이번에는 화살표를 위치 격자로 바꾸어 보겠습니다. 그림 2의 행은 읽는 Query 위치이고, 열은 참조할 Key 위치입니다. 위 격자는 encoder 내부의 관계, 아래 격자는 decoder가 encoder 쪽 정보를 읽는 관계입니다.
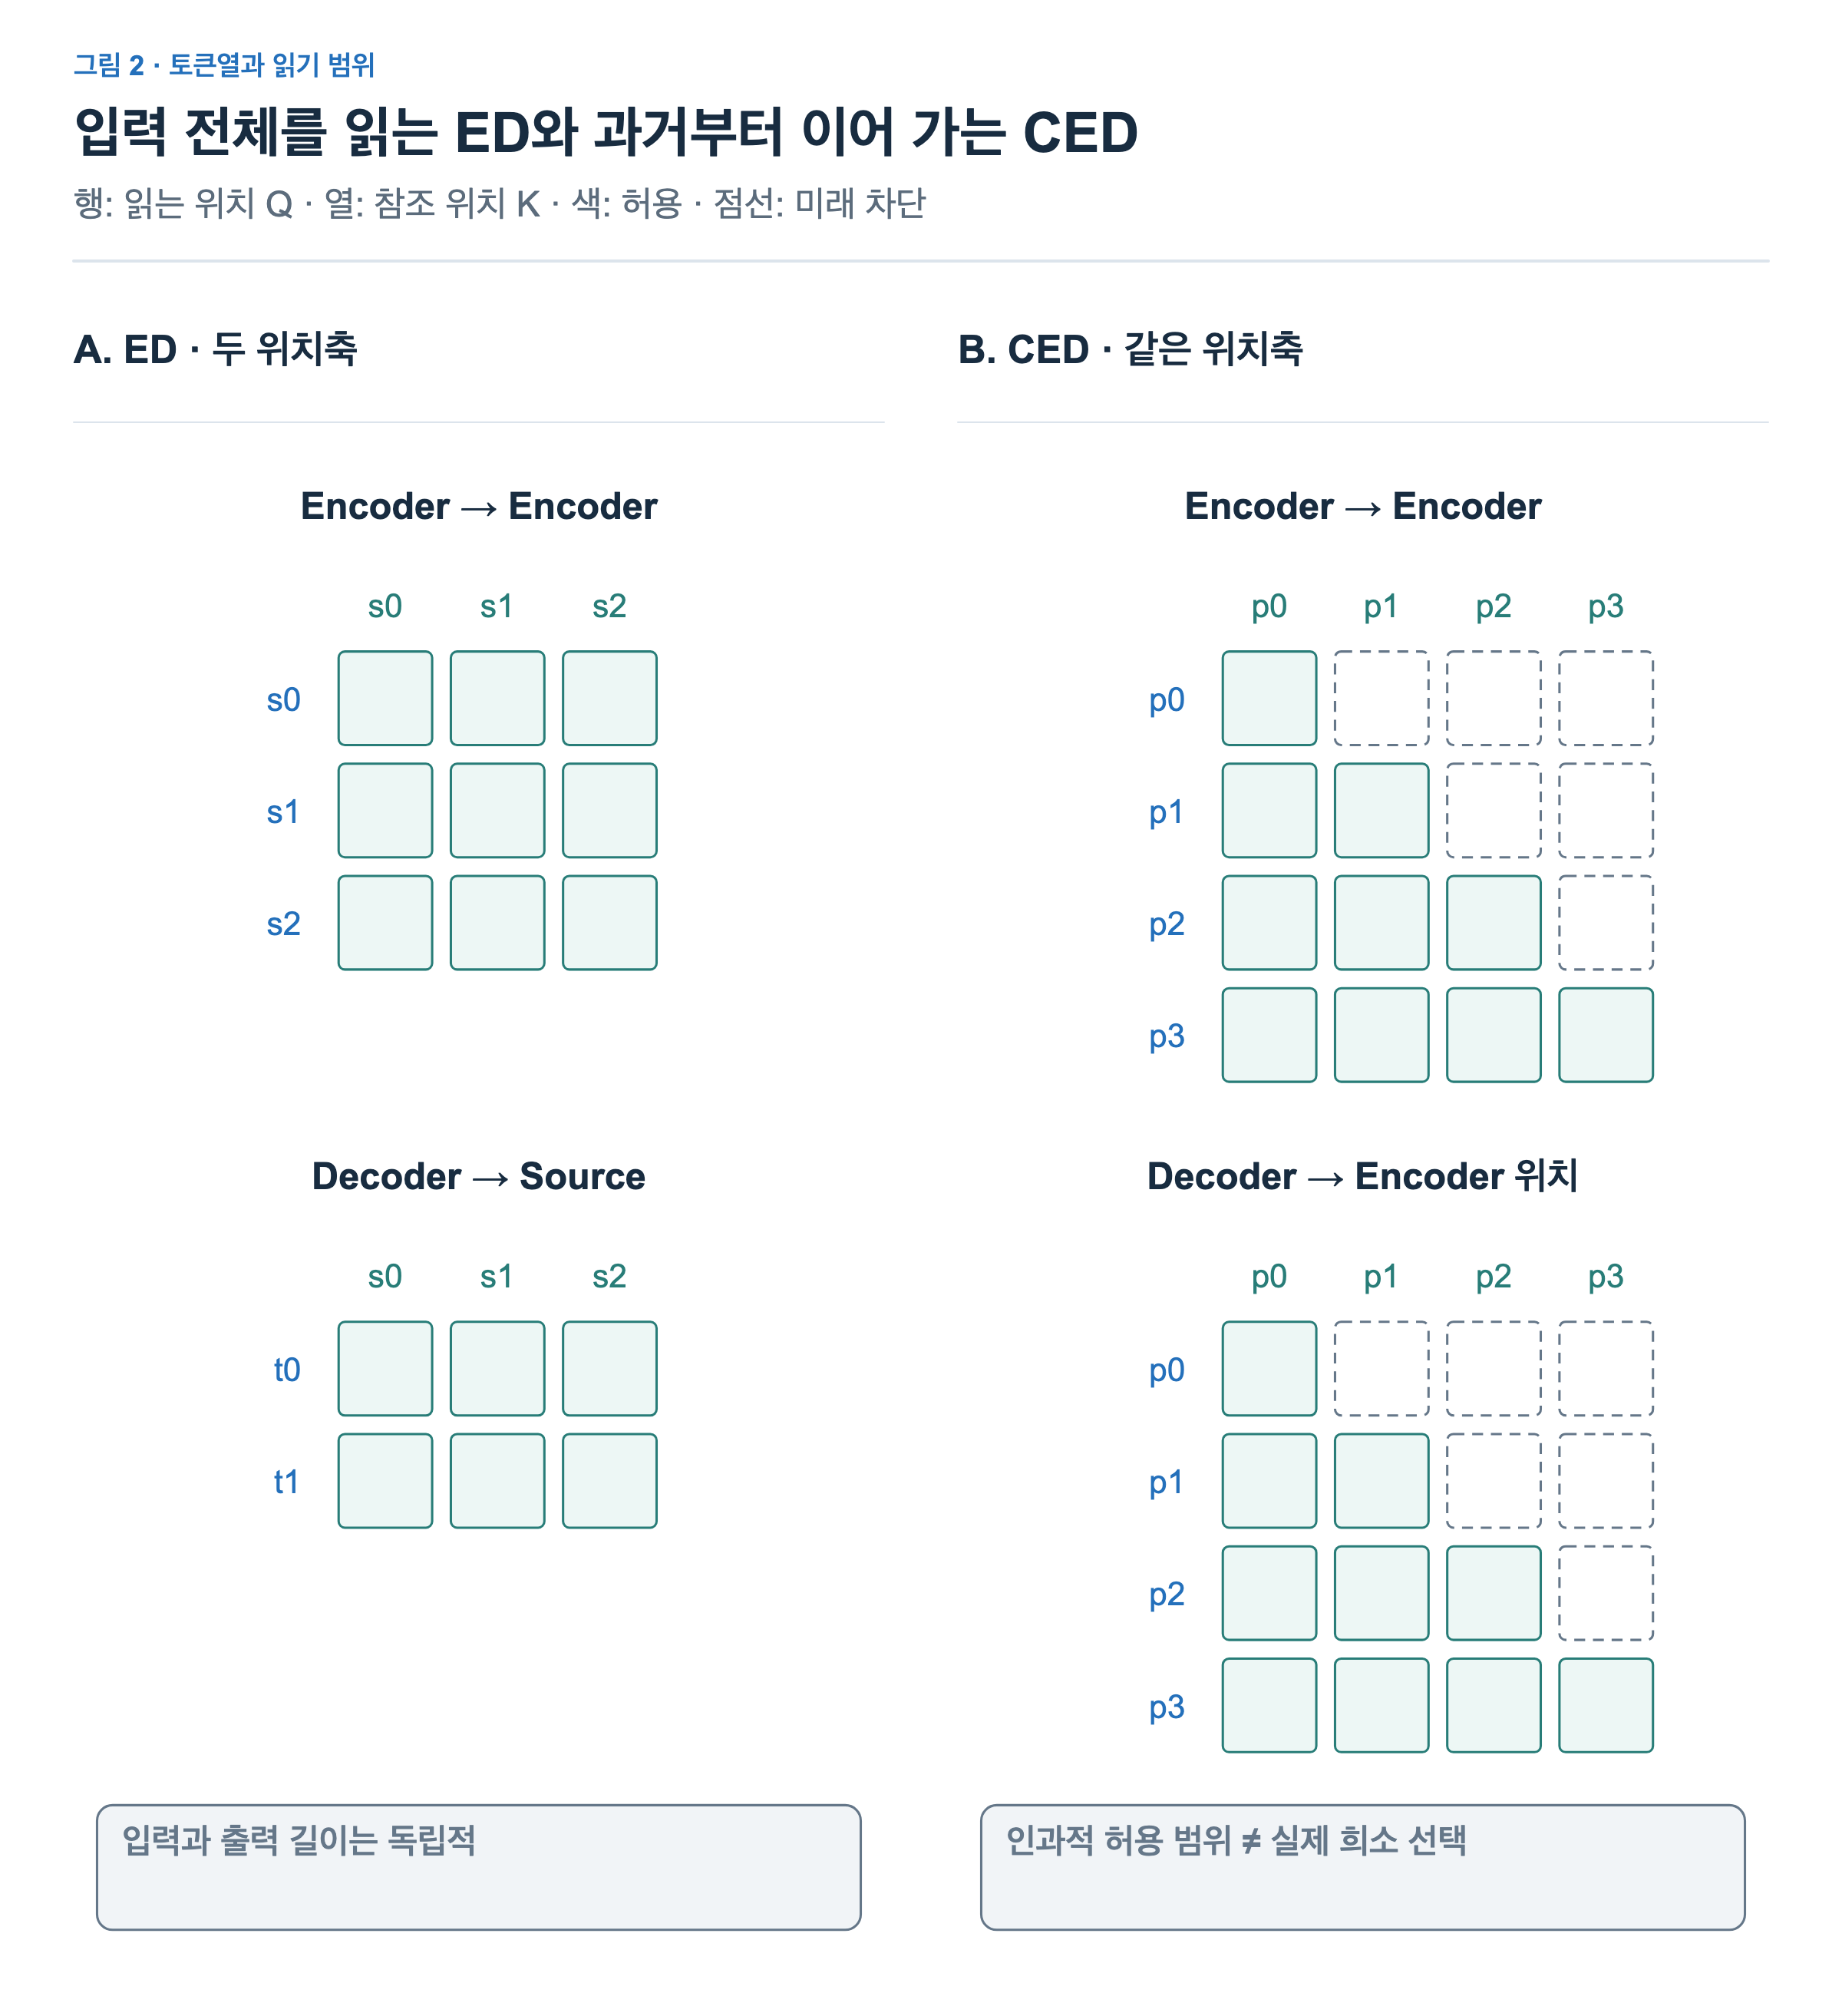
왼쪽 예시는 source 세 위치와 target 두 위치입니다. Source와 target은 길이도 독립적이고, 위치 번호가 같다고 서로 대응하는 단어일 필요도 없습니다. 각 target Query는 encoder가 준비한 source 전체를 읽을 수 있습니다. 이는 아직 생성하지 않은 target 정답을 읽는 것과는 다릅니다.
오른쪽에서는 encoder와 decoder가 같은 토큰열을 처리합니다. p2에서 사용하는 encoder 정보는 p2까지의 입력으로 만들어져야 합니다. p3의 정보를 p2에 넣으면 다음 토큰 예측에서 미래가 새어 들어갑니다. 그래서 현재 위치와 그 이전을 허용하고 미래를 막는 삼각형이 나타납니다.
이 그림은 인과적으로 허용되는 원래 위치 관계를 보여줍니다. 희소 attention이 실제로 선택한 항목 목록은 아닙니다. 삼각형 안에 있다는 것은 읽어도 인과성을 지킨다는 뜻이지, 그 위치를 모두 읽는다는 뜻은 아닙니다.
Global KV의 공유와 층별 Local KV
그림 3은 실제 decoder의 공통 저장소와 층별 계산을 나누어 보여줍니다. 왼쪽은 여러 층이 함께 읽을 값을 준비하는 경로이고, 오른쪽은 각 층에서 새로 처리하는 경로입니다.
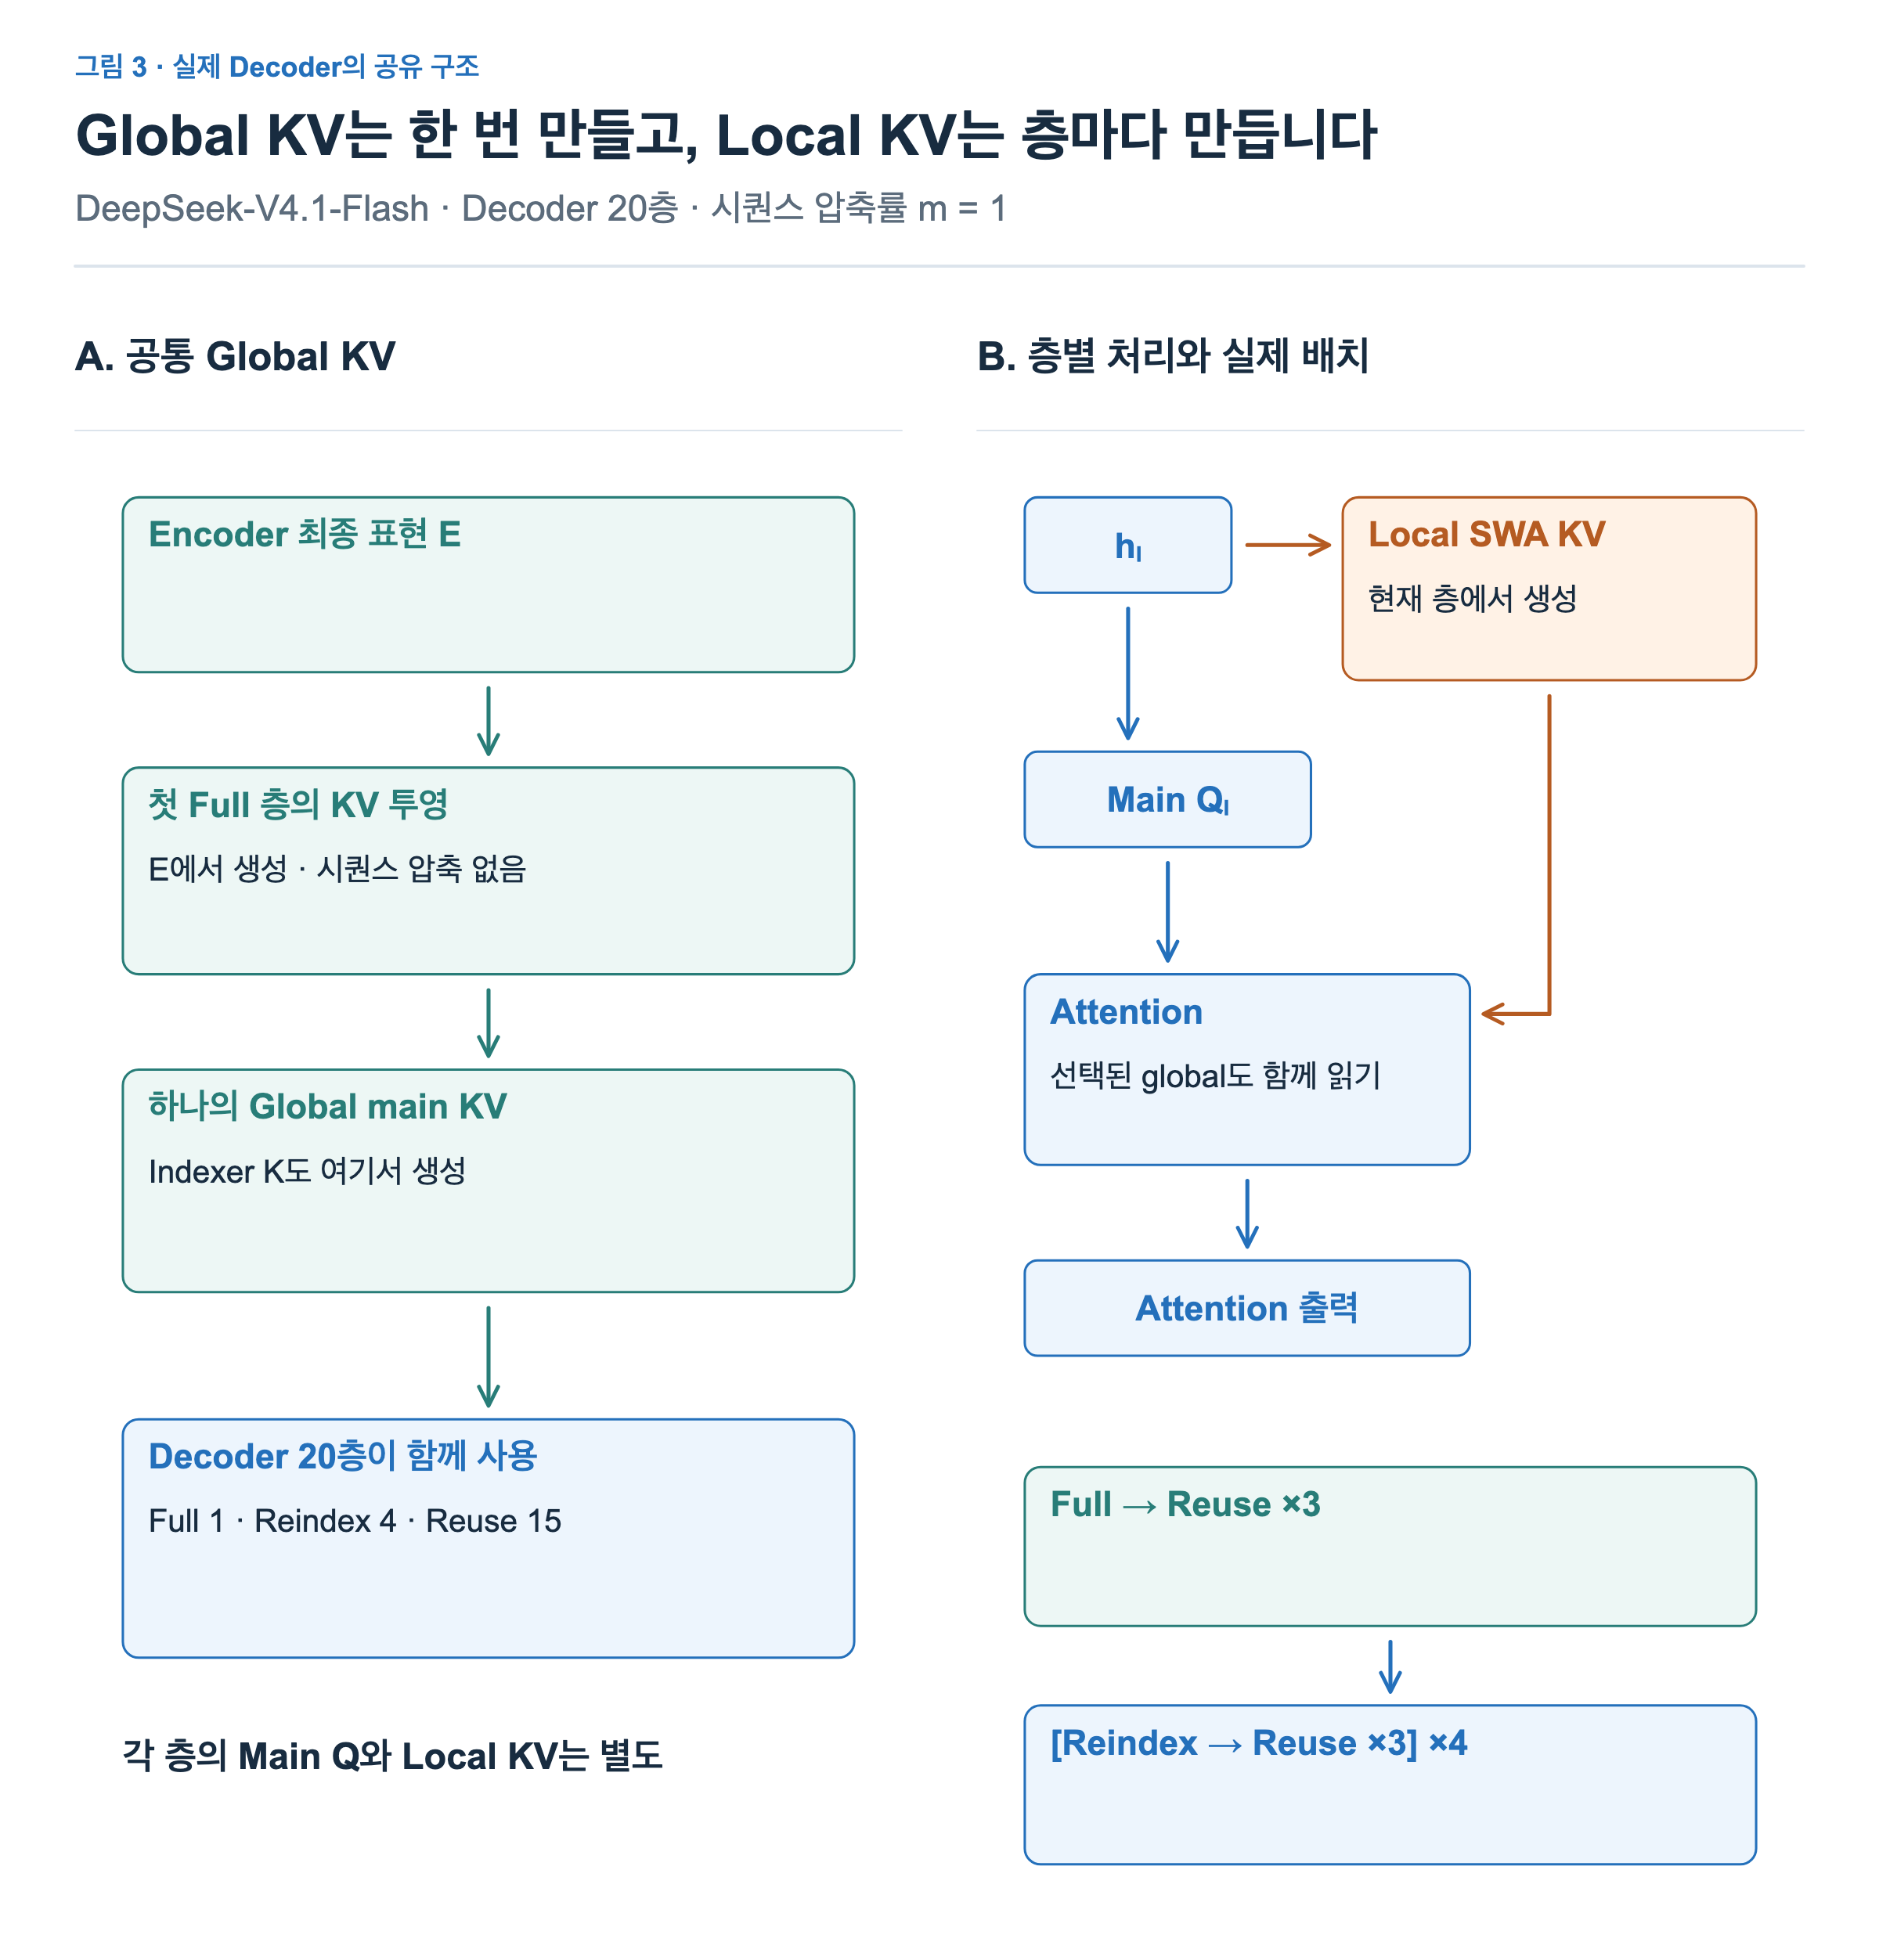
CED의 global KV는 encoder의 마지막 hidden state E를 투영해 만듭니다. Local KV는 각 decoder 층의 자체 hidden state에서 나옵니다. 따라서 encoder가 처리한 긴 문맥과 decoder가 깊이별로 처리한 최근 문맥을 함께 읽을 수 있습니다.
여기서 같은 E를 입력으로 받는 것과, 투영이 끝난 KV 값을 그대로 공유하는 것은 다릅니다. 같은 자료를 서로 다른 변환에 넣으면 결과도 달라질 수 있습니다. CED의 일반식은 층별 투영을 허용하지만, 그림 3의 실제 배치에서는 첫 decoder 층이 만든 global KV를 나머지 decoder 층도 공유합니다. 층별 재사용 방식은 뒤에서 살펴보겠습니다.
반면 오른쪽의 Main Q와 Local KV는 층마다 새로 만듭니다. 그림의 h는 원래 입력 임베딩이 아니라 현재 층에 들어온 hidden state입니다. 같은 토큰도 앞선 층을 거치면 표현이 달라지므로, 공유 KV를 읽는 Query와 최근 위치에 보관할 Local KV가 층마다 달라집니다.
가령 두 번째 decoder 층의 local KV를 만들려면 첫 번째 층을 거친 표현이 필요합니다. E가 준비되었다고 두 번째 층의 local KV까지 준비된 것은 아닙니다. 이 차이는 마지막 절에서 prefill의 계산 범위를 판단할 때 중요해집니다.
시퀀스 압축률은 무엇을 줄일까요?
그림 3의 시퀀스 압축률 m은 원래 토큰 위치 수에 비해 global main KV 항목 수를 얼마나 줄이는가를 나타냅니다. CSA2에서 m=2라면 두 위치의 정보를 한 항목으로 묶습니다. 완성된 묶음만 생각하는 교육용 예시로, 8개 위치는 8 ÷ 2 = 4개 항목이 됩니다. m=1이면 8개 위치에 8개 항목을 유지합니다. 입력 문장 자체를 짧게 바꾸는 것이 아닙니다.
실제 설정은 encoder의 CSA2에 m=2, decoder에는 m=1을 사용합니다. 따라서 이 글의 decoder 그림에서는 p0부터 p5까지 여섯 위치를 여섯 global 항목으로 그렸습니다. Encoder 내부의 압축 캐시를 decoder에 그대로 넘기는 것도 아닙니다. Decoder의 출발점은 E입니다.
저장 공간을 줄이는 방법은 적용하는 축으로 구별하면 쉽습니다. 시퀀스 압축은 항목 수를 줄이고, FP4 같은 양자화는 항목 안 숫자의 저장 비트 수를 줄입니다. 층간 공유는 같은 항목 묶음을 따로 보관하는 층의 수를 줄입니다.
위치 선택과 Attention의 값 읽기
그림 4에서는 현재 위치를 p5, 선택 수를 Top-2, local window를 2로 줄였습니다. Indexer는 읽을 위치를 고르고, Main attention은 그 위치의 값을 읽습니다. 두 단계에서 쓰는 Query를 구별해 보겠습니다.
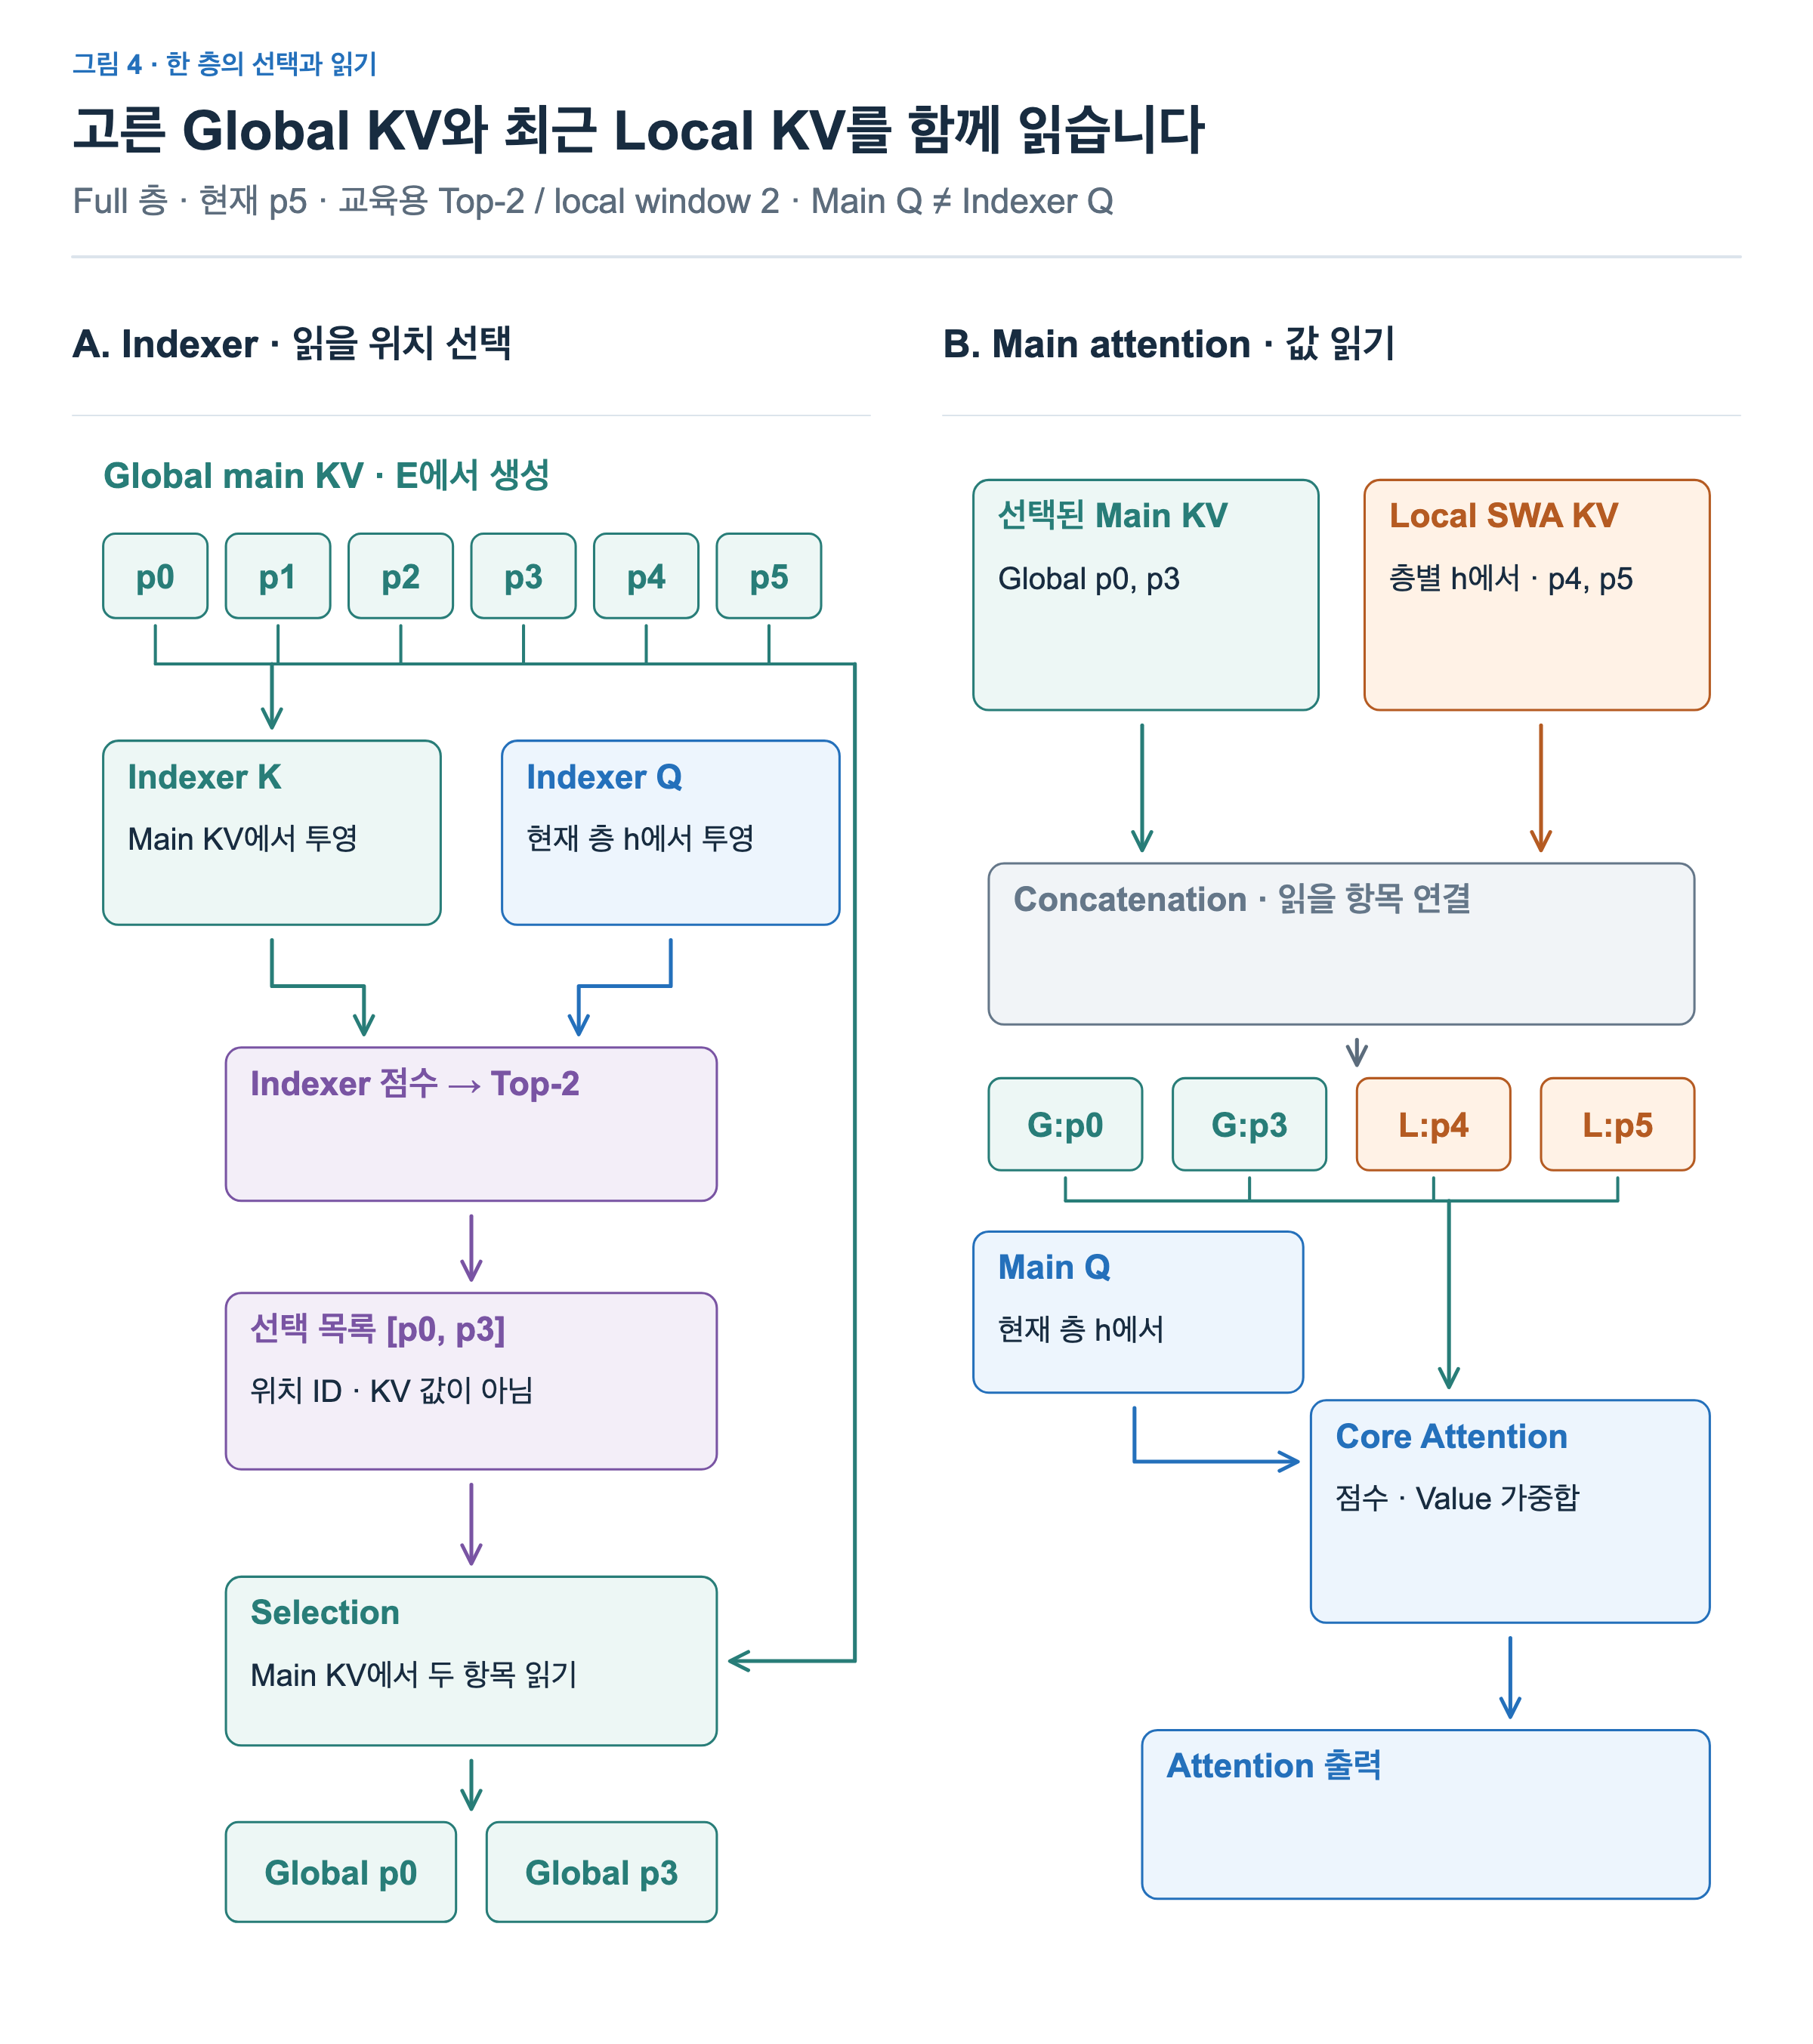
왼쪽의 Indexer Q는 현재 층의 h에서, Indexer K는 global main KV에서 만듭니다. Indexer가 고른 결과를 [p0, p3]이라고 하겠습니다. 이 목록에는 읽을 위치의 번호가 들어 있습니다. 아직 두 위치의 Value를 섞은 attention 출력이 나온 것은 아닙니다.
Selection은 그 번호로 global main KV에서 p0와 p3의 항목을 가져옵니다. 오른쪽에서는 여기에 최근 p4와 p5의 local KV를 연결합니다. Main Q는 이 네 항목에 대한 attention 점수를 계산하고, 그 비중으로 Value를 합쳐 출력을 만듭니다. Global KV도 실제로 읽는 값이며, 선택용 정보에 그치지 않습니다. Indexer Q와 Main Q는 같은 h에서 출발하더라도 역할과 투영이 다릅니다.
그림에서는 선택된 global 위치와 local 위치를 겹치지 않게 골랐습니다. 이해를 위한 예시일 뿐, global은 오래된 위치만 맡는다는 뜻은 아닙니다. 같은 위치가 양쪽에 포함되더라도 별도 경로의 KV입니다. Global은 E에서 만들고, local은 해당 decoder 층의 h에서 만듭니다.
논문의 Figure 4도 선택된 main KV와 SWA KV를 연결한 뒤 Core Attention에 넣습니다. 실제 모델의 선택 수는 Top-512, SWA window는 128입니다. 그림의 Top-2와 window 2는 연산 관계를 읽기 위한 축소 값입니다.
Full·Reindex·Reuse가 재사용하는 것
KV 값과 읽을 위치 목록은 서로 다른 대상입니다. 값을 공유하면서 위치를 다시 고를 수도 있고, 둘 다 공유할 수도 있습니다. 그림 5는 이 차이를 같은 배치에서 비교합니다.
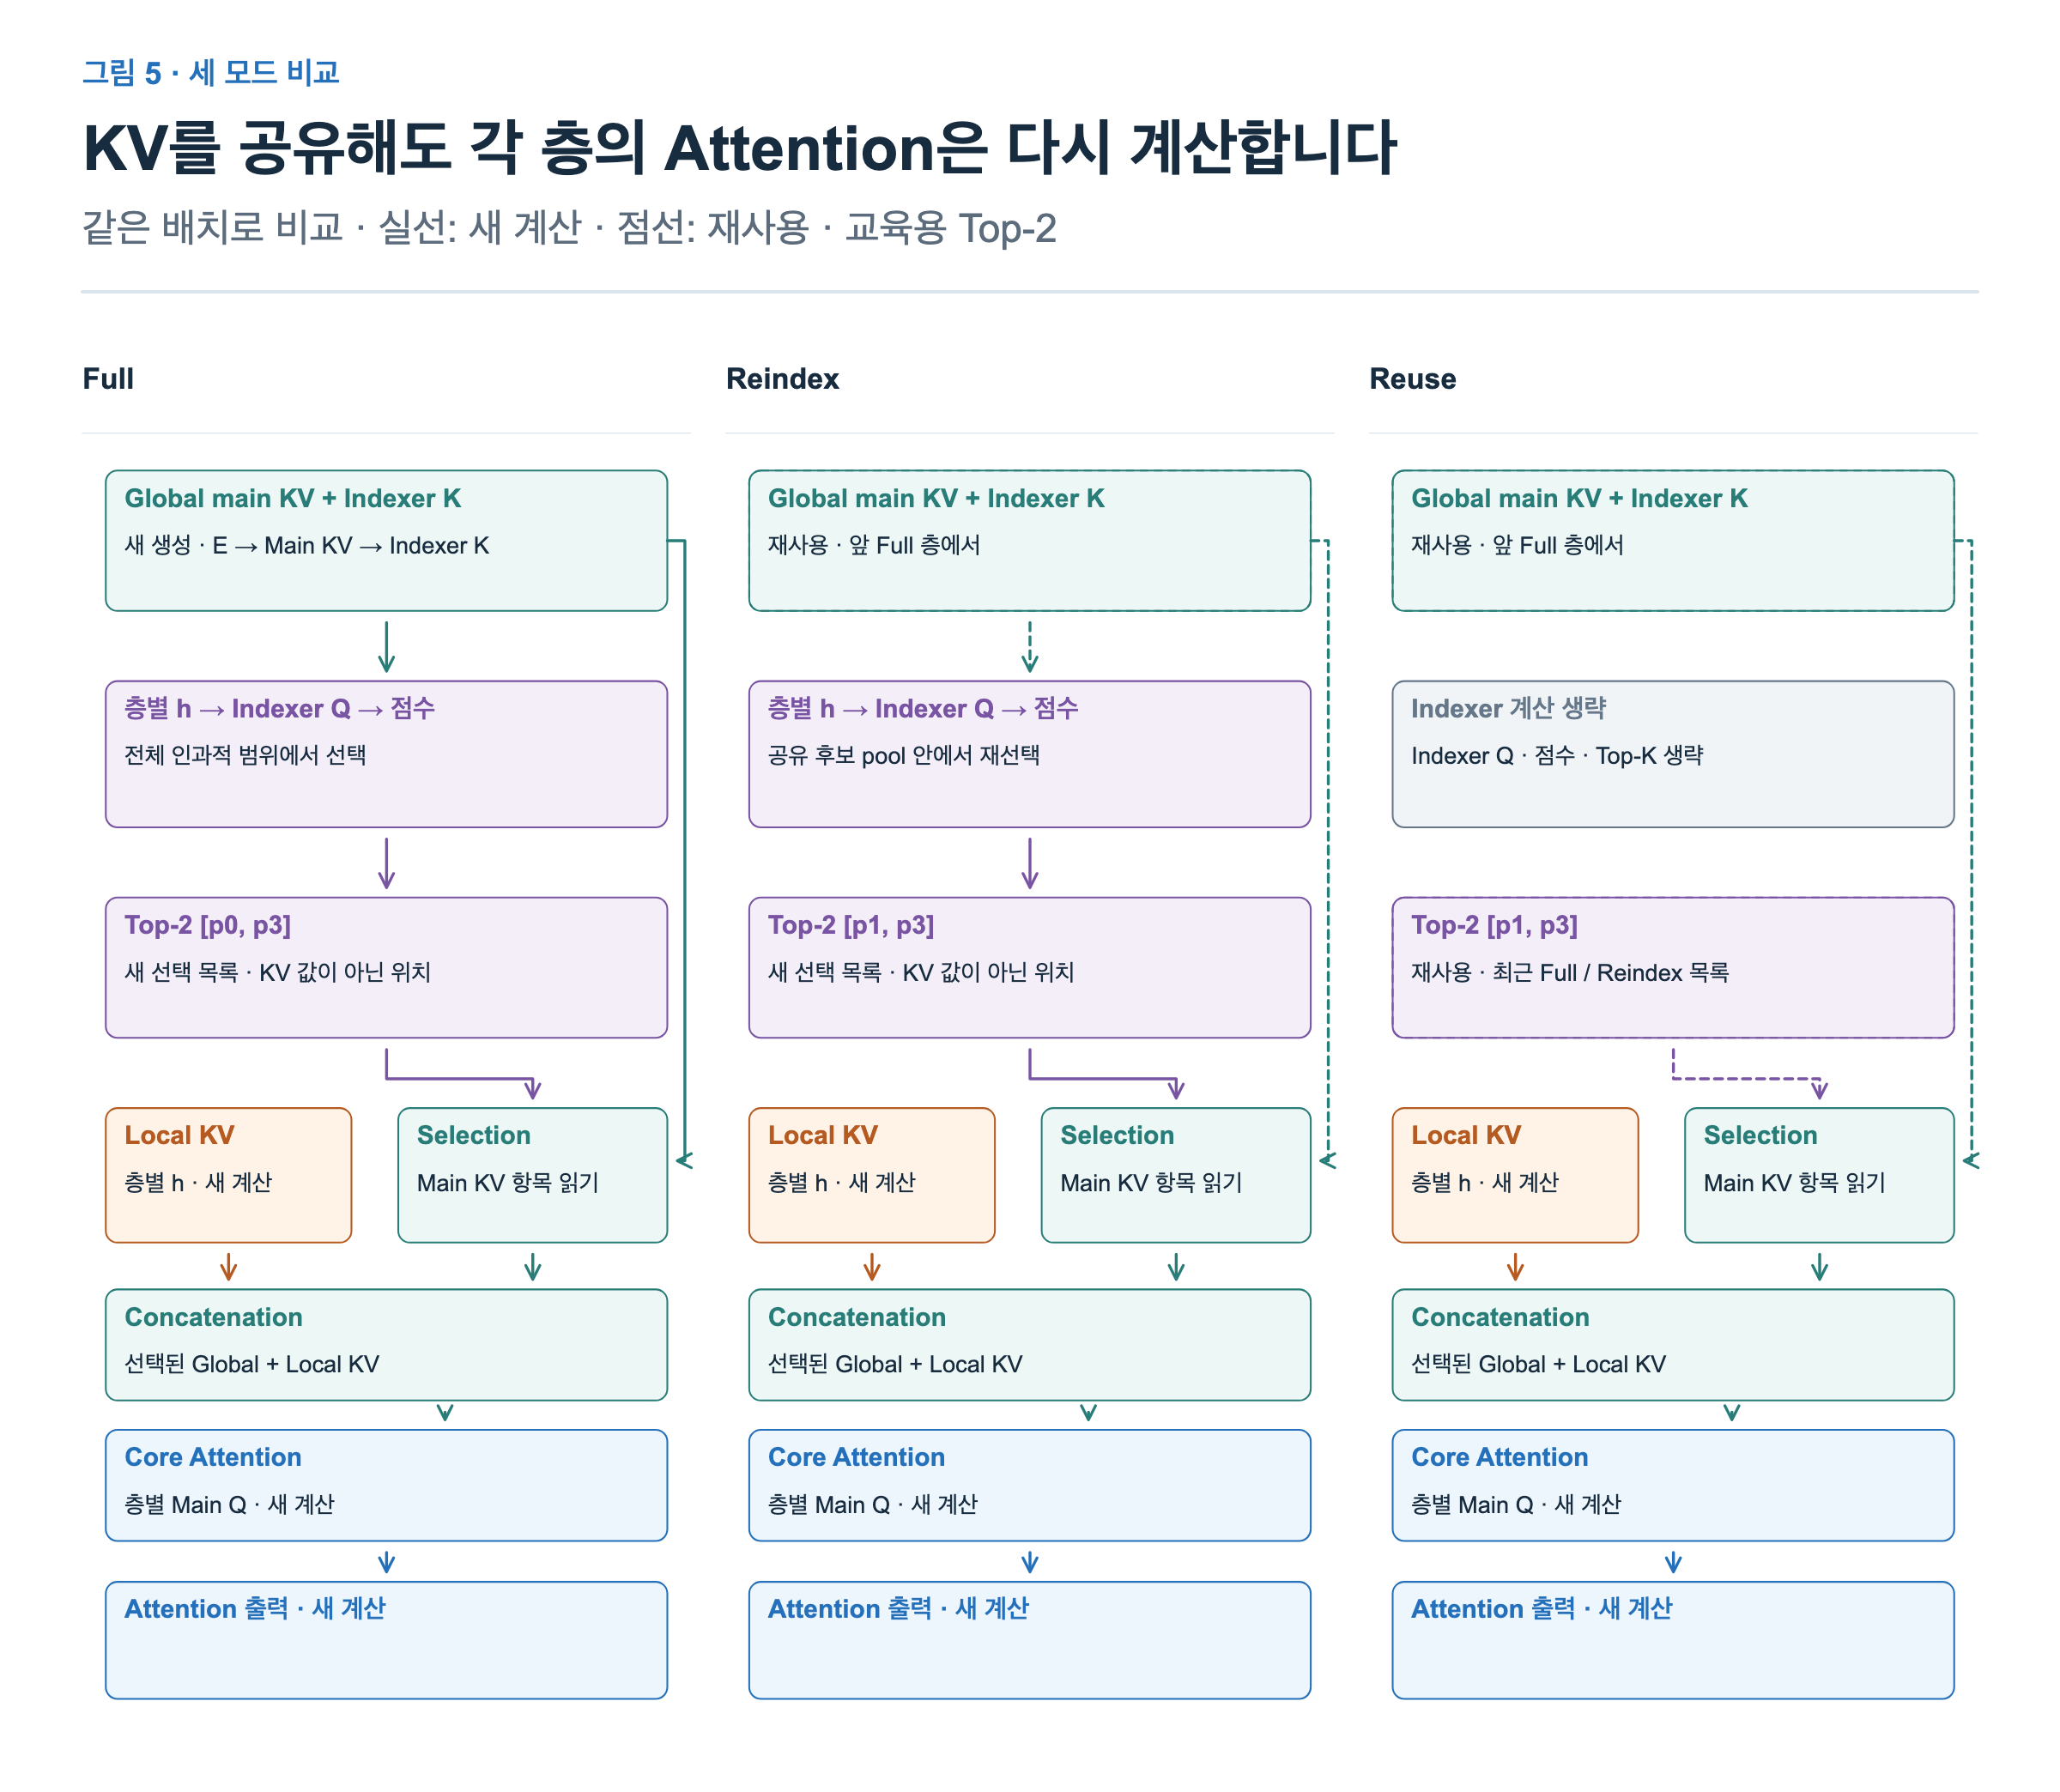
CSA2의 모드는 층마다 미리 지정됩니다. 토큰을 볼 때마다 세 모드 중 하나를 고르는 라우터가 있다는 뜻은 아닙니다.
- Full은 global main KV와 indexer K를 만들고, 자신의 Indexer Q로 새 선택 목록을 계산합니다.
- Reindex는 앞선 Full의 KV를 읽되, 자신의 Indexer Q로 위치를 다시 고릅니다.
- Reuse는 KV와 가장 최근 Full 또는 Reindex의 선택 목록을 함께 재사용합니다. Indexer Q·점수·Top-K 계산은 생략합니다.
그림의 예에서는 Full이 p0와 p3을 골랐고, Reindex는 p1과 p3을 골랐습니다. 뒤의 Reuse는 p1과 p3을 그대로 읽습니다. 다만 같은 목록을 쓴다고 attention 출력까지 복사하지는 않습니다. 모든 모드가 각 층의 Main Q와 Local KV로 attention을 다시 계산합니다.
Reindex의 검색 범위에도 제한이 있습니다. Hierarchical Sparse Indexer는 첫 Full이 만든 공유 후보 pool 안에서 뒤의 Reindex가 다시 고르게 합니다. 후보 pool은 최종 Top-K 목록보다 넓은 검색 대상입니다. 앞 층이 최종 선택한 두 위치만 두고 순서를 바꾸는 것이 아니므로, 그림처럼 p0 대신 p1을 새로 고를 수 있습니다.
실제 decoder 20층의 순서는 [Full + Reuse 3층] 뒤에 [Reindex + Reuse 3층]을 네 번 배치합니다. 합계는 Full 1층, Reindex 4층, Reuse 15층입니다. 그림 5의 세 패널은 모드별 비교이며, 세 모드가 매번 연속해서 반복된다는 뜻은 아닙니다.
이 구조에서 KV 공유는 저장 공간을 줄이고, 선택 목록 공유는 indexer 계산을 줄입니다. Reindex는 저장소를 더 만들지 않으면서 읽을 위치를 바꿀 기회를 남깁니다. Main attention과 층별 local 계산은 계속 수행합니다.
Prefill에서 최근 구간을 다시 계산하는 이유
그림 6도 prompt 여섯 위치 p0부터 p5까지를 사용합니다. 앞뒤 각각 두 층, 최근 재계산 구간 W=2라는 교육용 조건입니다. 칸은 attention mask가 아니라 실행할 Query 위치입니다.
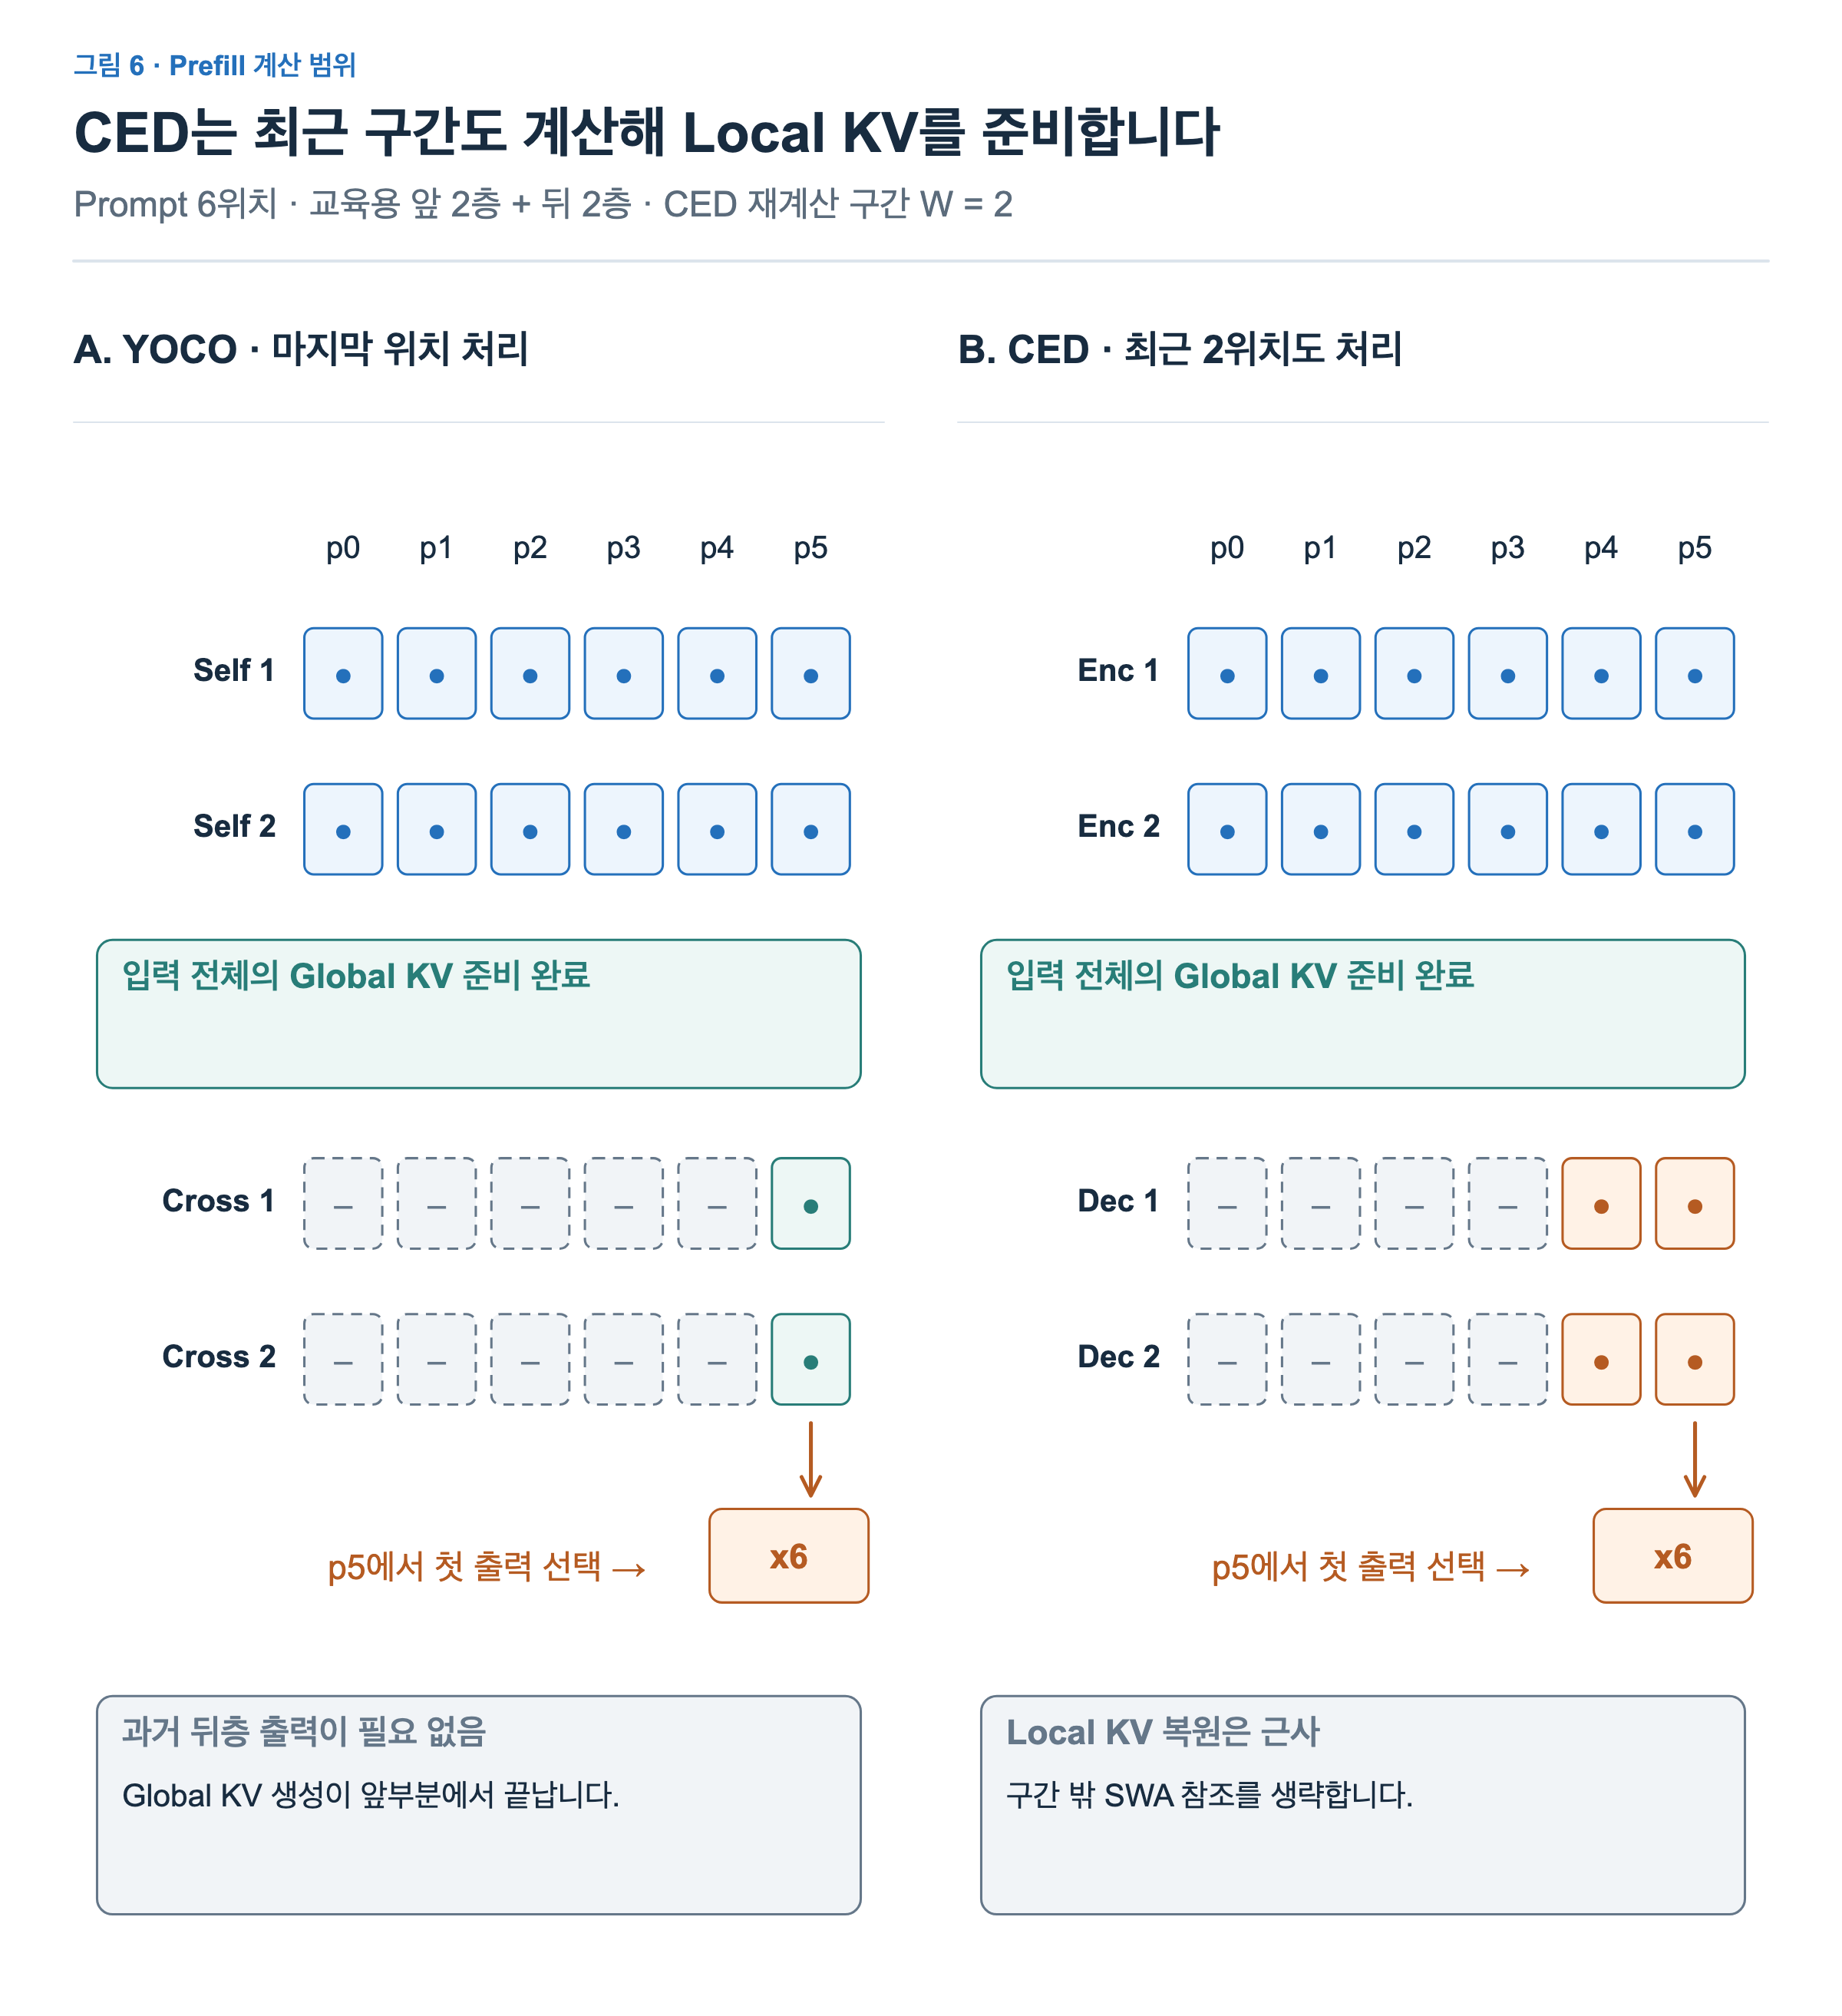
YOCO 쪽은 앞부분에서 global KV를 준비한 뒤, p5만 cross-decoder의 두 층을 통과시켜 첫 생성 토큰을 선택할 수 있습니다. CED 쪽도 global KV의 원천은 앞부분에 있지만, decoder 자체의 local KV가 추가로 필요합니다. 그림에서는 최근 p4와 p5를 decoder에 다시 넣어 그 상태를 준비합니다.
여기에는 정확성의 경계가 있습니다. 최근 구간만 다시 처리하는 bounded replay는 전체 decoder 실행과 수학적으로 같은 상태를 복원하는 방법이 아닙니다. 보고서 §3.2.2는 재계산 구간 밖의 SWA 참조를 잘라 근사 상태를 구성합니다.
왜 window 길이만큼만 계산한다고 자동으로 정확해지지 않을까요? 교육용으로 최근 두 위치를 읽는 층을 생각해 보겠습니다. p5의 두 번째 층이 읽는 p4의 표현은 첫 번째 층에서 p3의 영향을 받았을 수 있습니다. 그런데 재계산을 p4에서 시작하며 그 이전 local 참조를 막으면, p4의 표현부터 전체 실행 때와 달라질 수 있습니다. 층을 거치며 의존 범위가 누적되기 때문입니다.
Bounded replay는 이 차이를 허용하는 대신 긴 prompt의 나머지 decoder 계산을 줄이는 선택입니다.
첫 출력을 고른 다음에는 선택된 토큰을 새 입력으로 넣어 encoder와 decoder를 모두 실행합니다. 각 층의 local 상태를 갱신하고, 새 위치의 E에서 만든 decoder global KV도 추가합니다.
세 글을 연결하면 비교할 기준이 분명해집니다. CLA에서는 같은 KV를 몇 층이 읽는지, YOCO에서는 과거 뒤층 출력 없이 공통 KV를 준비할 수 있는지, CED에서는 encoder 기반 global 경로와 decoder 자체 local 경로가 어떤 상태를 요구하는지를 보았습니다. 재사용의 범위뿐 아니라 나중에 필요한 상태를 누가 만들어야 하는가까지 확인해야 계산 생략을 판단할 수 있습니다.