공통 · 모델 · 2026-09-29
YOCO: 공통 KV를 만드는 층과 읽는 층 나누기
앞부분의 공통 KV를 뒷부분이 읽는 구조와 새 토큰의 처리 순서를 따라가며, 첫 출력에 불필요한 prefill 계산을 생략하는 이유를 설명합니다.
층간 KV 공유에서는 앞선 층이 만든 Key와 Value를 다음 층도 읽었습니다. YOCO(You Only Cache Once)는 이 역할을 모델의 앞뒤로 나눕니다. 앞부분이 문맥을 담은 공통 KV를 준비하고, 뒷부분의 여러 층이 그 값을 읽습니다.
이렇게 나누면 저장 공간뿐 아니라 계산의 의존성도 달라집니다. 앞부분만으로 과거의 KV를 준비할 수 있다면, 첫 답변을 위해 뒷부분의 모든 과거 위치까지 계산할 필요가 있을까요? 구조와 attention 연산을 먼저 살펴보고, 새 토큰을 처리하는 과정과 prompt를 처음 읽는 과정을 나누어 답해 보겠습니다. 마지막에는 문맥이 길어질 때 앞부분의 상태와 공통 KV의 저장량이 어떻게 달라지는지 비교합니다.
공통 KV를 만드는 앞부분과 읽는 뒷부분
YOCO 논문 §2는 앞부분을 self-decoder, 뒷부분을 cross-decoder라고 부릅니다. 두 부분 모두 같은 토큰열을 인과적으로 처리합니다. 그림 1은 각각 두 층으로 줄인 교육용 구조입니다.
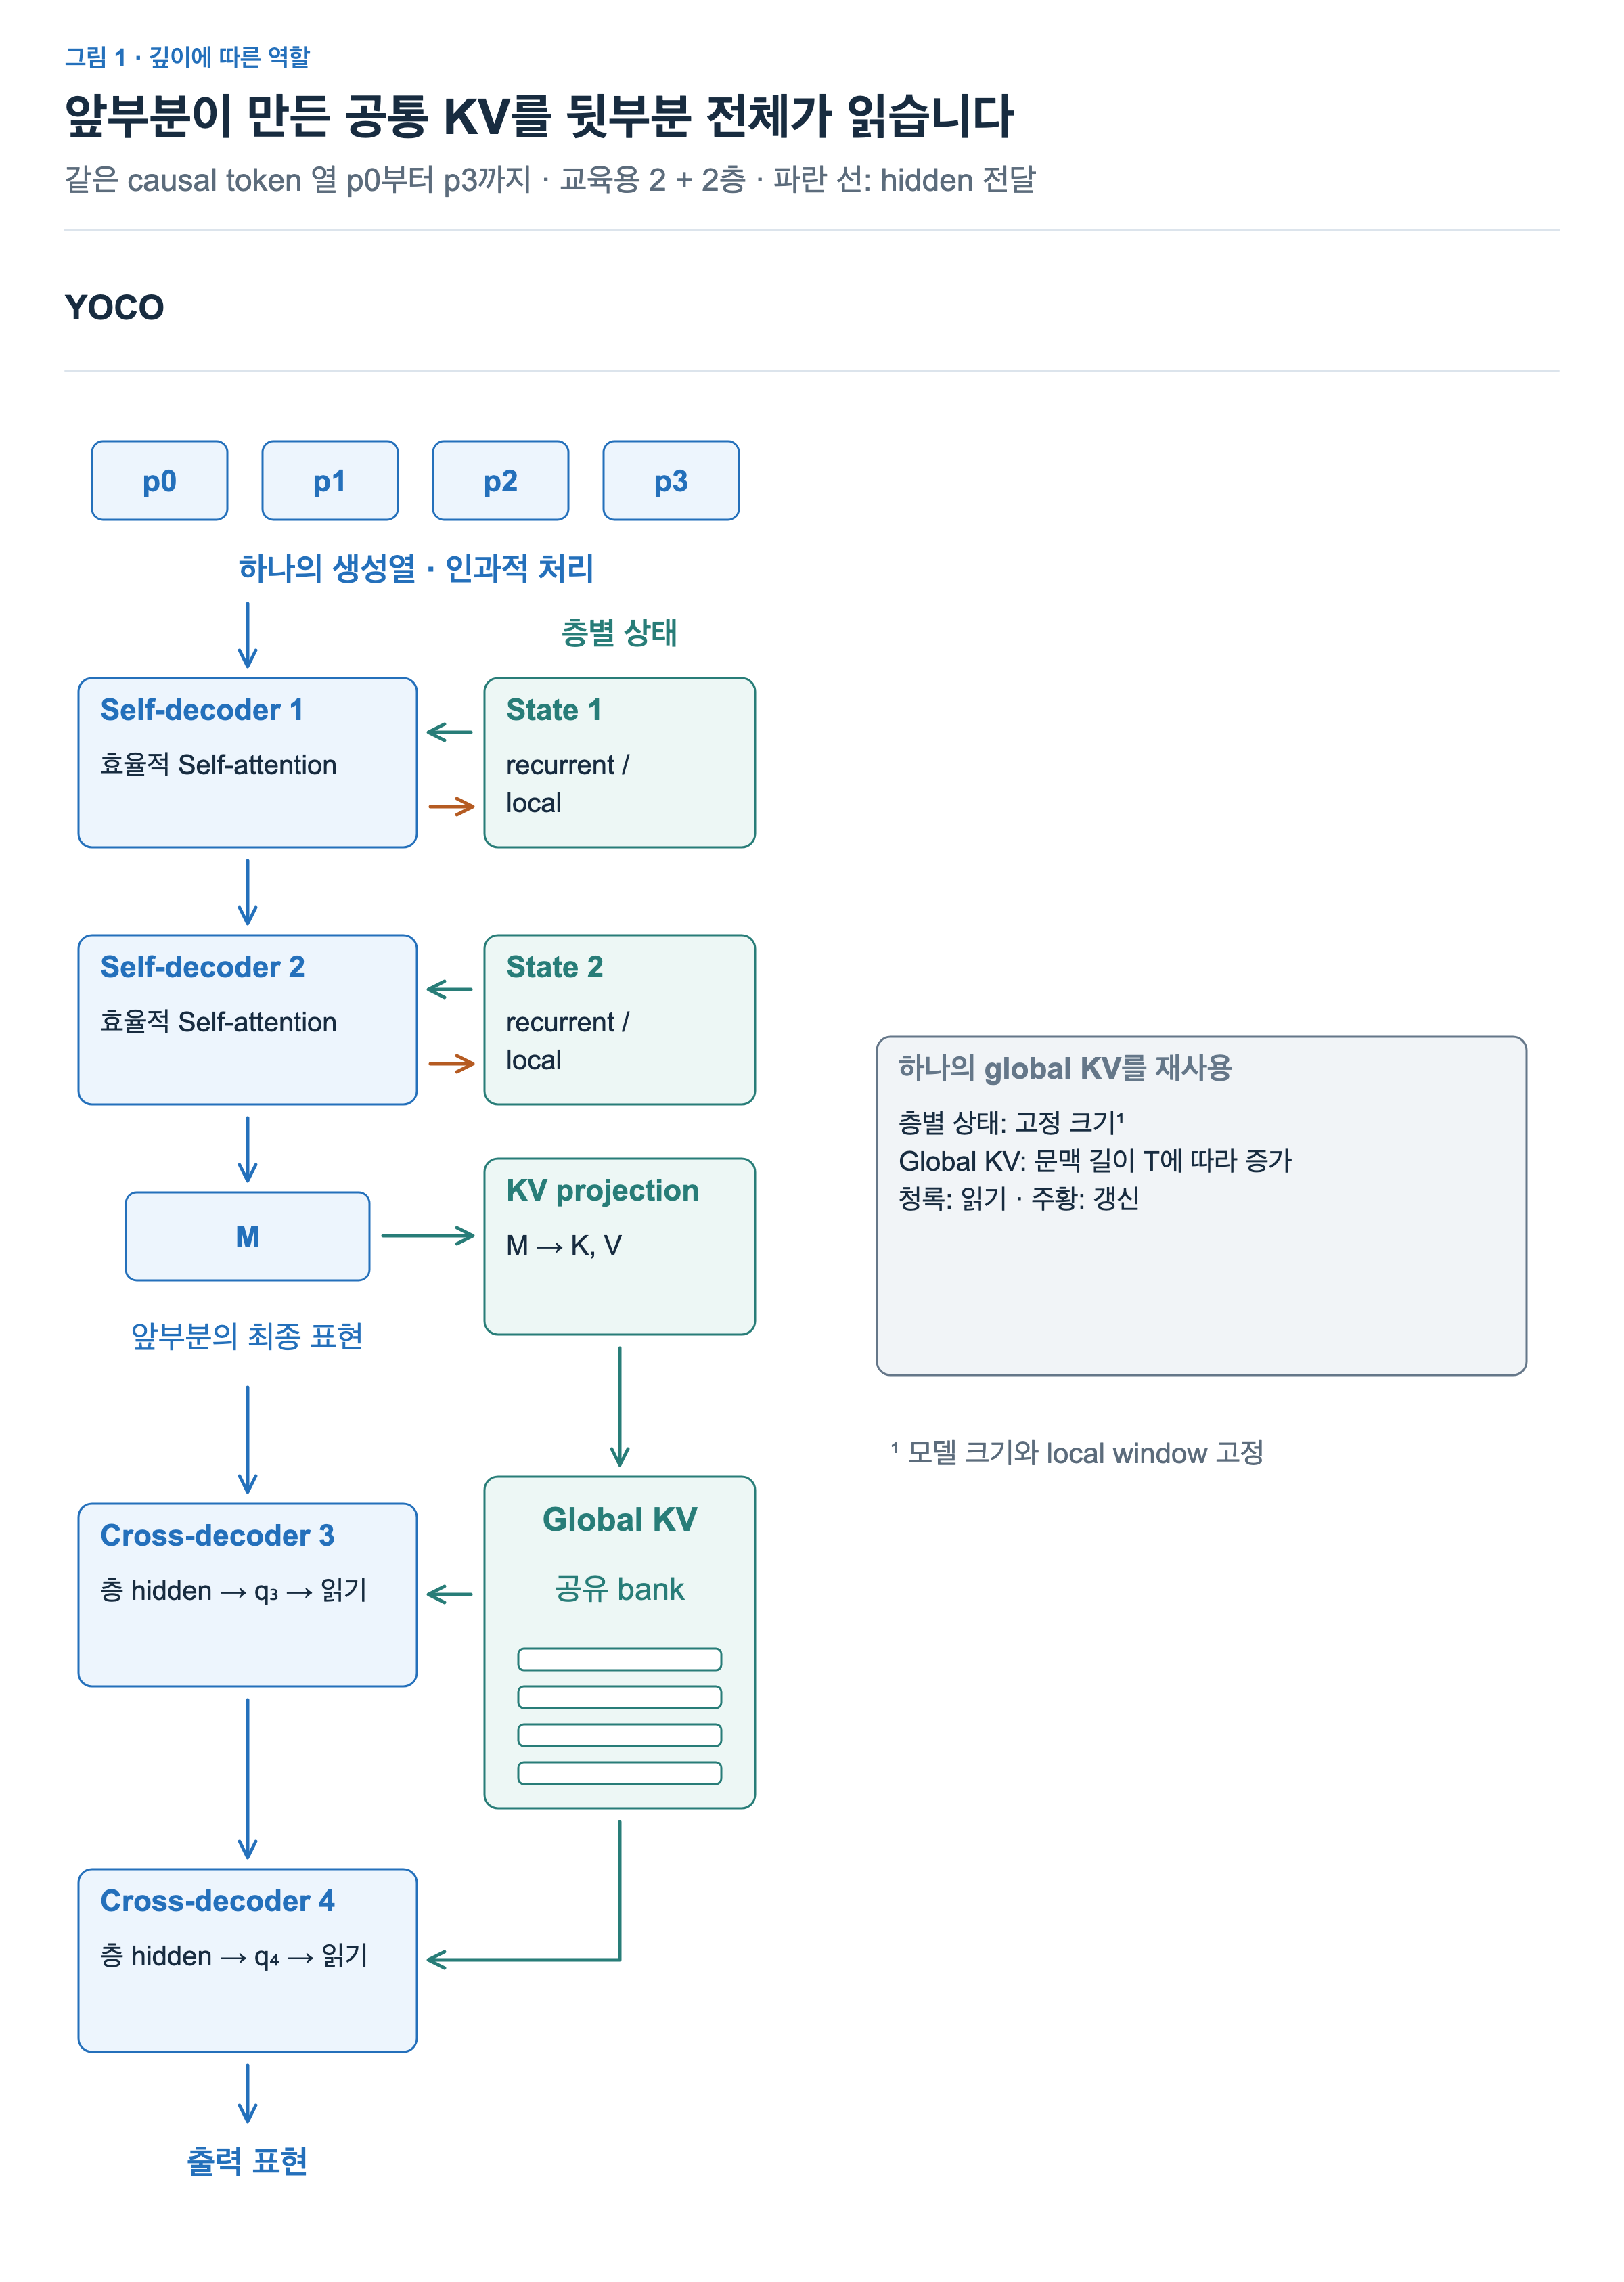
앞의 두 층을 거친 최종 표현 M에는 위치별 문맥 정보가 들어 있습니다. M을 Key와 Value로 투영한 결과가 global KV입니다. 여기서 global은 뒷부분이 긴 과거 문맥을 읽을 수 있다는 뜻입니다. 현재 위치보다 뒤의 미래를 읽을 수 있다는 뜻은 아닙니다.
뒤쪽 두 층은 같은 global KV를 읽습니다. 하지만 층을 지날 때마다 hidden 표현이 바뀌고, Query를 만드는 가중치도 층마다 다릅니다. 따라서 같은 자료를 읽더라도 어떤 위치를 얼마나 반영할지는 각 층에서 다시 정합니다. 파란 hidden 경로와 청록색 KV 읽기 경로를 함께 보면 이 관계가 드러납니다.
그림 오른쪽의 State 1과 State 2는 앞부분의 각 층이 따로 갖는 상태입니다. 청록색 화살표는 읽기, 주황색 화살표는 갱신을 나타냅니다. Self-decoder에 recurrent 방식을 쓰면 각 층이 누적 상태를 보관하고, sliding-window attention을 쓰면 최근 구간의 KV를 보관합니다.
논문의 “한 번 캐시한다”는 표현은 뒷부분이 공유할 global KV에 관한 설명입니다. 모델 전체의 상태가 물리적인 저장소 하나로 합쳐진다는 뜻은 아닙니다. 모델 크기와 window를 고정하면 앞부분의 상태 크기에는 문맥 길이와 무관한 상한이 있지만, global KV는 새 위치가 추가될 때마다 커집니다.
두 역할을 나누어도 모델의 깊이를 건너뛰지는 않습니다. 한 위치의 표현은 앞부분을 거쳐 뒷부분으로 전달되고, 각 층에는 attention 외에 정규화·residual·FFN 계산도 있습니다. 그림에서는 그 연산들을 층 상자 안에 접어 두었습니다.
서로 다른 표현에서 오는 Q와 KV
Cross-attention의 계산 자체는 익숙한 attention입니다. 차이는 Query와 Key·Value가 어디에서 오는가에 있습니다. 그림 2에서는 현재 위치 p3의 뒤층 표현 하나가 앞부분에서 준비한 p0부터 p3까지의 값을 읽습니다. 행렬은 행 하나가 한 위치인 행벡터 표기입니다.
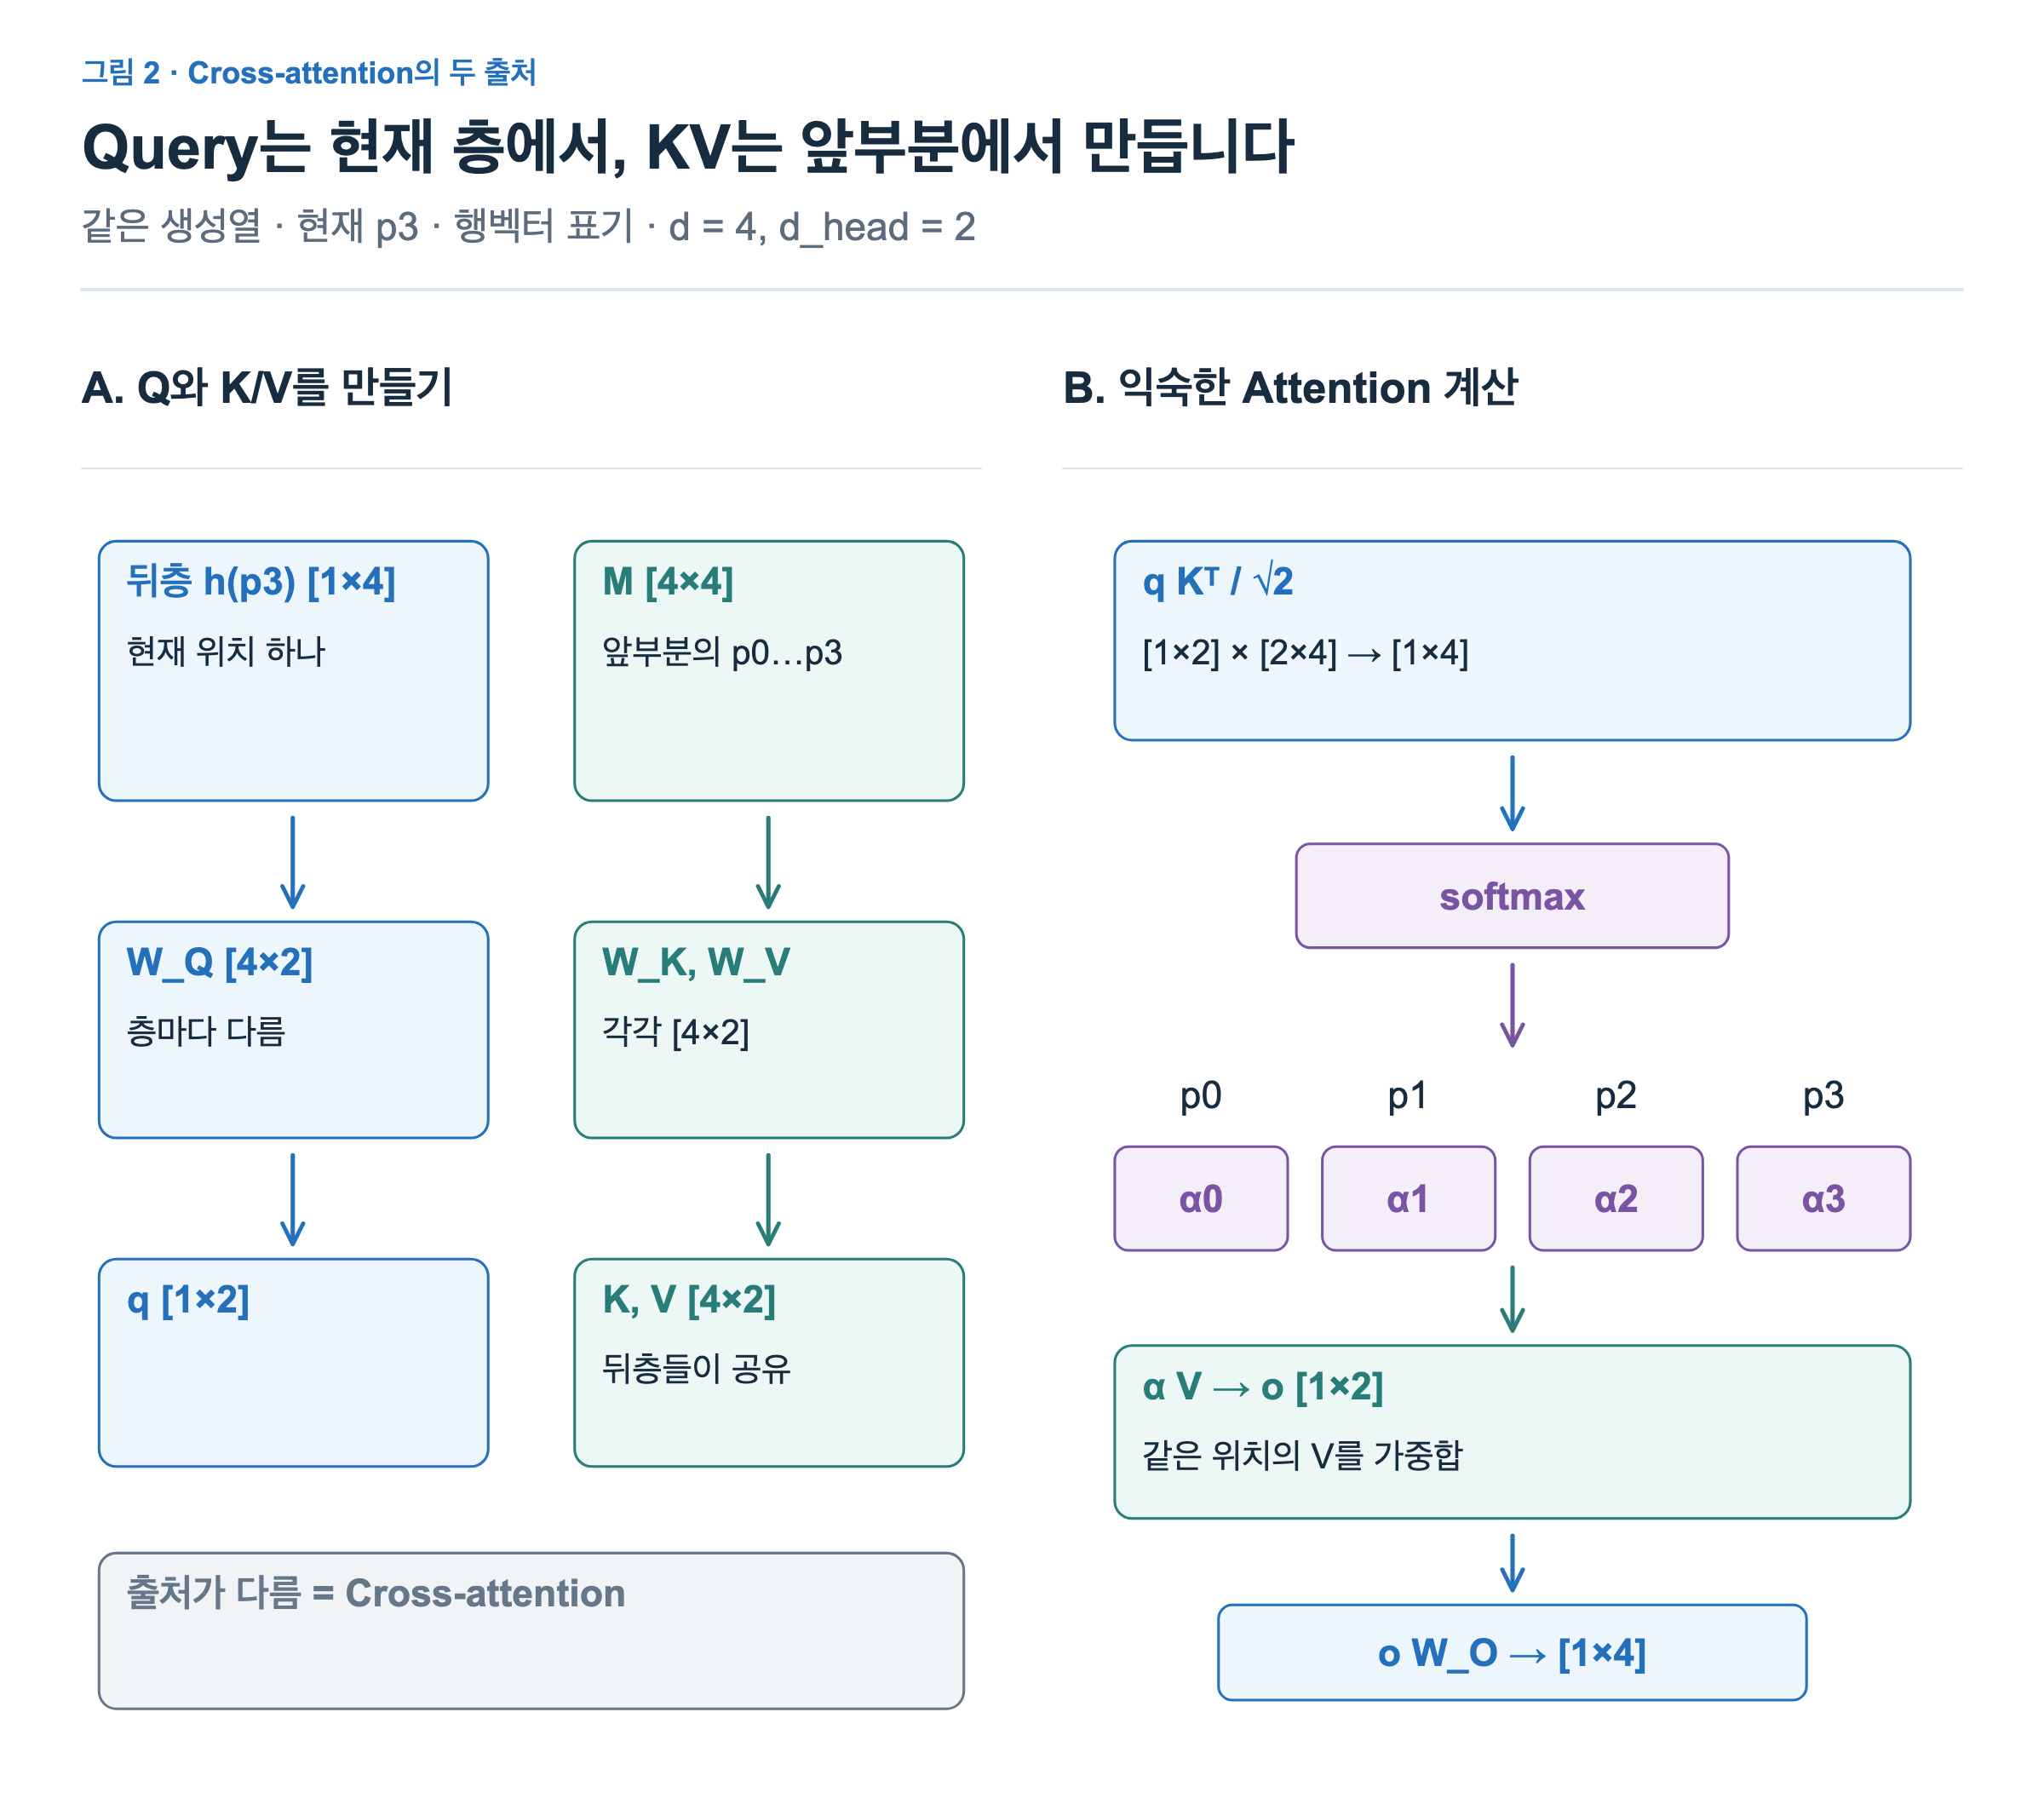
뒤층의 현재 표현 h는 [1×4]입니다. 이 층의 Query 투영 [4×2]를 곱하면 q [1×2]가 됩니다. 앞부분의 네 위치 표현 M은 [4×4]이며, Key와 Value 투영을 각각 적용하면 K와 V는 모두 [4×2]입니다. 실제 블록의 정규화는 그림에서 생략했습니다.
q와 K의 전치를 곱하면 [1×2] × [2×4] = [1×4]입니다. 네 성분은 특징 네 개가 아니라 네 토큰 위치에 대한 점수입니다. Head 차원이 2이므로 √2로 나누고 softmax를 적용하면 네 위치의 비중 α를 얻습니다.
그 비중으로 V의 네 행을 섞습니다. [1×4] × [4×2]의 결과 o는 [1×2]이고, 출력 투영 로 모델 폭인 [1×4]에 돌려놓습니다. 즉 KV의 출처를 바꾸어도 점수 계산, 위치별 비중, Value 가중합이라는 attention의 역할은 유지됩니다.
이때 M과 뒤층 h는 같은 토큰열의 서로 다른 깊이에서 온 표현입니다. Cross-attention이라고 해서 반드시 다른 언어나 별도의 입력열이 있어야 하는 것은 아닙니다. 또한 그림의 M → K/V는 값을 처음 만드는 경로입니다. 생성 과정에서 매번 과거 M 전체를 다시 투영하는 것이 아니라, 만들어 둔 K/V를 캐시에서 읽습니다.
새 토큰이 두 부분을 통과하는 과정
이번에는 이미 p0부터 p3까지 처리했고, 현재 입력 가 p4에 들어왔다고 하겠습니다. 그림 3은 recurrent self-decoder를 선택한 예시입니다. 과 는 앞 두 층이 각각 갖는 상태이며, 표시한 2×2 크기는 설명용입니다.
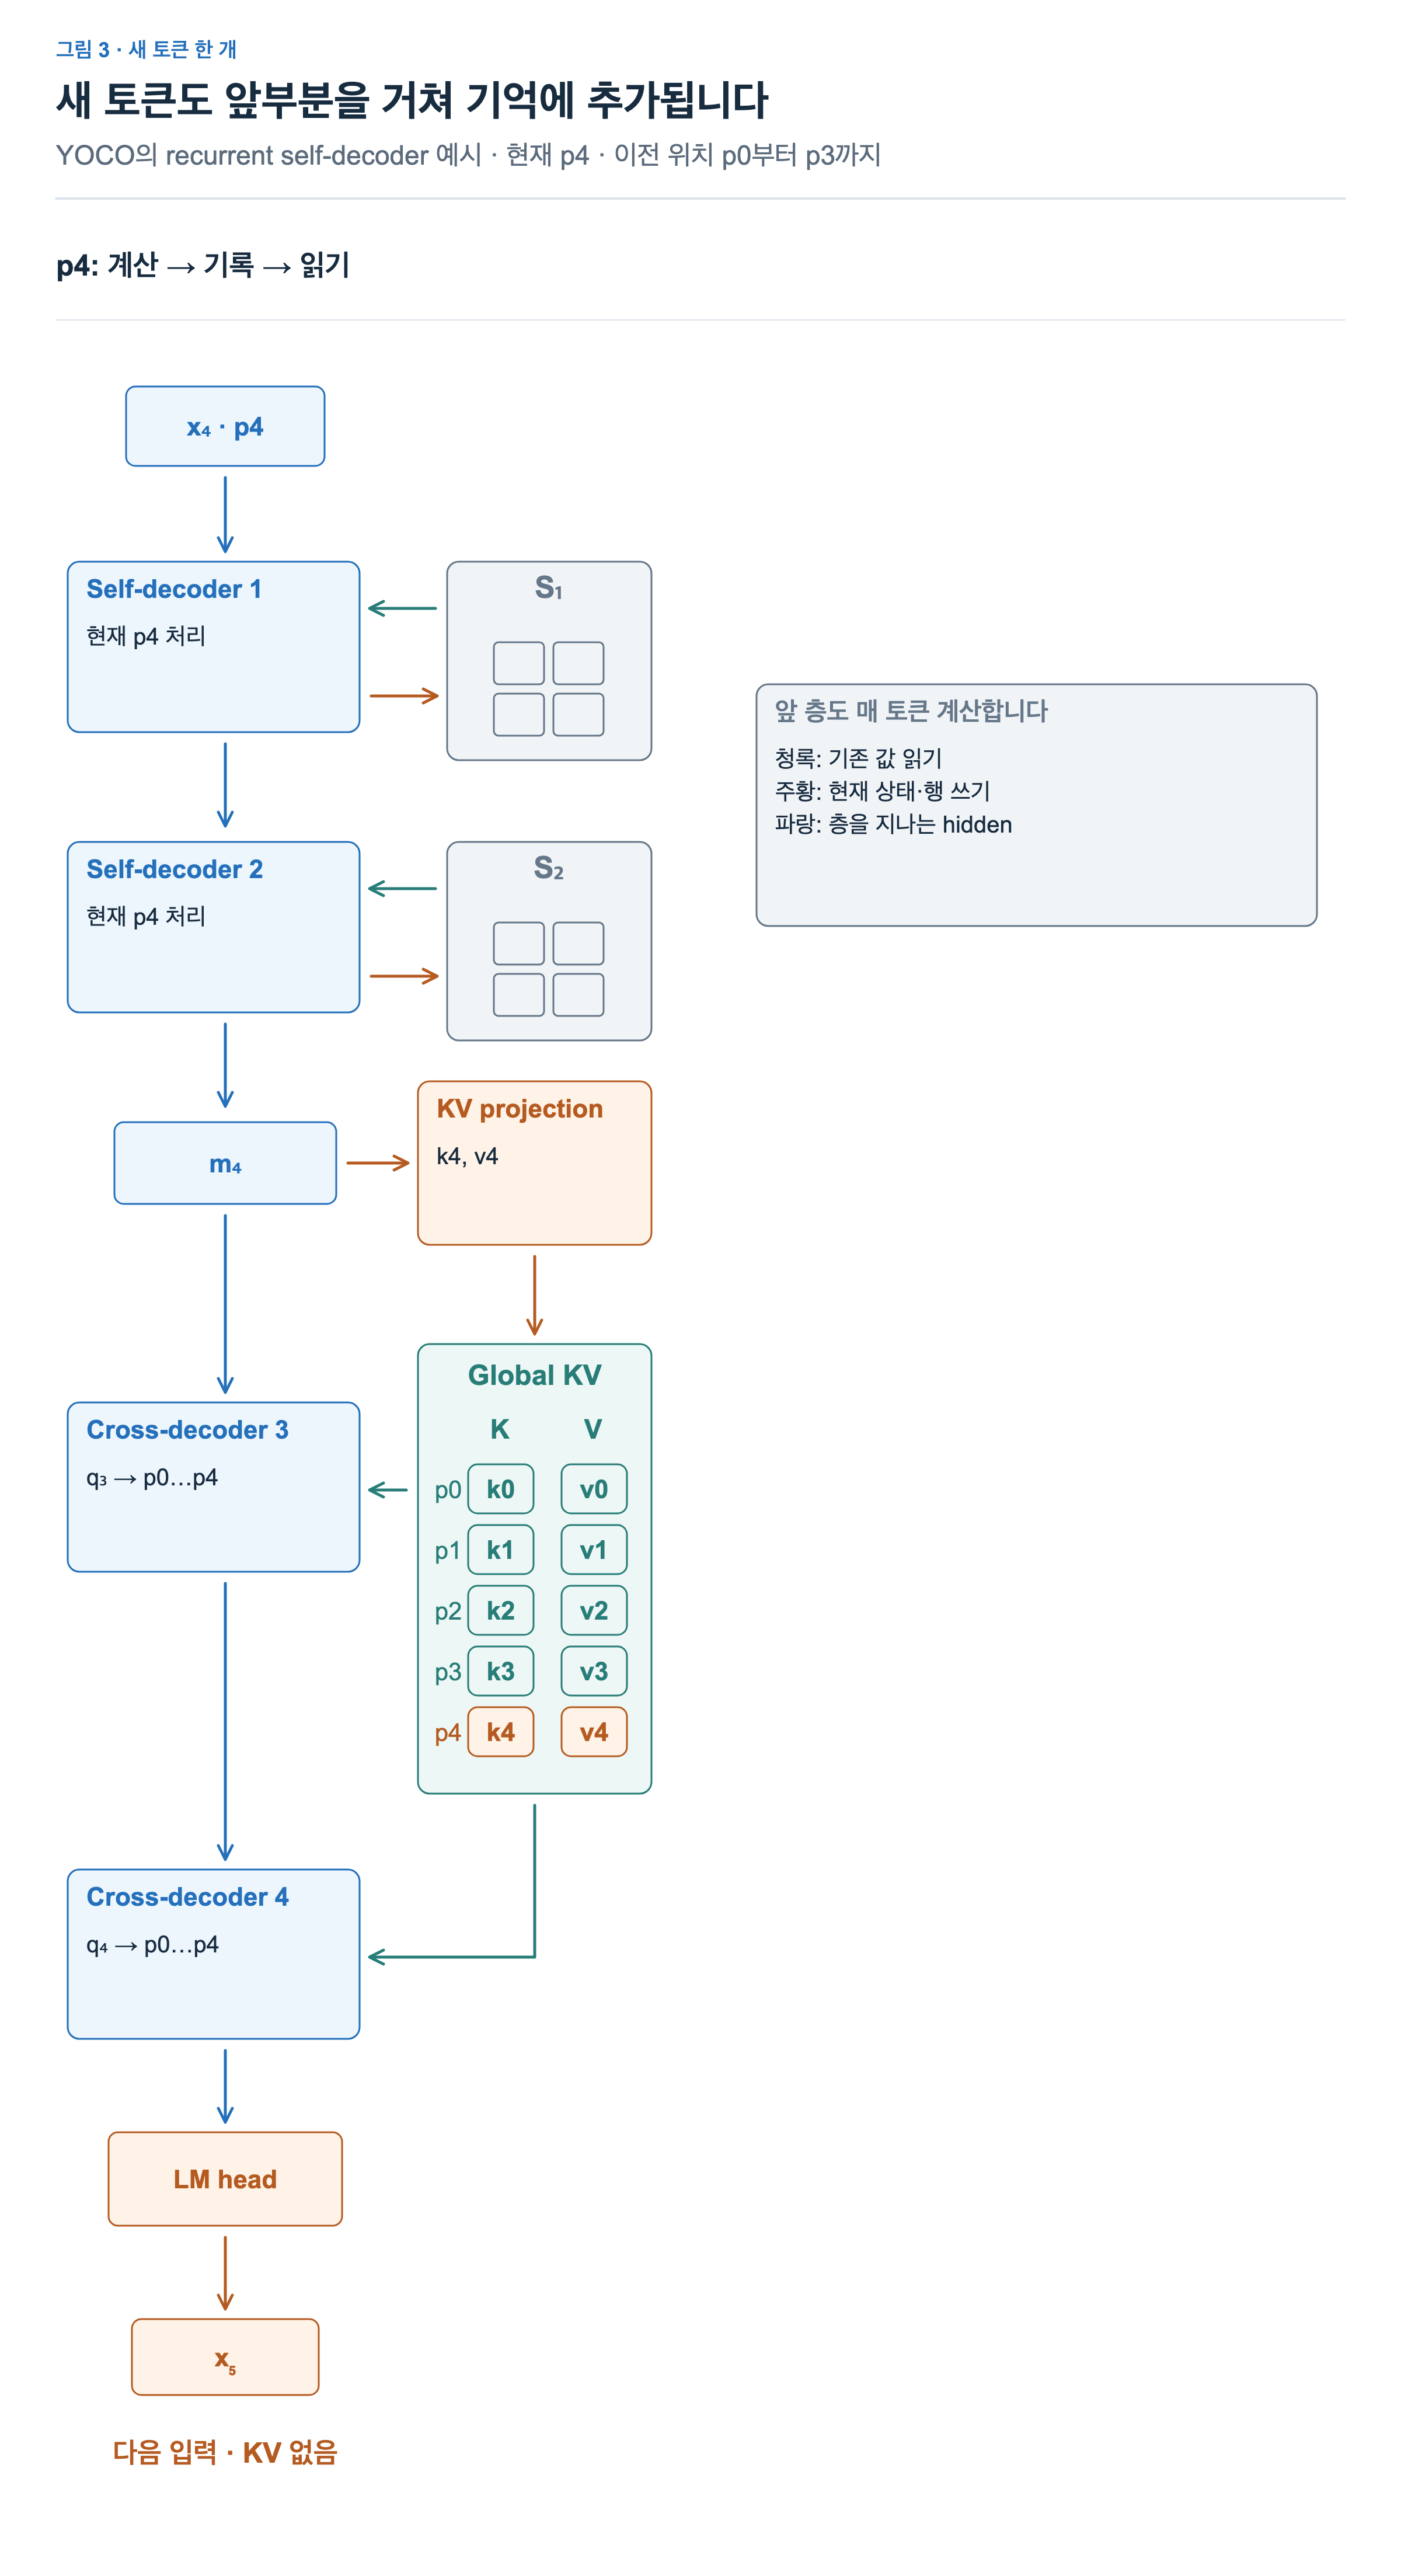
현재 토큰은 먼저 self-decoder 1을 지나며 그 층의 과거 상태를 읽고 갱신합니다. 그 결과가 self-decoder 2로 들어가 두 번째 층의 상태도 갱신합니다.
앞부분의 최종 표현 에서 현재 위치의 Key와 Value를 만들고 global KV에 p4 행을 추가합니다. 이제 뒤쪽 층들은 p0부터 p4까지 다섯 위치를 읽을 수 있습니다. Cross-decoder 3이 자신의 Query로 읽은 결과를 다음 층에 전달하고, cross-decoder 4도 바뀐 표현에서 새 Query를 만들어 같은 다섯 위치를 읽습니다.
마지막 표현을 LM head에 넣으면 다음 토큰의 점수가 나옵니다. 선택한 는 다음 실행의 입력입니다. 선택되었다는 사실만으로 p5의 KV가 이미 생긴 것은 아닙니다. 다음 실행에서 이 토큰도 앞부분과 뒷부분을 모두 지나며 필요한 상태를 갱신합니다.
따라서 공통 KV가 있다는 이유로 생성 도중 self-decoder를 멈출 수는 없습니다. 새 위치의 global KV는 여전히 앞부분이 만들어야 합니다. 다음 절에서 생략하는 것은 새 토큰의 앞부분이 아니라, 첫 출력을 만드는 데 필요하지 않은 과거 위치의 뒷부분입니다.
첫 출력에 필요한 계산만 남기기
이번에는 prompt p0부터 p3까지를 처음 받았고, 첫 생성 토큰 하나만 필요한 상황입니다. 그림 4의 칸은 attention mask가 아니라 어느 층에서 어느 위치를 계산하는가를 나타냅니다.
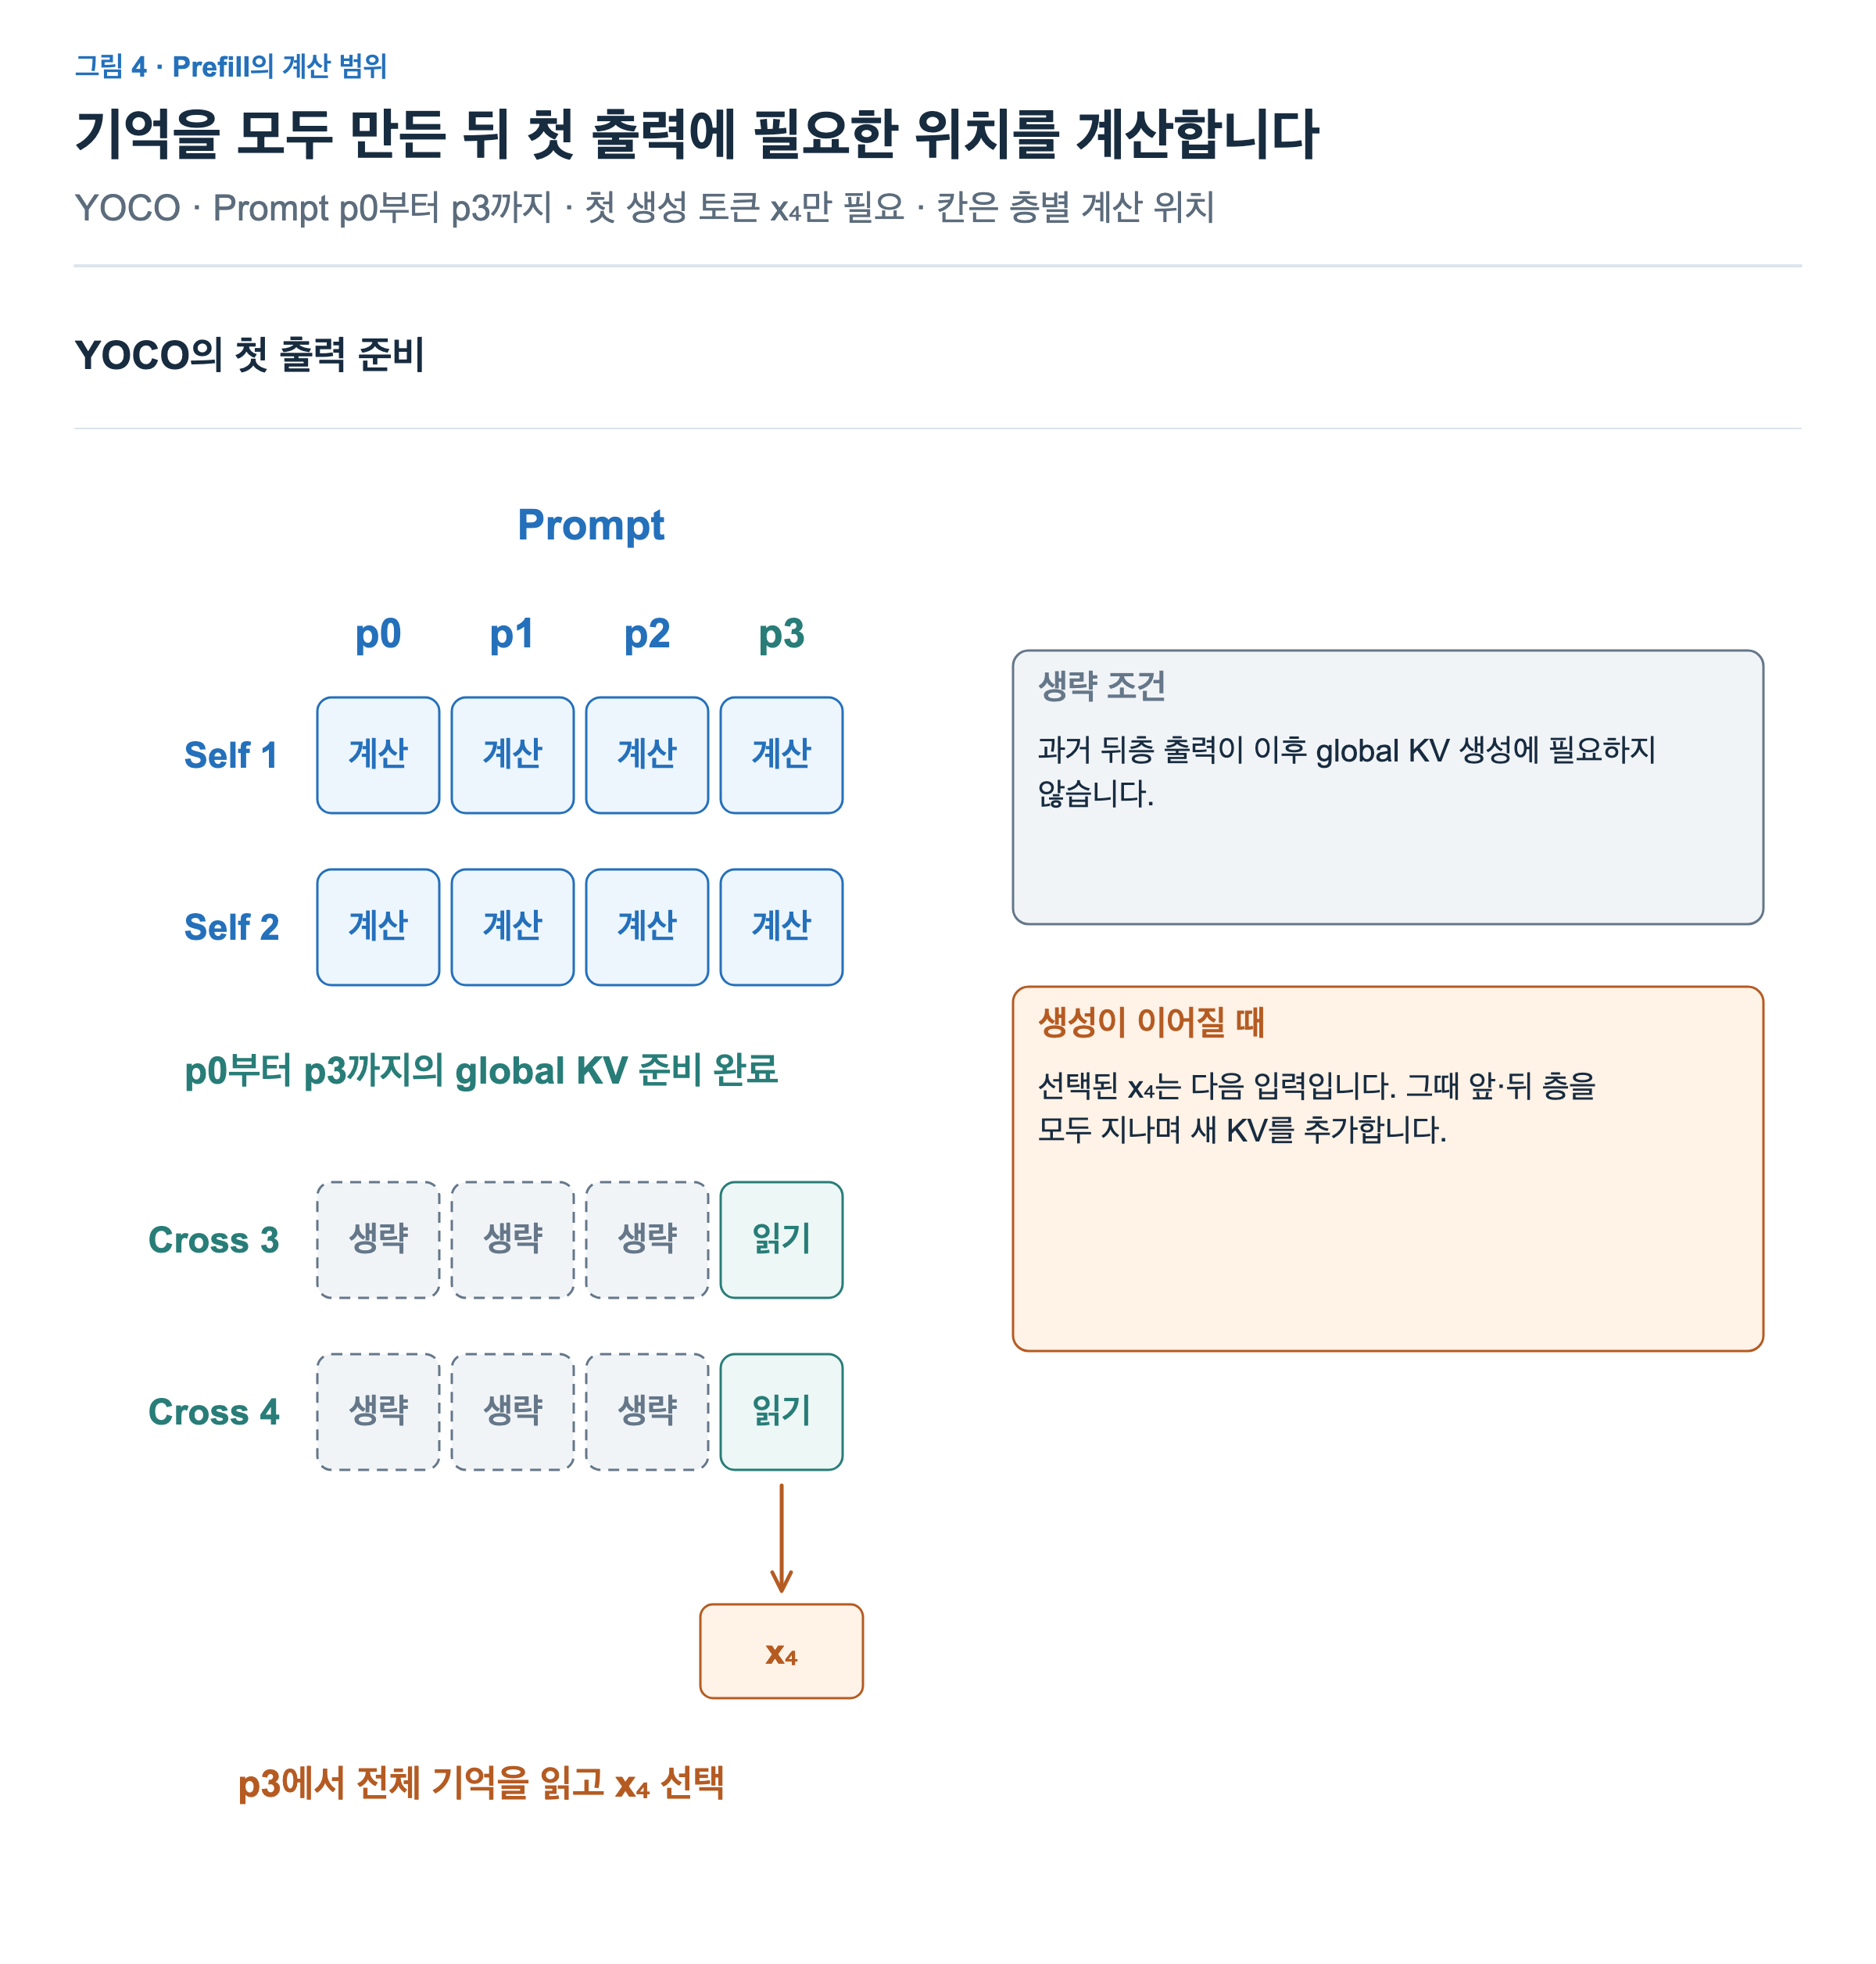
앞부분은 prompt의 네 위치를 모두 처리해야 합니다. 그래야 p0부터 p3까지의 공통 KV가 준비됩니다. 그다음에는 p3의 표현만 뒤쪽 두 층을 차례로 통과시켜 첫 생성 토큰을 선택할 수 있습니다.
왜 p0부터 p2까지의 cross-decoder 출력을 생략해도 될까요? 뒤쪽 층의 현재 Query가 읽는 과거 값은 self-decoder가 이미 만든 KV입니다. 뒤쪽 과거 출력으로 새 KV를 만들어야 하는 경로가 없습니다. FFN과 정규화도 여기서는 위치별 계산이므로, 과거 cross-decoder 출력을 만들지 않았다는 이유로 p3의 다음 층 입력이 사라지지 않습니다. 이 의존 관계가 논문 §2.3의 prefill 생략을 가능하게 합니다.
각 위치의 log probability나 학습 손실을 구할 때는 해당 위치의 최종 출력도 계산합니다.
문맥이 길어질 때 늘어나는 저장량
그림 5는 self-decoder를 sliding-window attention(SWA)으로 구성한 예시입니다. Self-decoder 두 층은 각각 최근 두 위치를 보관하고, cross-decoder 두 층은 global KV 하나를 공유합니다. 한 칸은 한 위치의 Key·Value 벡터 쌍이며, 비교하는 모든 KV의 head 수, 벡터 폭과 자료형은 같다고 가정합니다. 그림 3의 recurrent 방식에서는 상태 행렬의 크기로 앞부분의 저장량을 셉니다.
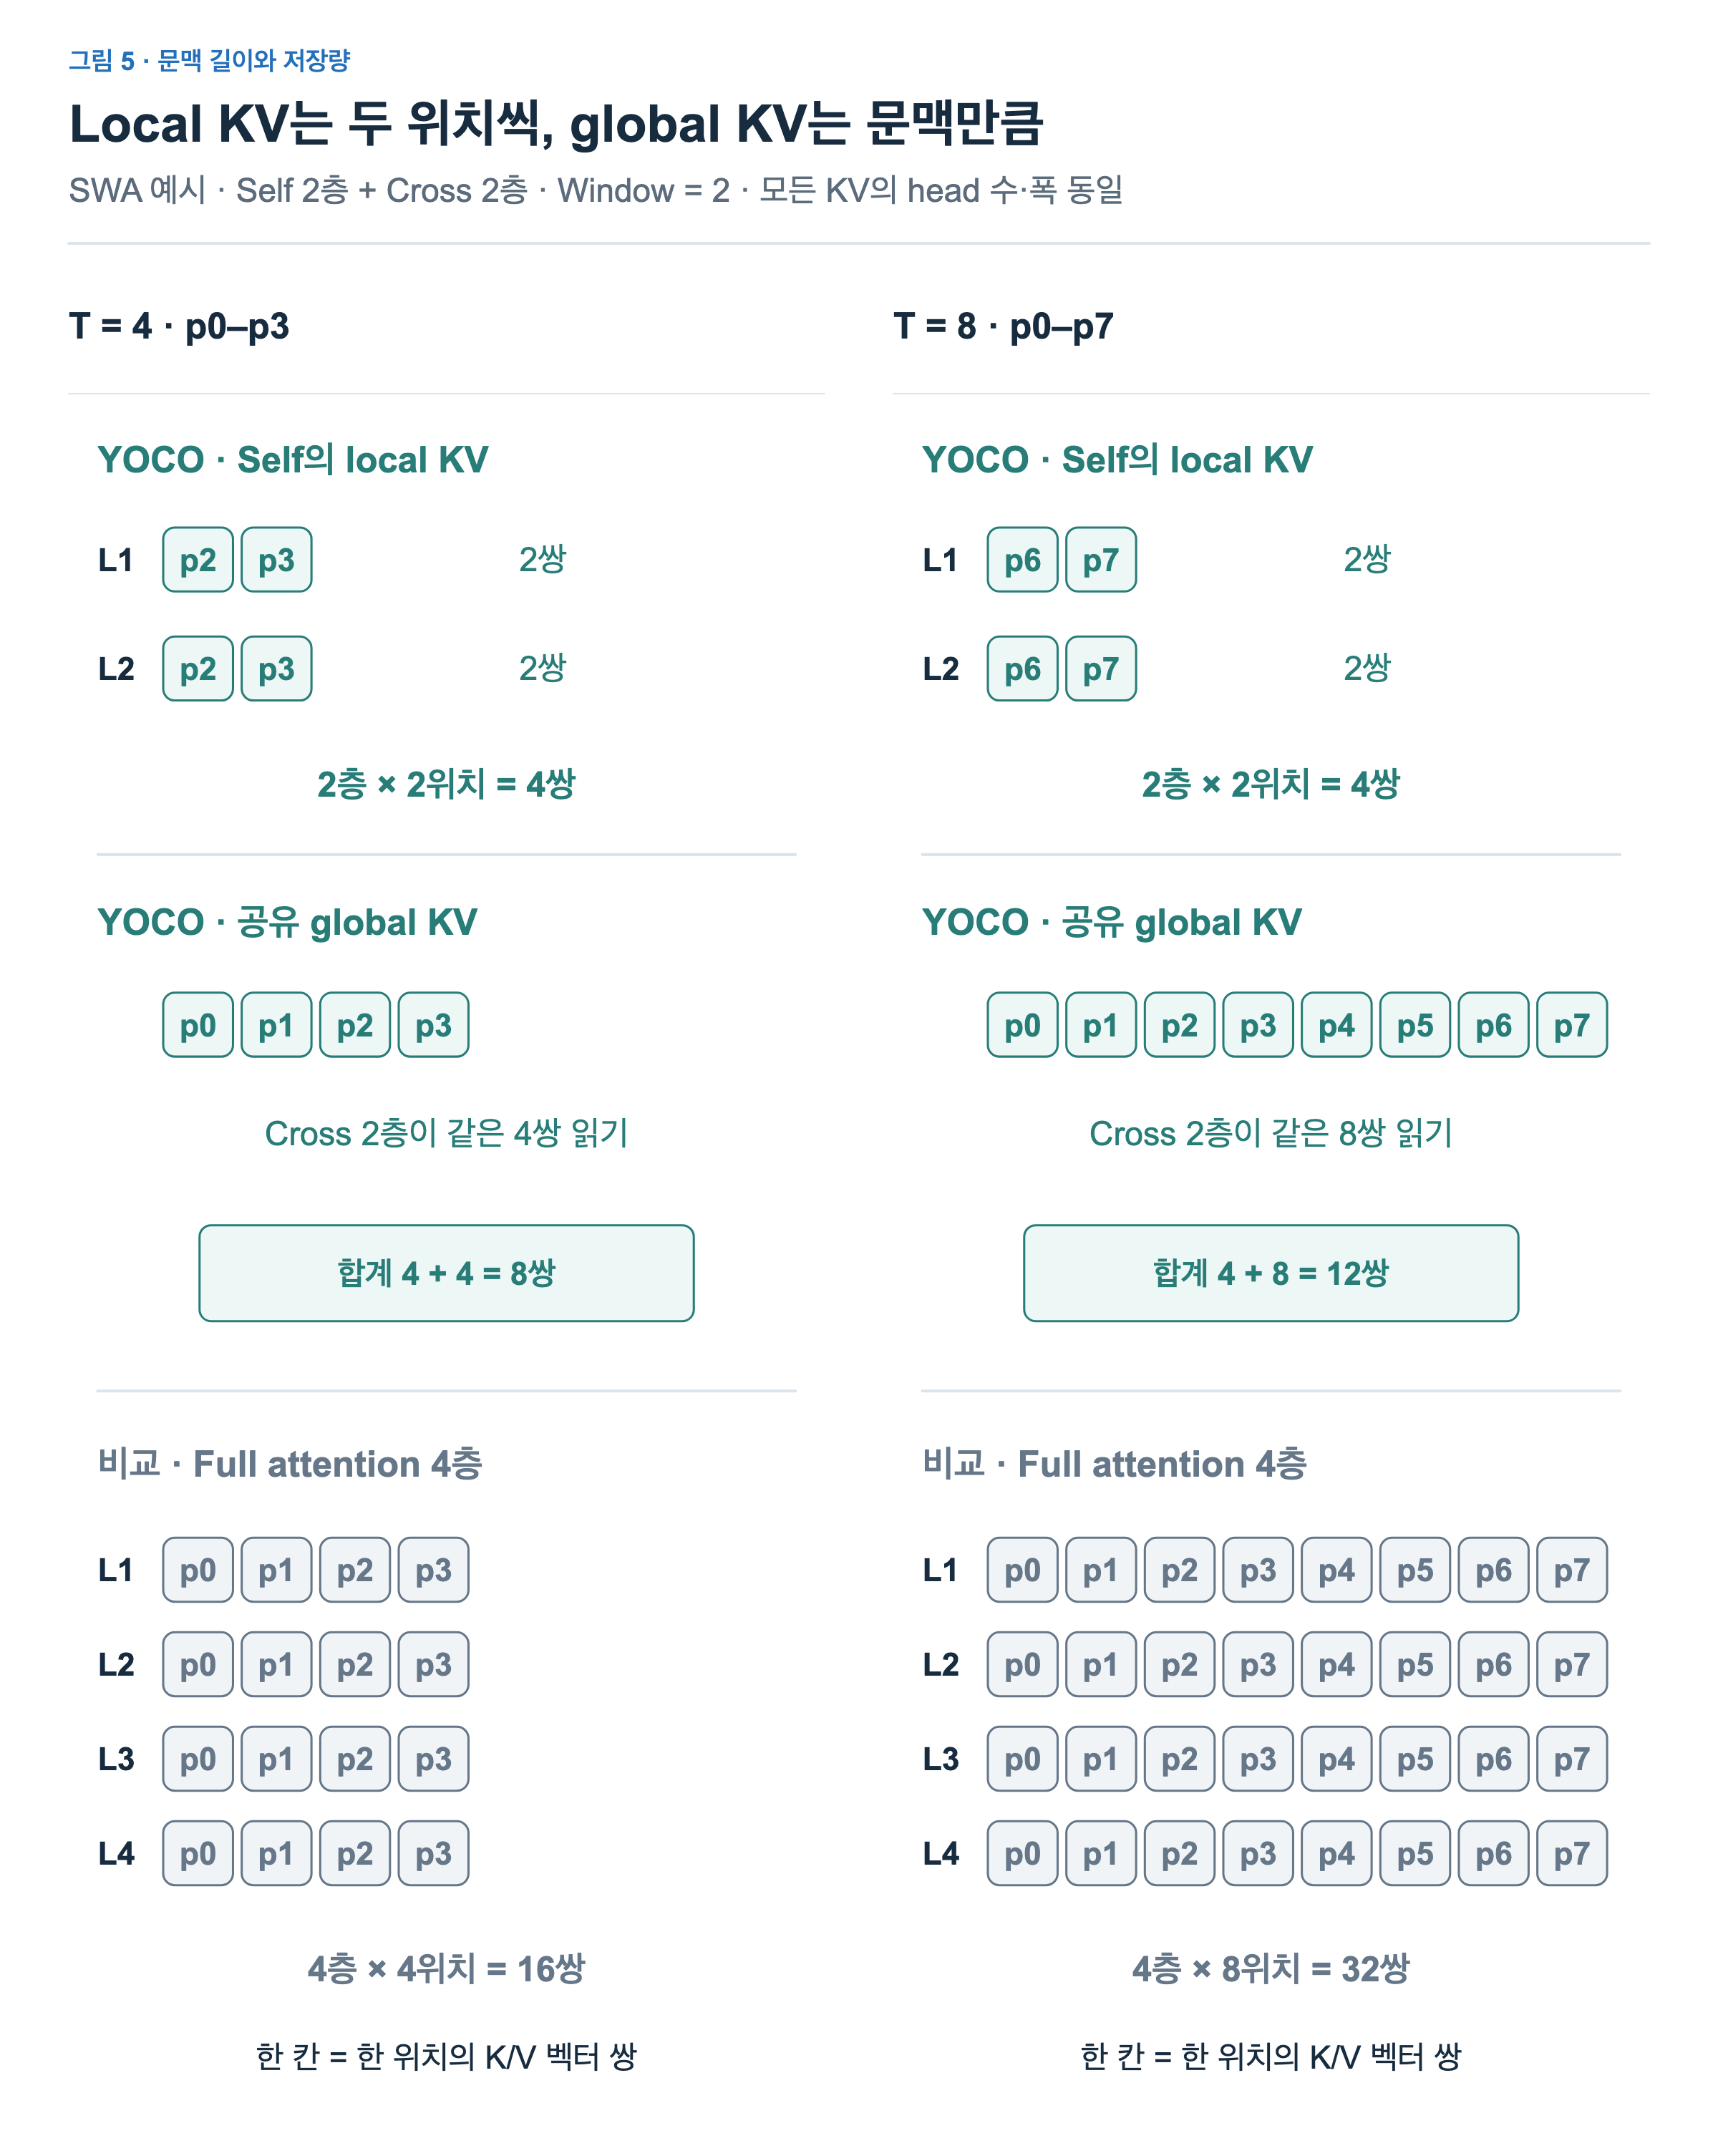
네 위치를 처리한 시점에는 각 self-decoder 층에 p2·p3의 KV가 남습니다. 층마다 2쌍이므로 local KV는 총 4쌍입니다. Global KV는 p0부터 p3까지 4쌍이고, 두 cross-decoder가 이를 함께 읽으므로 한 번만 셉니다. 합계는 4 + 4 = 8쌍입니다.
여덟 위치까지 처리하면 local KV의 내용은 p6·p7로 바뀌지만 개수는 여전히 층마다 2쌍입니다. Global KV는 p0부터 p7까지 8쌍으로 늘어 합계 4 + 8 = 12쌍이 됩니다. 같은 네 층이 각각 full attention용 KV를 보관한다면 4 × 4 = 16쌍에서 4 × 8 = 32쌍으로 증가합니다.
따라서 YOCO의 저장량 감소는 두 효과가 합쳐진 결과입니다. 앞부분은 층마다 긴 과거 KV 전체를 쌓지 않고, 뒷부분은 긴 문맥의 KV를 층마다 중복 보관하지 않습니다. 논문 §2.1–2.3의 고정 크기 상태와 공유 global KV를 이 예시에서 나누어 센 것입니다.
공통 KV는 긴 문맥과 함께 커지고, 뒤쪽 각 층에서 그 값을 읽는 계산도 남습니다.
YOCO에서 중요한 기준은 “과거 뒤층 출력이 다음 계산에 필요한 상태를 만드는가”였습니다. 다음 CED 글에서는 encoder에서 만든 global 정보와 decoder 자체의 local 상태가 함께 있을 때, 이 생략 범위가 어떻게 달라지는지 살펴보겠습니다.