공통 · 모델 · 2026-09-29
층간 KV 공유: 앞선 층의 Key와 Value 재사용하기
여섯 층의 KV 저장량을 비교하고, 새 토큰의 Key와 Value를 다음 층에서 재사용하는 순서와 저장·계산의 절충을 설명합니다.
MQA와 GQA는 한 층 안에서 여러 Query head가 같은 Key와 Value를 읽게 했습니다. 그러면 토큰마다 보관할 KV가 줄어듭니다. 하지만 층마다 별도의 KV를 만든다는 점은 그대로입니다.
이번에는 공유 범위를 층 사이로 넓혀 보겠습니다. 앞선 층이 만든 Key와 Value를 다음 층도 읽으면, 층마다 KV를 따로 보관하지 않아도 됩니다. Cross-Layer Attention(CLA)은 이런 층간 공유를 모델 구조에 넣는 방법입니다. 각 층은 자신의 Query를 만들되, 일부 층만 Key와 Value를 생산합니다.
먼저 여섯 층의 저장 공간이 어떻게 달라지는지 세어 보고, 새 토큰 하나가 두 층을 지나는 순서를 따라가겠습니다. 이어서 저장량이 줄어도 남는 계산을 확인하고, 두 층 공유를 세 층 공유로 넓힐 때의 절충을 살펴봅니다.
층마다 저장하던 KV를 함께 쓰기
각 층의 attention은 현재 Query로 과거와 현재 위치의 Key를 비교하고, 그 비중으로 Value를 읽습니다. 기본 구조에서는 각 층이 자기 입력으로 Key와 Value를 만들므로, 같은 토큰 위치에도 층마다 다른 KV가 있습니다.
그림 1은 토큰 네 개를 처리한 여섯 층을 비교합니다. 두 구조 모두 KV head는 하나이고, Key와 Value의 벡터 차원은 각각 2입니다. 오른쪽에서는 인접한 두 층을 한 쌍으로 묶습니다. L₁이 만든 KV를 L₁과 L₂가 읽고, L₃의 KV는 L₃와 L₄가, L₅의 KV는 L₅와 L₆이 읽습니다.
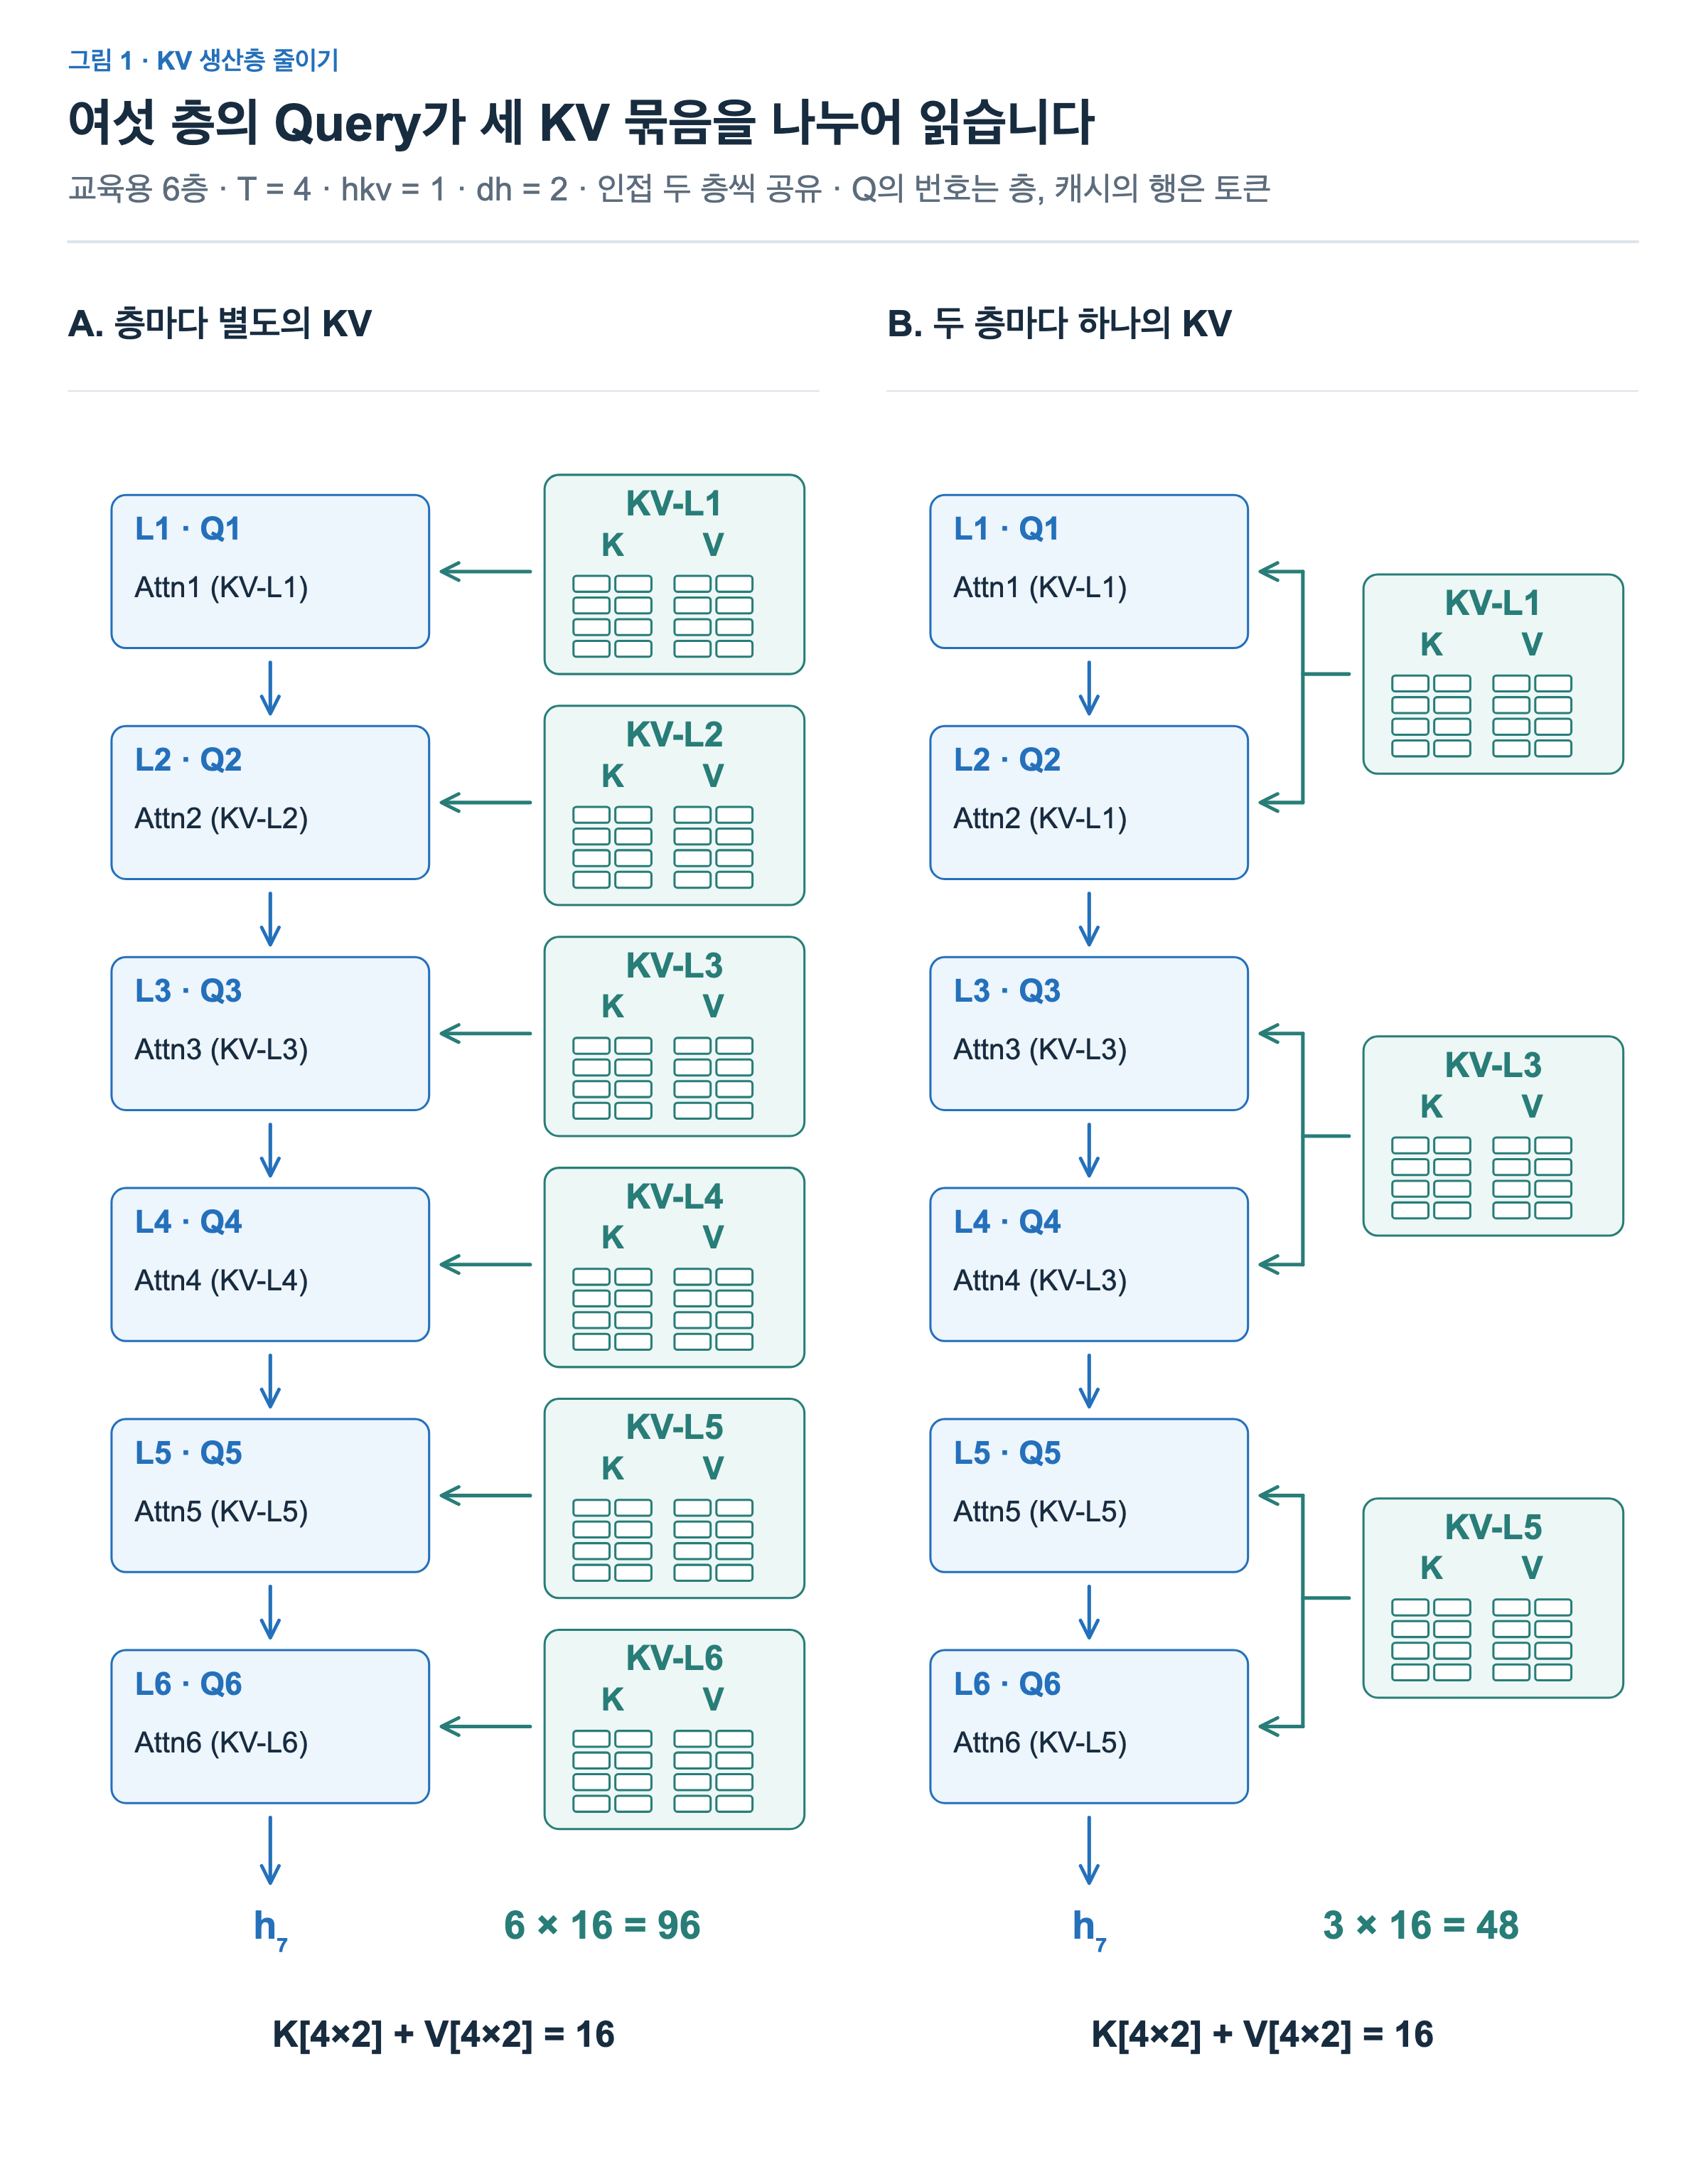
A. 층마다 별도의 KV. 여섯 층이 모두 KV를 만들고 따로 보관합니다. Query와 attention 계산도 여섯 번이고, 묶음 하나가 K[4×2] + V[4×2] = 16성분이므로 96성분입니다.
B. 두 층마다 하나의 KV. L₁, L₃, L₅만 KV를 만들고 바로 다음 층이 그 값을 읽습니다. 각 층은 자기 Query로 attention을 따로 계산하며, 파란 경로는 층 사이로 전달되는 activation입니다. 저장량은 48성분으로 줄지만, 이 비율은 이 예시의 KV 저장량일 뿐 전체 메모리나 속도의 비율이 아닙니다.
그림의 KV 묶음 하나에는 K[4×2]와 V[4×2]가 들어 있습니다. Key가 8성분, Value가 8성분이므로 합계 16성분입니다. 층마다 보관하면 6 × 16 = 96성분이지만, 두 층씩 공유하면 3 × 16 = 48성분입니다. 같은 자료형으로 빈틈없이 저장한다고 가정하면 이 예시의 KV 데이터 크기는 절반입니다.
오른쪽에서 줄어든 것은 서로 다른 KV를 생산하고 보관하는 층의 수입니다. 여섯 층의 계산 자체는 남아 있습니다. 파란 경로를 따라 표현이 순서대로 바뀌며, L₂는 L₁을 통과한 표현으로 자신의 Query를 만듭니다. 읽을 KV가 같아도 Query가 다르면 attention의 비중과 출력은 달라질 수 있습니다.
여기서 공유하는 대상은 이미 계산된 Key와 Value 값입니다. 두 층에 같은 KV 투영 가중치를 두고 각각 계산하는 것과는 다릅니다. 가중치가 같아도 입력 표현이 다르면 출력 KV가 달라질 수 있기 때문입니다. CLA 논문 §2.2의 구조는 일부 층에서 만든 KV를 다른 층이 직접 재사용합니다.
MQA/GQA와 CLA는 공유하는 축도 다릅니다. MQA/GQA는 한 층 안에서 Query head들이 읽을 KV head 수를 줄이고, CLA는 깊이 방향에서 별도로 KV를 만드는 층 수를 줄입니다. 두 방식을 함께 적용할 수도 있습니다. 이 글에서 KV head를 하나로 고정한 이유도, head 수를 바꾸는 효과와 층간 공유의 효과를 나누어 보기 위해서입니다.
현재 토큰의 KV를 만들고 재사용하기
이제 그림 1의 첫 번째 쌍만 보겠습니다. 이전 위치 p0부터 p3까지의 KV가 저장되어 있고, 현재 위치 p4를 처리하는 시점입니다. L₁은 이 위치의 입력 로 Query , Key , Value 를 만듭니다. 이 그림에서 q와 h의 아래첨자는 층, k와 v의 숫자는 토큰 위치를 가리킵니다.
그림 2에서는 주황색 쓰기가 먼저 일어나고, 두 층이 차례로 같은 KV를 읽습니다. 오른쪽의 T=4와 T=5 상자는 별도의 저장소 두 개가 아니라, 하나의 KV-L1이 갱신되기 전과 후의 모습입니다.
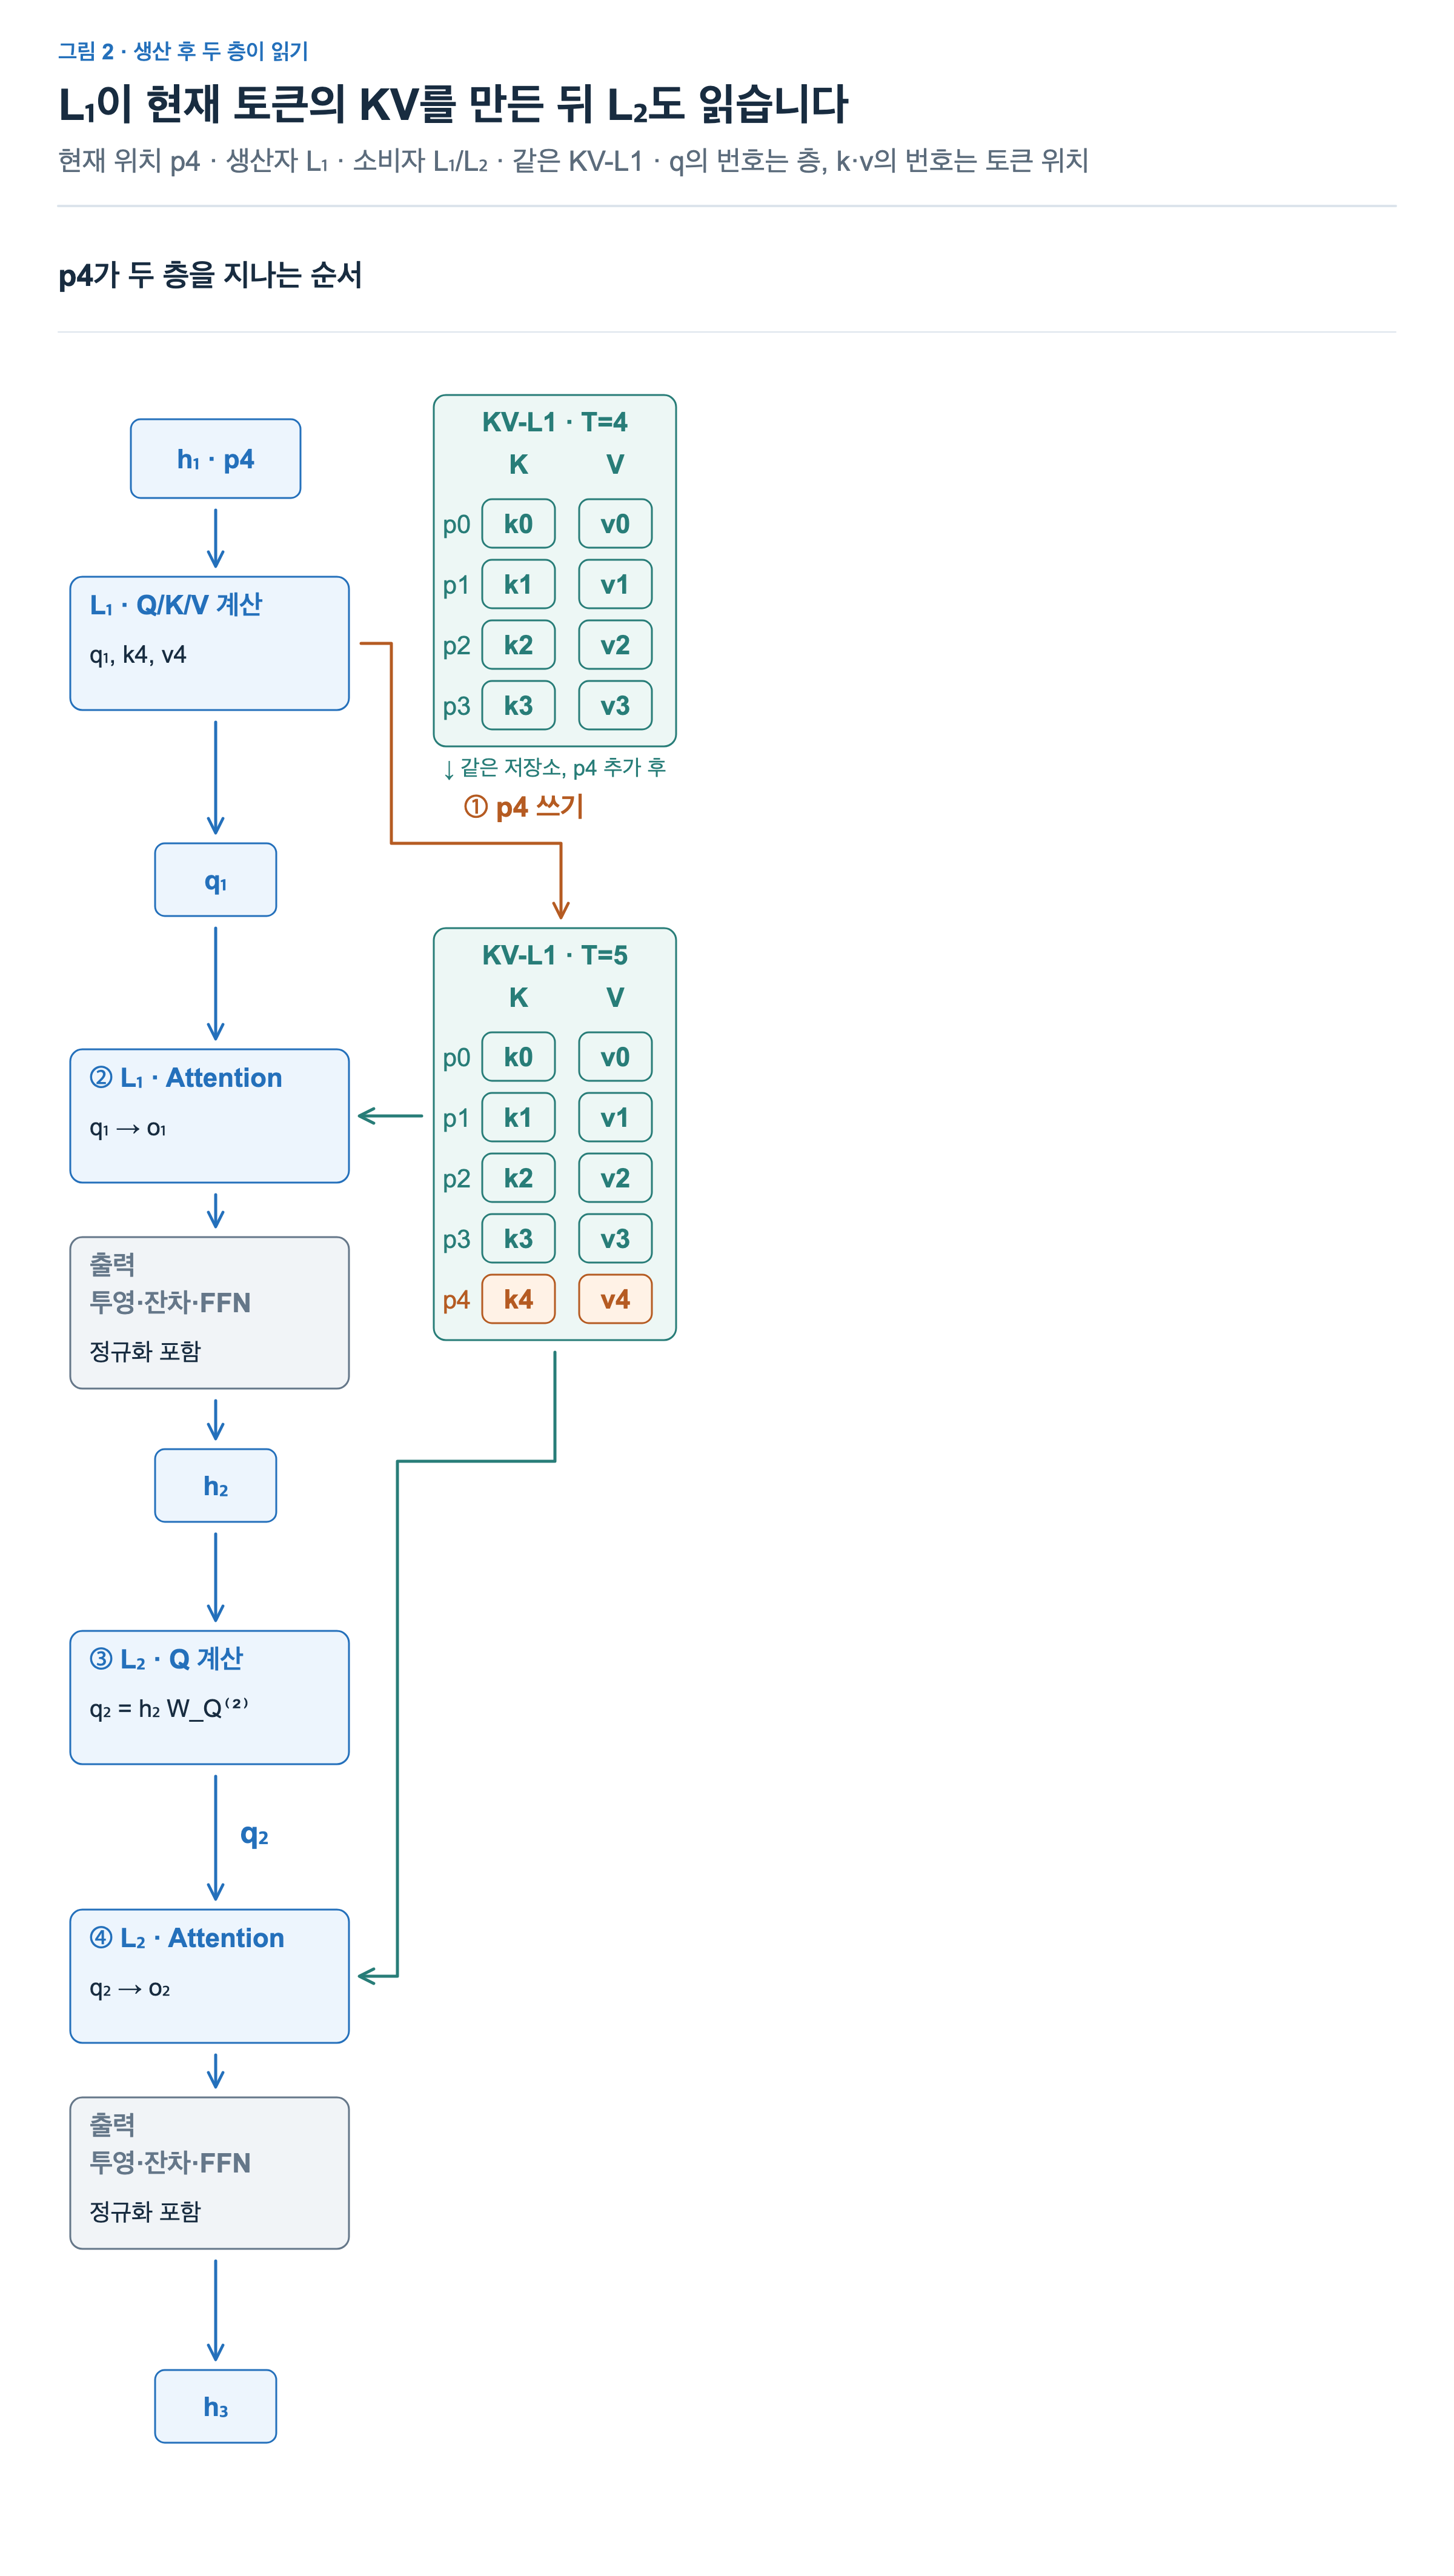
① L₁이 쓰고 ② 읽기. p4의 h₁이 L₁에 들어오면 q₁, k4, v4를 만듭니다. k4, v4는 KV-L1의 p4 행에 추가되고, L₁의 q₁이 p0부터 p4까지 읽습니다. 오른쪽 두 상자는 하나의 bank가 4행에서 5행으로 바뀌는 전후 모습입니다.
③ L₂의 Query, ④ 같은 KV 읽기. L₂의 Query는 h₂가 나온 뒤에야 만들 수 있습니다. L₂는 새 KV를 쓰지 않고 같은 p0부터 p4까지 읽습니다. p4는 현재 위치이고 미래 위치 p5는 아직 없습니다. 공유하는 것은 만들어진 KV 값이며, 층마다 KV 투영 가중치를 같게 묶는 것과는 다릅니다.
먼저 와 를 p4 행에 추가합니다. KV-L1에는 이제 p0부터 p4까지 다섯 행이 있습니다. 그림의 k0, v0 같은 표기는 실제 성분값이 아니라 해당 위치의 벡터 이름입니다. 각 Key와 Value는 앞 절과 동일하게 2차원입니다.
L₁의 은 이 다섯 Key와 비교되어 attention 비중을 만들고, 같은 위치들의 Value를 가중합합니다. 이후 출력 투영, residual 연결, FFN 등의 계산을 거쳐 L₂로 들어갈 가 만들어집니다. 그림의 o₁은 attention의 가중합 결과이며, 회색 상자는 다음 층 입력을 만드는 연산들을 묶어 나타냅니다. 정규화도 각 단계에 포함하며, Q/K/V를 만들기 전의 정규화는 투영 상자에 접었습니다.
L₂는 로 자신의 를 만듭니다. 그리고 L₁이 갱신한 KV-L1의 다섯 행을 읽습니다. L₂가 자기 입력으로 새로운 Key와 Value를 만들거나, 이 저장소에 두 번째 p4 행을 쓰지는 않습니다. 다음 토큰을 처리할 때도 L₁이 새 행을 추가하고 L₂가 그 값을 재사용합니다.
두 층 모두 현재 위치 p4까지 읽습니다.
줄어드는 저장과 남는 계산
KV를 공유하면 저장량을 줄일 수 있지만, 각 층에서 정보를 읽는 계산까지 합쳐지는 것은 아닙니다. 그림 3에서 청록색 저장소의 개수와 파란색 계산 상자의 개수를 따로 세어 보겠습니다.
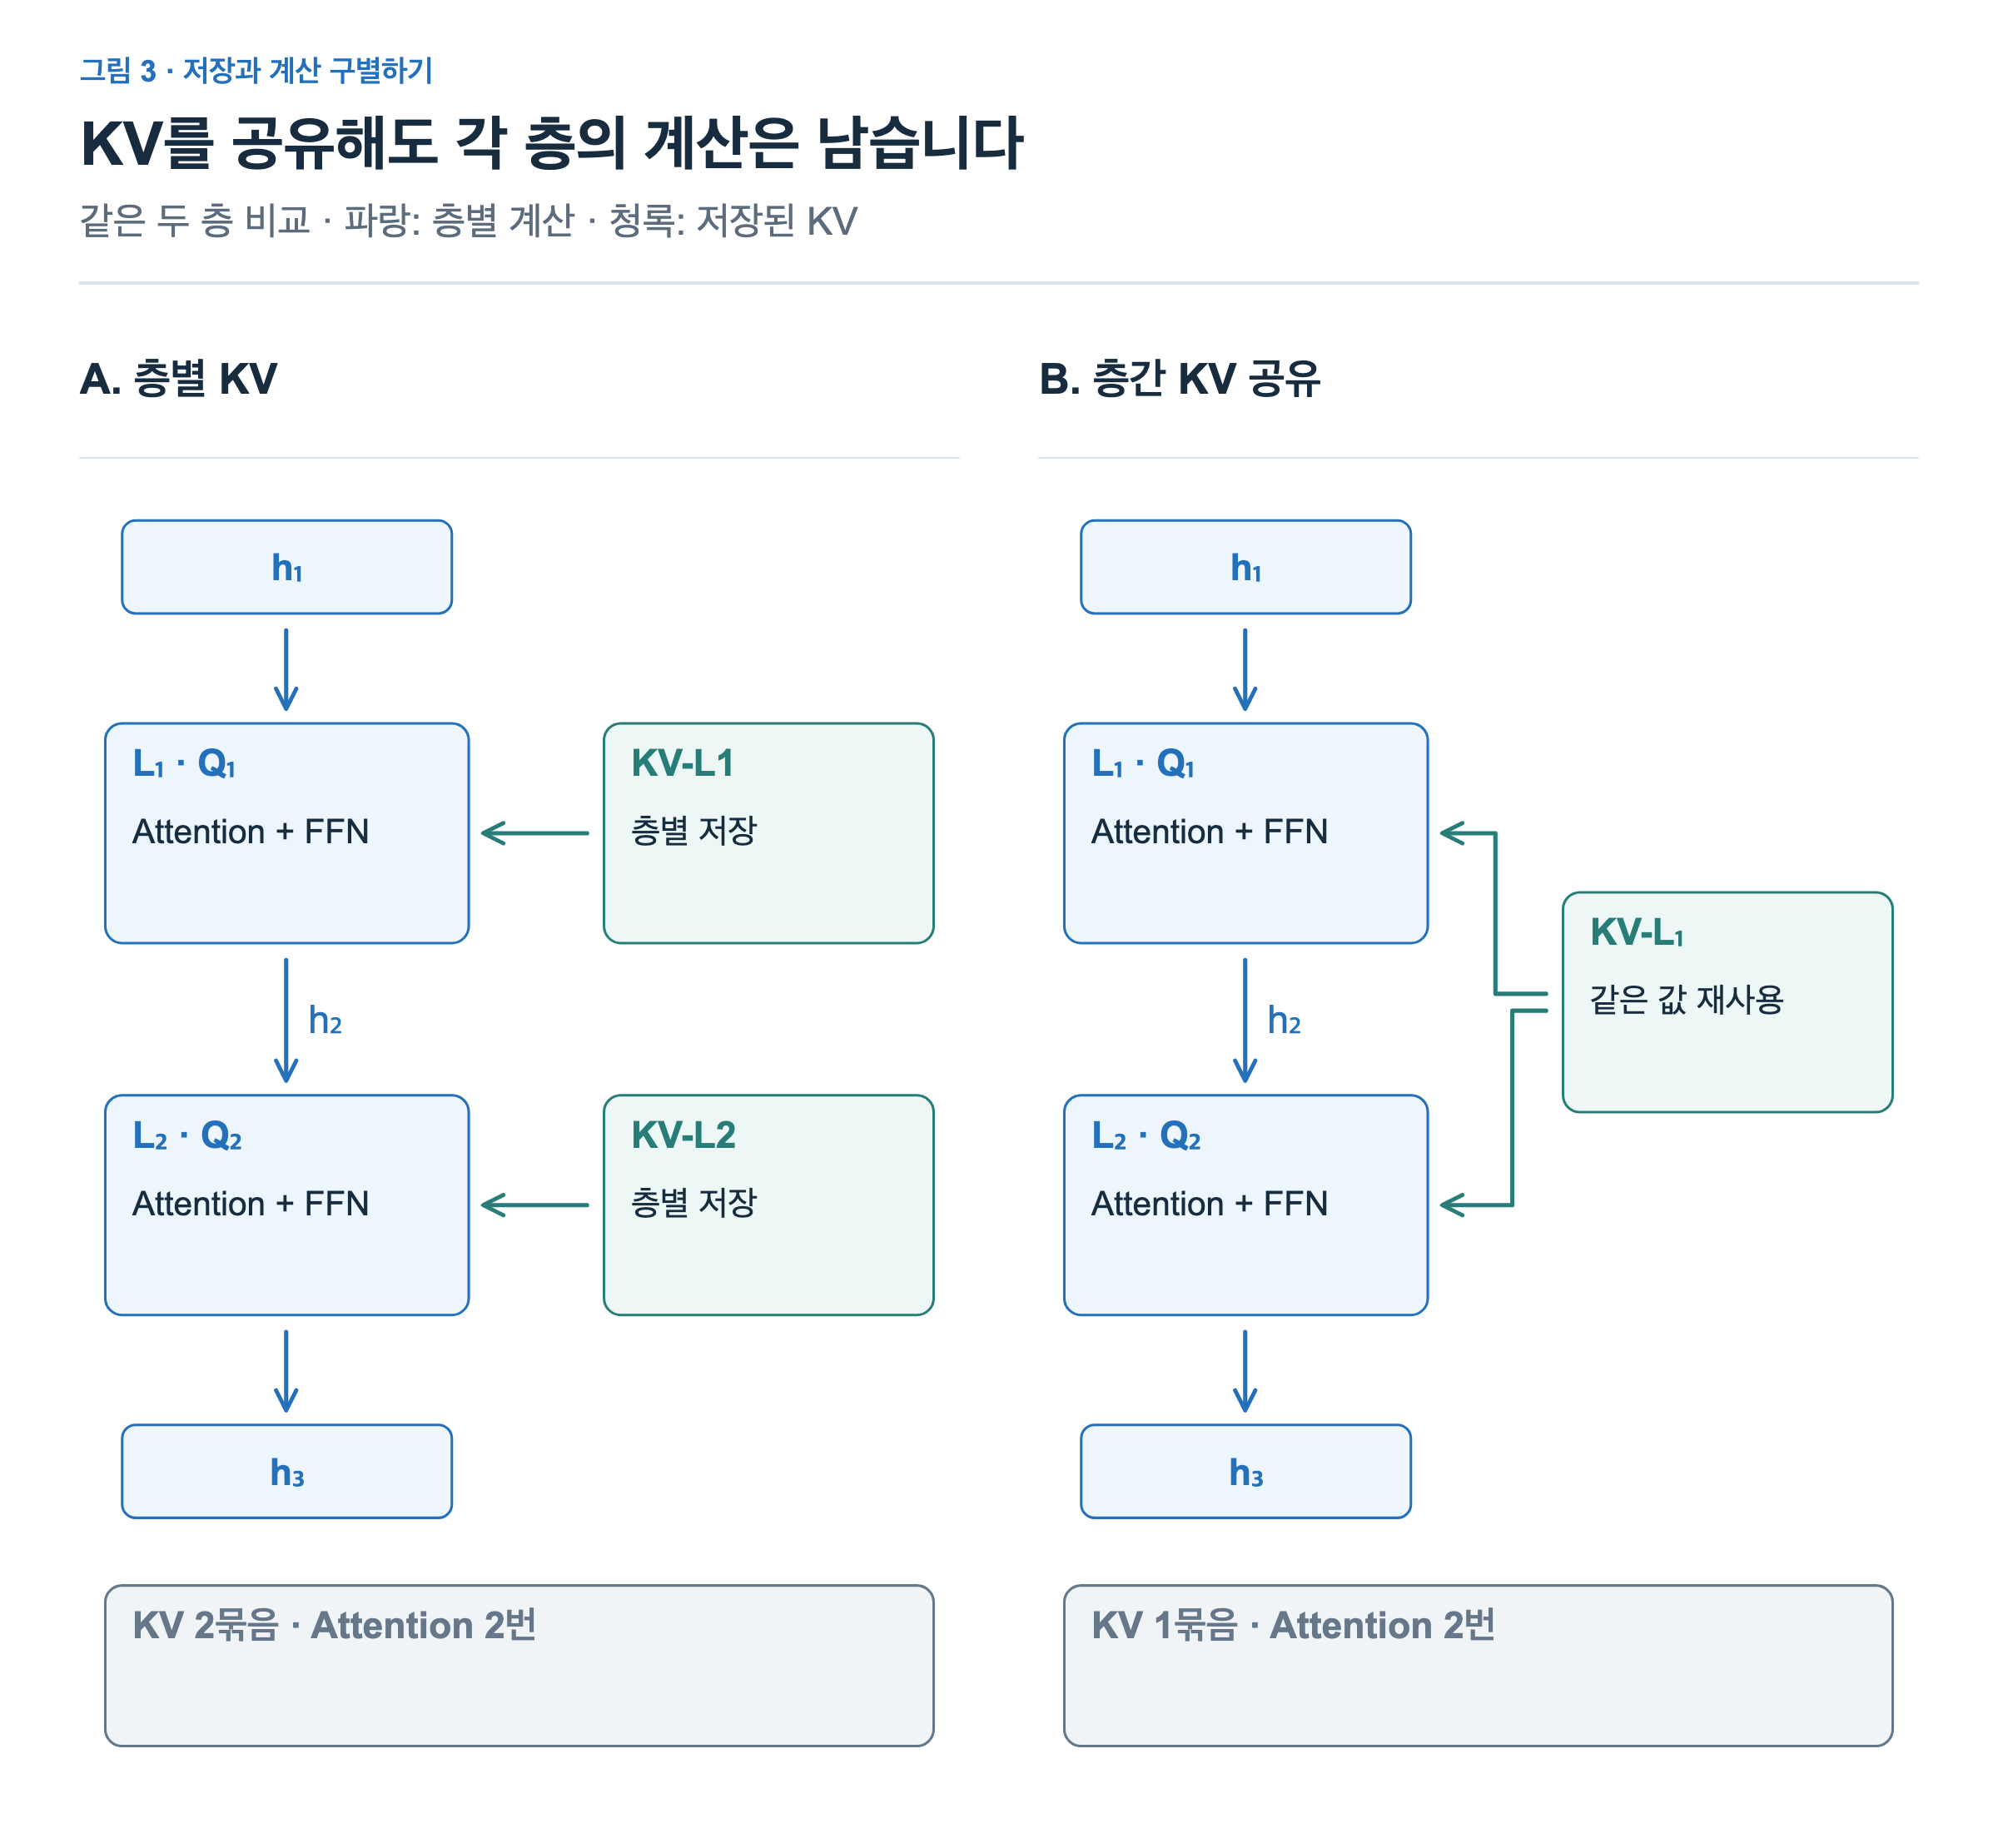
왼쪽과 오른쪽 모두 attention을 두 번 수행합니다. 오른쪽의 두 Query는 같은 Key 목록으로 점수를 계산하지만 Query 자체가 다르므로 각자 점수와 가중합을 구해야 합니다. FFN과 층 사이의 순차적인 처리도 남습니다.
소비하는 층에서 별도의 KV를 만들지 않으면 그 층의 K/V 투영과 캐시 쓰기를 생략할 수 있습니다. 해당 투영 가중치도 필요하지 않습니다. 다만 attention은 층마다 공유 KV를 다시 읽습니다. CLA 논문 §2.3도 KV 저장량 감소와 전체 계산량·지연 시간 감소를 구분합니다.
두 층 공유에서 세 층 공유로
지금까지 사용한 두 층 공유가 CLA2입니다. 원논문 그림 2는 세 층씩 묶는 CLA3도 비교합니다. 그림 4에서는 앞서 사용한 여섯 층과 네 토큰을 그대로 두고 공유 범위만 바꿉니다.
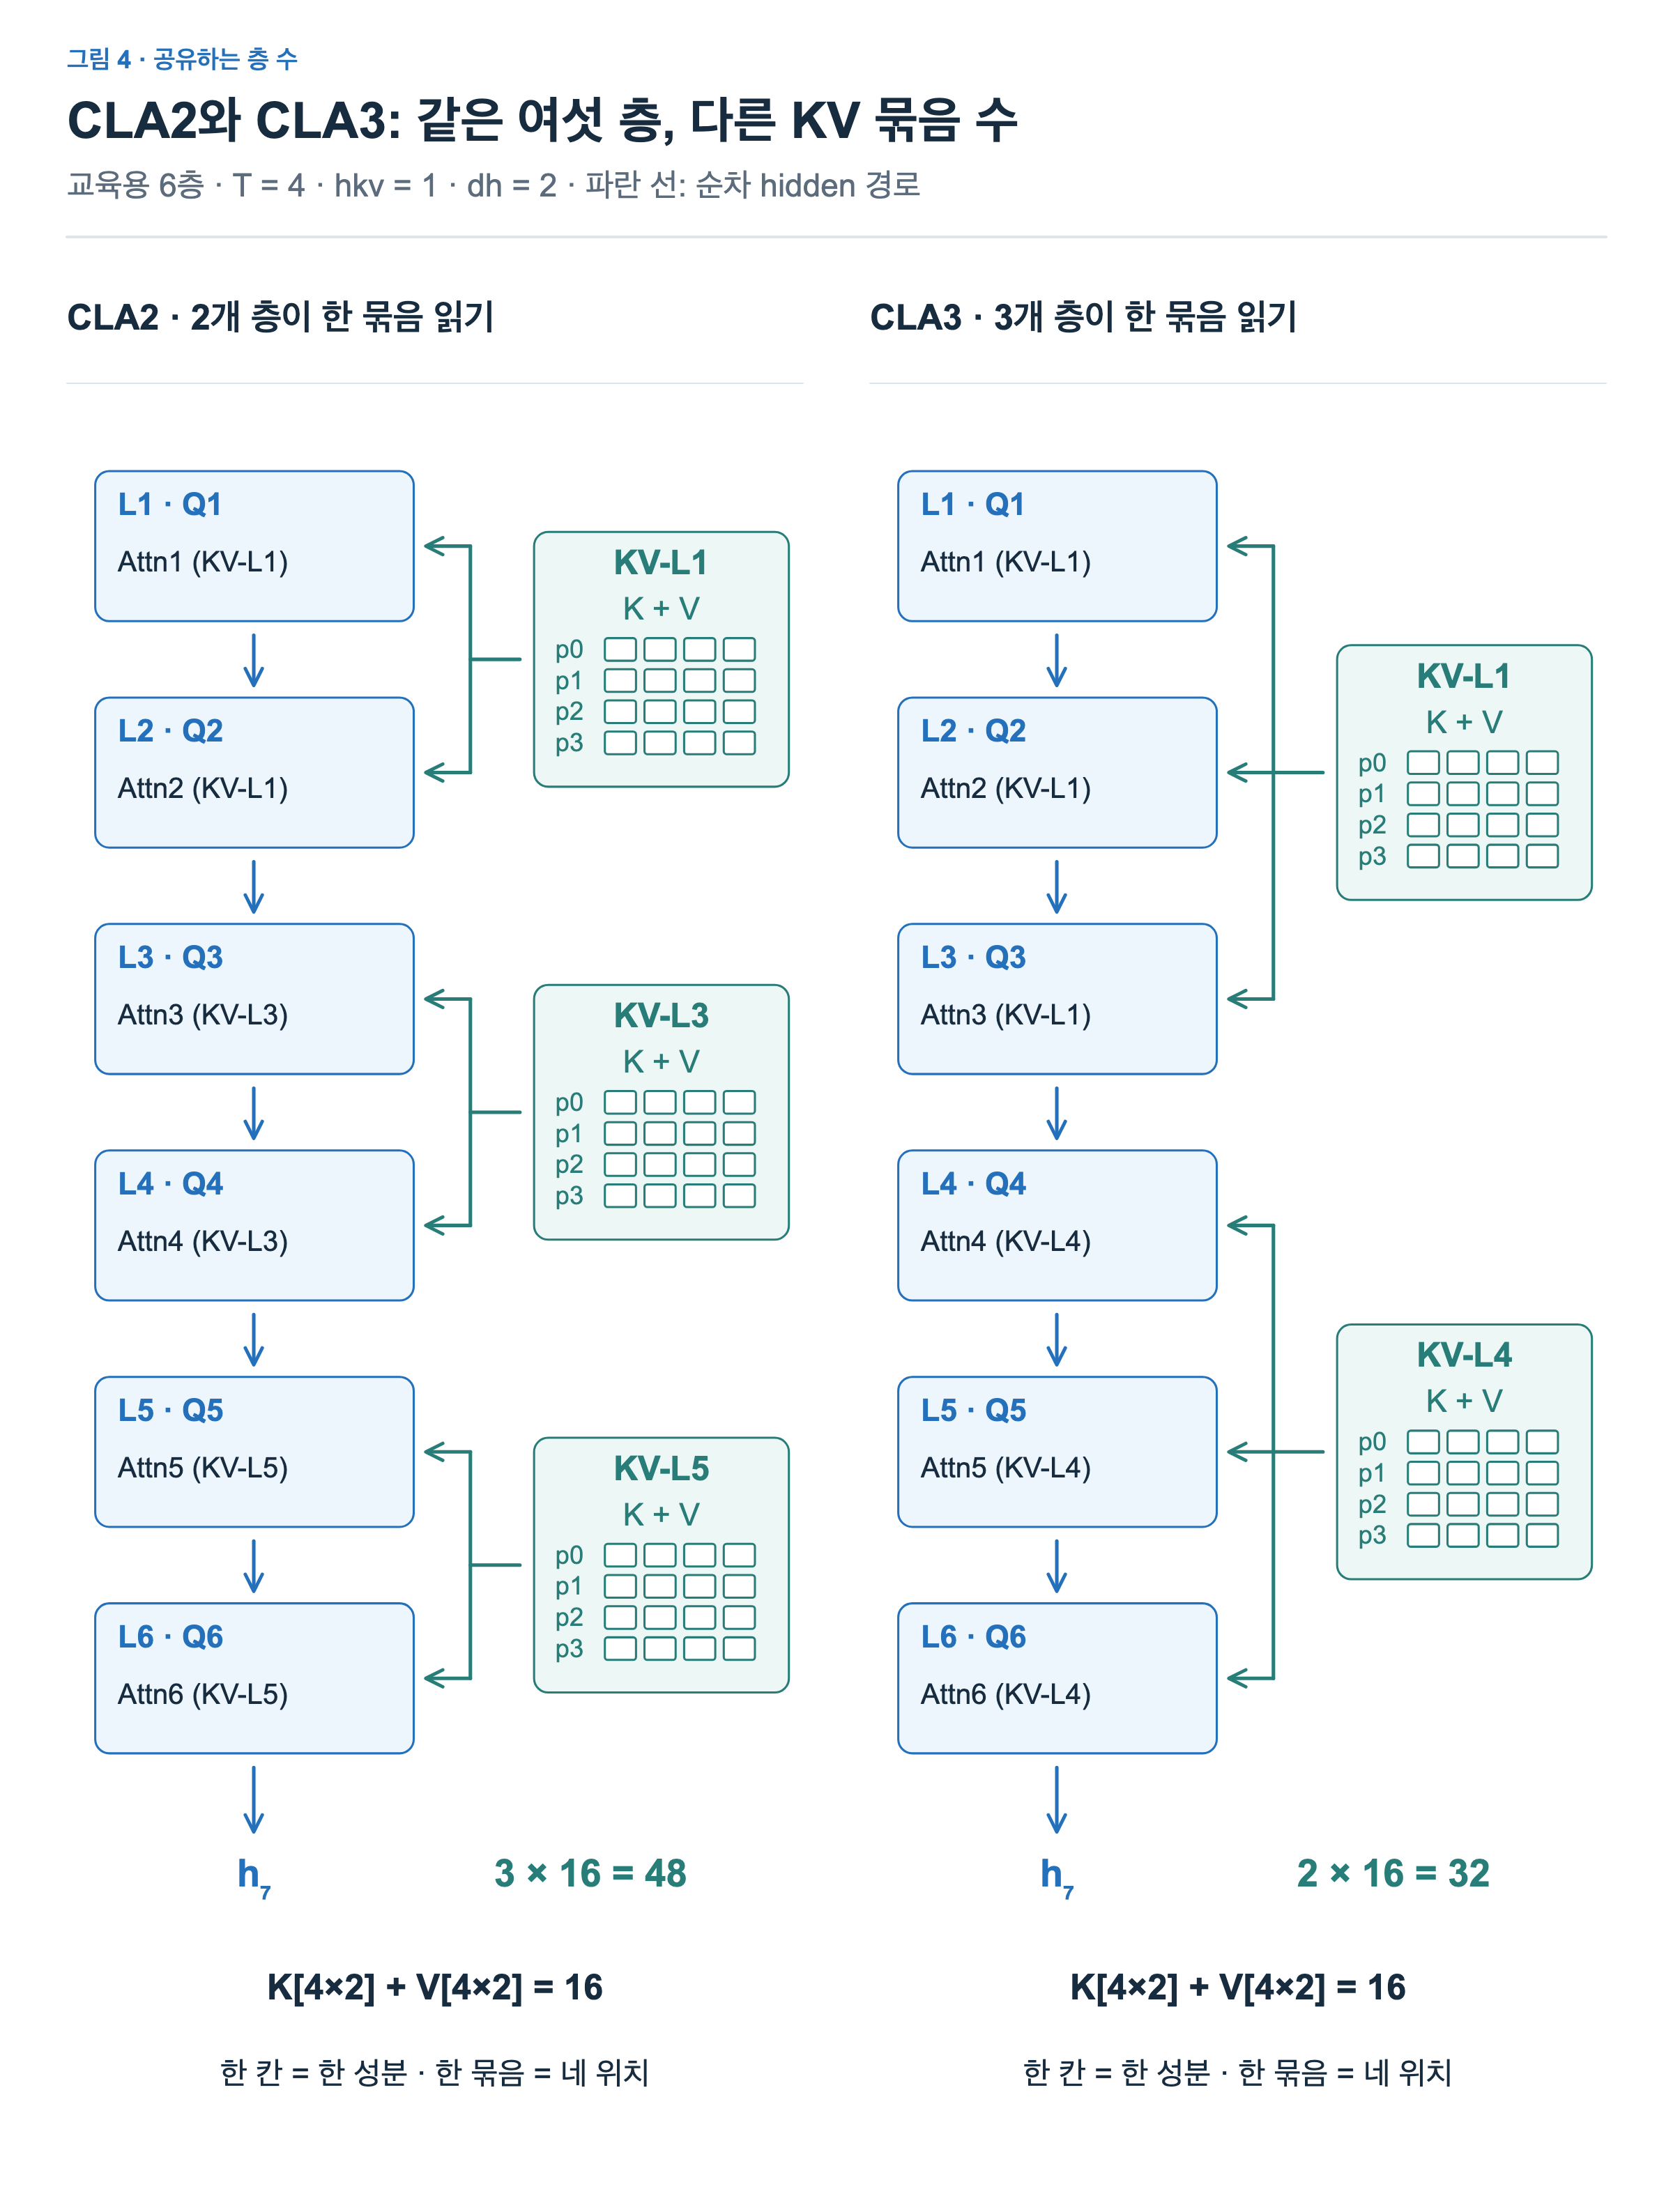
CLA2는 L₁·L₃·L₅가 KV를 만들어 3 × 16 = 48성분을 저장합니다. CLA3는 L₁·L₄만 생산자이므로 2 × 16 = 32성분입니다. 예를 들어 L₃는 CLA2에서 자기 KV를 만들지만, CLA3에서는 L₁의 KV를 자신의 Q₃로 읽습니다. 두 구조 모두 여섯 층의 Query와 attention 계산은 남습니다.
여기서 2와 3은 같은 KV를 읽는 층의 수입니다. 세 토큰을 한 토큰으로 합치는 시퀀스 압축률이 아닙니다. 모든 묶음은 여전히 p0부터 p3까지 네 위치의 Key와 Value를 보관합니다.
구조를 바꾸는 대가도 있습니다. 층별 KV를 쓰는 L₂는 더 깊어진 자기 입력으로 별도의 Key와 Value를 만들 수 있습니다. 공유하는 L₂는 그 선택을 포기하고, L₁이 만든 표현을 자신의 Query로 읽습니다. Query가 달라질 수 있다는 사실만으로 두 구조가 같은 출력을 낸다고 보장할 수는 없습니다. 공유 범위를 넓힐 때는 저장량과 함께 모델 품질도 확인해야 합니다.
층간 공유는 이 구조에 맞춰 학습하는 모델 설계입니다.
이제 층간 공유를 볼 때는 KV를 만드는 층, 그 값을 읽는 층, 새 토큰이 추가되는 순서를 구별할 수 있습니다. 다음 글에서는 모델의 앞부분이 만든 KV를 뒷부분의 여러 층이 읽도록 역할을 나누는 YOCO로 이어가겠습니다.