공통 · 모델 · 2026-09-28
Attention Residuals: 지나온 층의 출력을 선택해서 읽기
과거 층의 새 출력을 보관하고 깊이별 비중으로 읽는 과정을 계산해 보고, 학습 Query와 Block 방식의 저장량·선택 단위 절충을 설명합니다.
HC/mHC와 Gated Residual은 같은 토큰의 표현을 여러 stream에 유지했습니다. 각 층은 그 표현들을 읽어 계산하고, 결과를 다시 stream들에 씁니다. 지나온 모든 층의 출력을 하나씩 보관하는 구조는 아니었습니다.
Attention Residuals(AttnRes)는 다른 질문에서 출발합니다. 과거 층이 만든 결과를 따로 보관해 두고, 다음 층이 필요한 결과를 골라 읽을 수 있을까요? 토큰 사이에서 정보를 선택하던 attention의 생각을 깊이 방향의 연결에도 적용하는 것입니다.
먼저 개별 출력을 보관하는 Full 방식과 가중합을 살펴보고, 그 비중을 계산하는 과정을 연결하겠습니다. 마지막에는 출력을 묶어서 보관하는 Block 방식의 절충과 앞선 두 계열의 차이를 정리합니다. 구체적인 점수·Block 정의는 Kimi K3 보고서 §2.2를 기준으로 합니다.
누적 표현과 개별 출력
Embedding을 e, 각 sublayer의 새 출력을 , 라고 하겠습니다. 이 글의 sublayer는 Attention이나 MLP처럼 residual 연결이 걸리는 계산 단위입니다. 그림의 아래첨자는 토큰 위치가 아니라 이 계산의 깊이를 가리킵니다.
기본 residual에서는 e, , 가 합쳐진 표현을 다음 F에 넣습니다. Full AttnRes에서는 이 세 벡터를 별도 source, 즉 읽을 후보로 보관합니다. 그림 1에서 중요한 차이는 화살표의 개수보다 다음 입력을 만들 때 무엇을 따로 읽을 수 있는가입니다.
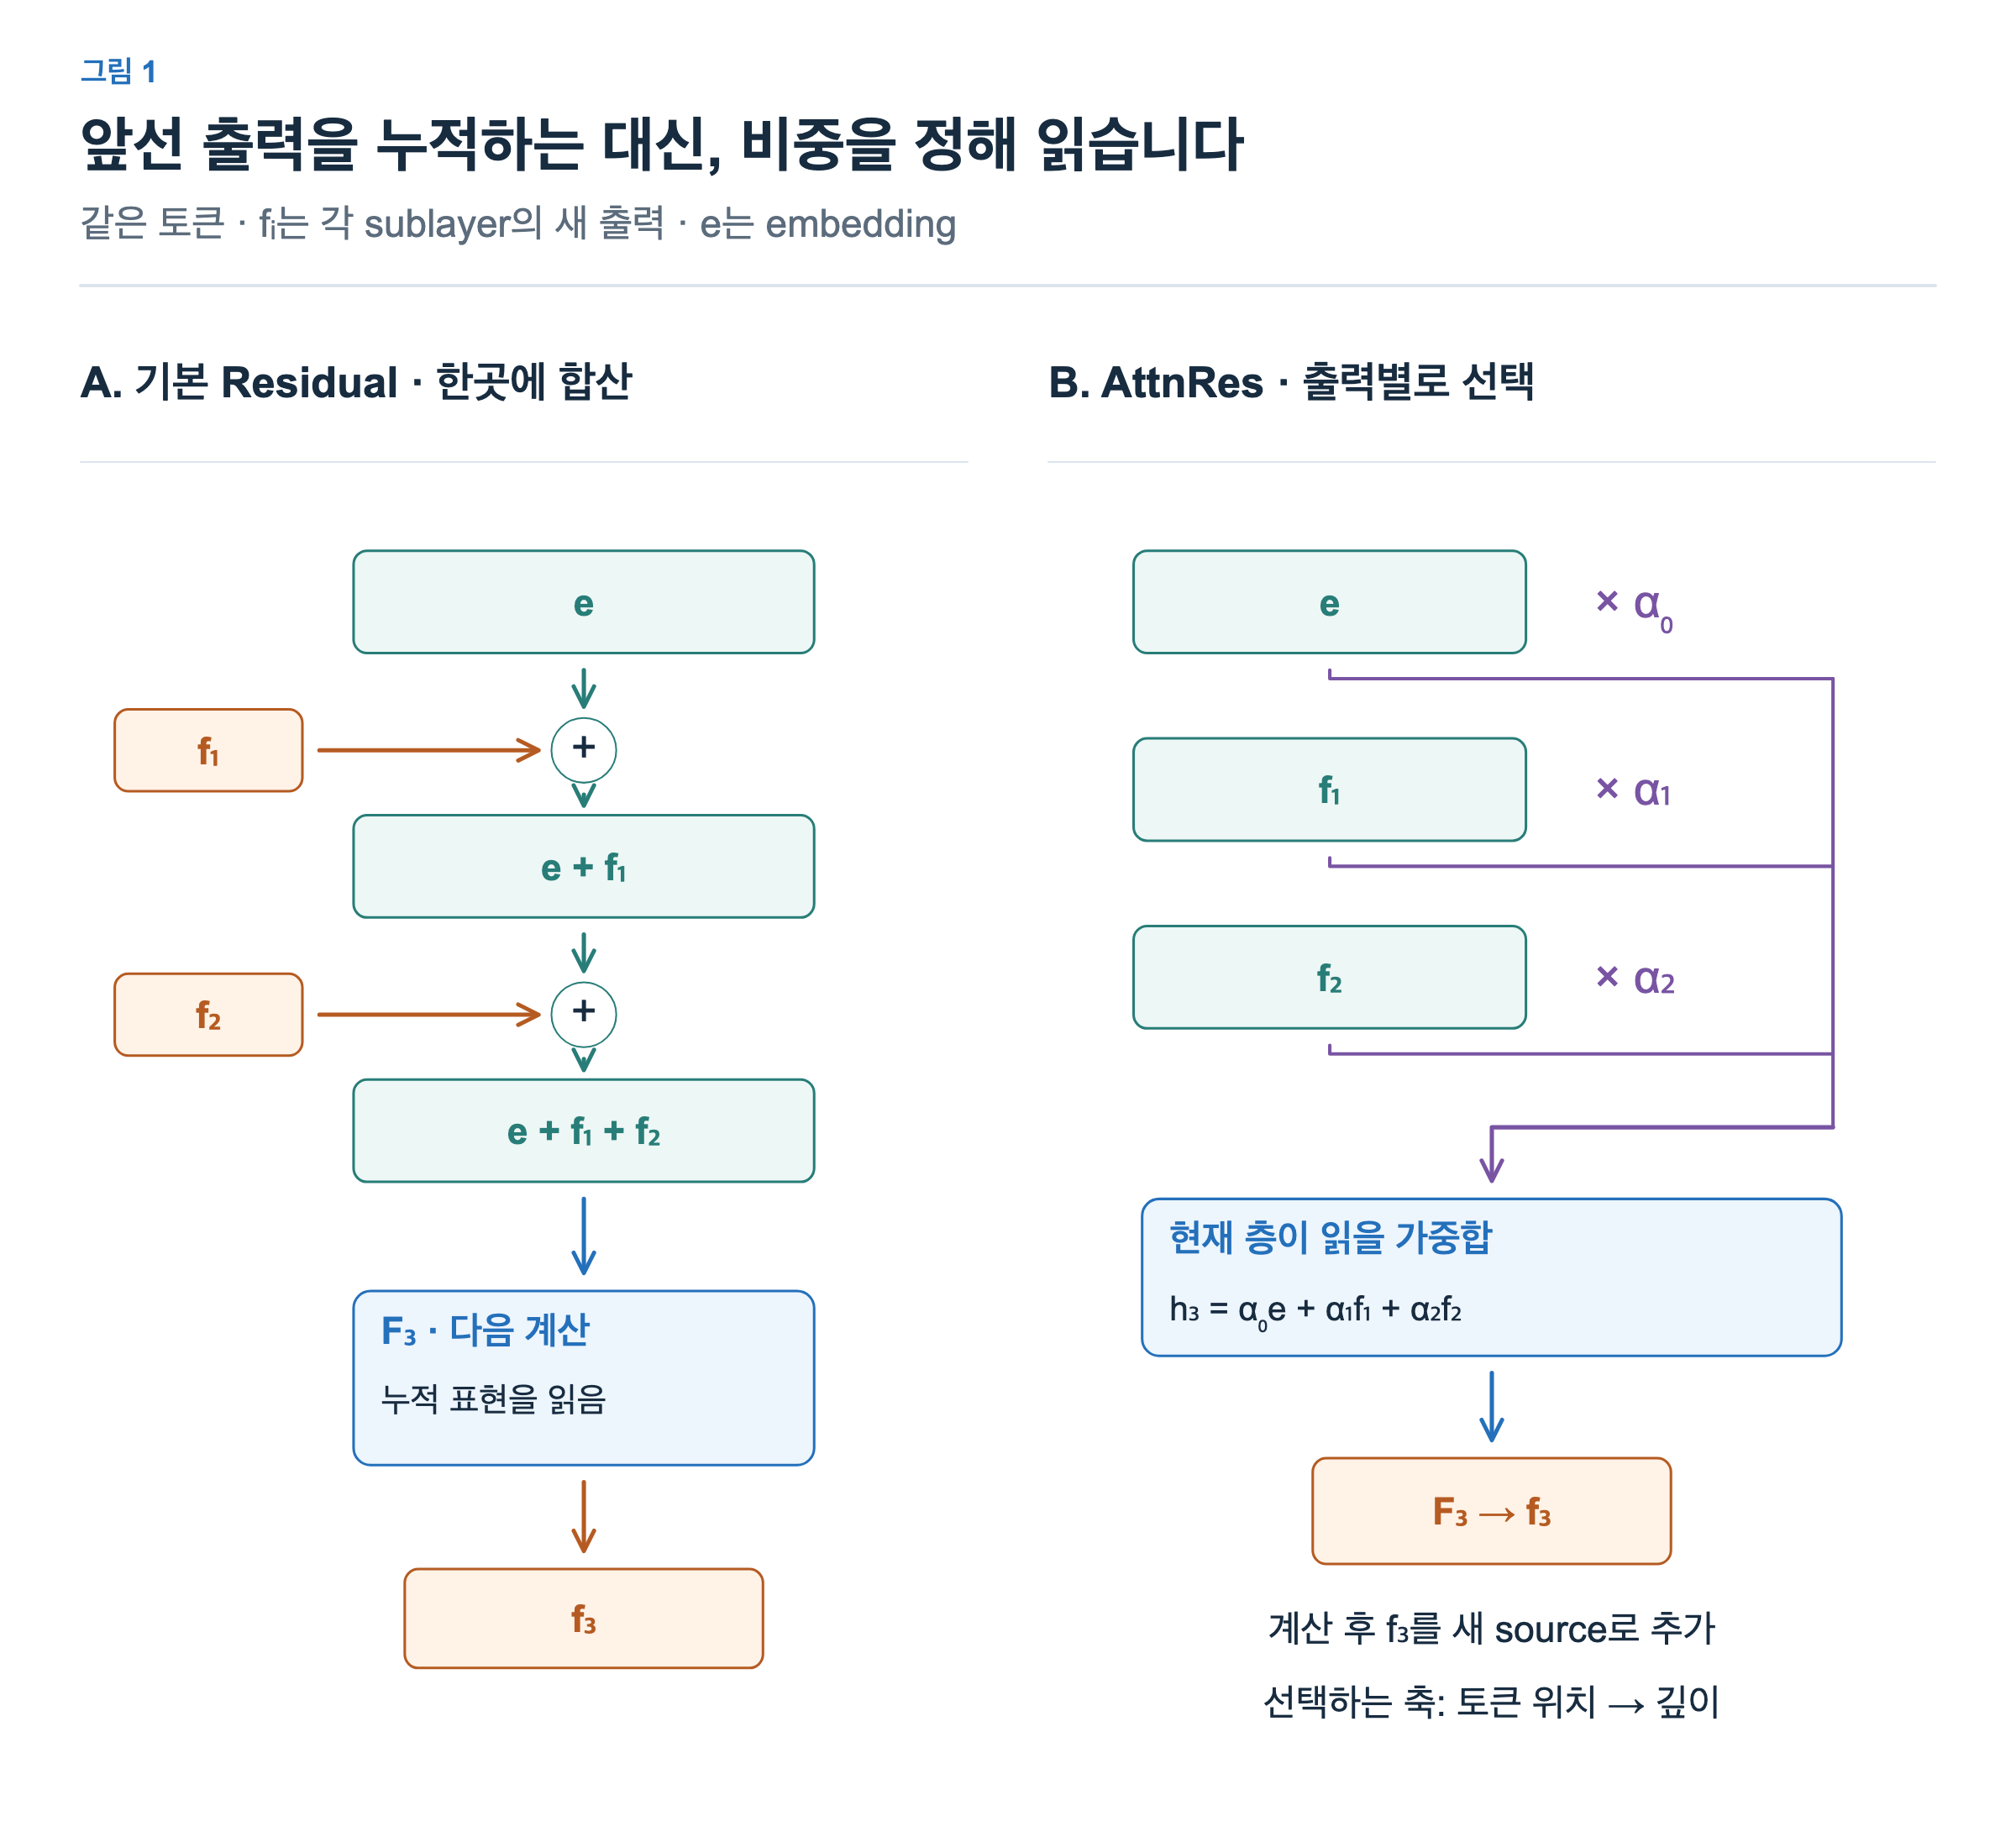
오른쪽은 e, , 에 각각 비중을 곱해 입력 을 만듭니다. 그 입력을 가 처리하면 새로운 출력 이 생깁니다. 그 뒤의 계산부터 도 source로 사용할 수 있습니다. 아직 계산하지 않은 출력을 미리 읽는 순환은 없습니다.
여기서 는 e + + 같은 누적 표현이 아니라 두 번째 F가 새로 만든 출력입니다. 누적 표현들을 source로 잘못 넣으면 앞선 기여가 여러 항에 중복되어 그림과 다른 연산이 됩니다. 각 새 출력이 이전 결과를 바탕으로 계산되었다는 사실과, 저장하는 항목이 새 출력이라는 사실은 함께 성립합니다.
AttnRes 원 논문은 PreNorm 구조에서 깊이에 따라 누적 표현의 크기가 커지면서 개별 층의 기여가 상대적으로 희석되는 문제도 동기로 제시합니다. 과거 결과들을 따로 읽고 비중을 다시 정하면, 어느 결과를 이번 입력에 강하게 반영할지 조절할 수 있습니다. 이것은 구조의 설계 목적이며, 모든 모델에서 같은 크기의 이득을 보장한다는 뜻은 아닙니다.
또한 일반적인 self-attention과 선택하는 축이 다릅니다. Self-attention은 여러 토큰 위치의 정보를 읽습니다. 이 그림은 같은 토큰 위치에서 이미 계산된 여러 깊이의 출력을 읽습니다. AttnRes가 Attention sublayer의 토큰 간 계산을 대체하는 것은 아닙니다. Attention이나 MLP가 받을 입력을 만드는 residual 연결이 달라진 것입니다.
비중이 달라지면 입력도 달라진다
하나의 토큰에서 e = [2, 0, 0], = [0, 4, 0], = [0, 0, 6]을 보관했다고 하겠습니다. 세 source는 각각 3차원 벡터입니다. 계산을 눈으로 구분하기 위해 서로 다른 성분만 0이 아니도록 정한 교육용 예시이며, 실제 출력이 이런 형태여야 하는 것은 아닙니다.
다음 층이 e, , 를 읽는 비중을 각각 0.25, 0.5, 0.25로 두겠습니다. 비중을 어디서 구하는지는 다음 절에서 설명하고, 먼저 그 비중으로 어떤 입력이 만들어지는지 보겠습니다.

각 비중은 source 벡터 전체에 곱합니다.
| Source | 비중 | 이번 입력에 기여하는 값 |
|---|---|---|
| e = [2, 0, 0] | 0.25 | [0.5, 0, 0] |
| = [0, 4, 0] | 0.5 | [0, 2, 0] |
| = [0, 0, 6] | 0.25 | [0, 0, 1.5] |
이 세 벡터를 성분끼리 더하면 = [0.5, 2, 1.5]입니다. 비중 목록 [0.25, 0.5, 0.25]와 결과 벡터 [0.5, 2, 1.5]는 다른 대상입니다. 전자는 source 세 개에 대응하고 후자는 특징 성분 세 개에 대응합니다. 이 예시에서만 source 수와 벡터 차원이 둘 다 3입니다.
비중을 [0.5, 0.25, 0.25]로 바꾸면 결과는 [1, 1, 1.5]가 됩니다. 보관된 벡터들은 그대로인데 다음 F가 받는 입력이 바뀐 것입니다. 따라서 선택은 source 하나만 고르는 동작에 한정되지 않습니다. 여러 결과의 기여를 서로 다르게 조절하는 연속적인 가중합입니다.
기본 residual의 단순 합이라면 이 예시의 값은 [2, 4, 6]입니다. AttnRes에서 비중을 모두 같게 해도 softmax 비중의 합은 1이므로 평균이 됩니다. 가중합을 균일하게 만드는 것과 기본 residual의 합으로 돌아가는 것은 같은 연산이 아닙니다.
학습된 Query로 비중 계산하기
이제 앞에서 정한 [0.25, 0.5, 0.25]가 만들어지는 예를 보겠습니다. 각 목적지 sublayer에는 학습되는 d차원 벡터 w가 있습니다. 논문에서는 이를 pseudo-query라고 부릅니다. 여기의 w는 현재 hidden state를 Query 투영에 넣어 만든 벡터가 아니라, 이 목적지 층이 가진 학습 파라미터입니다.
그림 3은 점수를 만드는 경로와 그 비중으로 원본을 섞는 경로를 구분합니다. 점수를 계산할 때는 source를 RMSNorm으로 정규화합니다. 가중합에 사용하는 값은 정규화 전 원본입니다.

Gain을 1로 두고 ε를 생략하면 e = [2, 0, 0]의 RMS는 2/√3입니다. 이를 나누면 [√3, 0, 0]이 됩니다. 같은 방식으로 과 는 각각 [0, √3, 0], [0, 0, √3]이 됩니다. 원본의 크기 2, 4, 6이 점수에 그대로 곱해지는 효과를 정규화가 줄여 줍니다.
w = [0, ln2/√3, 0]인 경우를 만들어 보겠습니다. 정규화된 세 source와 w를 내적하면 e의 점수는 0, 의 점수는 ln2, 의 점수는 0입니다. 여기서 ln은 자연로그입니다.
Softmax는 각 점수에 지수 함수를 적용한 뒤 그 합으로 나눕니다. exp(0) = 1, exp(ln2) = 2이므로 이 예시의 계산은 간단합니다.
이렇게 얻은 비중이 앞 절의 [0.25, 0.5, 0.25]입니다. 이를 원본 [2, 0, 0], [0, 4, 0], [0, 0, 6]에 적용하므로 최종 입력은 다시 [0.5, 2, 1.5]가 됩니다. 점수 계산에 쓴 √3을 원본에 다시 곱하지 않습니다.
w가 층의 파라미터라면 모든 입력에서 같은 비중이 나올까요? 그렇지는 않습니다. w와 내적하는 source가 토큰과 입력에 따라 달라질 수 있기 때문입니다. 같은 목적지 층의 w를 공유하더라도 source의 방향이 달라지면 점수와 softmax 비중도 달라집니다. 다만 정규화 때문에 원본 크기만 달라지는 변화가 점수에 그대로 반영되지는 않습니다.
이 설명은 보고서의 Full AttnRes 정의, 식 (8)–(9)를 위 숫자로 직접 계산한 것입니다. w와 source 값은 교육용으로 구성했으며 학습된 실제 모델에서 추출한 값이 아닙니다.
Block으로 묶어서 보관하기
과거 출력을 따로 읽으려면 그 출력이 필요할 때까지 살아 있어야 합니다. 기본 residual처럼 현재 합 하나만 유지하면 나중에 과 를 각각 골라 읽을 수 없습니다. Full AttnRes의 선택 자유도에는 source 보관과 반복 읽기 비용이 따릅니다.
Block AttnRes는 깊이 방향의 여러 sublayer 출력을 합쳐 하나의 source로 보관합니다. 그림 4는 까지 계산한 같은 시점에서 두 방식을 비교합니다. 여기의 Block은 문맥의 토큰 구간이 아니라 깊이 방향 sublayer 묶음입니다.
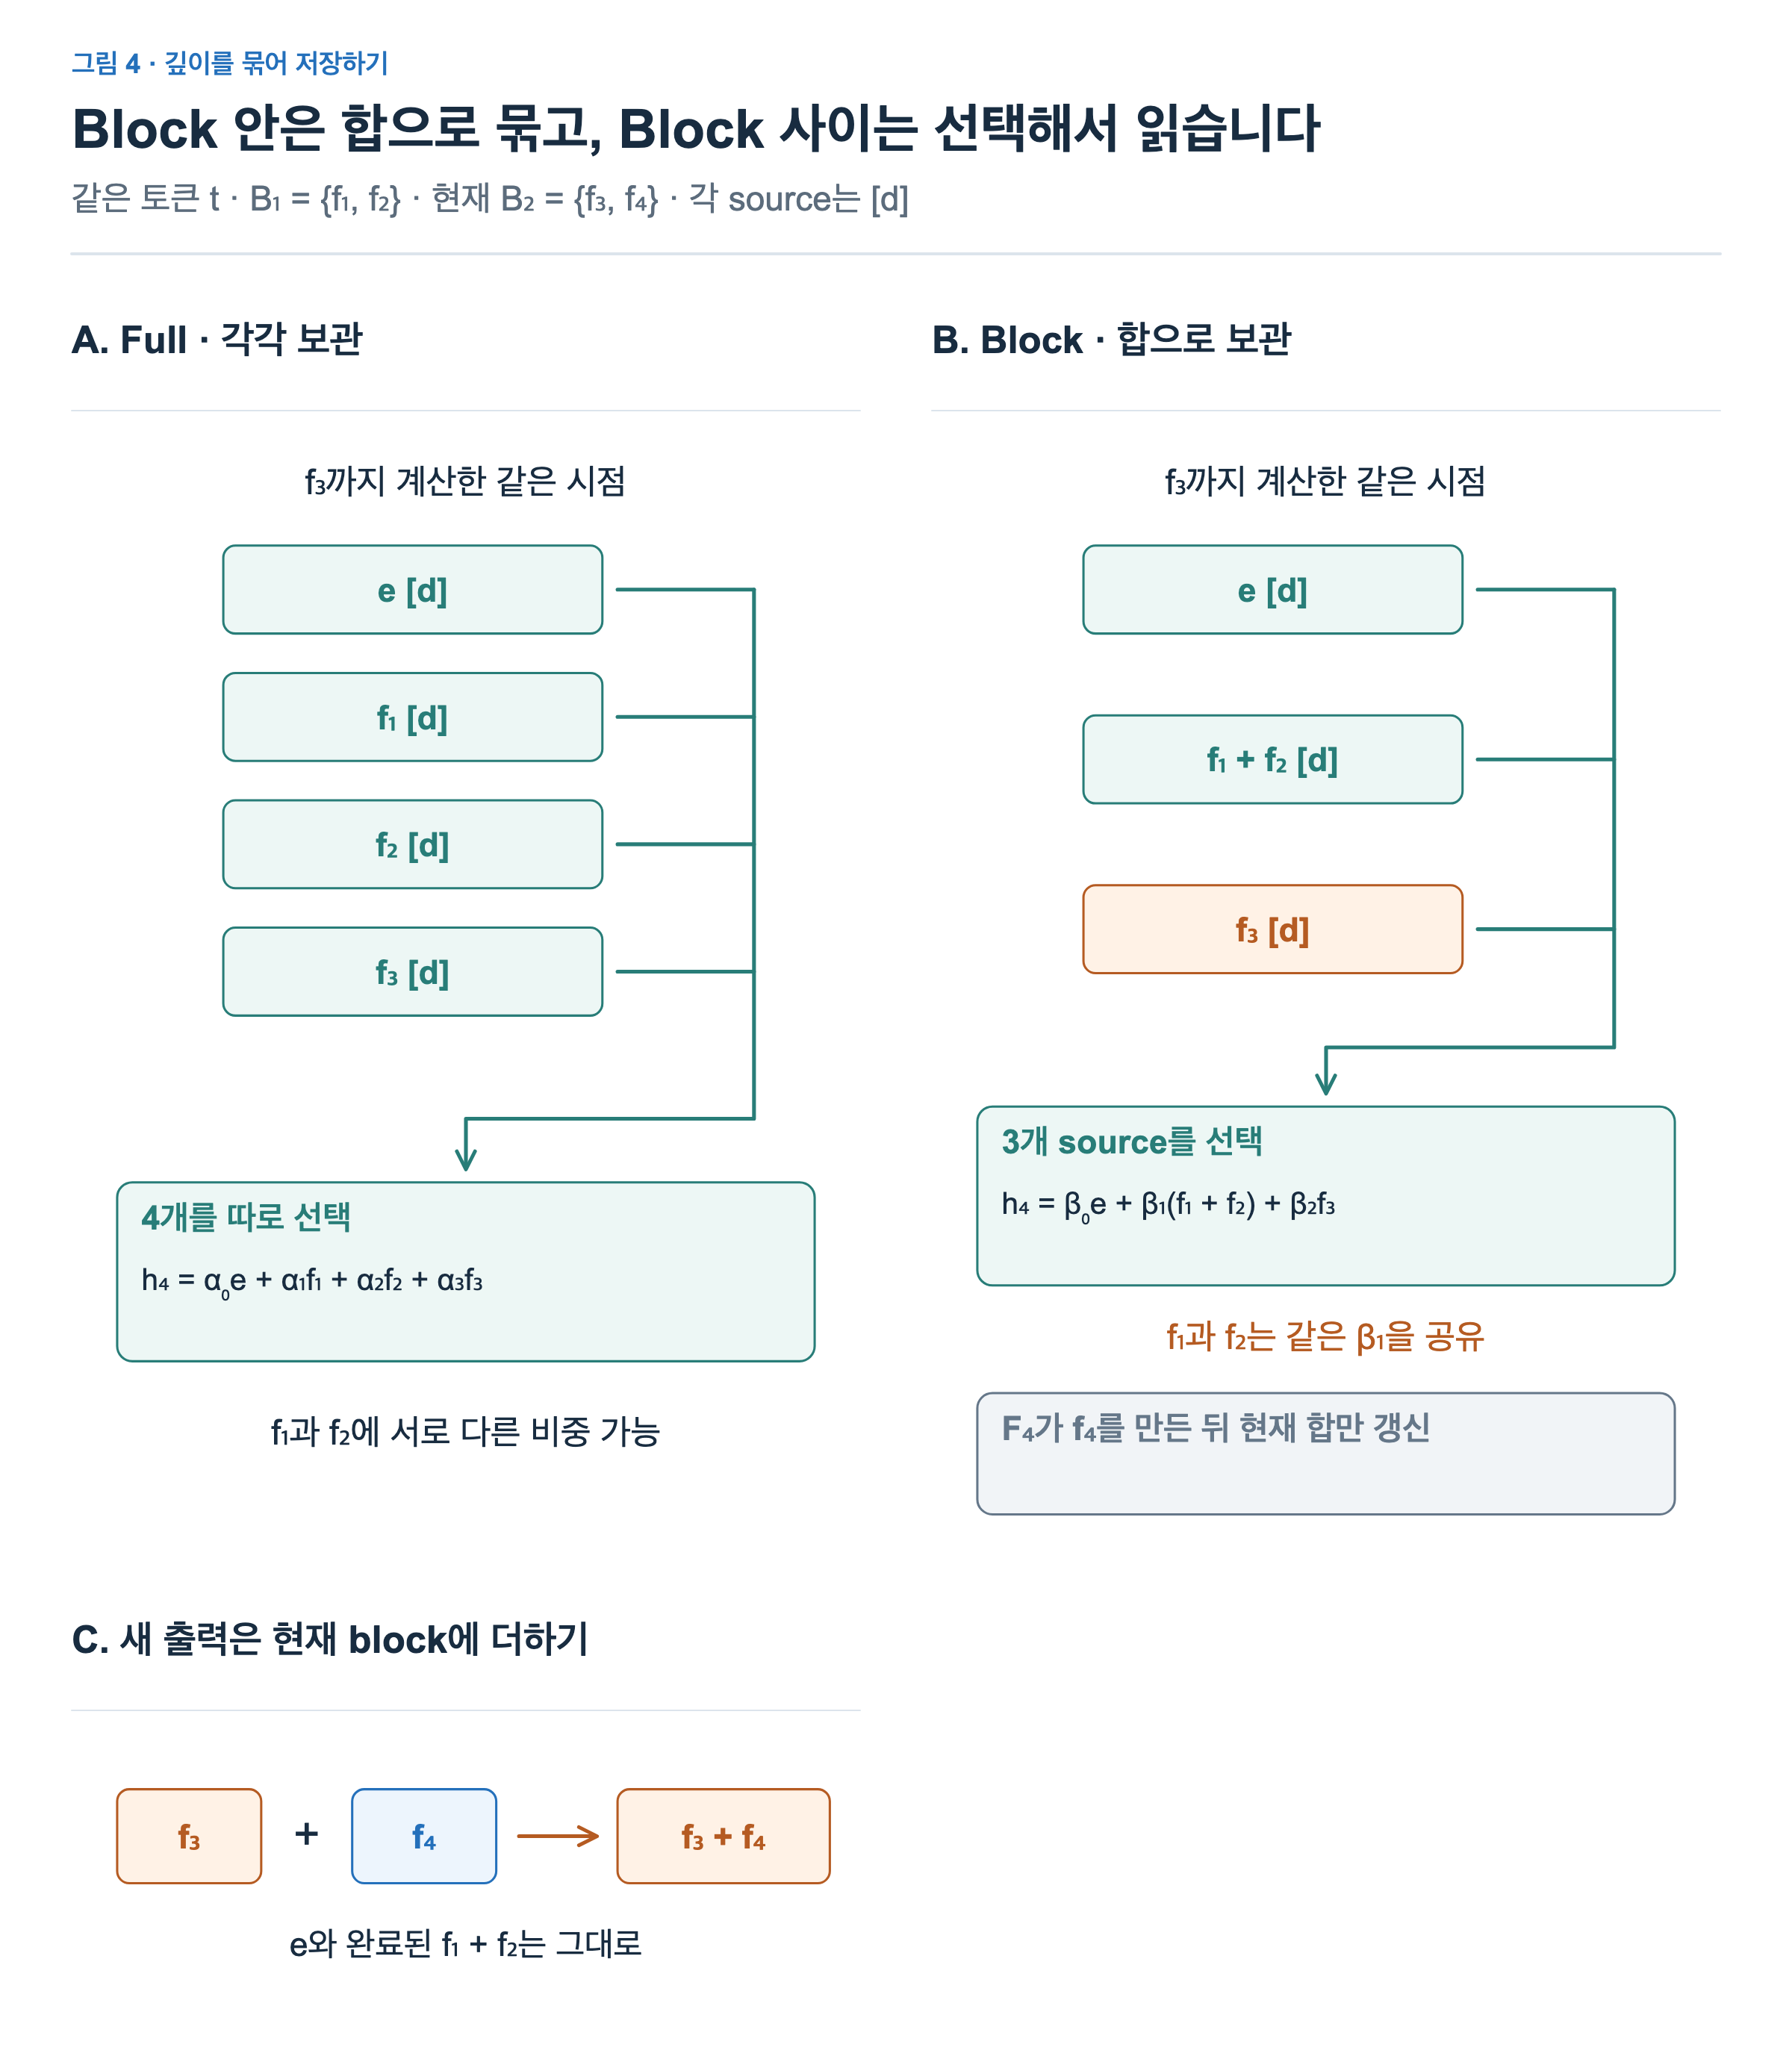
Full은 e, , , 네 source를 보관합니다. 예시의 Block은 e, + , 세 source를 보관합니다. 첫 block은 완료되었고, 두 번째 block에는 아직 만 들어 있는 시점입니다. 각 source의 폭은 모두 d입니다.
저장할 벡터가 4개에서 3개로 줄지만 선택 단위도 달라집니다. Full은 과 에 서로 다른 비중을 줄 수 있습니다. Block에서는 이미 두 벡터를 더했으므로 그 합에 하나의 비중 을 곱합니다.
둘은 같은 비중을 공유합니다. 게다가 점수도 개별 출력이 아닌 합쳐진 source에서 계산하므로, Full에서 구했던 비중을 단순히 더한 것과 같지 않습니다. Block은 Full과 동일한 결과를 더 적은 저장 공간으로 계산하는 항등 변환이 아니라, 저장량을 줄이는 대신 세밀한 선택을 묶음 단위로 바꾸는 설계입니다.
현재 세 source를 읽어 를 만든 다음, 가 를 계산합니다. 그 뒤 현재 block의 합이 + 로 갱신됩니다. Embedding e와 완료된 + 는 그대로입니다. 는 자기 자신을 만들기 위한 읽기에 참여하지 않습니다. 또한 이 정의에서는 block 첫 sublayer가 아직 비어 있는 현재 합을 source로 넣지 않습니다.
깊이 선택의 저장 비용
한 토큰에 대해 L개의 새 출력을 각각 보관하면 source 저장량은 대략 Ld에 비례합니다. N개의 block 합으로 묶으면 Nd에 비례하는 구조로 줄어듭니다. Embedding과 현재 partial 합의 취급에 따른 작은 항은 여기서 생략했습니다. 이 비교는 residual source 저장에 대한 것으로, 전체 학습 메모리가 같은 비율로 줄어든다는 뜻은 아닙니다.
Full에서 각 층이 앞선 모든 source를 읽으면 깊이 전체의 읽기 연산도 누적됩니다. Source 수가 1, 2, 3, …처럼 늘어나므로 단순한 계산에서는 그 합이 L의 제곱에 비례합니다. 실제 비용에는 d, 처리하는 토큰 수, 메모리 접근, 병렬화 방식이 함께 작용합니다. AttnRes 원 논문도 Full 구조와 비용을 낮추기 위한 Block 구조를 구분합니다.
이 source 목록을 토큰의 KV cache와 같은 것으로 생각해서는 안 됩니다. 여기서 별도로 보관하는 것은 같은 토큰의 깊이별 출력이며, 토큰 간 attention을 위해 과거 위치의 Key·Value를 유지하는 저장 공간과 역할이 다릅니다. Pipeline parallelism으로 깊이를 여러 장치에 나누면 필요한 source를 다음 stage에 전달하는 비용도 검토해야 합니다.
그림의 4개와 3개는 한 시점의 작은 비교입니다. 이것만으로 처리 시간이 25% 줄거나 특정 모델의 품질이 유지된다고 말할 수는 없습니다. 더 큰 block은 저장할 source 수를 줄이지만, 하나로 묶여 개별 선택이 어려워지는 출력도 늘립니다.
세 Residual 설계의 연결
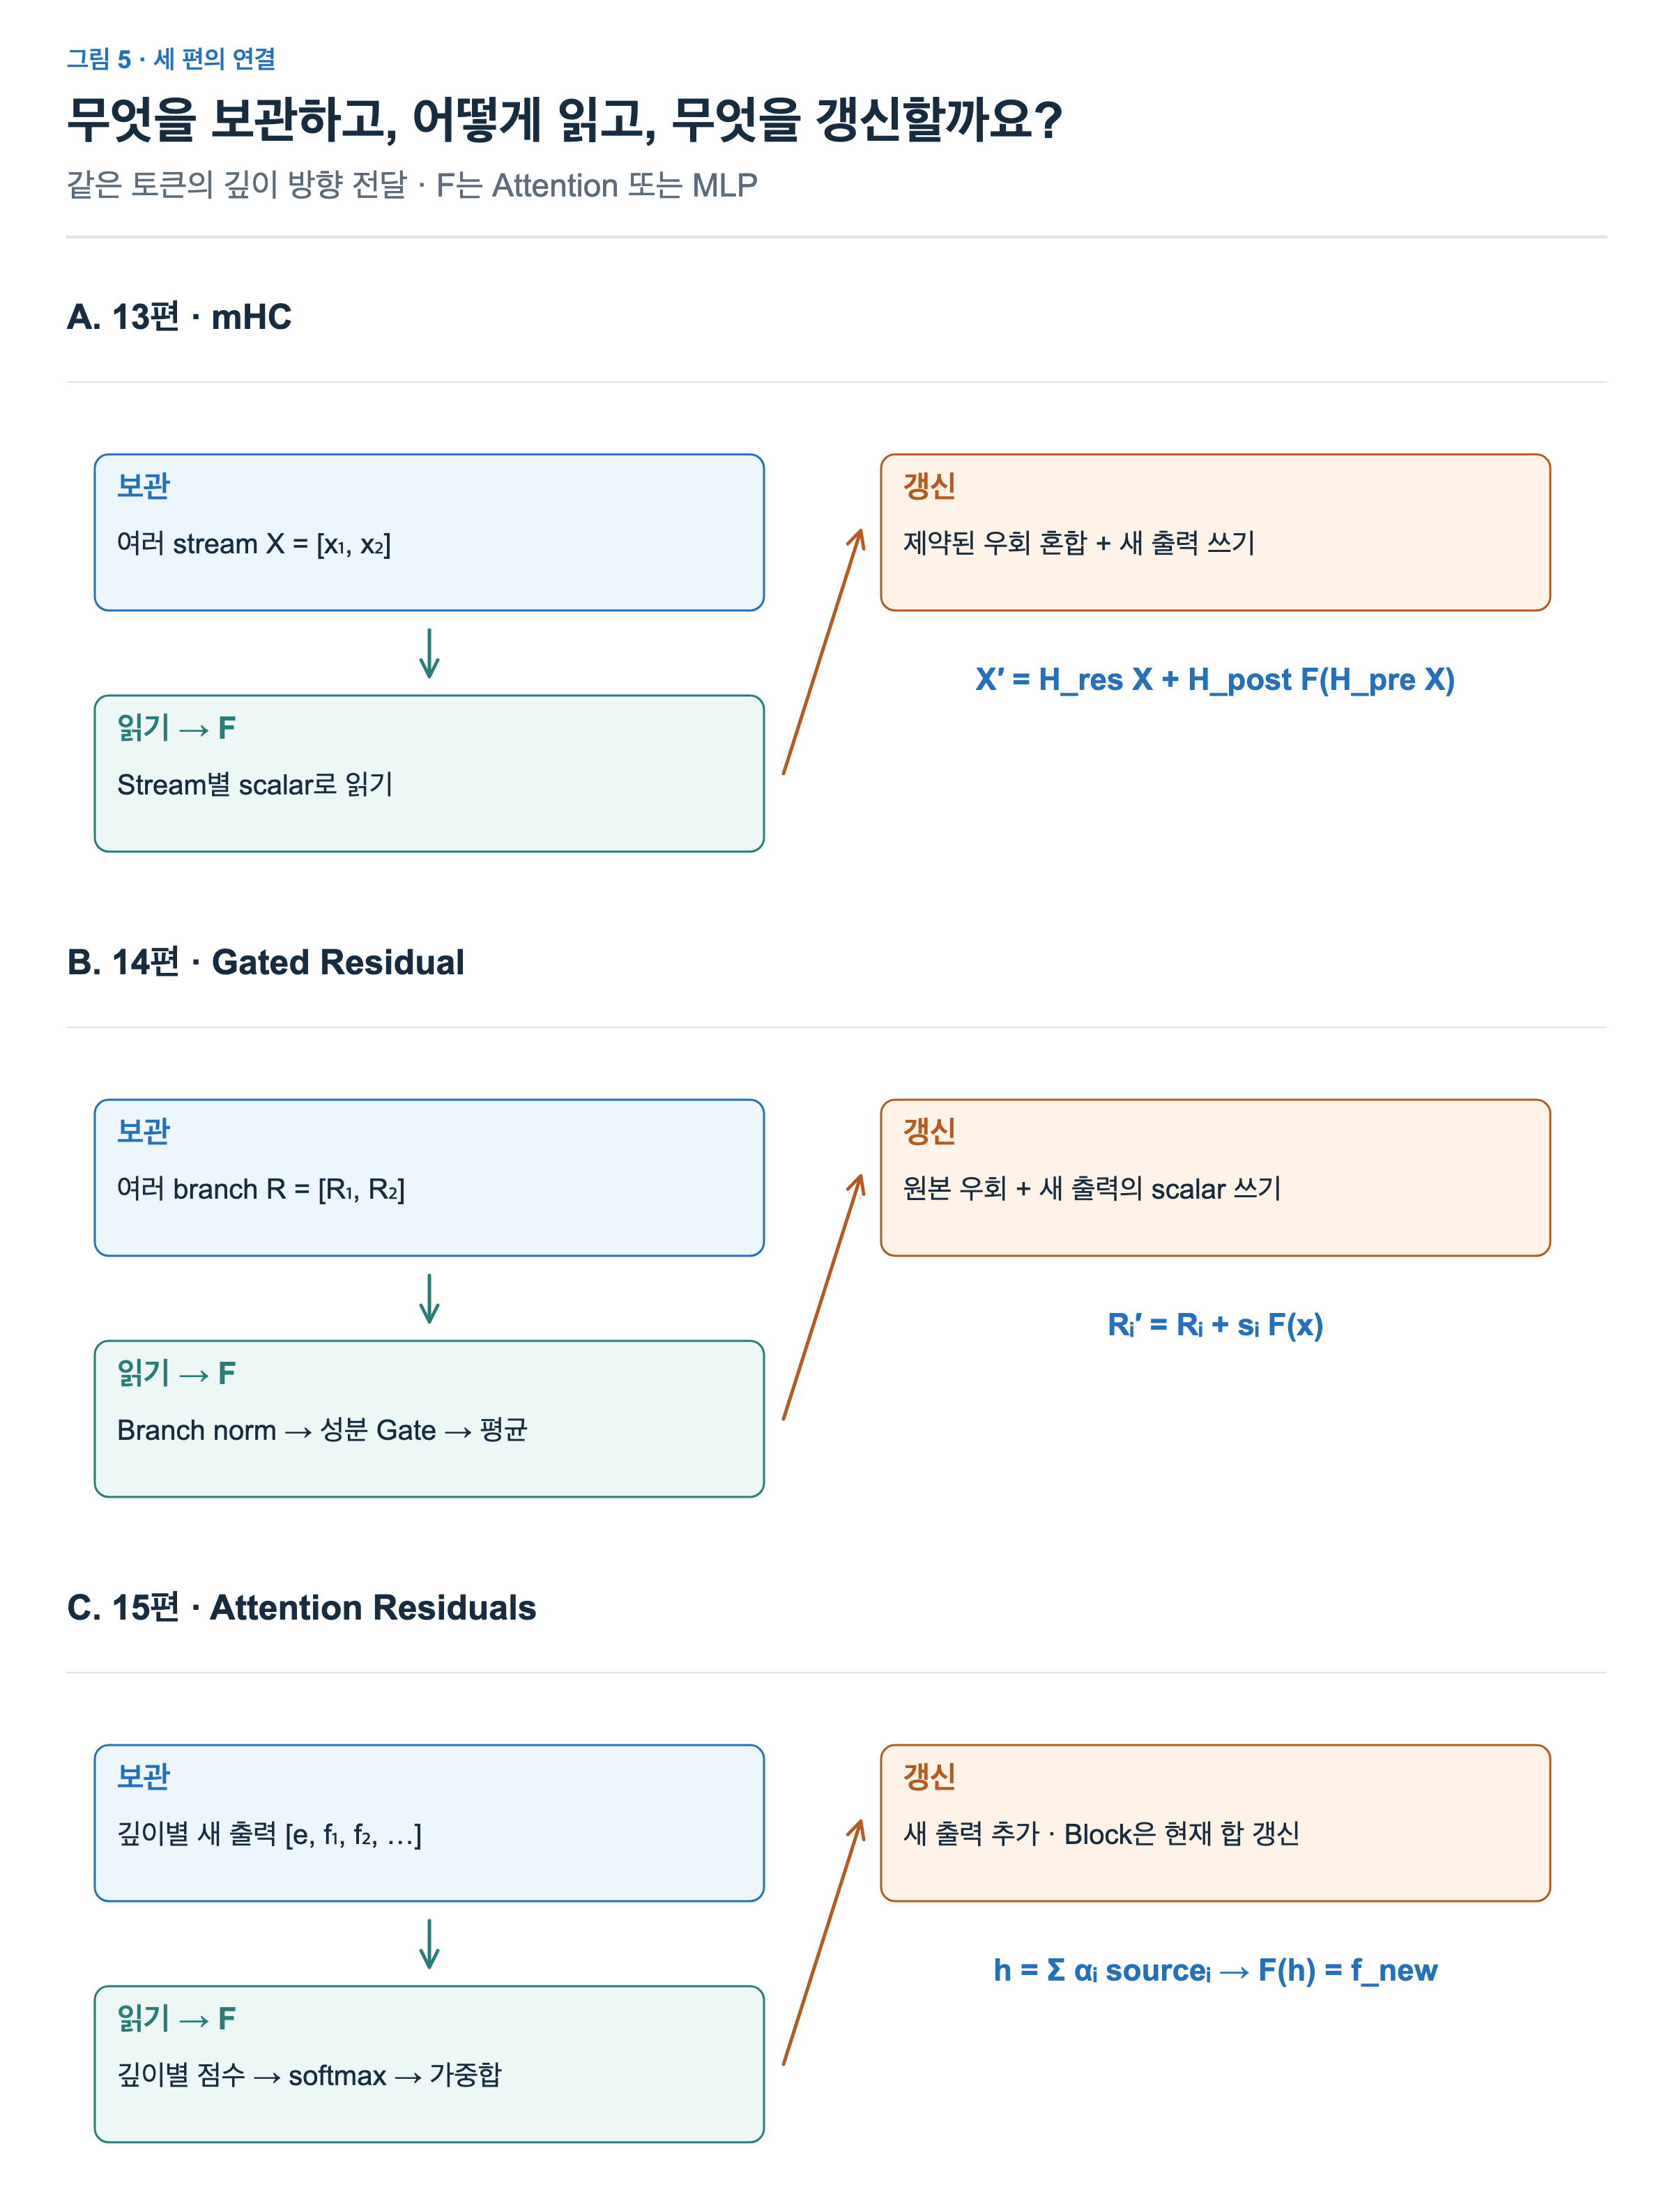
세 편의 공통 질문은 층 사이에서 정보를 어떻게 보관하고 다음 계산에 제공할 것인가였습니다. 그림 5는 보관·읽기·갱신을 같은 기준으로 놓고 차이를 정리합니다.
| 방식 | 보관하는 단위 | 다음 계산을 위한 읽기 | 새 결과를 반영하는 방식 |
|---|---|---|---|
| HC/mHC | 동시에 유지하는 여러 stream | Stream별 scalar로 모으기 | 우회 혼합 결과에 stream별 쓰기 기여 더하기 |
| 여기의 GR | 동시에 유지하는 여러 branch | Branch별 norm과 성분 gate 뒤 평균 | 각 원본에 새 출력의 scalar 배율 더하기 |
| Full AttnRes | 과거 sublayer의 개별 새 출력 | 깊이별 점수와 softmax 가중합 | 새 출력을 source 목록에 추가하기 |
| Block AttnRes | 깊이별 block 합과 현재 partial 합 | Block source 사이 가중합 | 현재 block 합에 새 출력 더하기 |
HC/mHC와 GR의 여러 stream은 특정 과거 층의 출력 하나를 그대로 보관하는 전용 칸이 아닙니다. 계속 읽고 갱신되는 표현입니다. 반면 Full AttnRes의 source는 어느 깊이에서 나온 새 출력인지가 구분됩니다. 그래서 두 접근을 단순히 “여러 벡터를 저장한다”로 묶으면 다음 층이 선택할 수 있는 대상의 차이를 놓칩니다.
이 변형들은 기본 residual이 모든 모델에서 실패하기 때문에 필요한 필수 교체품은 아닙니다. 연결을 풍부하게 하거나, 읽기와 쓰기를 조절하거나, 과거 결과를 더 직접 선택할 수 있게 하는 시도입니다. 표현의 자유도와 함께 저장·읽기 비용, 수치 안정성, 실제 구현의 부담도 달라집니다. 모델 구조를 읽을 때는 방법의 이름보다 무엇을 보관하며, 다음 계산이 무엇을 읽고, 어떤 값을 갱신하는지를 먼저 확인하면 세 계열을 구분할 수 있습니다.