공통 · 모델 · 2026-09-28
Gated Residual: 성분별로 읽고 원본에 나누어 쓰기
여러 branch를 유지하는 Gated Residual에서 정규화와 성분별 읽기 gate, branch별 scalar 쓰기를 구분하고 하나의 수치 예시로 연결합니다.
HC와 mHC에서는 같은 토큰의 표현을 여러 stream에 보관했습니다. 각 계산은 이 표현들을 읽어 하나의 입력을 만들고, 새 출력을 다시 stream들에 씁니다. mHC는 그와 별도로 기존 stream을 섞는 우회 경로에 제약을 두었습니다.
이번 글의 Gated Residual(GR)도 여러 표현을 유지합니다. 달라지는 부분은 벡터의 성분마다 읽는 양을 조절하고, 새 결과를 원본 표현에 더하는 방식입니다. Gate가 있다는 이유만으로 이전 표현을 일정 비율 지우는 구조라고 이해하면 읽기와 쓰기를 혼동하기 쉽습니다. 두 경로를 구분한 다음 하나의 수치 예시를 끝까지 따라가겠습니다.
여기서 GR은 Qwen3.8-Flash-Next 보고서 §2.2의 설계를 뜻합니다. 이름이 비슷한 모든 gated residual 변형을 하나의 규칙으로 묶지는 않겠습니다. 보고서의 구성은 4개 branch이며, 그림은 계산을 따라가기 쉽도록 2개로 줄였습니다. 이 글의 branch는 앞 글에서 여러 stream이라 부른, 같은 토큰의 표현을 이어 가는 경로입니다.
우회 경로와 읽기 경로
그림 1에서 mHC와 GR은 모두 여러 표현을 하나의 입력으로 모아 F에 넣고, F의 결과를 각 경로로 다시 보냅니다. F는 Attention 또는 MLP입니다. 먼저 원래 표현이 다음 표현으로 이어지는 우회선을 살펴보겠습니다.
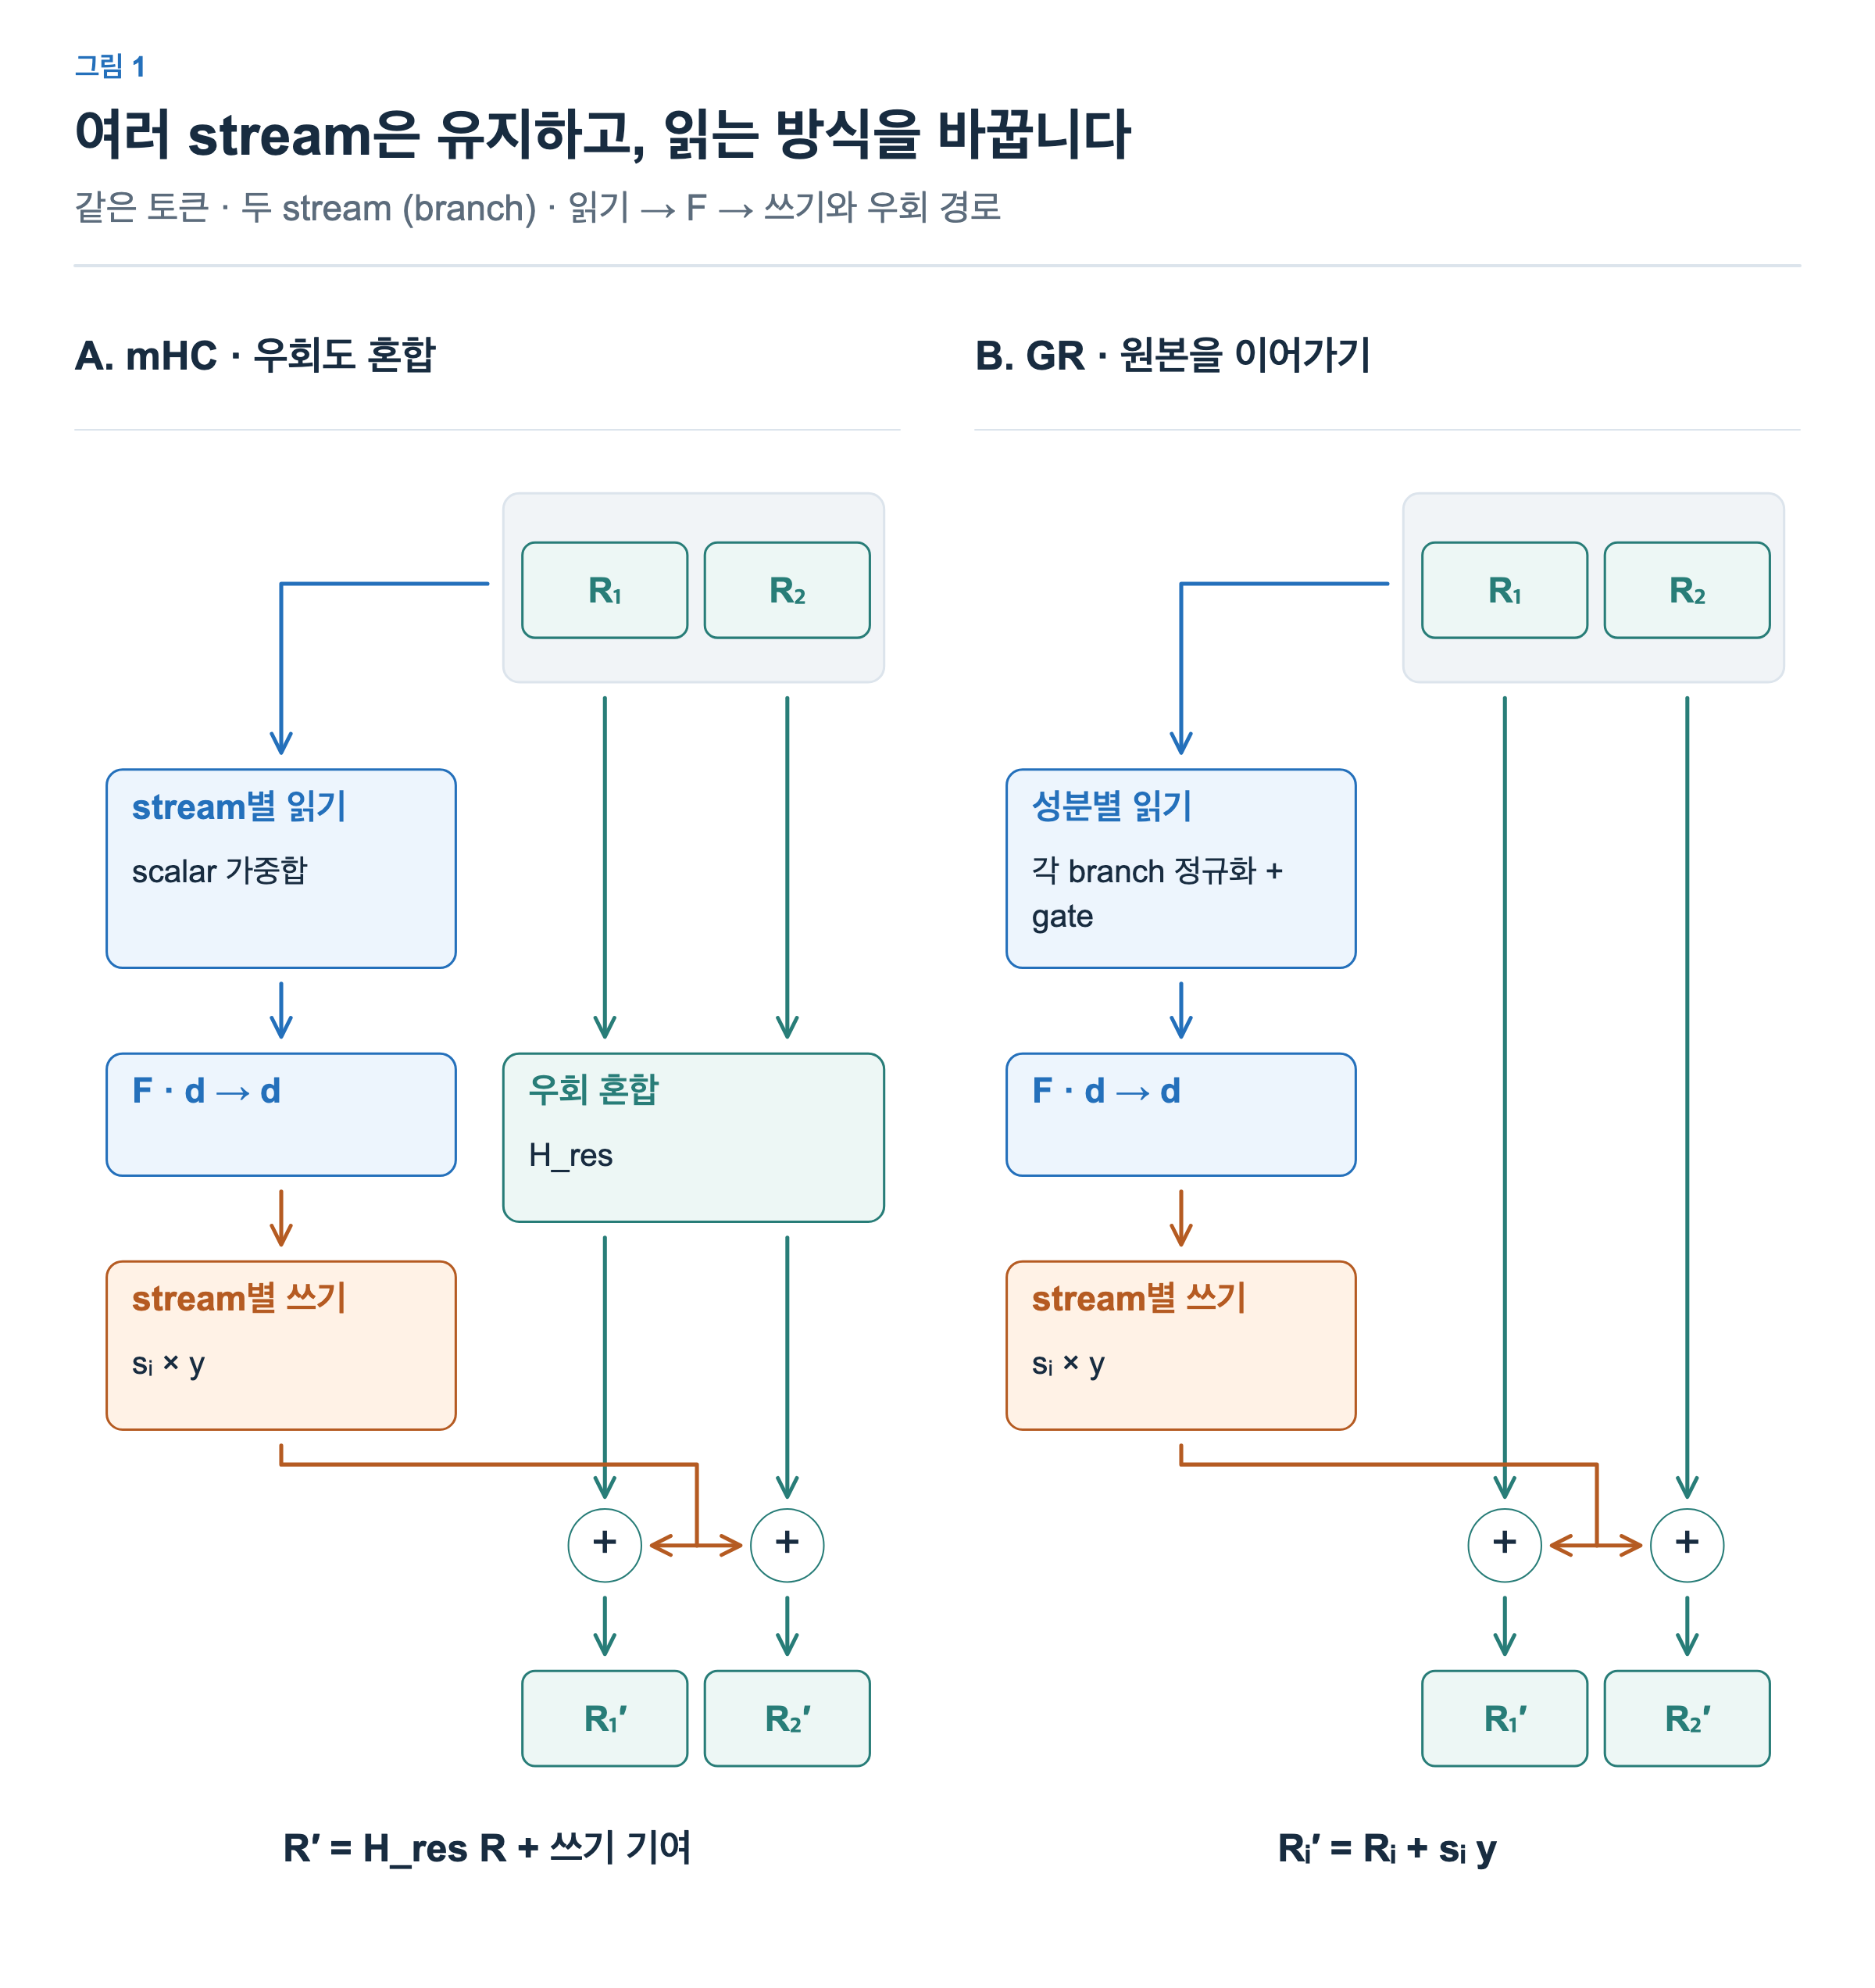
mHC에서는 우회 경로의 가 기존 stream들을 섞습니다. GR의 우회선은 각 원본 branch를 그대로 전달합니다. 새로 계산한 값은 그 원본에 더합니다. 따라서 여기의 GR에는 mHC의 우회 혼합 행렬에 대응하는 직접적인 branch 혼합이 없습니다.
그렇다고 branch들이 서로 독립적인 모델처럼 동작하지는 않습니다. 읽기 단계에서 여러 branch의 정보를 함께 사용하고, 하나의 F가 만든 결과를 여러 branch가 나눠 받습니다. 우회선을 직접 섞는 것과 읽기·계산을 통해 상호작용하는 것은 구별해야 합니다.
읽는 방법에도 차이가 있습니다. 앞 글의 mHC 읽기는 stream마다 하나의 scalar를 곱했습니다. GR은 branch를 정규화한 뒤 성분마다 다른 gate를 곱합니다. 같은 branch에서도 어떤 성분은 크게, 다른 성분은 작게 읽을 수 있는 것입니다.
각 branch를 정규화해 읽기
두 원본을 = [2, 2], = [4, −4]라고 하겠습니다. 그림 2는 정규화한 값이 두 곳에 쓰이는 모습을 보여 줍니다. 한 경로에서는 읽을 값으로 사용하고, 다른 경로에서는 읽기 gate를 계산하는 controller에 넣습니다.

먼저 각 branch에 RMSNorm을 따로 적용합니다. 계산을 단순하게 하기 위해 학습되는 gain은 1, 작은 안정화 상수 ε는 생략하겠습니다. [2, 2]의 RMS는 √((4 + 4) / 2) = 2이므로 나눈 결과는 [1, 1]입니다. [4, −4]의 RMS는 4이므로 [1, −1]이 됩니다. 정규화는 두 branch를 하나로 합치는 연산이 아닙니다.
그림에서 R 위의 모자는 정규화된 값을 뜻합니다. 이후 읽기에서는 이 값들을 쓰지만, 원본 [2, 2]와 [4, −4]는 앞 그림의 우회 경로로 계속 전달됩니다. 나중에 새 출력을 더할 대상도 원본입니다.
Controller는 모든 정규화 branch를 함께 보고 branch·성분별 gate를 만듭니다. 이는 입력마다 계수를 계산하는 학습된 변환이며, 추론 중 controller의 가중치를 다시 학습하는 과정은 아닙니다. 보고서 식 (31)의 내부 투영은 그림의 controller 상자에 접어 두었습니다.
이번 입력에서 gate가 = [0.8, 0.2], = [0.4, 0.6]으로 나왔다고 가정하겠습니다. 이 값은 설명을 위해 정한 출력 예시이며, 위의 두 원본만 알면 별도의 가중치 없이 계산할 수 있는 수가 아닙니다.
| Branch | 정규화한 값 | 성분별 gate | 성분끼리 곱한 값 |
|---|---|---|---|
| 첫 번째 | [1, 1] | [0.8, 0.2] | [0.8, 0.2] |
| 두 번째 | [1, −1] | [0.4, 0.6] | [0.4, −0.6] |
여기서 성분끼리 곱하는 연산을 그림의 ⊙로 표시했습니다. 첫 branch의 첫 성분은 0.8배, 둘째 성분은 0.2배가 됩니다. 하나의 scalar를 벡터 전체에 곱할 때보다 읽는 양을 더 세밀하게 조절할 수 있습니다.
다음으로 두 결과를 더하고 branch 수 2로 나눕니다.
이 x가 F에 들어갑니다. Branch 수가 n이면 같은 방식으로 각 branch의 gate 적용 결과를 합한 뒤 n으로 나눕니다. Gate의 합으로 나누는 것이 아닙니다. 예시에서도 첫 성분의 두 gate 합은 1.2, 둘째는 0.8이지만 두 성분 모두 branch 수 2로 나눕니다.
읽기 gate는 sigmoid로 만들며 softmax처럼 branch 사이 합을 1로 맞추지 않습니다. 따라서 여기의 gate를 “두 branch의 선택 확률”로 읽기보다는 정규화한 각 성분에 곱할 배율로 이해하는 편이 정확합니다. 그림의 작은 gate는 그 성분이 F의 입력에 덜 기여한다는 뜻이지, 원본에서 해당 성분을 삭제했다는 뜻이 아닙니다.
새 출력을 원본에 쓰기
읽은 값 x = [0.6, −0.2]를 F에 넣어 새 출력 y = [0.5, −0.25]가 나왔다고 가정하겠습니다. F 내부 계산은 이번 예시에서 다루지 않습니다. 이제 y를 각 원본에 얼마나 더할지 정합니다.
그림 3에서는 읽기 gate와 별도의 쓰기 controller가 branch마다 하나의 scalar를 만듭니다. 이 controller도 정규화한 모든 branch를 입력으로 받습니다.

보고서 식 (33)–(34)의 쓰기 계수는 sigmoid 결과에 2를 곱하므로 0과 2 사이입니다. 이번 예시에서는 = 1.2, = 0.4로 두겠습니다. 읽기에서는 성분마다 다른 gate를 썼지만, 쓰기에서는 branch 하나에 전달하는 y의 모든 성분에 같은 scalar가 곱해집니다.
첫 branch에 쓸 값은 1.2×[0.5, −0.25] = [0.6, −0.3]입니다. 둘째에 쓸 값은 0.4×[0.5, −0.25] = [0.2, −0.1]입니다. 원본을 여기에 더하면 다음과 같습니다.
| Branch | 보존된 원본 | 새 출력에 배율을 곱한 값 | 다음 branch |
|---|---|---|---|
| 첫 번째 | [2, 2] | [0.6, −0.3] | [2.6, 1.7] |
| 두 번째 | [4, −4] | [0.2, −0.1] | [4.2, −4.1] |
를 i번째 원본, 를 그 branch의 쓰기 배율로 두면 갱신은 다음 한 줄로 표현할 수 있습니다.
배율이 곱해지는 대상은 새 출력 y입니다. 원본 앞에는 그 배율이 붙지 않습니다. 따라서 가 작으면 원본을 조금 남기는 것이 아니라, 원본에 더할 새 기여가 작아집니다. 경계의 극한으로 배율이 0에 가까워지면 해당 branch는 원본에 가까운 값을 다음으로 넘깁니다.
배율이 양수라고 branch의 모든 성분이 커지는 것도 아닙니다. 예시의 첫 branch 둘째 성분은 음수 기여 −0.3을 더해 2에서 1.7로 줄었습니다. 계수의 부호와 벡터 각 성분의 부호를 함께 보아야 합니다.
유지율과 구별하기
GDN과 KDA에서는 토큰이 들어올 때 기존 상태에 유지율을 곱했습니다. 이전 상태 자체를 얼마나 남길지를 정하는 연산입니다. 이번 GR의 우회 경로에는 그런 감쇠가 없습니다.
| 조절 대상 | 배율을 곱하는 위치 | 직접 달라지는 것 |
|---|---|---|
| 상태의 유지율 | 이전 상태 | 다음 시점에 남길 기존 상태 |
| GR의 읽기 gate | 정규화된 branch의 각 성분 | 이번 F에 들어갈 입력 |
| GR의 쓰기 scalar | F의 새 출력 | 원본 branch에 더할 새 기여 |
또한 앞선 상태 갱신은 문맥의 토큰 순서를 따라 진행됐고, 여기의 residual 전달은 모델의 깊이를 따라 진행됩니다. 같은 “gate”라는 단어를 써도 조절하는 값과 축이 다릅니다.
세밀한 읽기의 비용과 의미
GR은 여러 표현을 유지하는 용량과, 그중 무엇을 읽을지 정하는 유연성을 함께 사용합니다. 하나의 branch 안에서도 성분마다 배율을 달리할 수 있고, 원본 우회는 그대로 이어집니다. 그래서 “이전 층의 정보를 얼마나 전달하는가”만으로 요약하기보다는 이번 계산에 무엇을 읽고, 계산 결과를 얼마나 쓸 것인가로 나누어 보는 편이 좋습니다.
여러 branch를 유지하므로 저장과 메모리 접근 비용은 남습니다. Branch별 정규화와 gate를 만드는 controller에도 연산이 필요합니다. 우회 혼합 행렬을 없앴다는 이유만으로 모든 환경에서 mHC보다 빠르다고 결론낼 수는 없습니다. 실행 비용은 branch 수, 차원, 연산을 묶는 커널 구성과 학습·추론 단계에 따라 확인해야 합니다.
보고서의 안정성 논의는 별도의 비교 실험 §3.3에 근거합니다. 이번 수치 예시에서 gate가 값을 줄였다는 사실만으로 전체 모델의 학습 안정성을 증명한 것은 아닙니다. 구조를 이해하는 계산과 실제 학습 결과는 구별해야 합니다.
다음 글의 Attention Residuals에서는 보관 방식이 바뀝니다. 몇 개의 branch를 계속 갱신하는 대신, 지나온 층이 만든 새 출력들을 보관하고 다음 층이 그중 무엇을 얼마나 읽을지 계산합니다.