공통 · 모델 · 2026-09-28
GDN과 KDA: 기존 상태의 유지와 델타 보정
기존 상태를 남기는 유지율과 새 Value에 맞추는 보정 강도를 구분하고, GDN의 상태 갱신에서 KDA의 성분별 유지율과 입력에 따른 조절값 계산까지 살펴봅니다.
앞선 글에서는 현재 Key로 상태를 읽고, 그 값이 새 Value에 가까워지도록 차이를 반영하는 델타 규칙을 살펴봤습니다. 이번에는 여기에 기존 상태를 얼마나 남길 것인가라는 조절을 더하겠습니다. 새 내용을 기록하는 것뿐 아니라, 이전에 쌓인 내용의 영향을 줄이는 방법도 필요한 이유부터 생각해 보겠습니다.
Gated DeltaNet(GDN)은 기존 상태에 유지율을 적용한 뒤 델타 규칙으로 보정합니다. Kimi Delta Attention(KDA)은 그 유지율을 상태의 성분마다 다르게 적용합니다. 두 방식의 차이를 작은 행렬로 확인하고, 마지막에는 유지율과 보정 강도를 모델이 현재 입력에서 어떻게 계산하는지 연결하겠습니다.
기존 상태를 줄이는 조절이 필요한 이유
델타 규칙의 목적은 이번 Key로 읽히는 값을 새 Value에 가깝게 바꾸는 것입니다. 앞선 예시에서 Key가 [1, 0]이면 상태의 첫 행을 읽고, 보정할 때도 첫 행에만 차이를 더했습니다. 둘째 행은 그대로 남았습니다.
그런데 문맥이 달라지면 이번 Key에 연결할 내용뿐 아니라, 기존 상태에 남아 있는 다른 정보의 영향도 줄이고 싶을 수 있습니다. 델타 규칙의 β를 줄이는 것만으로는 이 목적을 달성할 수 없습니다. β는 이번 차이를 얼마나 반영할지 정하므로, β=0이면 상태를 고치지 않을 뿐 기존 내용이 줄어들지는 않습니다.
GDN은 이를 위해 기존 상태에 유지율 α를 곱합니다. α가 1에 가까우면 기존 상태를 많이 남기고, 0에 가까우면 크게 줄입니다. 기존 상태를 남기는 조절과 새 Value에 맞춰 고치는 조절을 함께 사용하는 것입니다. Gated DeltaNet 논문 §3.1은 상태의 감쇠와 델타 보정을 결합해 이 두 역할을 수행합니다.
그림 1은 같은 상태에서 시작해 같은 Key [1, 0]과 새 Value [1, 1]을 기록하는 두 경우입니다. 양쪽 모두 β=1로 보정합니다. 오른쪽에만 기존 상태를 절반 남기는 단계를 추가했습니다.

왼쪽은 델타 규칙만 적용하므로 첫 행 [2, 0]이 [1, 1]로 바뀌고, 둘째 행 [0, 3]은 유지됩니다. 오른쪽은 먼저 상태 전체에 0.5를 곱한 뒤 보정하므로, 첫 행은 똑같이 [1, 1]이 되지만 둘째 행은 [0, 1.5]로 줄어듭니다. 이번 Key에 대한 보정이 건드리지 않는 부분도 유지율을 통해 줄일 수 있습니다.
이 예시가 둘째 행의 정보는 불필요하다는 뜻은 아닙니다. 필요한 정보를 줄이면 이후 읽기에 손해가 될 수도 있습니다. 여기서 보여 주는 것은 기존 정보의 영향을 줄이는 별도의 수단이 생겼다는 점입니다. 또한 일반적인 Key는 여러 행을 함께 읽고 수정합니다. 첫 행만 바뀌는 것은 Key를 [1, 0]으로 정한 이 예시의 조건입니다.
남긴 상태를 기준으로 델타 보정하기
GDN의 순서는 기존 상태에 유지율 적용 → 남긴 상태를 Key로 읽기 → 새 Value와의 차이 계산 → β만큼 보정입니다. 차이를 계산할 때 읽는 대상이 유지율을 적용한 뒤의 상태라는 점이 중요합니다.
그림 2에서는 앞선 글과 동일하게 두 토큰까지 반영한 상태 에서 현재 토큰 를 처리해 를 만듭니다. 행은 Key 성분, 열은 Value 성분입니다. α=0.5, β=1을 사용하며, 유지율을 적용한 중간 상태는 로 표시하겠습니다.

기존 상태의 첫 행 [2, 0]과 둘째 행 [0, 3]에 α=0.5를 곱하면 각각 [1, 0], [0, 1.5]가 됩니다. 현재 Key [1, 0]으로 이 상태를 읽으면 첫 행인 [1, 0]이 나옵니다.
새 Value는 [1, 1]이므로 필요한 차이는 [1, 1] − [1, 0] = [0, 1]입니다. 같은 Key와 이 차이를 외적하면 첫 행에 [0, 1], 둘째 행에 [0, 0]을 더하는 보정량이 됩니다. β=1이므로 이를 전부 반영해 최종 상태의 첫 행은 [1, 1], 둘째 행은 [0, 1.5]가 됩니다.
만약 유지율을 적용하기 전의 [2, 0]을 읽어 차이를 구하면 [−1, 1]이 됩니다. 이것을 이미 줄인 첫 행 [1, 0]에 더하면 [0, 1]이 되어, 이번에 기록하려던 [1, 1]과 달라집니다. 보정할 기준 상태가 바뀌었으므로, 그 상태에서 읽히는 값과 새 Value를 비교해야 합니다.
앞선 글의 표기대로 현재 토큰을 기록하기 전 상태를 라고 하면 다음과 같이 정리할 수 있습니다. rᵀ는 남긴 상태에서 읽은 값이고, eᵀ는 새 Value와의 차이입니다.
α와 β는 다른 부분에 작용합니다. α는 보정에 앞서 기존 상태에 곱하고, β는 새 Value와 읽은 값의 차이를 기록하는 보정량에 곱합니다. 예를 들어 α=0.5, β=0이면 델타 보정은 하지 않아도 기존 상태는 절반으로 줄어 있습니다. α=1이면 기존 상태를 그대로 두고 델타 규칙만 적용합니다. 0과 1은 두 조절의 역할을 구별하기 위한 경계값입니다.
이 예시에서 β=1로 보정한 뒤 같은 Key로 읽으면 새 Value가 정확히 나오는 것은 Key [1, 0]의 길이가 1이기 때문입니다. 그리고 실제 출력은 여전히 현재 Query로 갱신된 상태를 읽어서 만듭니다. 그 출력이 새 Value와 같아야 하는 것은 아닙니다.
성분별로 유지율을 나누는 KDA
GDN에서는 한 헤드의 상태 전체에 같은 α를 곱합니다. 예를 들어 α=0.5라면 모든 행이 절반으로 줄어듭니다. 하지만 어떤 성분은 많이 남기면서 다른 성분은 더 크게 줄이고 싶을 수도 있습니다. 유지율 하나로는 이 차이를 표현할 수 없습니다.
KDA는 유지율을 Key 성분별로 계산합니다. 이 글처럼 상태의 행이 Key 성분인 표기에서는 각 행에 서로 다른 유지율을 곱하는 것으로 볼 수 있습니다. Kimi Linear 논문 §3은 GDN의 스칼라 감쇠를 성분별 감쇠로 확장합니다.

그림 3의 왼쪽은 GDN입니다. 두 행 모두 0.5를 곱해 [1, 0]과 [0, 1.5]를 만듭니다. 오른쪽은 KDA입니다. 첫 행에는 0.9를 곱해 [1.8, 0]을 남기고, 둘째 행에는 0.2를 곱해 [0, 0.6]을 남깁니다. 앞의 성분을 더 많이 유지하면서 뒤의 성분은 더 크게 줄일 수 있습니다.
여기까지는 유지율만 적용한 보정 전 상태입니다. KDA도 그다음에는 현재 Key로 이 상태를 읽고, 새 Value와의 차이를 β만큼 반영합니다. 델타 규칙이 없어지는 것이 아니라, 보정 전에 기존 상태를 남기는 방법이 더 세밀해집니다.
행 하나를 과거 토큰 하나나 독립된 기억 하나로 생각하면 안 됩니다. 각 행에는 여러 토큰의 기여가 섞여 있습니다. 따라서 성분별 유지율은 특정 토큰만 골라 지우는 기능이 아니며, 줄인 성분을 읽는 여러 Query에 영향을 줄 수 있습니다. β를 통한 보정도 다른 조회에 영향을 줄 수 있다는 앞선 글의 설명이 그대로 적용됩니다.
유지율과 보정 강도도 입력에서 계산하기
지금까지 α=0.5, β=1처럼 값을 정해서 계산했습니다. 실제 모델에서는 매번 사람이 이 값을 고르지 않습니다. 현재 토큰의 벡터를 학습한 가중치로 투영하고 변환하여, 이번에 사용할 α와 β를 계산합니다.
Q·K·V를 만드는 과정과 같은 관점으로 이해할 수 있습니다. Query를 만드는 가중치는 학습되지만, Query 자체는 현재 입력에서 계산됩니다. 마찬가지로 α·β를 만드는 가중치가 학습 대상이고, α·β는 그 가중치와 현재 입력으로부터 나오는 값입니다.
그림 4의 왼쪽은 이 조절값을 만드는 과정이고, 오른쪽은 만들어진 값이 사용되는 위치입니다. 왼쪽 블록은 위치 번호 2나 토큰 ID가 아니라, 그 위치의 토큰이 현재 층에 들어올 때 가진 벡터 전체를 나타냅니다.
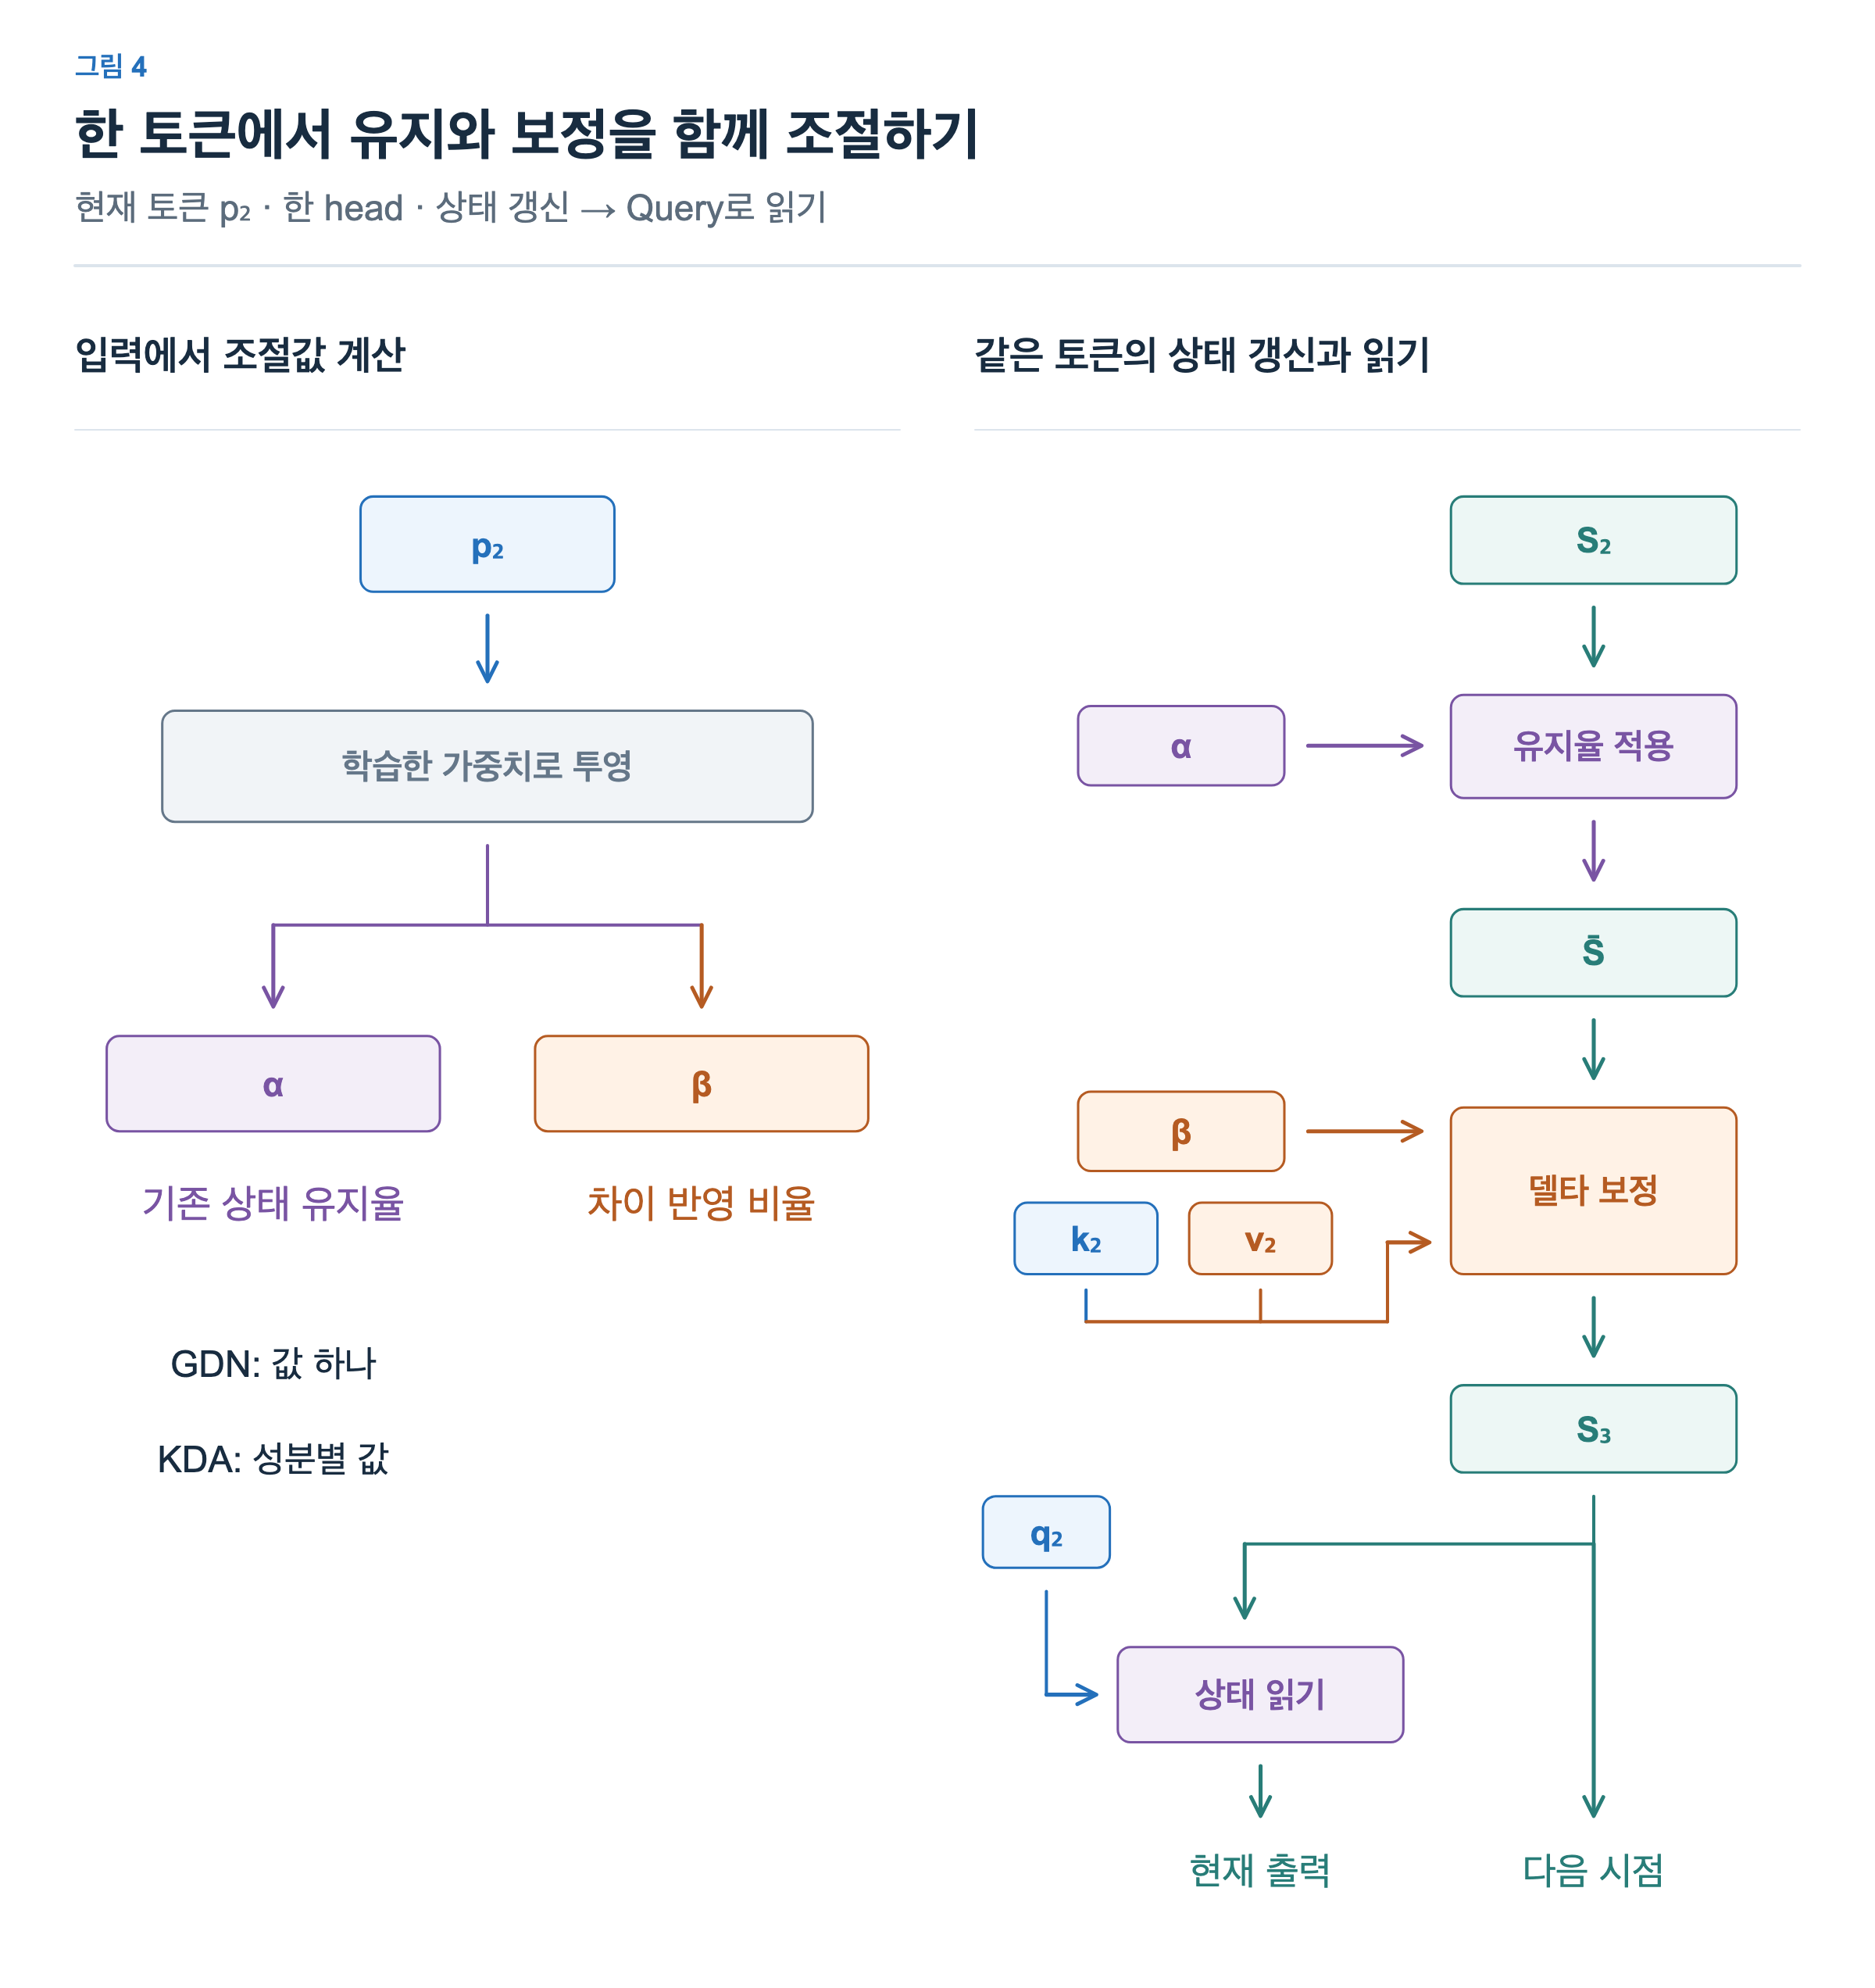
그림에서는 “학습한 가중치로 투영”으로 간략히 표시했지만, 투영 결과를 유지율이나 보정 비율로 사용하려면 값의 범위를 조절하는 변환도 적용합니다. 예를 들어 Kimi Linear 논문 §4에서 β는 현재 입력을 가중치로 투영한 값에 sigmoid를 적용해 계산합니다. α는 두 단계의 투영과 감쇠 함수를 거쳐 Key 성분별 값으로 만듭니다.
| 구분 | 학습하는 동안 | 추론하는 동안 |
|---|---|---|
| α·β를 만드는 가중치 | 모델의 다른 가중치와 함께 학습 | 학습된 값 사용 |
| 이번 토큰의 α·β | 현재 입력에서 계산 | 현재 입력에서 계산 |
따라서 학습이 끝나 가중치가 고정되어도 입력이 달라지면 α와 β는 달라질 수 있습니다. GDN의 α는 토큰마다, 헤드마다 계산되는 값 하나이고, KDA의 α는 한 헤드 안에서도 Key 성분별로 나뉜 벡터입니다. β는 두 방식 모두 한 헤드에서 이번 보정의 강도를 정하는 스칼라입니다.
오른쪽 흐름에서는 먼저 α로 기존 상태를 남기고, 현재 Key·Value와 β로 델타 보정을 수행합니다. 갱신된 는 다음 토큰을 처리할 때의 상태로 이어집니다. 동시에 현재 Query가 이 상태를 읽어 현재 출력에 사용할 값을 만듭니다. 유지, 보정, 읽기가 서로 다른 토큰에 나누어 배정되는 것이 아니라 현재 토큰 하나를 처리하는 과정에 함께 들어 있습니다.
이렇게 상태의 크기를 늘리지 않으면서도 기존 정보를 남기는 정도와 새 내용을 반영하는 정도를 입력에 맞게 조절할 수 있습니다. 다만 여러 토큰의 정보를 같은 상태에 기록하는 구조는 유지됩니다. 유지율을 세밀하게 나눈다고 해서 과거 KV를 각각 저장해 원하는 토큰을 직접 읽을 수 있게 되는 것은 아닙니다.