공통 · 모델 · 2026-09-28
SSM: 이전 상태와 새 입력으로 문맥을 이어가기
Linear Attention과 상태 갱신 구조를 비교하고, SSM의 유지·기록·읽기 연산과 과거 입력의 영향이 남는 과정을 작은 수치 예시로 살펴봅니다.
앞선 글까지 살펴본 Linear Attention 계열은 과거 정보를 고정 크기 상태에 기록하고, 현재 Query로 그 상태를 읽었습니다. SSM(State Space Model, 상태 공간 모델)도 과거 정보를 상태에 담아 다음 입력으로 이어갑니다. 그렇다면 이미 배운 방식과 무엇이 다를까요?
이번 글에서는 상태를 유지하고, 새 정보를 기록하고, 출력을 읽는 연산을 기준으로 두 방식을 연결하겠습니다. 먼저 고정 계수 SSM의 기본 구조를 살펴보고, 작은 상태 벡터를 계산하며 과거 입력의 영향이 어떻게 남는지 확인하겠습니다. 다음 글의 Mamba는 이 구조에서 사용하는 계수를 현재 입력에 따라 바꿉니다.
Linear Attention에서 SSM으로
기본 Linear Attention은 Key와 Value의 외적을 상태에 더했습니다. Query로 상태를 읽으면, Query와 각 Key의 유사도에 따라 과거 Value들의 기여가 섞여 나왔습니다. 이 설명에서 상태는 여러 Key–Value 연결을 함께 담은 기억이었습니다.
SSM은 다른 출발점에서 같은 상태 기반 구조에 도달합니다. 과거의 영향을 현재 상태에 담고, 그 상태가 새 입력을 받으며 어떻게 변하는지 모델링하는 것입니다.
주변 온도보다 뜨거운 물체에 히터로 열을 공급하는 상황을 생각해 보겠습니다. 주변 온도와의 차이를 상태로 잡으면, 기존에 남은 열의 영향은 시간이 지나며 줄어들고 히터가 공급하는 열의 영향은 더해집니다. 다음 상태를 ‘기존 상태가 변한 결과 + 새 입력이 더한 영향’으로 설명할 수 있습니다.
이번에 다루는 선형 SSM은 이 두 영향을 행렬 곱과 덧셈으로 표현하는 모델을 선택합니다. 모든 시스템이 반드시 이 규칙을 따른다는 뜻은 아닙니다. 언어 모델에서는 상태가 실제 온도 같은 물리량일 필요도 없습니다. 다음 토큰 예측에 유용한 과거 정보를 담도록 가중치를 학습합니다.
SSM도 이전 상태에 새 정보의 기여를 더하고, 갱신한 상태에서 출력을 읽습니다. 다만 이번에 살펴볼 고정 계수 SSM은 세 가지 연산으로 이 과정을 정합니다. 는 이전 상태를 변화시키고, 는 현재 입력을 상태에 기록할 값으로 바꾸며, C는 상태에서 출력을 읽습니다. 그림 1은 두 방식을 같은 순서에 놓은 것입니다.
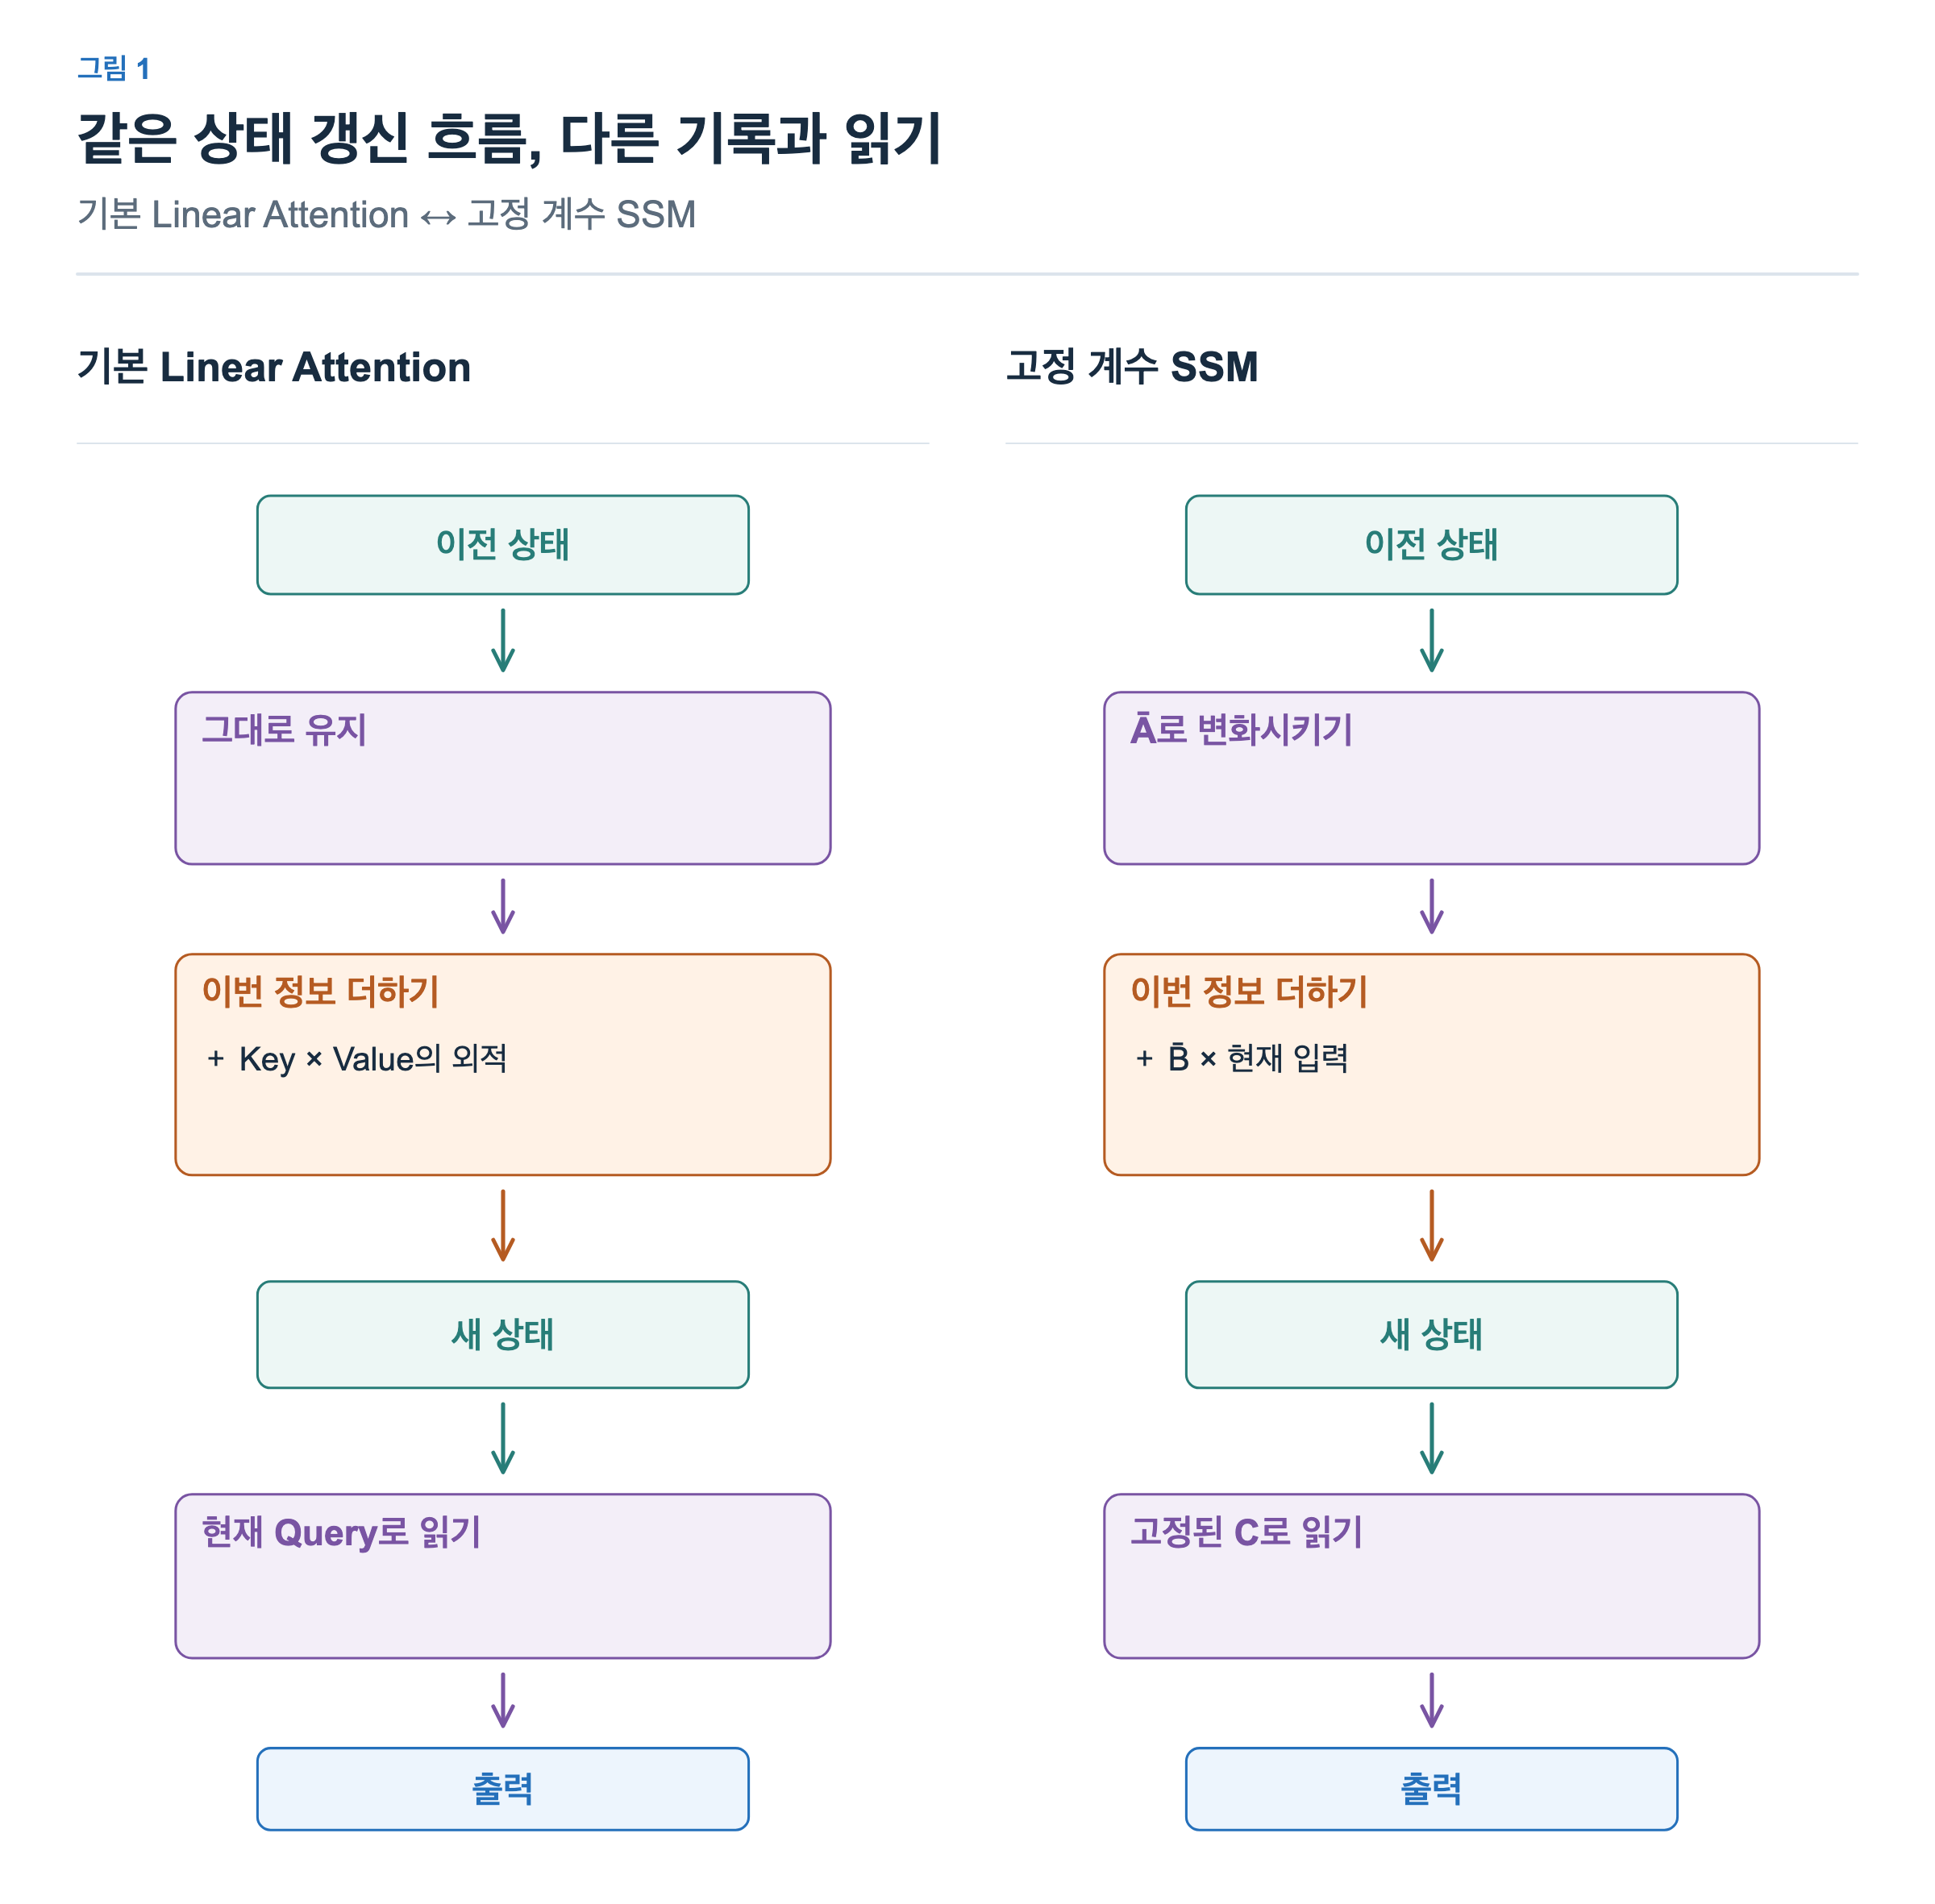
기본 Linear Attention은 이전 상태를 그대로 두고 새 Key–Value 기여를 더합니다. 반면 SSM에서는 새 정보를 더하기 전에 가 이전 상태에 작용합니다. 를 어떻게 정하느냐에 따라 이전 상태의 성분을 줄이거나 서로 섞을 수 있습니다. 이 글의 작은 예시에서는 각 성분에 서로 다른 계수를 곱하는 경우를 사용하겠습니다.
기록과 읽기에도 차이가 있습니다. Linear Attention에서는 현재 입력에서 만든 Key·Value로 기록하고 Query로 읽습니다. 여기서 다루는 고정 계수 SSM은 현재 입력을 로 변환해 기록하고, C로 읽습니다. 와 C는 추론 중 입력이 바뀌어도 같은 값을 사용합니다. 그림에서는 갱신 구조에 집중하기 위해 Linear Attention의 분모 정규화와 SSM의 입력을 출력에 직접 더하는 항을 생략했습니다. Linear Attention 논문, Mamba 논문 §2
이전 상태를 줄이는 동작 자체는 이미 GDN·KDA에서도 배웠습니다. 따라서 SSM을 이해할 때 기억의 감쇠가 처음 등장한 것처럼 생각할 필요는 없습니다. 같은 상태 기반 계산을 어떤 갱신 규칙으로 구성했는지에 집중하면 됩니다.
그림 1에서 양쪽을 같은 ‘상태’ 블록으로 표시한 것은 이 공통 구조를 비교하기 위해서입니다. 이후 SSM을 작은 벡터로 그리는 것은 한 채널만 확대해서 보기 위한 선택입니다. Linear Attention은 행렬, SSM은 벡터라는 모양의 차이가 두 방식의 본질적인 구분은 아닙니다.
이전 상태와 새 입력을 합치는 방법
한 층에서 입력의 한 채널을 처리한다고 생각해 보겠습니다. 이번 채널의 입력값을 u, 과거 입력의 영향을 담은 상태를 h라고 부르겠습니다. u는 토큰 ID나 위치 번호가 아니라, 토큰을 나타내는 특징 벡터의 한 성분입니다. 상태 h에는 두 성분을 두겠습니다. 입력 한 성분을 처리하기 위해 기억 공간 두 성분을 사용하는 예시입니다.
이전 상태가 [2, 1]이고 현재 입력 u가 2라고 하겠습니다. 이전 상태의 첫 성분에는 0.5, 둘째 성분에는 0.8을 곱해 남깁니다. 입력은 첫 상태 성분에 1배, 둘째 성분에 0.5배를 기록합니다. 마지막에는 상태의 두 성분을 더해 출력을 읽겠습니다.
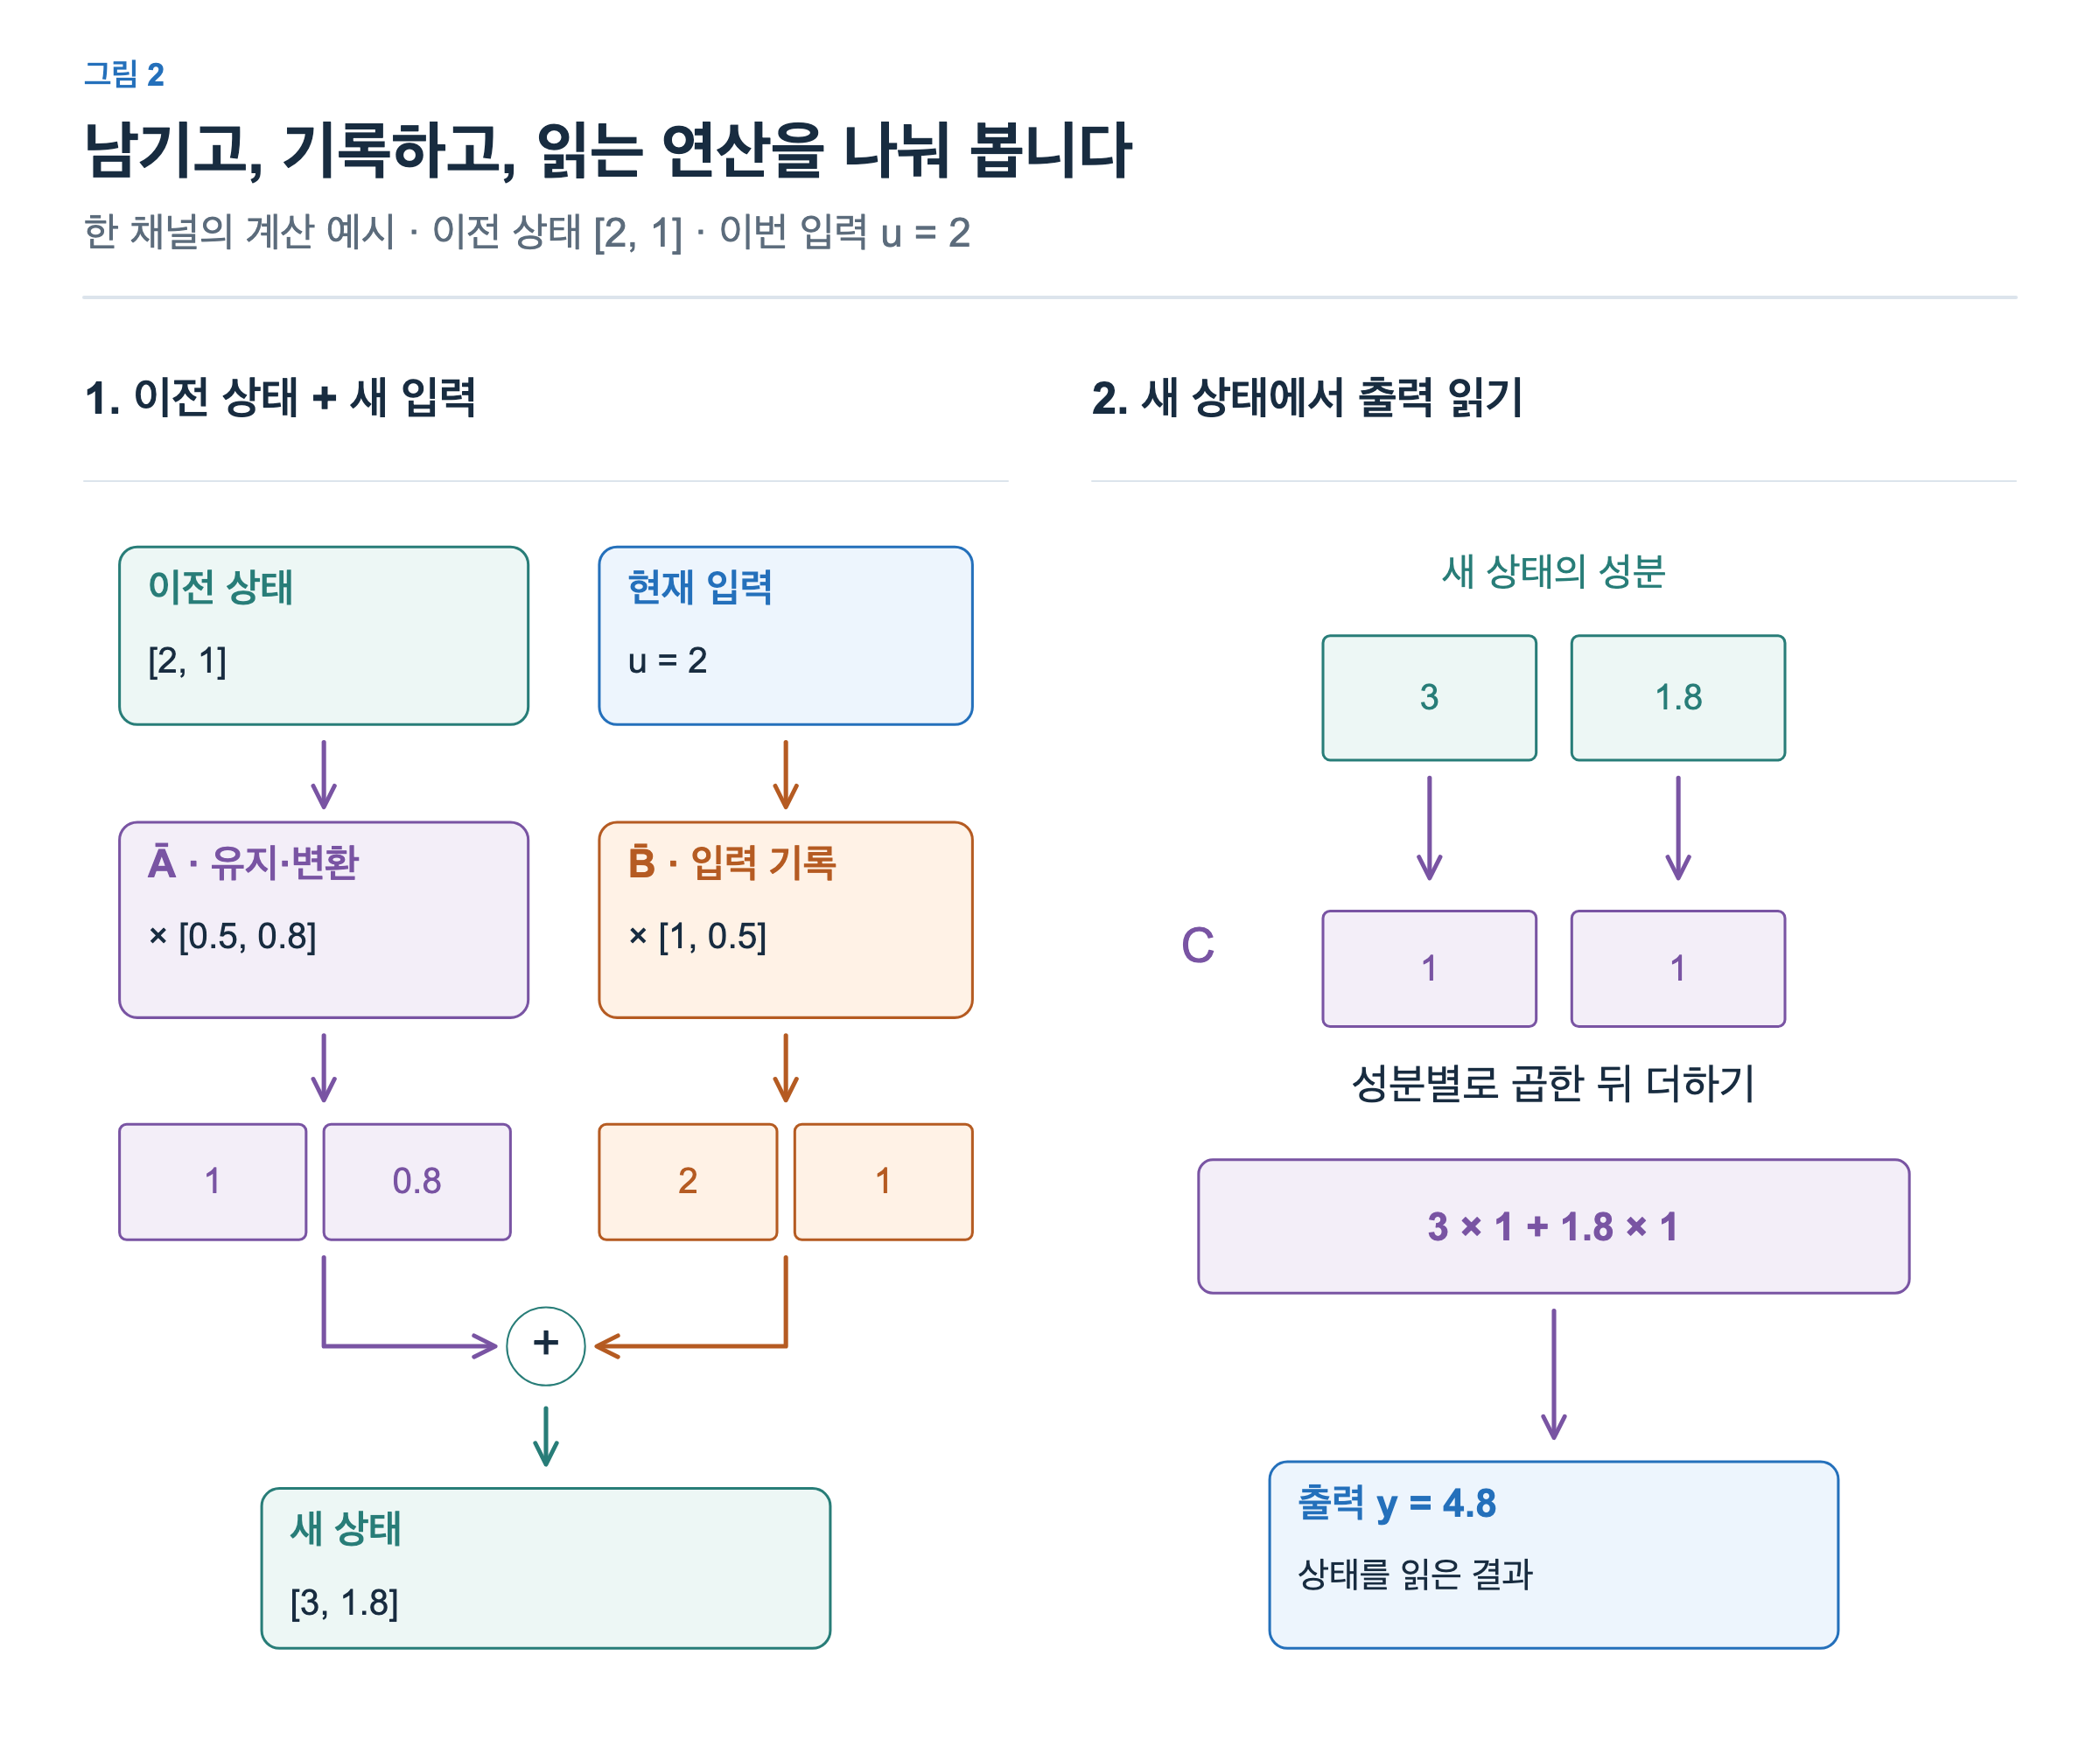
먼저 를 적용합니다. 이전 상태 [2, 1]의 각 성분에 0.5와 0.8을 곱하면 [1, 0.8]이 됩니다. 이것이 이번 단계에 남길 과거의 기여입니다. 이 예시의 는 대각선에 0.5와 0.8이 있고 나머지는 0인 2×2 행렬입니다. 그림의 ‘× [0.5, 0.8]’은 이 대각 행렬이 각 성분에 작용하는 모습을 간단하게 표시한 것입니다.
다음으로 를 적용합니다. 는 두 성분이 1과 0.5인 열벡터이므로, 스칼라 입력 2를 곱하면 [2, 1]이 됩니다. 현재 입력 하나가 상태의 여러 성분에 서로 다른 크기로 기록됩니다. 이를 남겨 둔 [1, 0.8]과 더하면 새 상태는 [3, 1.8]입니다.
이제 C로 읽습니다. C를 [1, 1]로 정했으므로, 새 상태의 각 성분에 1을 곱해 더한 3 + 1.8 = 4.8이 출력입니다. C가 [1, 0]이었다면 첫 성분인 3만 읽었을 것입니다. 상태를 만드는 연산과 그 상태에서 무엇을 출력으로 꺼낼지 정하는 연산을 분리한 것입니다.
같은 입력이 서로 다른 속도로 남는 이유
새 입력의 영향이 얼마나 오래 남는지 보려면, 한 번만 입력을 넣은 뒤 이후 입력을 0으로 두면 됩니다. 새로 더해지는 기여가 없으므로 이전 상태가 변하는 과정만 관찰할 수 있습니다.
초기 상태를 [0, 0]으로 두고 위치 p₀에서 입력 2를 넣겠습니다. 앞 절의 를 사용하면 첫 상태 h₁은 [2, 1]입니다. 이후 위치 p₁과 p₂의 입력은 모두 0으로 두고, 같은 를 반복 적용합니다. 그림 3의 각 막대는 토큰 하나가 아니라 동일한 상태 벡터의 한 성분이 시간에 따라 변하는 모습입니다.
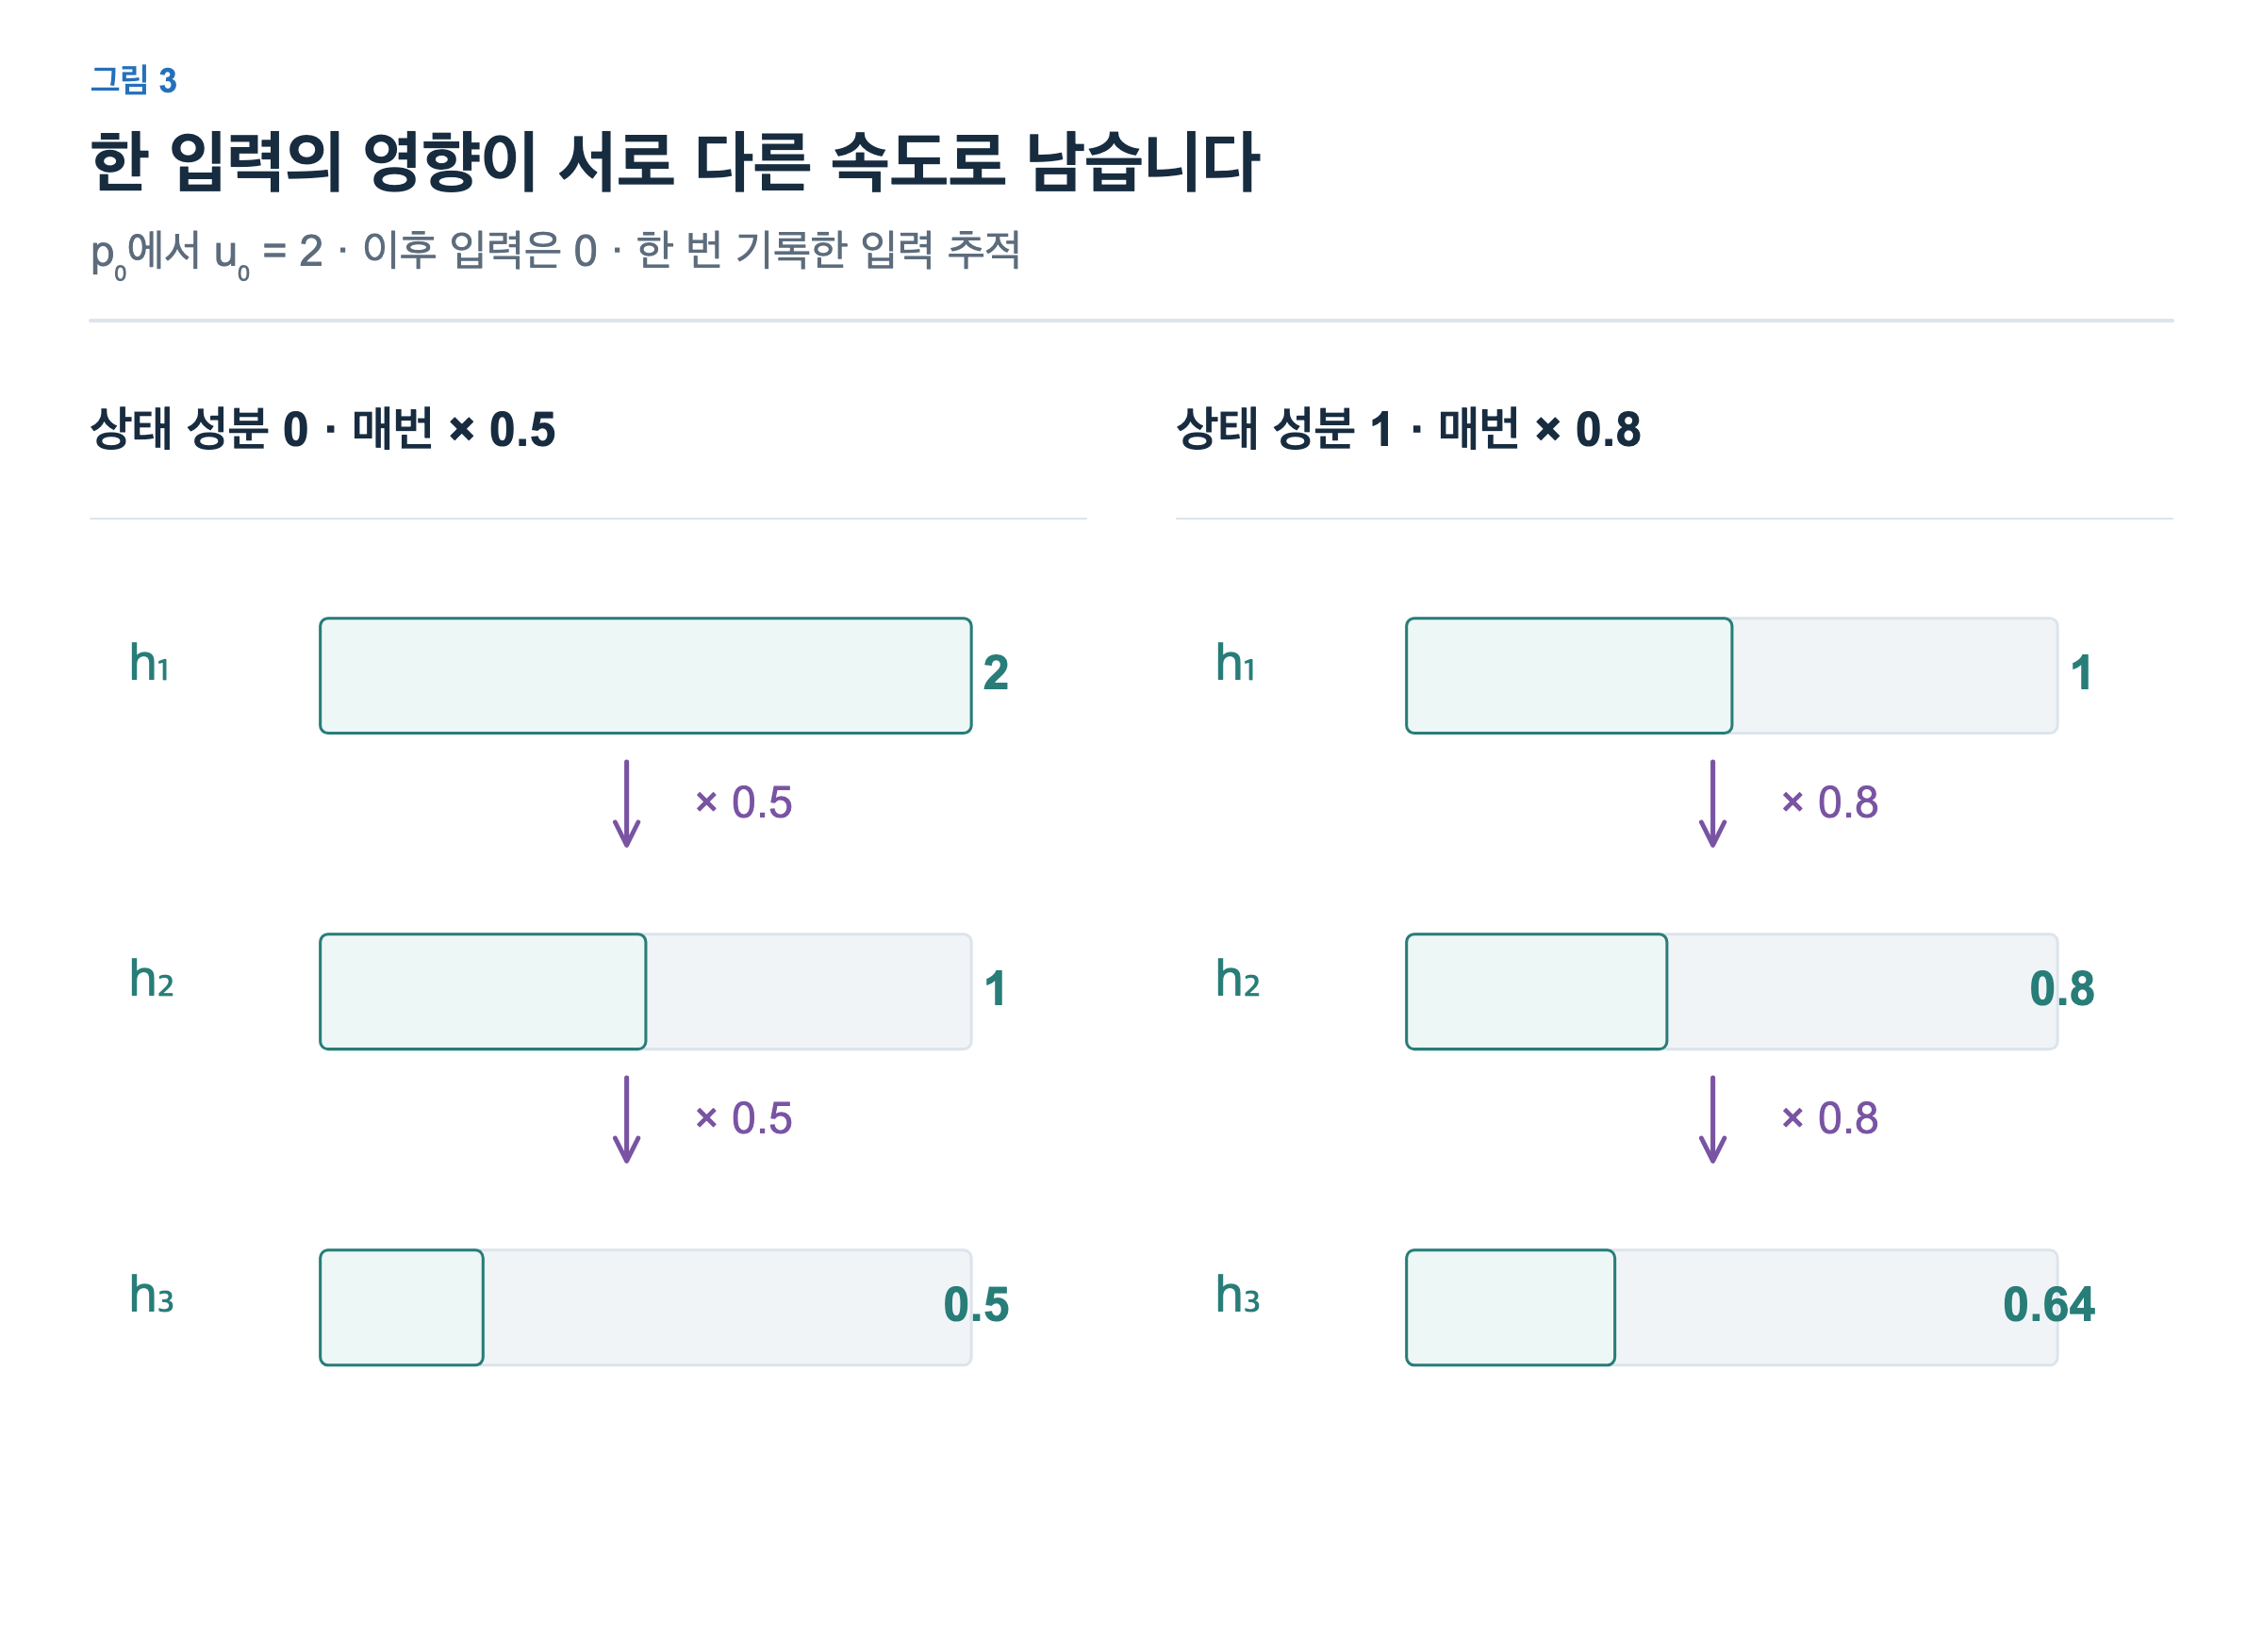
첫 성분은 매 단계 0.5배가 되어 2 → 1 → 0.5로 줄어듭니다. 둘째 성분은 매 단계 0.8배가 되어 1 → 0.8 → 0.64로 줄어듭니다. 같은 입력 2가 만든 두 기여지만, 둘째 성분에는 그 영향이 상대적으로 오래 남습니다. C=[1, 1]로 읽는다면 각 단계의 출력은 3, 1.8, 1.14입니다.
이렇게 서로 다른 변화 속도를 가진 성분을 함께 두면, 하나의 상태 안에 최근 입력의 영향을 강하게 반영하는 성분과 더 오래된 입력의 영향도 남기는 성분을 둘 수 있습니다. 실제로 새 입력이 계속 들어오면 각 성분에는 여러 입력의 기여가 더해집니다. 따라서 성분 하나를 특정 토큰 하나의 저장 공간으로 해석하면 안 됩니다.
여기서 사용한 0.5와 0.8은 원리를 설명하기 위해 고른 값입니다. 실제 Mamba의 계수나 측정된 기억 시간을 뜻하지 않습니다. 또한 모든 SSM이 이 두 성분처럼 단순하게 감쇠하는 것은 아닙니다. 이 예시는 상태 전이가 과거 입력의 영향을 어떻게 바꾸는지 살펴보기 위한 가장 작은 경우입니다.
고정된 계수로 처리한다는 의미
지금까지의 ··C는 현재 입력과 관계없이 정해진 값을 사용했습니다. 입력이 2에서 −2로 달라지면 기록하는 값과 새 상태는 달라지지만, 적용하는 계수 자체는 바뀌지 않습니다.
그림 4는 같은 이전 상태 [2, 1]에서 두 입력을 처리합니다. 양쪽 모두 로 [1, 0.8]을 남기고, 같은 와 C를 사용합니다.
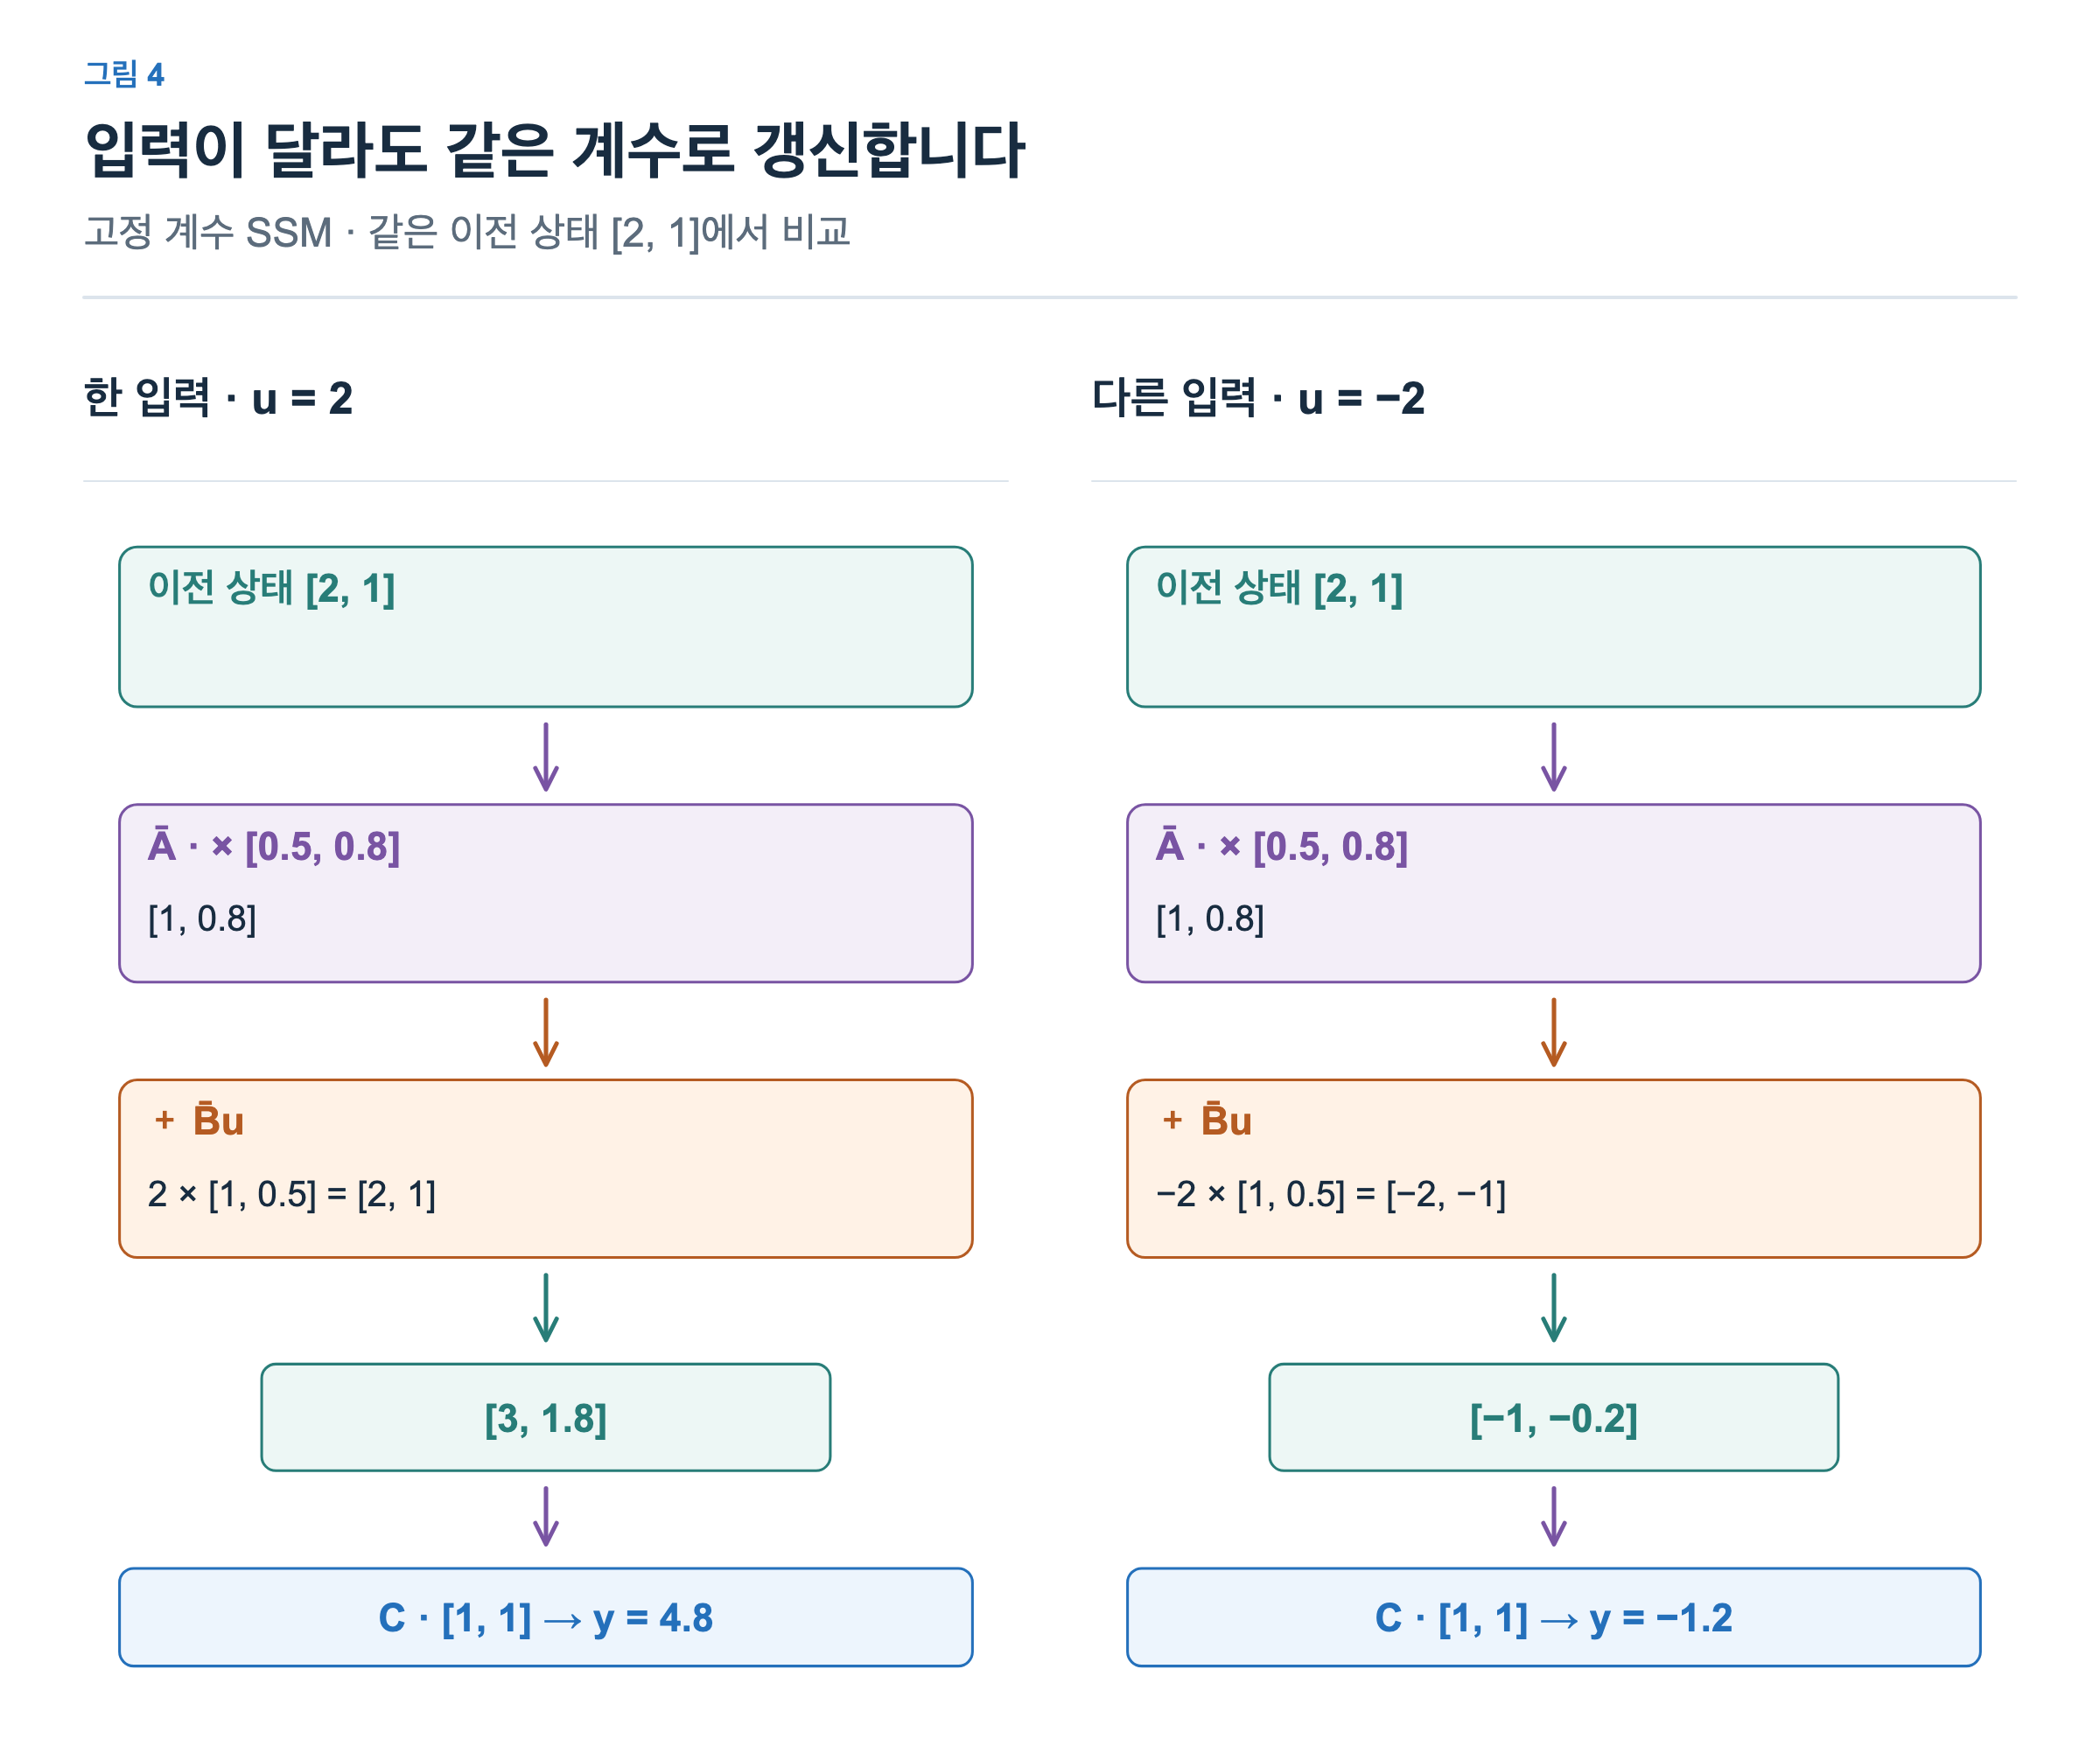
입력이 2이면 [2, 1]을 더해 새 상태 [3, 1.8]을 만듭니다. 입력이 −2이면 [−2, −1]을 더하므로 새 상태는 [−1, −0.2]입니다. C=[1, 1]로 읽은 출력은 각각 4.8과 −1.2입니다.
입력의 값은 결과에 반영되지만, 그 입력을 보고 유지·기록·읽기의 계수를 새로 정하지는 않습니다. 이것이 여기서 말하는 고정 계수의 의미입니다. 학습 과정에서도 계수가 변하지 않는다는 뜻은 아닙니다. 학습된 모델을 추론에 사용할 때 각 시점에 같은 계수를 적용한다는 뜻입니다.
상태 갱신과 읽기를 식으로 정리하기
그림에서 본 과정을 식으로 묶어 보겠습니다. 선형 어텐션에서 S로 표시했던 기억을, 이 글에서는 한 채널의 상태 벡터 h로 표시합니다. 상태의 이름은 달라도 시간의 순서는 같습니다. 출력은 선형 어텐션 글과 같이 y로 쓰며, 여기서는 한 채널의 스칼라 출력입니다.
현재 위치의 입력을 처리하기 전 상태를 , 처리한 뒤를 이라고 쓰면 다음과 같습니다. 상태의 첨자는 지금까지 처리한 입력 수를 나타냅니다.
와 위의 막대는 토큰을 한 단계씩 처리하는 이산 갱신에 쓰는 계수라는 표시입니다. 그림의 상태 성분은 읽기 쉽게 가로로 배치했지만, 식의 h와 는 각각 2×1 열벡터이고 C는 1×2 행벡터입니다. 갱신된 상태는 출력으로 읽힌 뒤에도 다음 입력을 처리하기 위해 남습니다.
첫 식의 hₜ는 이전 상태를 변화시켜 남기는 값이고, uₜ는 현재 입력을 상태에 기록할 형태로 바꾼 값입니다. 그림 2의 [1, 0.8]과 [2, 1]이 각각 이 두 항에 해당합니다. 이들을 더해 새 상태 [3, 1.8]을 만든 뒤, 둘째 식의 C로 읽으면 4.8이 나옵니다.
여기서 uₜ는 SSM에 전달된 입력 특징의 한 채널 값입니다. 신경망에서는 투영 등의 연산으로 이 특징을 만들 수 있지만, 위 식 자체가 입력을 만드는 앞단까지 정하지는 않습니다. hₜ는 입력 토큰을 투영한 값이 아니라, 과거 정보를 담은 상태를 변환한 값입니다. 두 경로가 더하기 기호에서 만나는 것입니다.
식을 펼치면 과거 입력이 보입니다
이 갱신이 문맥을 기억하는 방법이 되는 이유는 식을 몇 단계 펼쳐 보면 드러납니다. 초기 상태 h₀를 0으로 두고 같은 와 를 반복 사용하면 다음과 같습니다.
h₃에는 세 입력의 기여가 모두 들어 있습니다. 가장 최근 입력 u₂의 기여는 u₂이고, 한 단계 앞선 u₁의 기여에는 가 한 번, 두 단계 앞선 u₀의 기여에는 가 두 번 적용됩니다. 오래된 입력일수록 상태 전이를 더 많이 거친 형태로 남는 것입니다.
그림 3은 이후 입력을 0으로 두어 첫 입력의 기여만 추적한 경우입니다. 의 대각 성분이 0.5인 기억은 매번 절반이 되고, 0.8인 기억은 더 천천히 줄어듭니다. 서로 다른 변화 속도를 가진 성분을 함께 두면 과거 입력의 영향을 여러 시간 범위로 담을 수 있고, C는 이 성분들을 조합해 출력으로 읽습니다. 다만 이 구조만으로 중요한 문맥이 반드시 잘 보존되는 것은 아닙니다. 어떤 정보를 기록하고 읽을지는 모델의 학습과 상태 크기, 계수의 구성에 달려 있습니다.
선형 어텐션에서는 이전 상태에 kₜvₜᵀ를 그대로 더했습니다. 이 SSM에서는 이전 상태에 를 적용하고 uₜ를 더합니다. 읽을 때도 현재 Query 대신 고정된 C를 사용합니다. ··C에 시점 첨자가 없는 것은 추론 중 모든 위치에서 같은 계수를 사용하기 때문입니다. 다음 글에서는 이 계수들이 입력에 따라 달라집니다.
문맥에 따라 새 입력을 적극적으로 반영하거나, 기존 상태를 더 많이 남기고 싶은 경우를 생각해 볼 수 있습니다. 다음 글의 Mamba는 현재 입력에서 계수를 계산해 이 선택을 가능하게 합니다. 상태를 이어가며 기록하고 읽는 기본 구조는 유지하면서, 그 구조가 입력에 반응하는 방식을 바꾸는 것입니다.