공통 · 모델 · 2026-09-28
하이브리드 모델: 상태와 Attention을 함께 쓰기
고정 크기 상태와 위치별 KV를 함께 사용하는 이유, 품질과 저장량의 절충을 살펴보고 한 토큰이 두 종류의 층을 지나는 과정을 따라갑니다.
Linear Attention부터 Mamba까지 살펴본 모델들은 과거 입력의 영향을 상태에 남겼습니다. 새 토큰이 들어오면 그 상태를 갱신하고, 갱신된 상태에서 현재 출력에 필요한 값을 읽었습니다. 모델의 상태 크기가 정해져 있으면 토큰을 더 생성해도 저장 공간이 계속 늘어나지 않았습니다.
그렇다면 모든 Attention 층을 상태 기반 층으로 바꾸면 될까요? 저장량만 줄이는 것이 목적이라면 자연스러운 선택입니다. 하지만 모델이 과거 정보를 활용하는 방식도 함께 바뀝니다. 상태에 기록해 둔 내용을 읽는 것과, 과거 위치들의 KV를 남겨 두었다가 현재 Query로 다시 참조하는 것은 서로 다른 계산입니다.
이번 글에서는 두 계산을 서로 다른 층에 배치하는 하이브리드 모델을 살펴보겠습니다. 함께 쓰는 이유와 품질상의 가능성을 먼저 짚고, 메모리와 실행에서 남는 비용을 확인하겠습니다. 마지막에는 한 토큰이 상태 기반 층과 Attention 층을 차례로 지나는 과정을 따라가겠습니다.
상태에 남기는 기억과 위치별로 남기는 기억
먼저 두 방식이 무엇을 저장하는지 비교해 보겠습니다. 그림 1의 양쪽에는 같은 네 위치 p₀, p₁, p₂, p₃가 들어옵니다. 각 위치의 블록은 그 층에 들어오는 벡터 하나이고, 상태 안의 작은 칸은 벡터가 아닌 상태의 성분입니다.
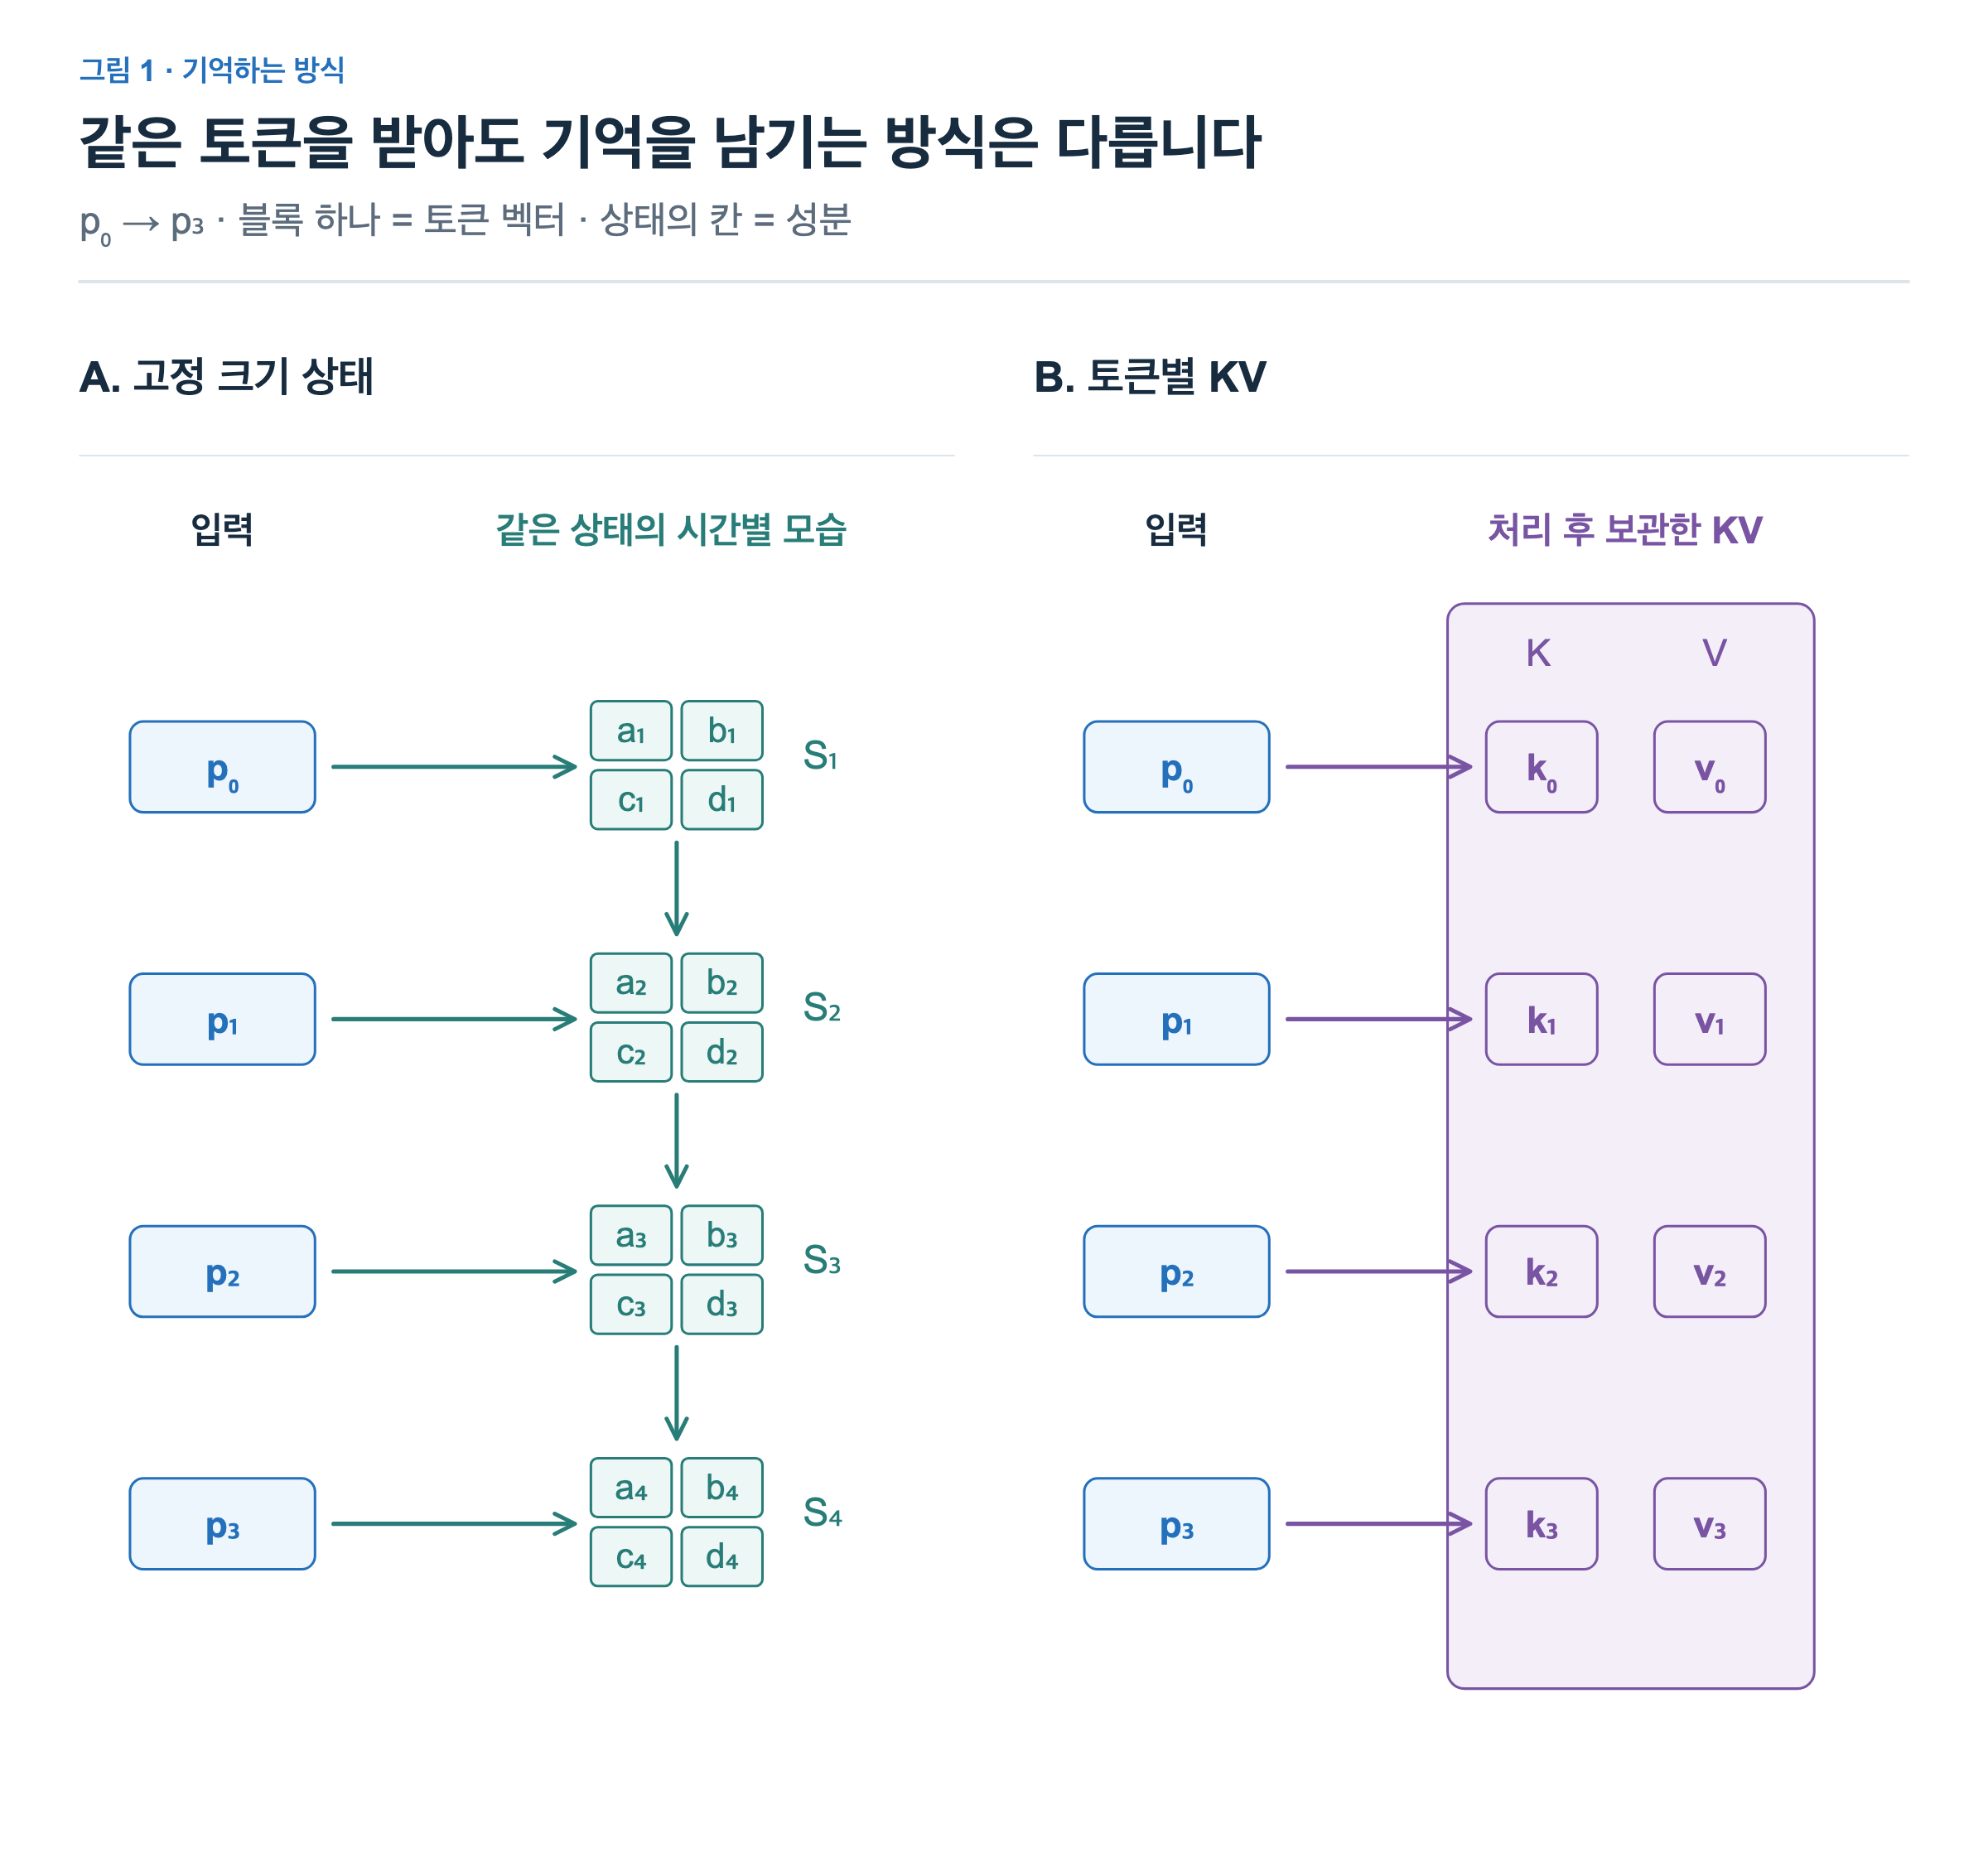
왼쪽은 입력이 들어올 때마다 같은 크기의 상태를 갱신합니다. 그림에 여러 상태가 보이는 것은 시간에 따른 변화를 나란히 보여주기 위해서입니다. 실제 생성 과정에서 이 상태들을 모두 보관한다는 뜻은 아닙니다. p₃까지 처리한 뒤에는 마지막 상태를 다음 토큰으로 넘깁니다.
오른쪽은 위치마다 만든 Key와 Value를 남깁니다. p₃까지 처리했다면 네 위치의 KV가 저장됩니다. 다음 위치의 Query는 이 위치들을 구별해 점수를 계산하고, 그 가중치로 Value를 읽을 수 있습니다. 여기서 KV는 원문 토큰 자체가 아니라 해당 층에서 계산한 표현입니다.
상태 기반 층에서는 여러 기록이 같은 성분에 영향을 주고, 갱신 과정에서 이전 기록이 바뀔 수 있습니다. KV Attention은 위치별 표현을 남겨 두므로 현재 Query로 각 위치를 다시 비교할 수 있습니다.
두 계산을 서로 다른 층에 배치하기
상태 기반 계산에는 문맥을 반복해서 갱신하는 연산이 들어 있습니다. GDN·KDA는 기존 상태에서 읽힌 값과 새 Value의 차이를 반영하고, Mamba는 입력에 따라 유지·기록·읽기의 계수를 조절했습니다. 이러한 갱신은 저장 공간을 아끼는 방법인 동시에, 정보를 처리하는 방식이기도 합니다.
KV Attention에는 현재 Query를 기준으로 과거 위치들의 표현을 직접 비교하는 경로가 있습니다. 하이브리드 모델은 이 경로를 일부 층에 남기고, 다른 층에서는 상태를 갱신하도록 구성할 수 있습니다. 그림 2는 전체 여섯 층을 같게 두고 배치만 비교한 교육용 예시입니다.
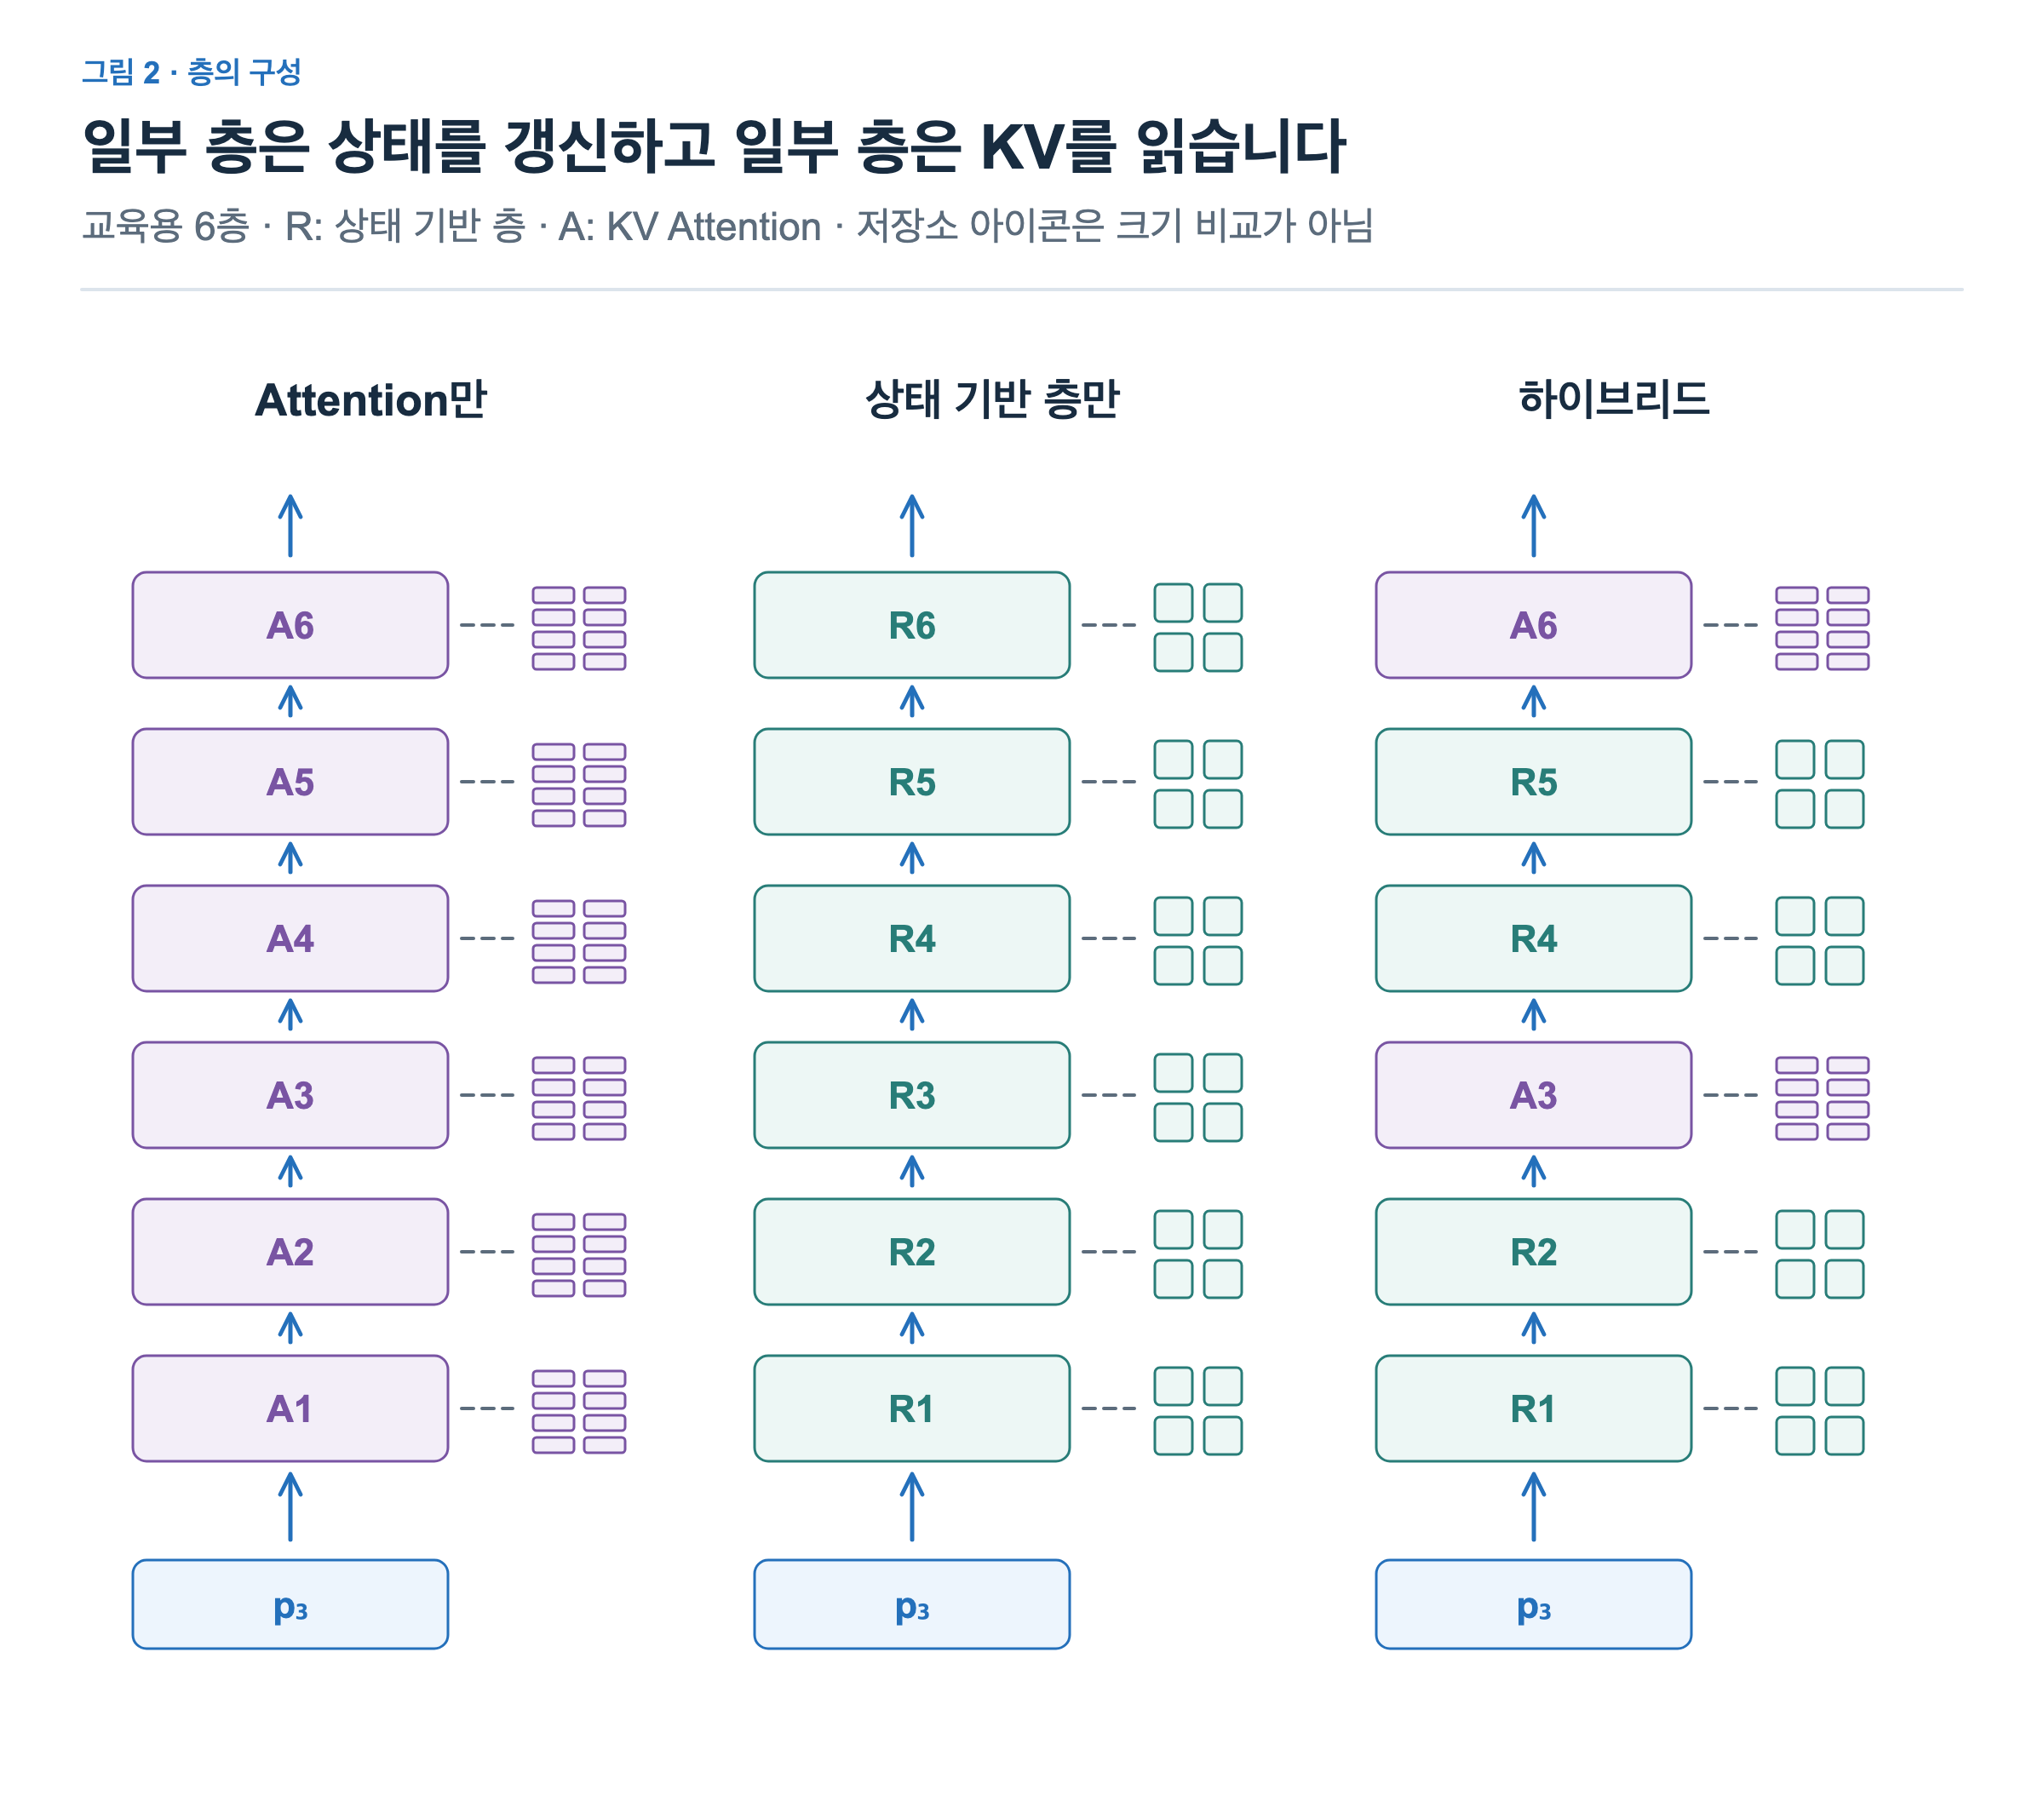
가운데 구성은 모든 층이 상태를 사용하고, 오른쪽 혼합 구성은 R₁ → R₂ → A₃ → R₄ → R₅ → A₆ 순서로 처리합니다. R은 상태 기반 층, A는 KV Attention 층이며 하첨자는 층 번호입니다. 서로 다른 R 층은 각각 자신의 상태를 가지고, A₃과 A₆도 각각 자신의 KV를 저장합니다.
같은 토큰의 표현이 모든 층을 차례로 통과합니다. 상태 기반 층이 만든 출력은 다음 Attention 층의 입력이 되고, Attention 층에서 과거 위치를 참조한 결과는 뒤의 상태 기반 층으로 전달됩니다. 두 종류의 계산이 깊이 방향으로 연결되는 것입니다.
품질에서도 이점이 있을까
두 방식을 섞는 이유가 메모리를 줄이면서 품질 저하를 견디기 위해서만은 아닙니다. 같은 학습 조건에서 혼합 모델이 각각의 단독 모델보다 더 좋은 결과를 낸 실험도 있습니다.
그림 3은 Mamba-2 논문의 비교입니다. 약 350M 파라미터 모델을 Pile의 7B 토큰으로 학습하고, 같은 GPT-2 토크나이저와 학습·검증 조건에서 Perplexity를 비교했습니다. Perplexity는 다음 토큰 예측을 평가하는 지표로, 이 비교에서는 낮을수록 좋습니다.
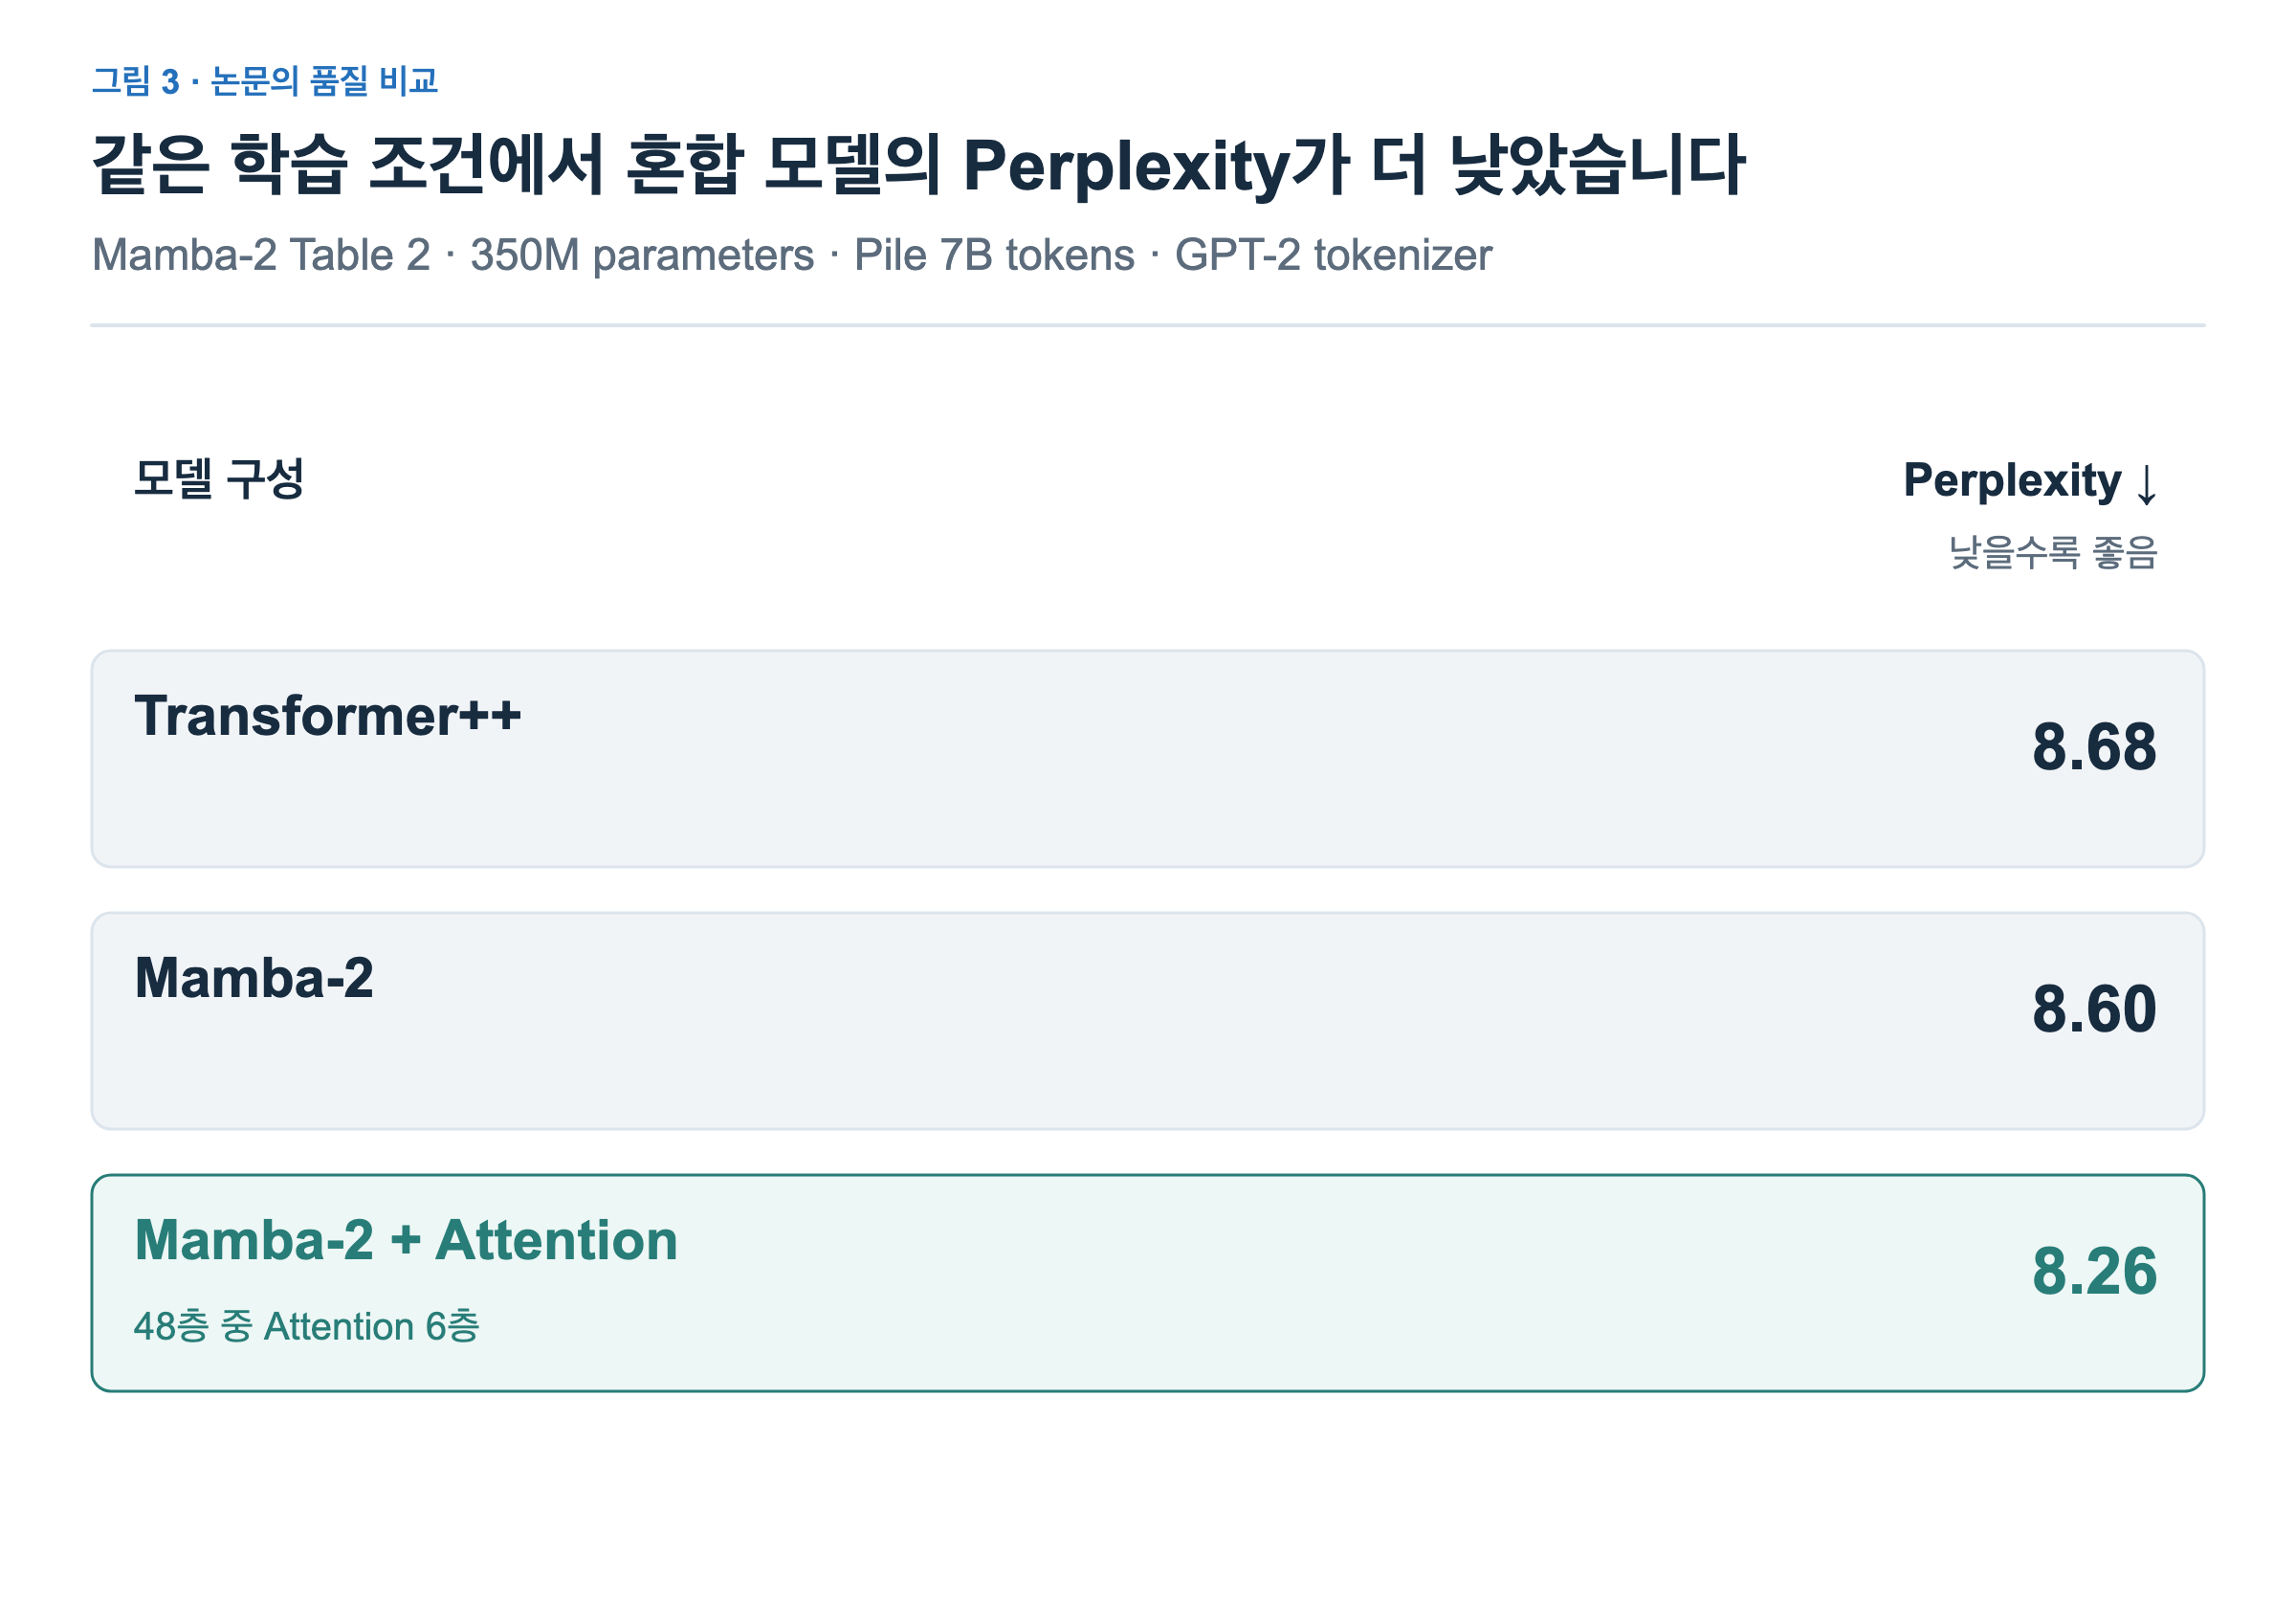
Transformer++는 8.68, Mamba-2는 8.60이고, Mamba-2의 48개 층 가운데 6개를 Attention으로 구성한 혼합 모델은 8.26입니다. 이 실험에서는 Attention만 쓰거나 상태 기반 계산만 쓰는 구성보다 혼합 구성이 더 낮은 Perplexity를 얻었습니다. Mamba-2 논문 §9.2.3, Table 2
이 결과는 두 계산을 함께 사용해 예측 품질을 높일 수 있음을 보여줍니다. 적절한 층 비율은 모델 규모와 학습 조건에 따라 달라집니다.
줄어드는 저장량과 남는 비용
혼합 모델에서도 KV를 사용하는 층의 캐시는 문맥 길이에 따라 늘어납니다. 그림 4에서는 다시 여섯 층 예시로 돌아와, 토큰 네 개를 처리했을 때와 여덟 개를 처리했을 때를 비교합니다. 그림 3의 실험 모델과는 별개인 저장량 계산입니다.
상태 기반 층은 각각 2×2 상태, 즉 4개 성분을 저장한다고 하겠습니다. Attention 층은 토큰마다 Key 2개 성분과 Value 2개 성분을 저장합니다. 모든 칸은 동일한 크기의 성분 하나이며, head나 토큰 하나를 뜻하지 않습니다.
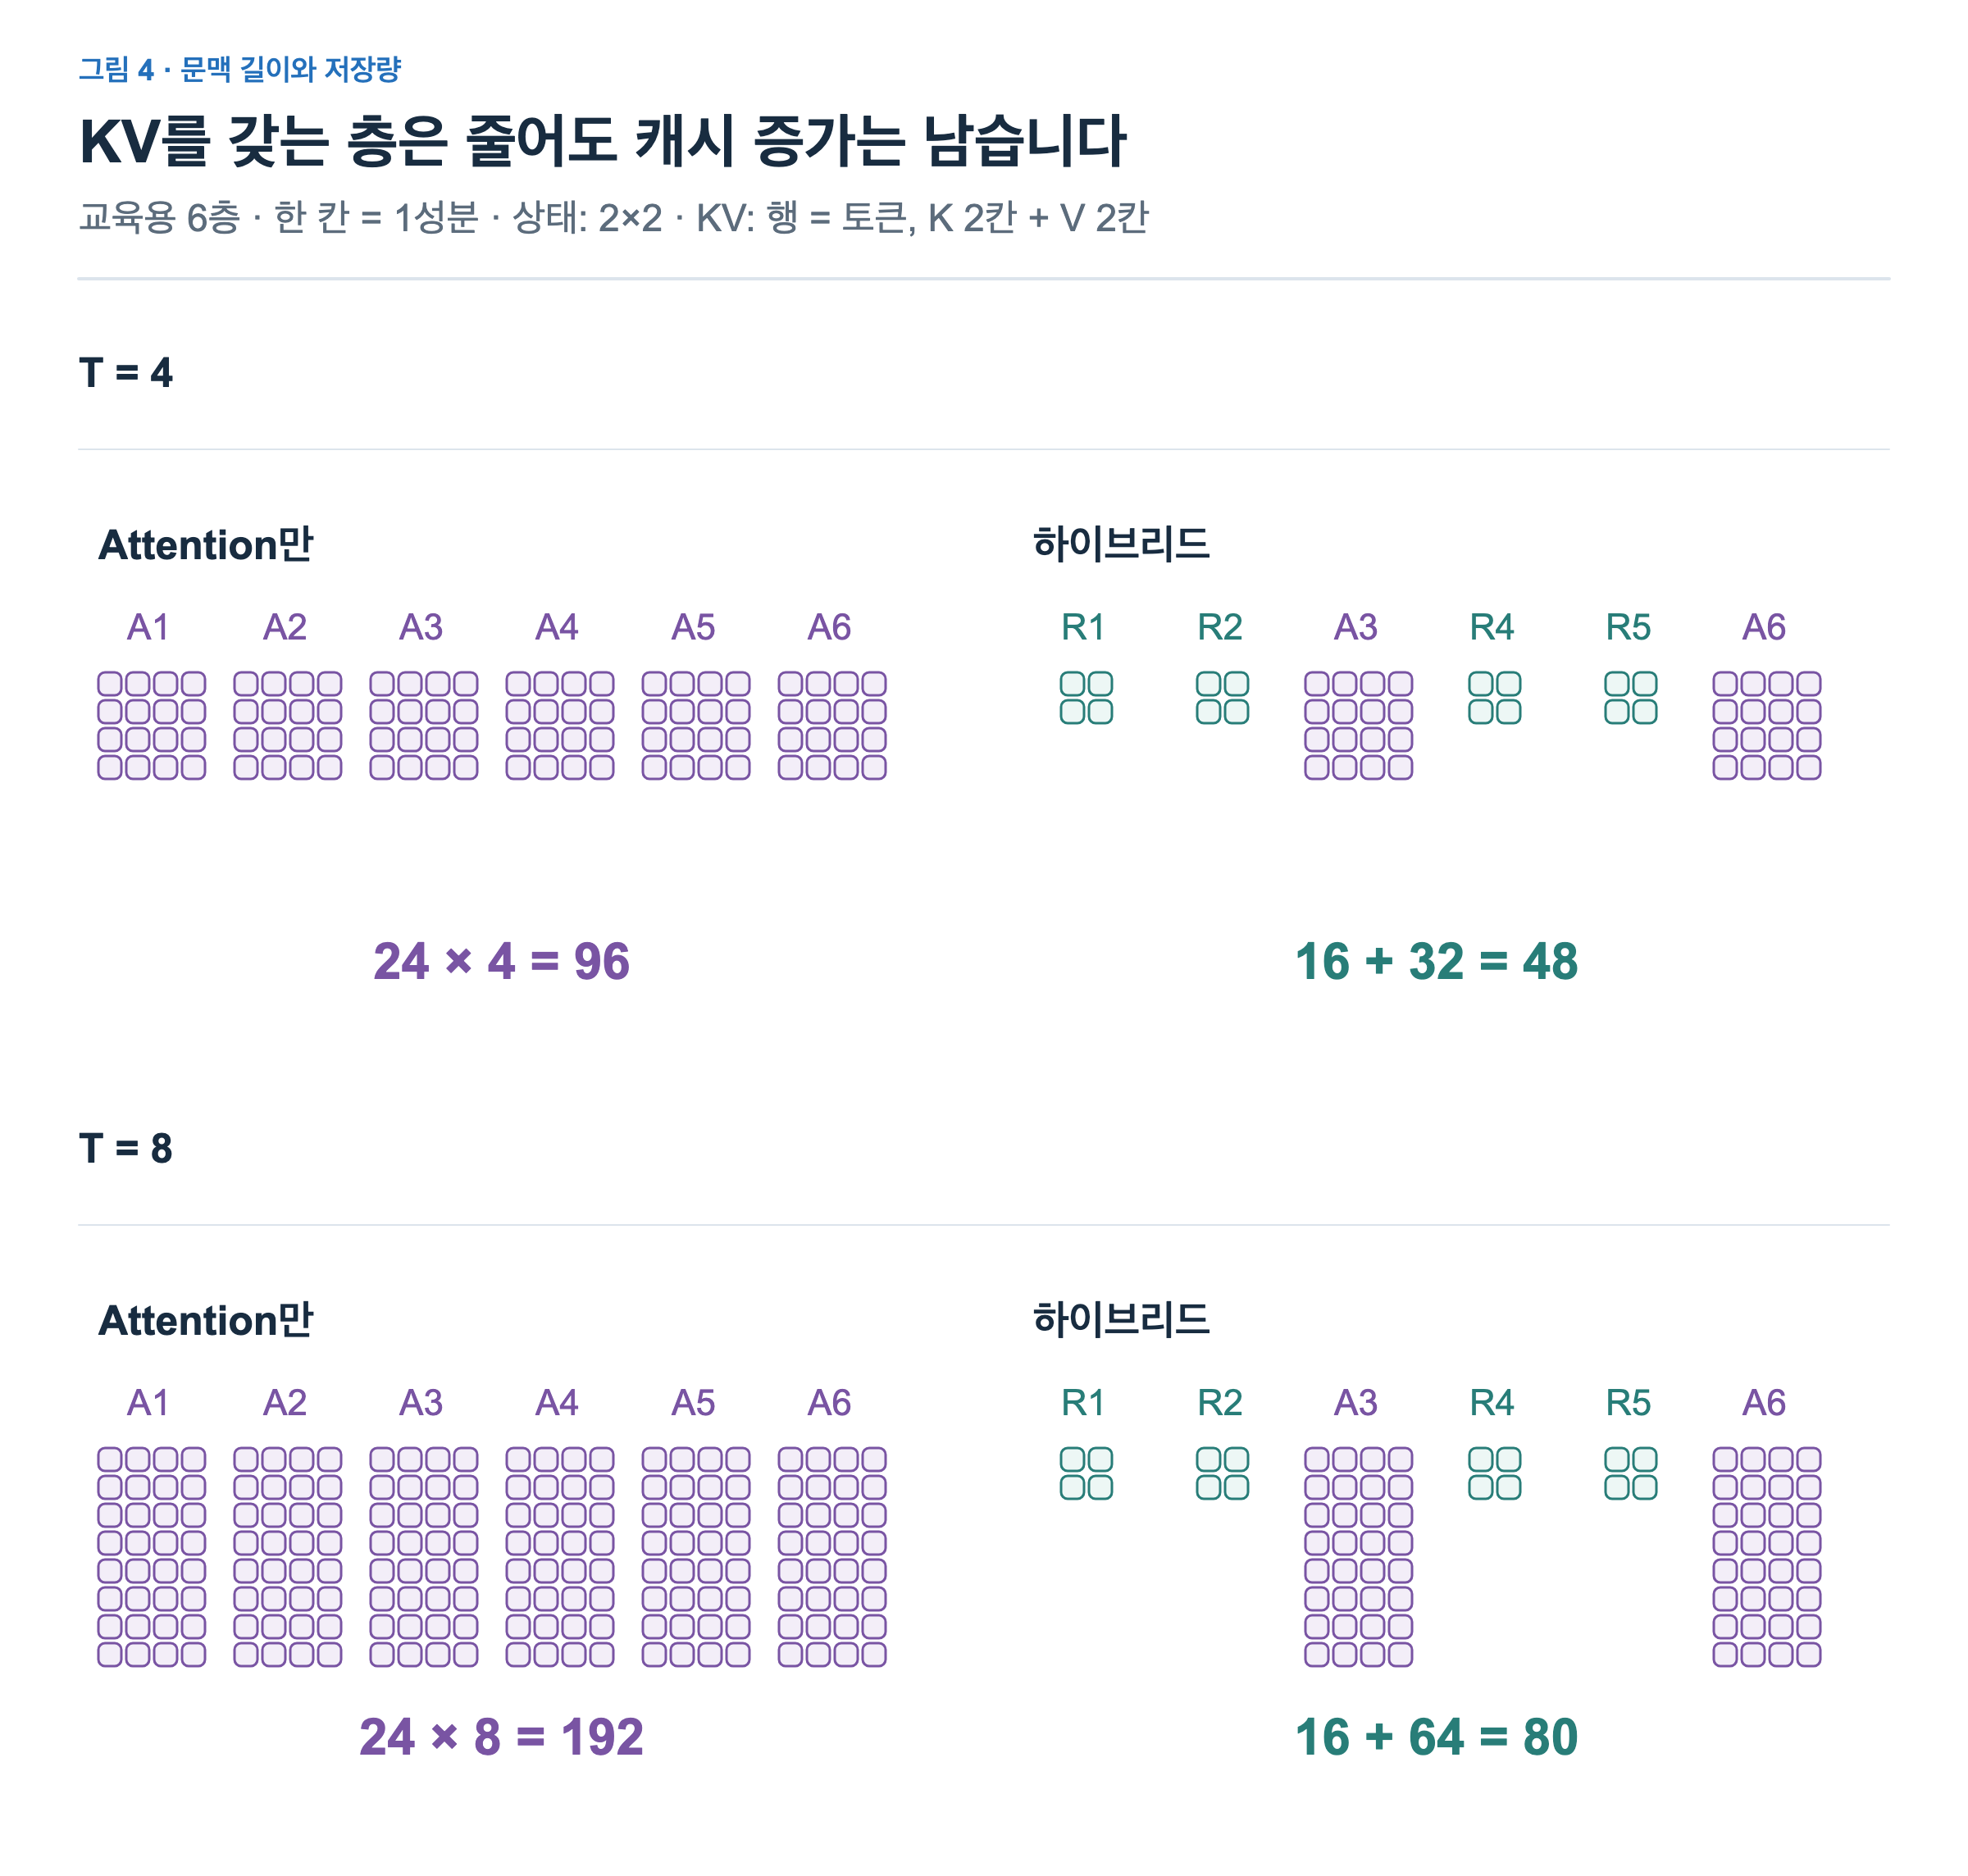
모든 층이 Attention이면 각 층에 토큰 수의 4배만큼 성분이 필요합니다. 층이 여섯 개이므로 토큰 수를 T라 할 때 합계는 24T입니다. T=4에서는 96개, T=8에서는 192개입니다.
혼합 구성의 상태 층 네 개는 합계 16개 성분으로 고정됩니다. Attention 층 두 개는 합계 8T개 성분을 저장합니다. 따라서 전체는 16+8T이며, T=4에서는 48개, T=8에서는 80개입니다. KV를 저장하는 층이 줄어들어 증가 폭은 작아지지만, 전체 저장량이 고정되지는 않습니다.
이 계산은 상태와 KV의 저장량만 비교한 것으로, 가중치와 중간 활성값 등은 제외했습니다. 고정 상태에도 저장 공간이 필요하므로 짧은 문맥에서는 이점이 작을 수 있습니다.
품질과 실행에서도 주의할 점이 있습니다. Attention 층을 줄이면 위치별 KV를 직접 참조하는 단계도 줄어듭니다. 남은 층만으로 필요한 품질을 유지하는지는 학습과 평가로 확인해야 합니다.
실행기는 두 종류의 기억도 관리해야 합니다. KV는 새 위치의 행을 추가하지만 상태는 기존 내용을 갱신합니다. 예를 들어 생성 후보를 처리했다가 이전 위치로 돌아가려면 KV는 뒤에 추가한 행을 제외할 수 있는 반면, 덮어쓴 상태는 이전 값을 보관했거나 다시 계산할 수 있어야 합니다. 이는 층 비율과 별도로 고려할 실행상의 차이입니다. 또한 줄어든 KV 접근 비용이 실제 속도 향상으로 이어지는 정도는 상태 갱신 커널, 문맥 길이와 배치 크기에도 달려 있습니다.
하이브리드마다 섞는 대상이 다르다
모델 설명에서 Hybrid Attention이라는 이름을 보더라도 모두 지금까지 설명한 상태와 KV의 조합은 아닙니다. 앞서 배운 SWA나 압축 Attention을 서로 다른 층에 배치하는 경우에도 같은 표현을 사용합니다. 그림 5에서는 무엇을 섞는지에 따라 구분합니다.
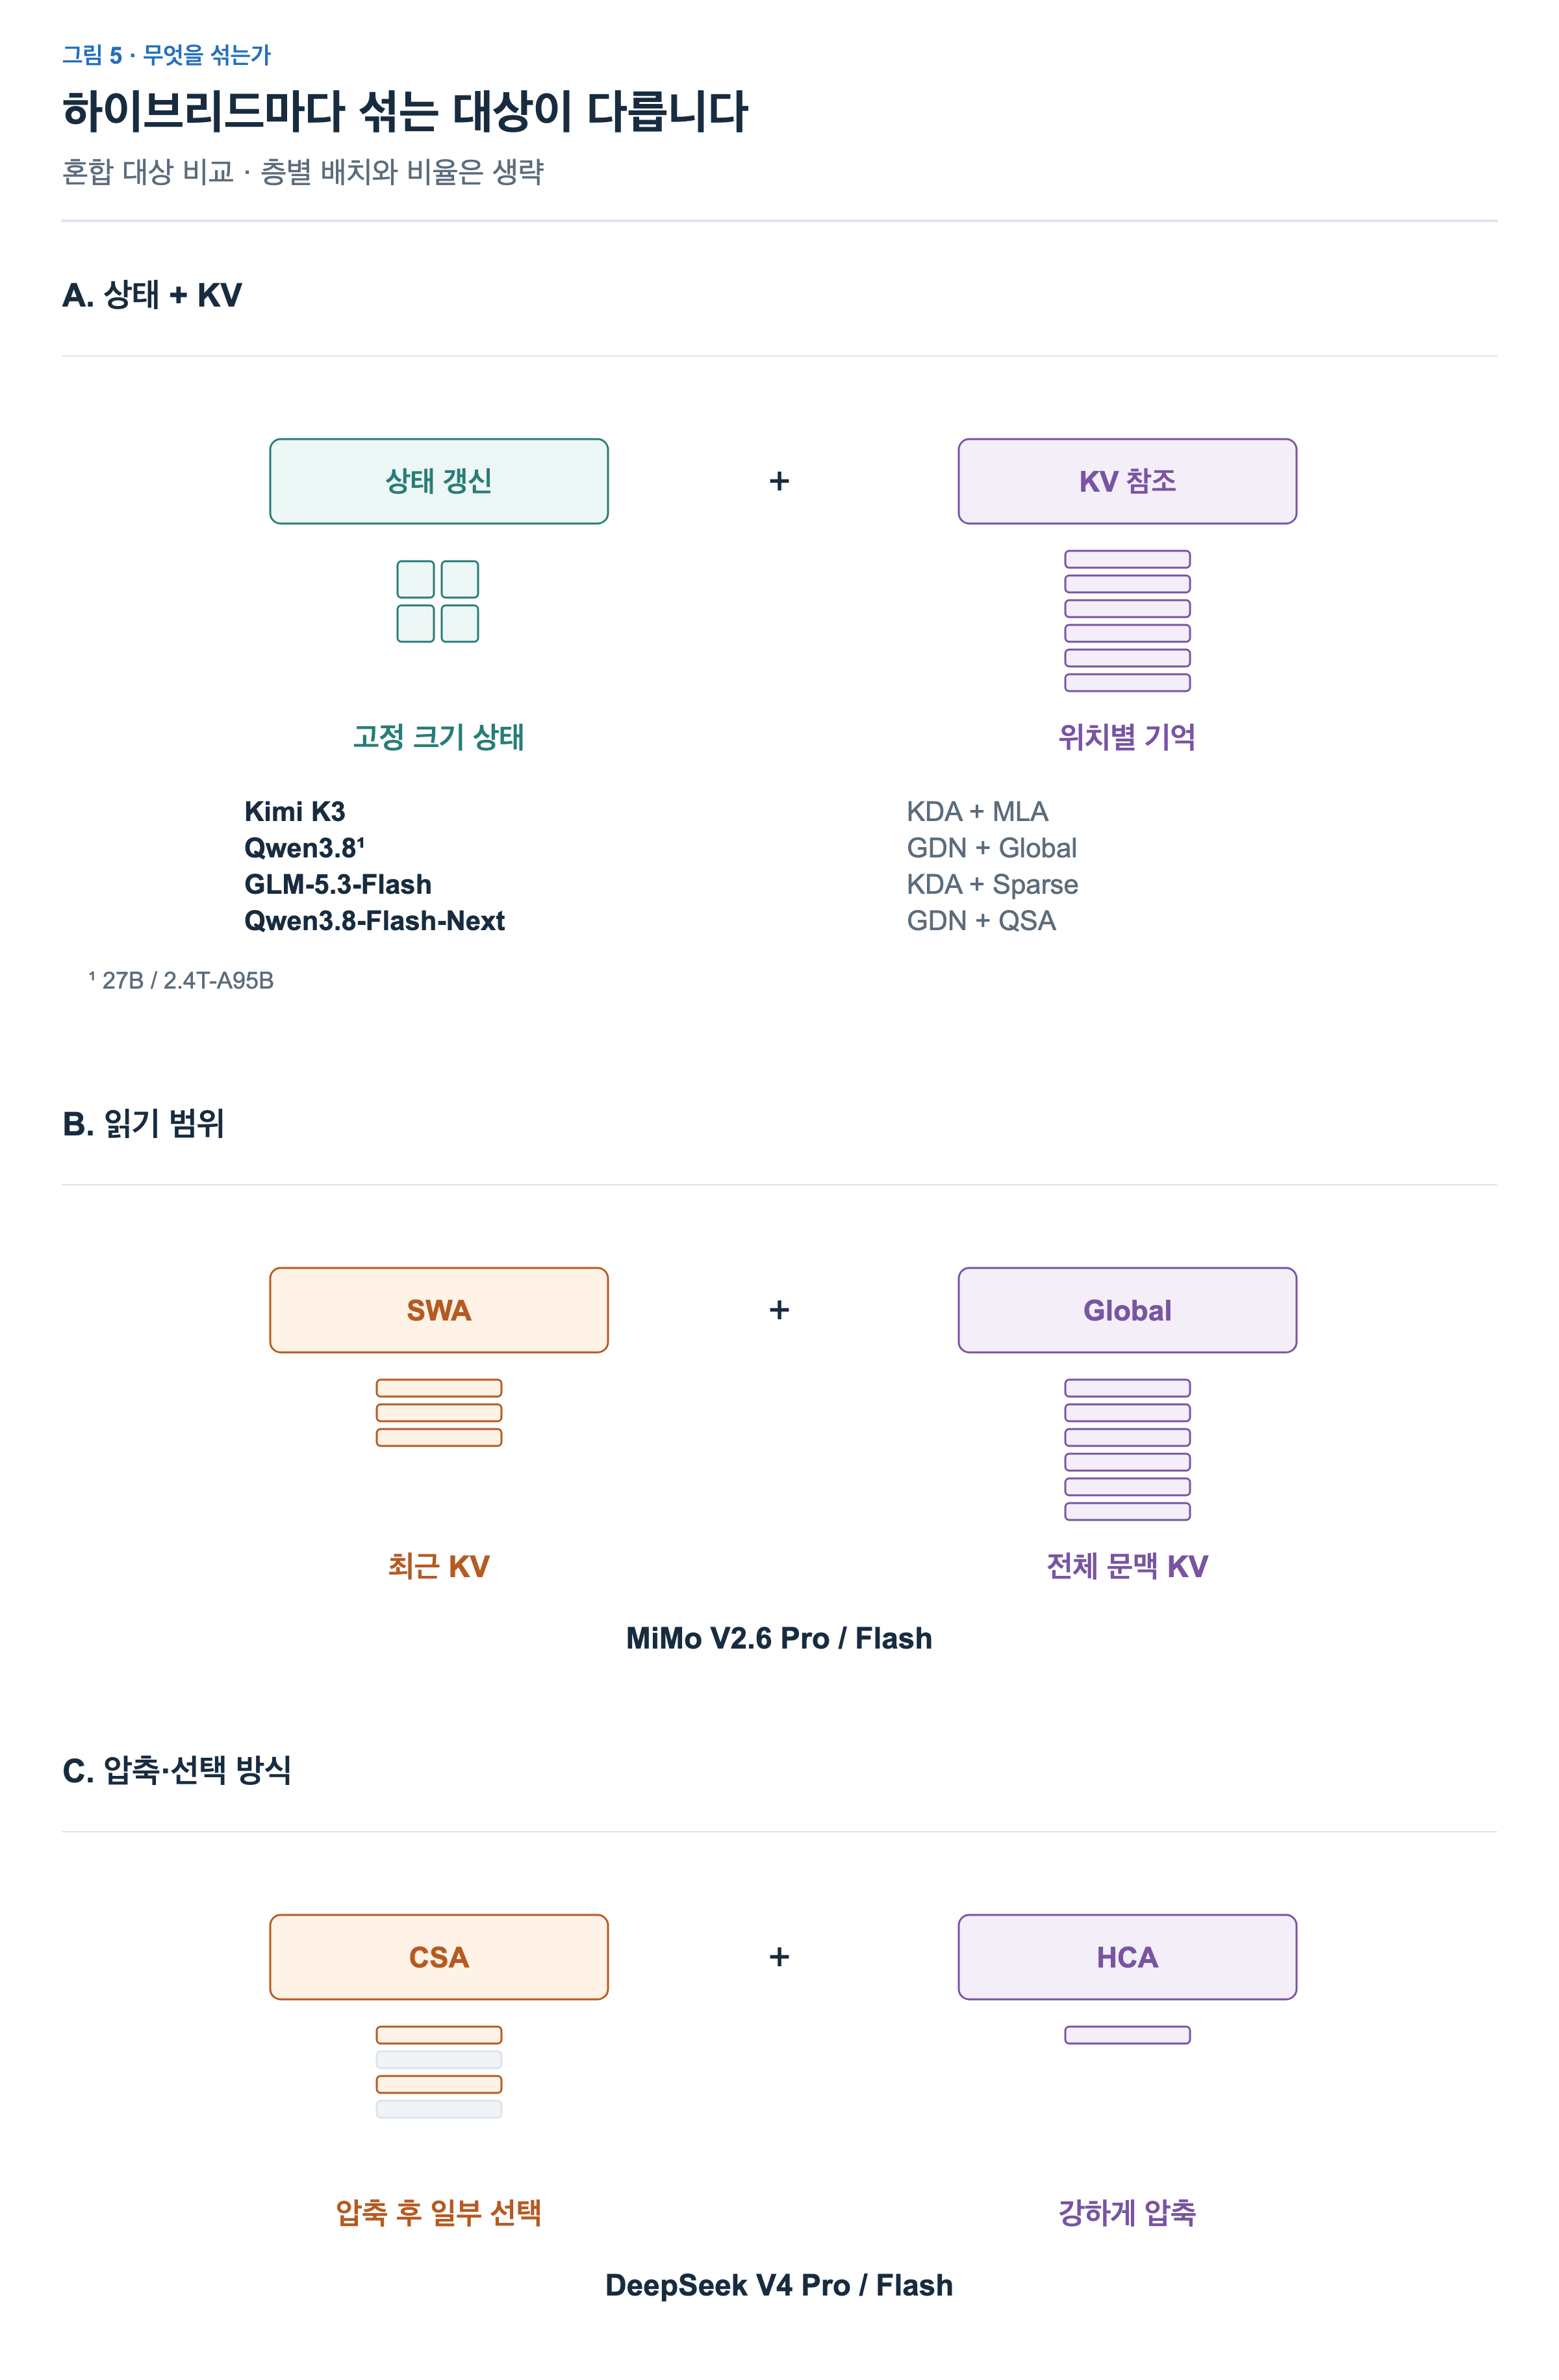
첫째는 이번 글의 중심인 상태 기반 층과 KV Attention 층의 조합입니다. Kimi K3는 KDA와 MLA를, Qwen3.8-27B는 GDN과 전체 문맥 Attention을 사용합니다. KV 쪽이 반드시 일반적인 Full Attention이어야 하는 것은 아닙니다. GLM-5.3-Flash는 KDA와 Sparse Attention을, Qwen3.8-Flash-Next는 GDN과 QSA를 조합합니다.
둘째는 KV를 읽는 범위의 조합입니다. MiMo-V2.6-Pro-RL처럼 최근 구간을 보는 SWA와 전체 문맥을 보는 Attention을 함께 배치합니다. SWA는 최근 구간의 위치별 KV를 저장하고 읽습니다.
셋째는 압축과 선택 방식의 조합입니다. DeepSeek-V4는 여러 토큰의 KV를 압축한 뒤 일부를 선택하는 CSA와, 더 강하게 압축하는 HCA를 배치합니다. 두 방식에는 최근 구간의 압축하지 않은 KV를 읽는 경로도 있습니다. 여기서 압축된 항목은 토큰 묶음이 늘어나면 추가되는 KV이며, 매번 같은 크기의 상태 하나를 갱신하는 구조와 구별됩니다.
한 토큰이 두 종류의 층을 지나는 과정
마지막으로 그림 2의 혼합 구성에서 p₃을 처리하는 순간을 따라가겠습니다. 층 2는 GDN, 층 3은 KV Attention이라고 하겠습니다. 두 층 모두 p₀부터 p₂까지 처리한 기억이 있고, 이제 p₃ 위치의 입력 표현을 받습니다.
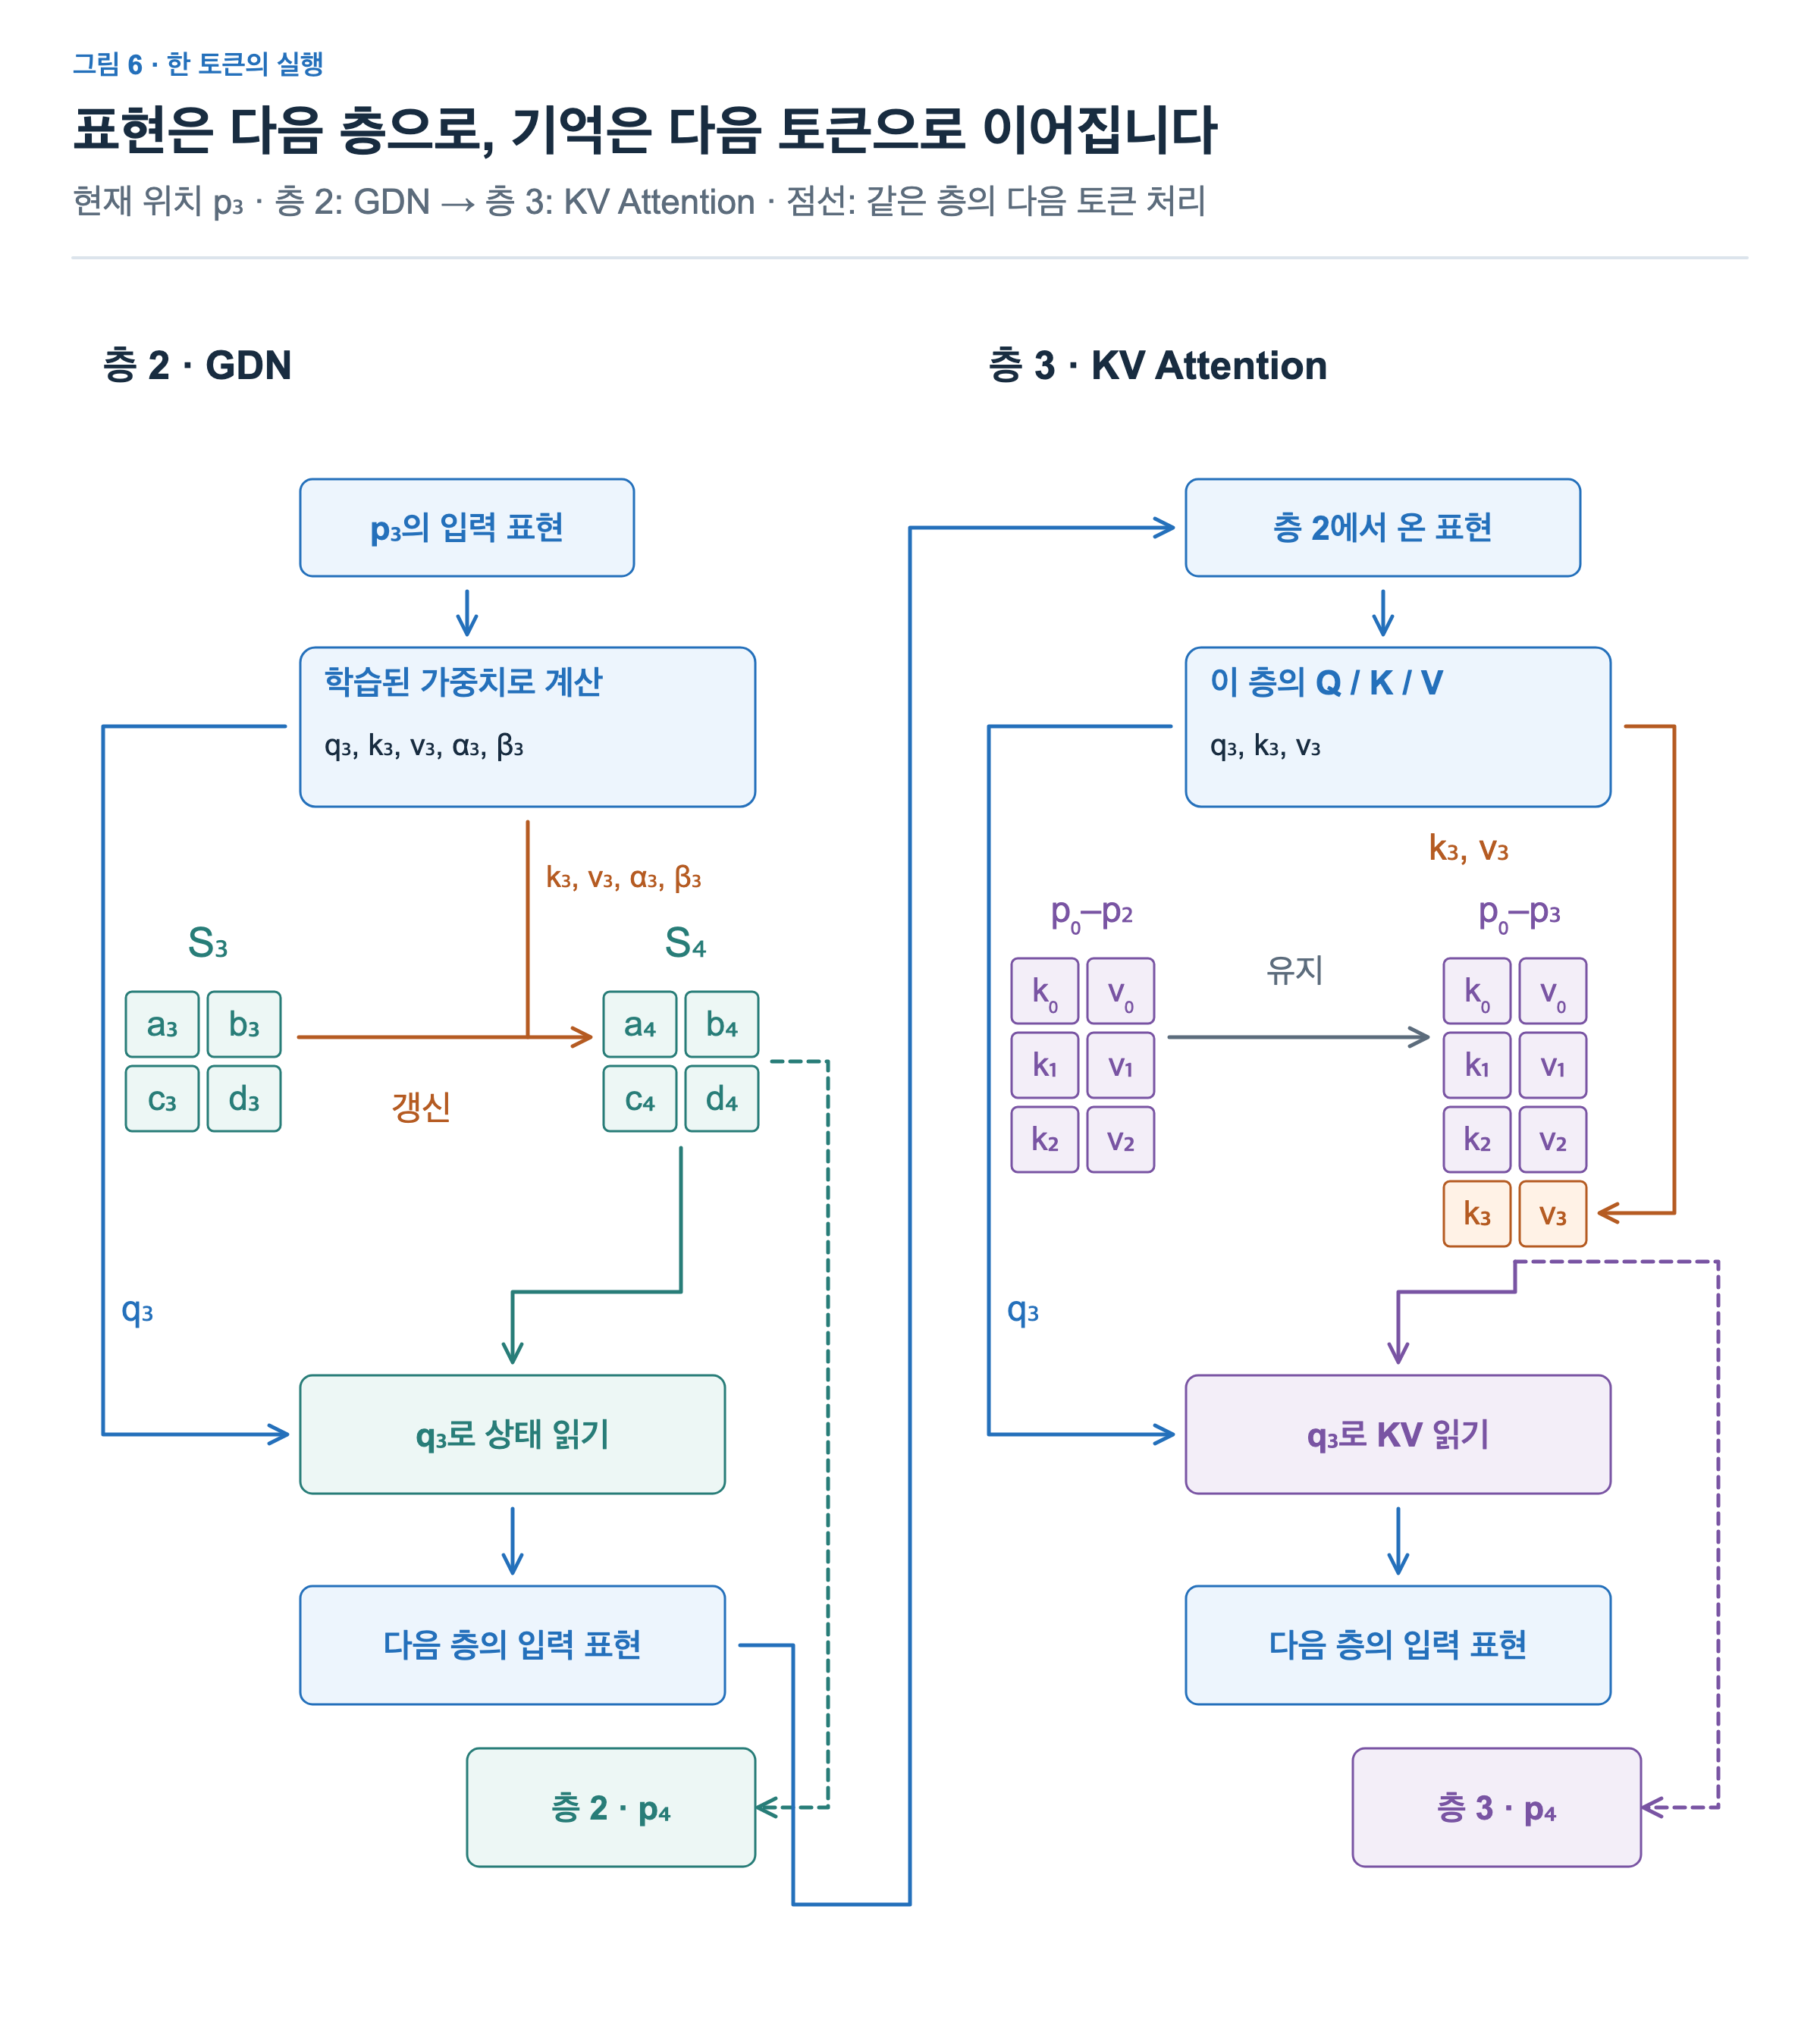
먼저 층 2는 자신의 입력 표현에서 학습된 가중치를 사용해 Query, Key, Value와 유지율 α₃, 보정 강도 β₃을 계산합니다.
그다음 기존 상태 S₃에 유지율을 적용하고, 유지한 상태를 k₃으로 읽습니다. 이번에 기록할 v₃과 읽힌 값의 차이에 β₃과 k₃을 적용해 보정량을 만들고 상태를 갱신합니다. 이것이 앞서 배운 GDN의 계산입니다.
갱신한 상태는 S₄입니다. 앞선 글과 같이 상태 하첨자는 처리한 토큰 수를 나타내므로, p₃을 처리하기 전은 S₃, 처리한 뒤는 S₄입니다. q₃은 이 새 상태를 읽어 현재 위치의 출력을 만듭니다. 출력 투영과 residual, FFN 같은 나머지 블록 연산을 거친 표현이 다음 층의 입력으로 이어집니다.
층 3은 전달받은 표현에서 자신의 가중치로 새로운 Query, Key, Value를 계산합니다. 양쪽에 q₃, k₃, v₃이라는 같은 기호가 있지만 층이 다르므로 같은 벡터가 아닙니다. 하첨자 3은 현재 토큰 위치이고, 층은 패널 제목으로 구분합니다.
층 3의 캐시에는 p₀부터 p₂까지의 KV가 있습니다. 여기에 자신의 k₃과 v₃을 추가한 뒤, q₃으로 p₀부터 p₃까지의 KV를 읽습니다. 이렇게 얻은 출력도 다음 층의 입력 표현으로 전달됩니다. 층 2의 상태를 KV로 변환하거나 층 3의 캐시에 복사하는 과정은 없습니다.
p₄가 들어올 때는 층 2가 자신의 S₄를 이어받아 갱신하고, 층 3이 자신의 네 위치 KV를 이어받아 새 행을 추가합니다. 현재 토큰의 표현은 다음 층으로 흐르고, 각 층의 기억은 같은 층의 다음 토큰 처리로 이어집니다.