RL · 2026-09-25
생성 확률과 학습 확률이 달라지는 이유
계산 순서에 따른 차이를 줄이는 방법을 살펴보고, 남은 엔진 차이와 모델 버전 차이를 확률비로 다루는 원리를 설명합니다.
앞선 글에서는 TITO와 R3로 토큰과 전문가 선택을 보존하고, 양자화 설정을 맞추는 방법을 살펴보았습니다. 그런데 입력과 가중치, 정밀도를 같게 해도 두 엔진이 계산하는 토큰 확률은 달라질 수 있습니다.
이번 글에서는 계산 순서에서 생기는 차이를 먼저 줄이고, 남는 차이는 학습에 반영할 비중을 보정하는 방식으로 다루겠습니다. 같은 가중치를 다르게 계산해서 생긴 차이와 학습으로 가중치가 바뀌어서 생긴 차이를 나눈 뒤, 확률비 보정이 학습에 반영되는 비중을 어떻게 조절하는지 살펴보겠습니다.
같은 숫자도 계산 순서에 따라 달라진다
추론 엔진은 다음 토큰을 하나씩 생성하고, 학습 엔진은 기록된 여러 토큰을 함께 읽어 확률을 다시 계산합니다. 처리하는 데이터의 모양이 다르므로 행렬 곱이나 attention을 실행하는 커널, 합산 순서도 달라질 수 있습니다. 컴퓨터는 모든 소수 자릿수를 보존하지 못하기 때문에 이 차이가 계산 결과에 남습니다.
아주 작은 예를 보겠습니다. 1.0, 0.04, 0.04를 더하되 덧셈을 한 번 끝낼 때마다 소수 첫째 자리로 반올림한다고 하겠습니다. 실제 GPU의 숫자 형식을 재현한 예가 아니라 중간 반올림의 효과만 보여주는 가상의 규칙입니다.
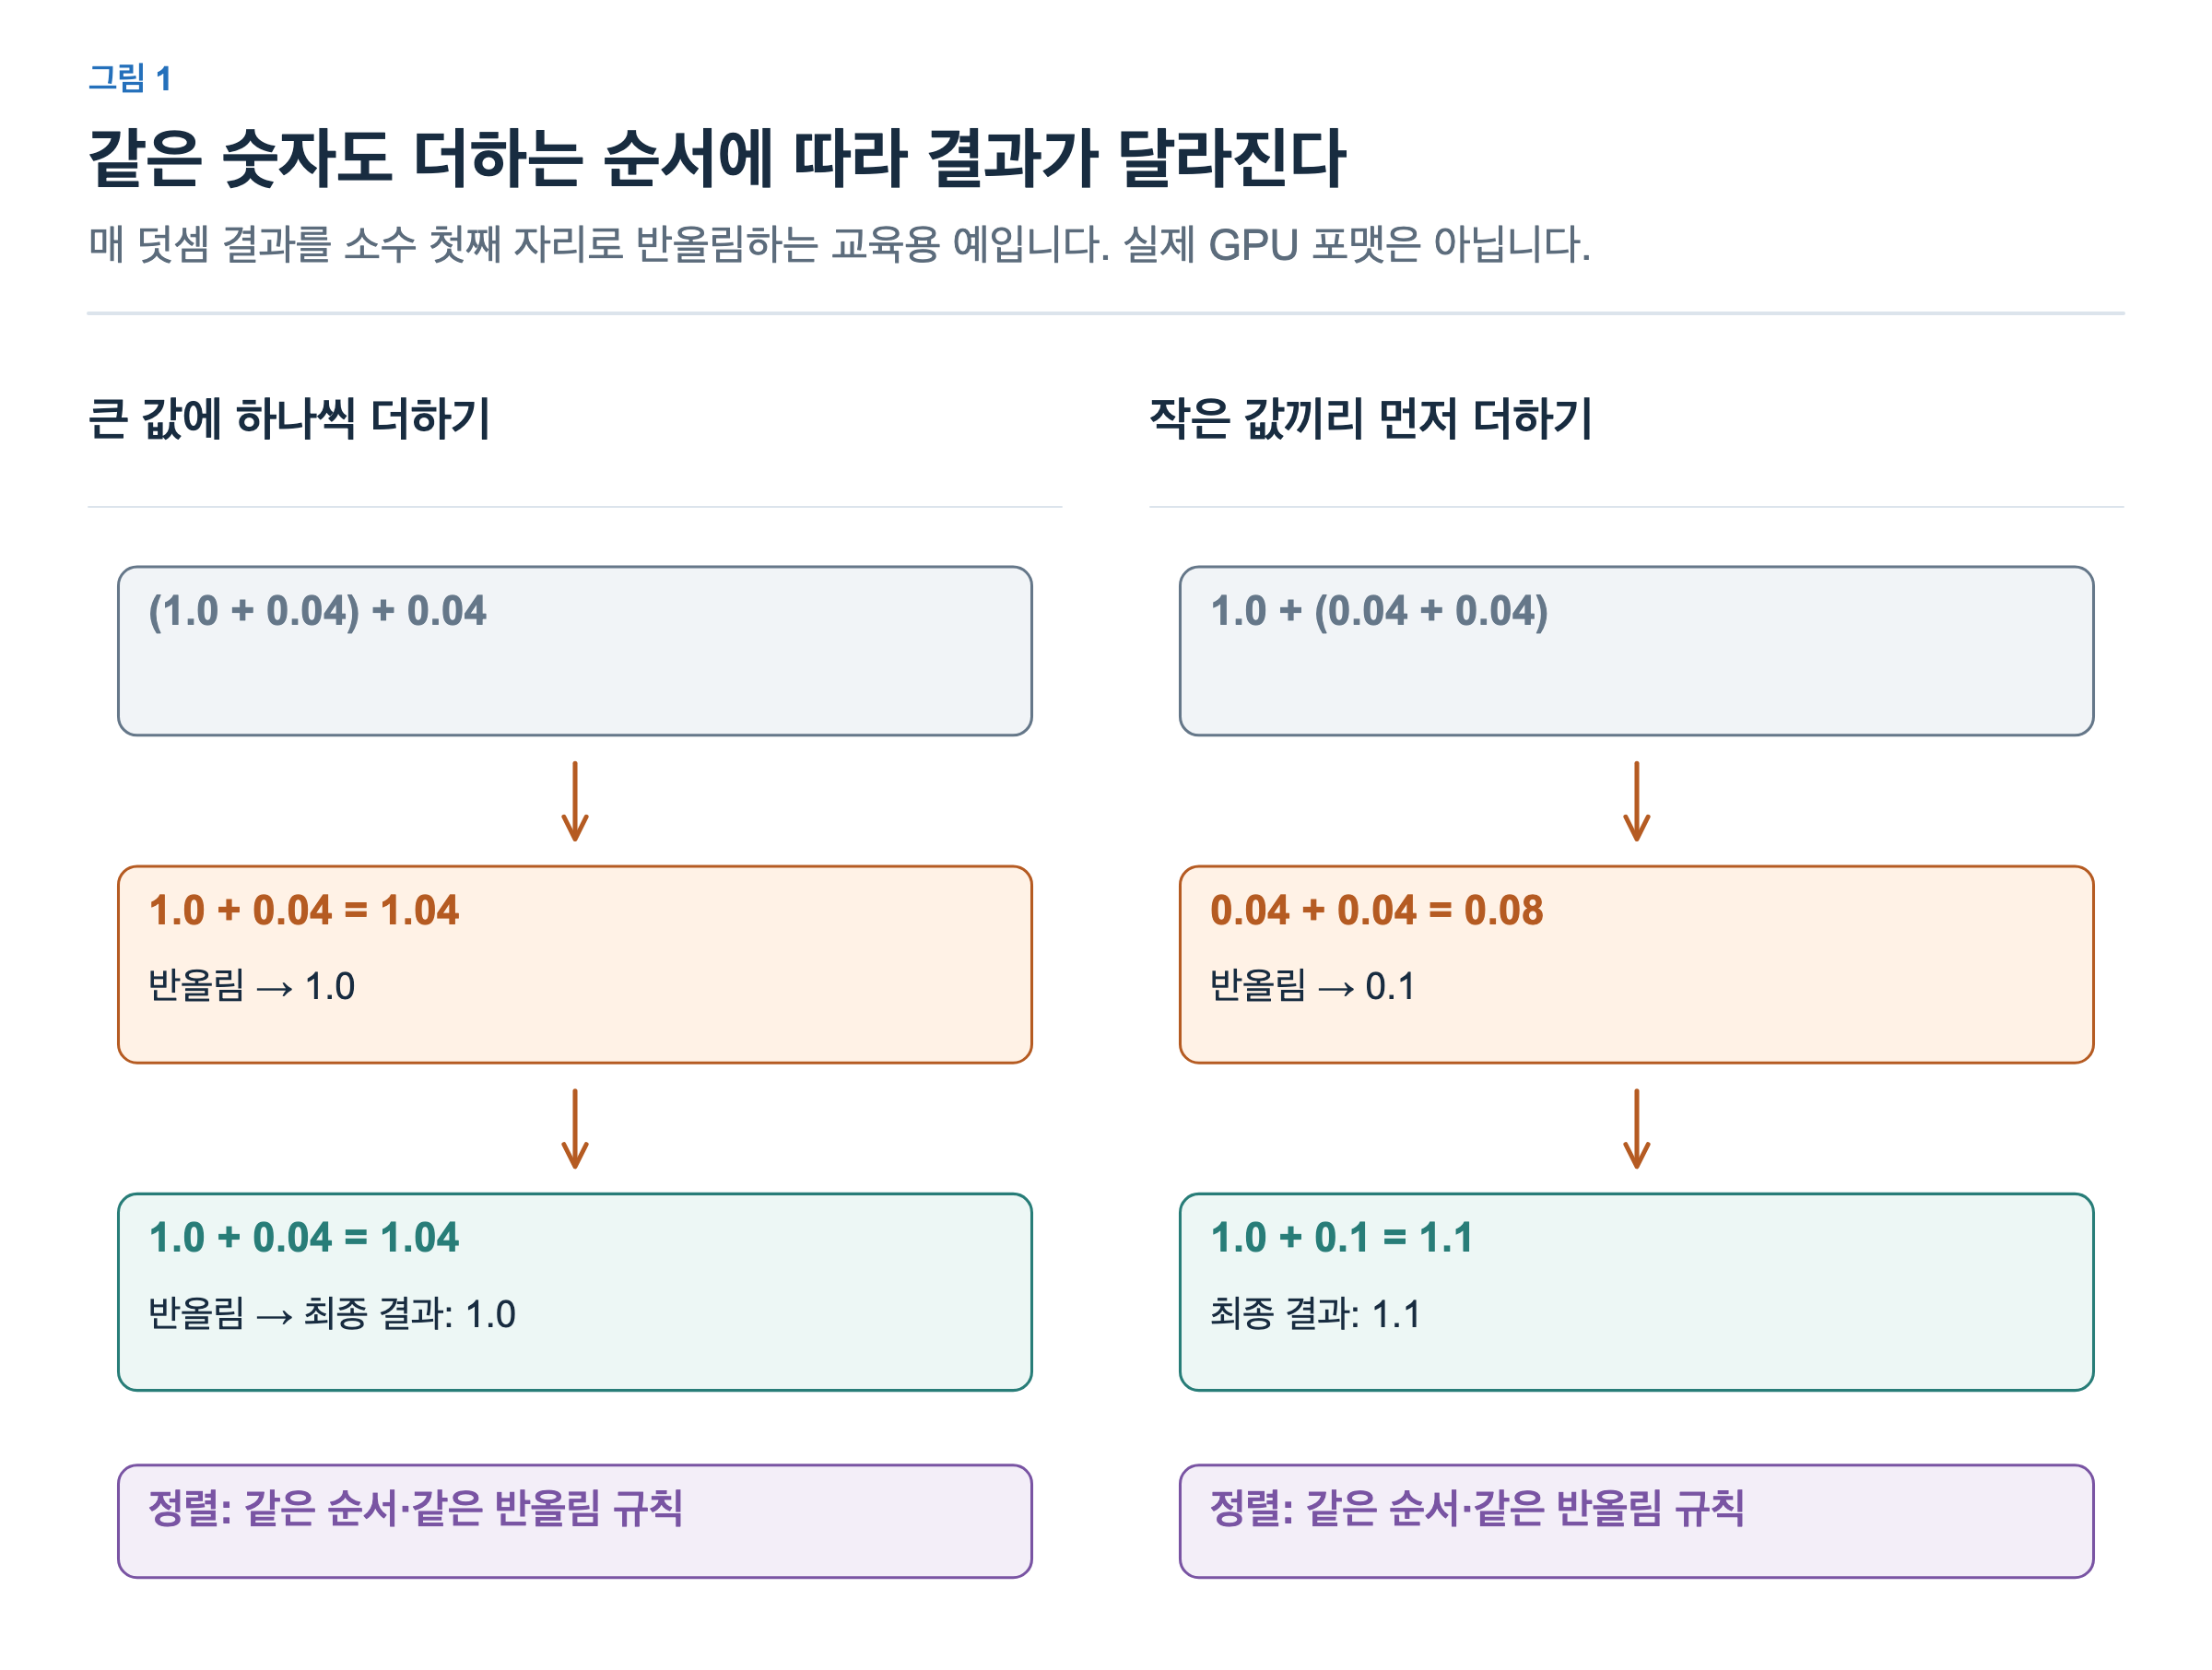
왼쪽에서는 1.0에 0.04를 더한 1.04가 다시 1.0이 됩니다. 한 번 더 더해도 같은 일이 일어나 최종 결과는 1.0입니다. 오른쪽에서는 작은 수끼리 먼저 더한 0.08을 0.1로 반올림하고, 여기에 1.0을 더하므로 1.1이 됩니다. 원래 수학식은 같지만 어느 중간 결과를 먼저 반올림했는지가 다릅니다.
LLM에서도 많은 수를 합치는 순서, 여러 연산을 합쳐 실행하는 방식, 배치 모양에 따른 커널 선택이 수치 차이를 만들 수 있습니다. 이 차이는 이후 계산을 거쳐 출력 점수인 logit과 토큰 확률에도 영향을 줍니다. Miles v0.1 §5.3
맞출 수 있는 계산부터 맞추기
그림 1의 두 결과를 맞추려면 같은 합산 순서와 반올림 규칙을 사용하면 됩니다. 실제 시스템에서도 같은 원리로 두 엔진의 계산 방식을 맞출 수 있습니다. Miles가 설명하는 true-on-policy alignment는 이 작업을 더 엄격하게 수행하는 모드입니다.
직관적으로 볼 부분은 세 가지입니다.
- 같은 연산을 같은 방식으로 실행합니다. Attention 커널과 나머지 연산의 구현을 맞춥니다. 빠르게 실행하려고 여러 연산을 합친 구현이 차이를 만들면 해당 최적화를 끄기도 합니다.
- 함께 묶인 요청 때문에 결과가 달라지지 않도록 합니다. 생성 배치와 학습 배치를 항상 같게 만들 수는 없으므로, 배치 모양이 바뀌어도 같은 입력의 계산 결과가 유지되는 batch-invariant 연산을 사용합니다.
- 완성된 기록을 비슷한 계산 형태로 다시 평가합니다. Miles는 생성이 끝난 시퀀스를 prefill로 다시 읽어 로그확률을 계산합니다. 한 토큰씩 생성할 때 얻은 값만 그대로 비교하는 대신, 양쪽의 점수 계산 형태를 맞추는 것입니다.
그렇다고 모든 모델과 설정에서 쉽게 일치시킬 수 있는 것은 아닙니다. Miles v0.1 논문은 지원 설정에서 선택된 토큰의 재평가 로그확률 차이가 0이라고 보고하지만, 전체 어휘의 모든 확률까지 같다는 보장은 구별합니다. 논문에 기록된 모델 범위도 dense Qwen3 0.6B·4B로 제한됩니다. 또한 Qwen3-4B 실험에서는 보상 곡선이 기준 실행과 비슷한 반면 rollout 시간이 늘었습니다. 정확한 정렬에는 지원 범위와 처리량의 비용이 따릅니다. Miles v0.1 §5.3
따라서 먼저 맞출 수 있는 조건을 맞추되, 실제 운영에서는 남는 차이를 다룰 방법도 필요합니다. 게다가 계산 방식을 맞추어도 가중치 버전이 달라지면 확률은 다시 달라집니다.
엔진 차이와 모델 버전 차이
같은 프롬프트 P와 앞선 토큰들을 입력하고, 같은 다음 토큰 x의 확률을 비교하겠습니다. Temperature나 후보 제한 같은 샘플링 조건도 맞췄다고 가정합니다. 아래 수치는 원인을 구별하기 위한 교육용 예입니다.
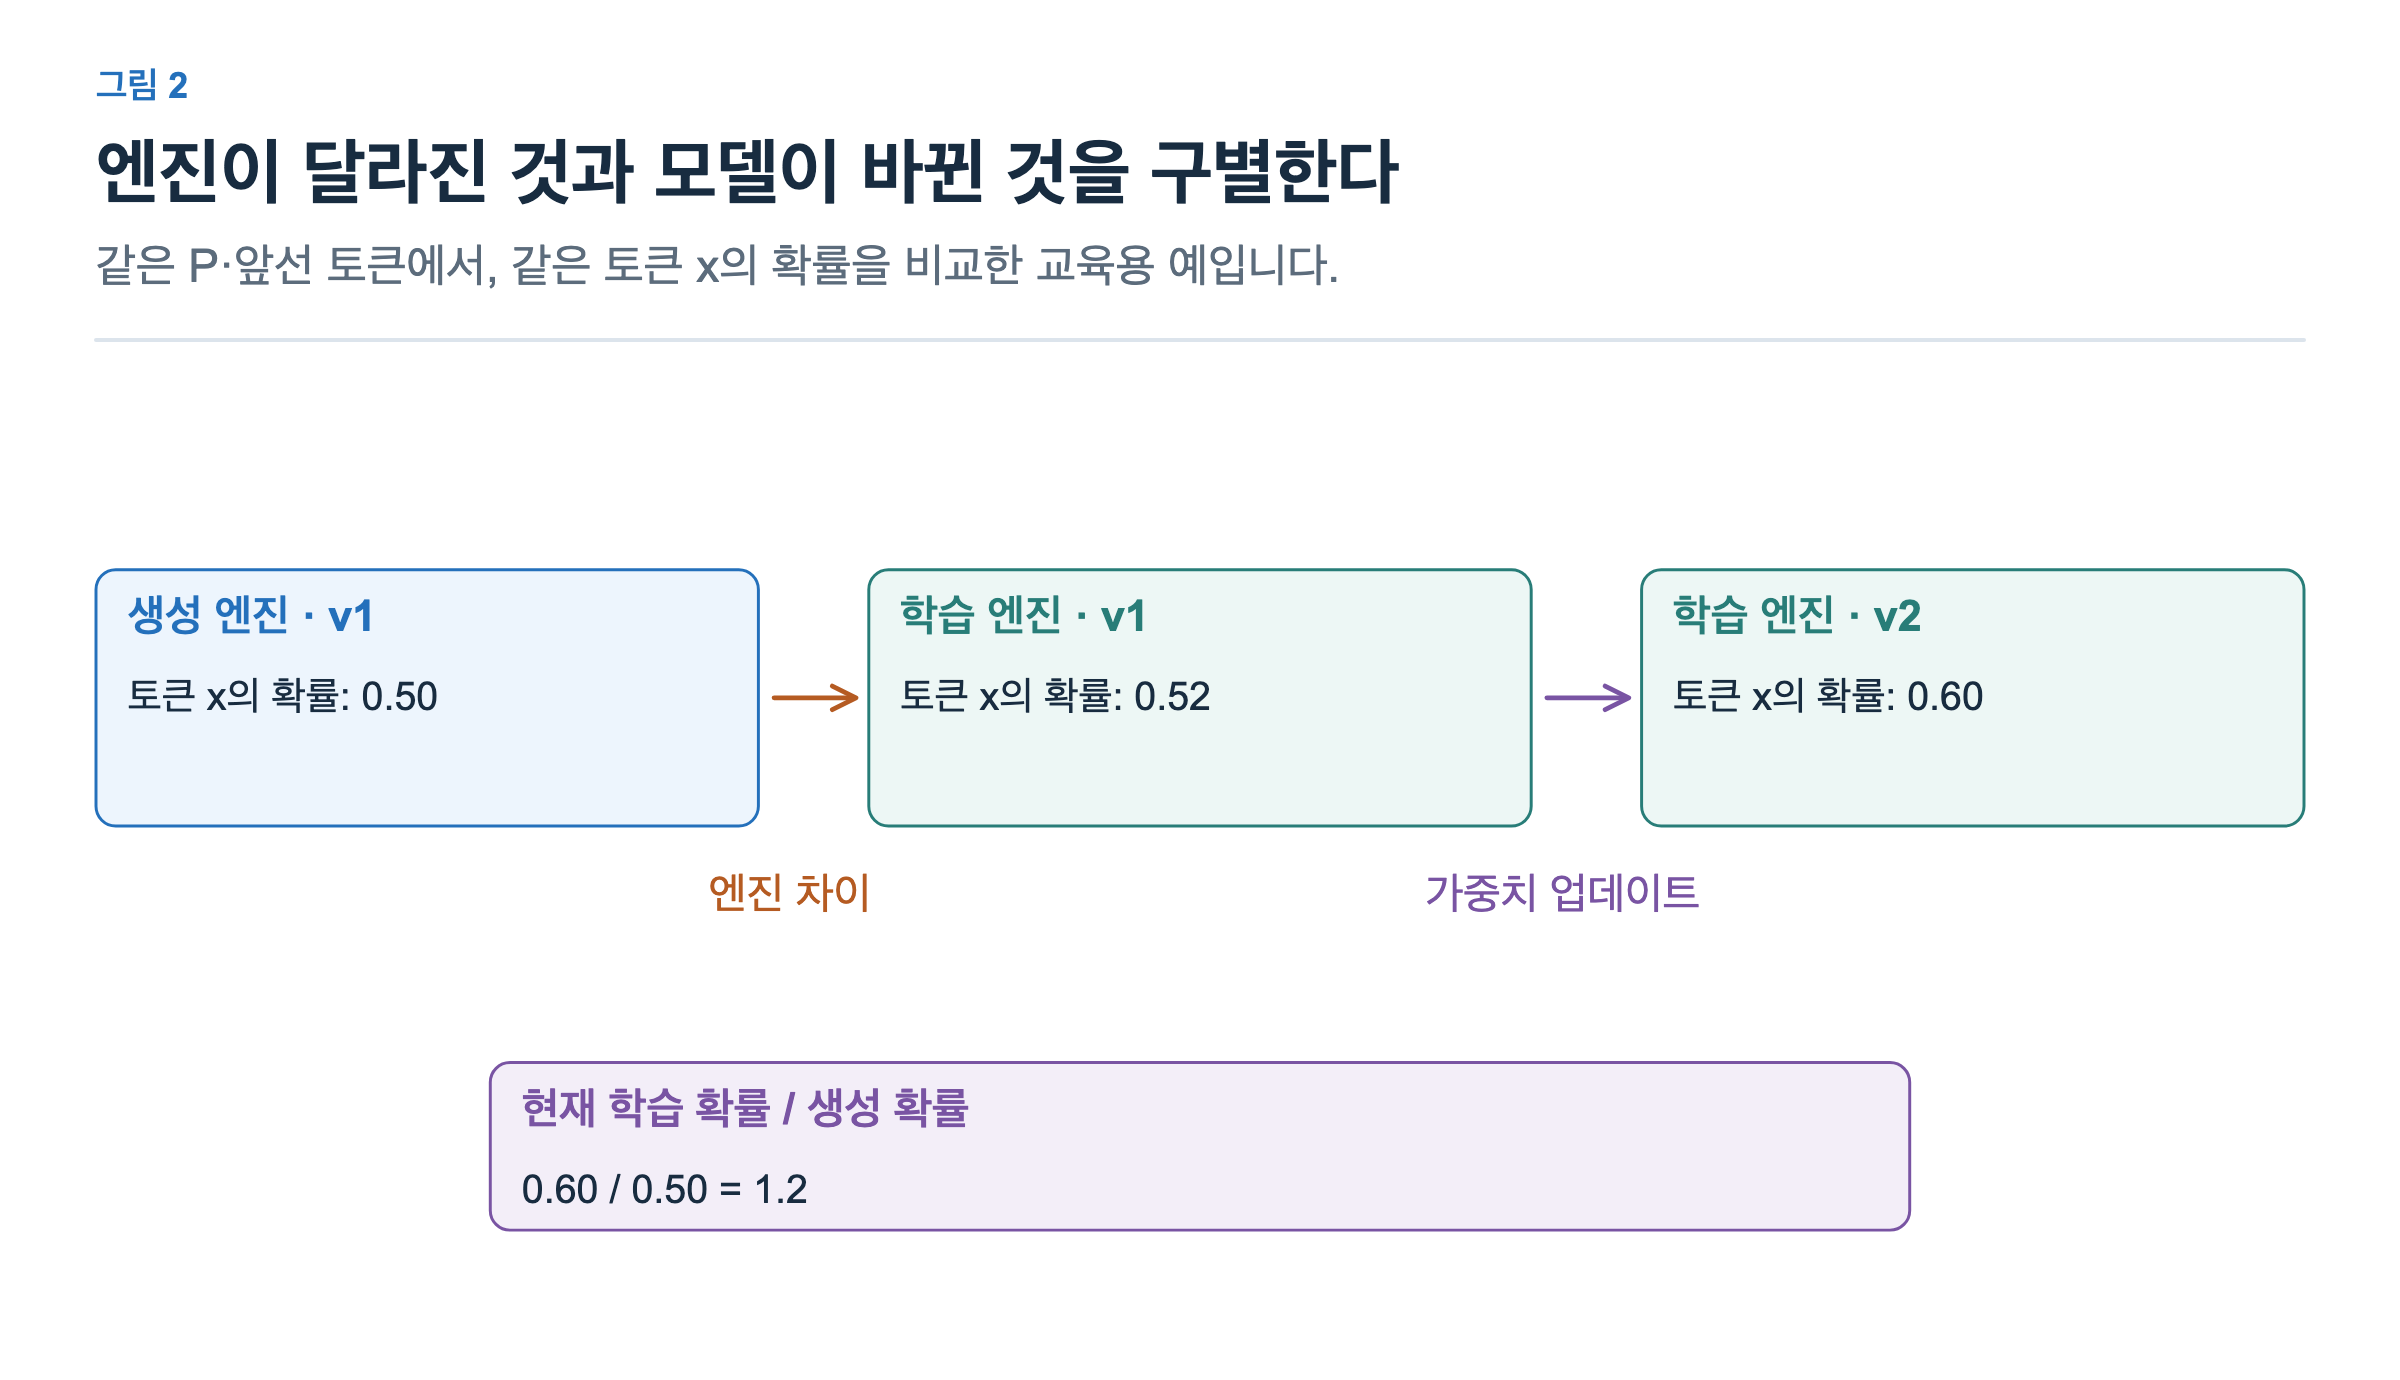
생성 엔진의 v1에서는 확률이 0.50인데, 같은 v1 가중치를 학습 엔진에서 실행하면 0.52입니다. 이것은 엔진의 계산 차이입니다. 이후 학습을 진행해 v2가 되면 같은 학습 엔진에서도 확률이 0.60으로 바뀝니다. 이것은 모델 가중치가 바뀐 효과입니다. 모든 토큰의 확률이 이처럼 증가한다는 뜻은 아닙니다.
현재 학습 확률 0.60을 생성 당시 확률 0.50으로 나누면 1.2입니다. 이 비교에는 두 차이가 함께 들어 있습니다. 계산을 완전히 정렬해 앞의 차이를 없애더라도, 이전 가중치로 생성한 데이터를 현재 모델이 학습할 때의 차이는 남습니다. 추론과 학습의 불일치를 TIM(train–inference mismatch)이라고 부르기도 하지만, 원인을 이해할 때는 두 경우를 나누는 편이 좋습니다.
확률을 기록할 때도 무엇을 저장했는지 확인해야 합니다. 실제로 토큰을 뽑는 확률과, 후보 제한 전의 모델 확률이나 생성 후 재평가한 확률은 자동으로 같은 값이 아닙니다. 아래에서는 중요도 보정의 원리를 설명하기 위해 실제 생성 확률을 q, 비교하려는 학습 측 확률을 p라고 하겠습니다.
확률비로 학습의 비중을 보정하기
같은 문맥에서 어떤 토큰의 확률이 생성 쪽에서는 0.50이고 학습 쪽에서는 0.60이라면, 생성 데이터에는 그 토큰이 학습 쪽 분포에 비해 덜 나타납니다. 확률비 0.60 / 0.50 = 1.2는 덜 나타난 선택의 학습 기여를 더 크게 반영하는 가중치로 이해할 수 있습니다. 반대로 비교 대상보다 자주 나타난 선택에는 작은 가중치를 줍니다. 이것이 중요도 샘플링, importance sampling(IS)의 기본 생각입니다.
여기서 높이거나 낮추는 것은 토큰의 생성 확률 자체가 아닙니다. 어드밴티지가 정한 학습 방향에 얼마나 비중을 줄지 조절합니다. 다만 큰 비율을 그대로 적용하면 일부 토큰이 업데이트에 지나치게 큰 영향을 줄 수 있습니다.
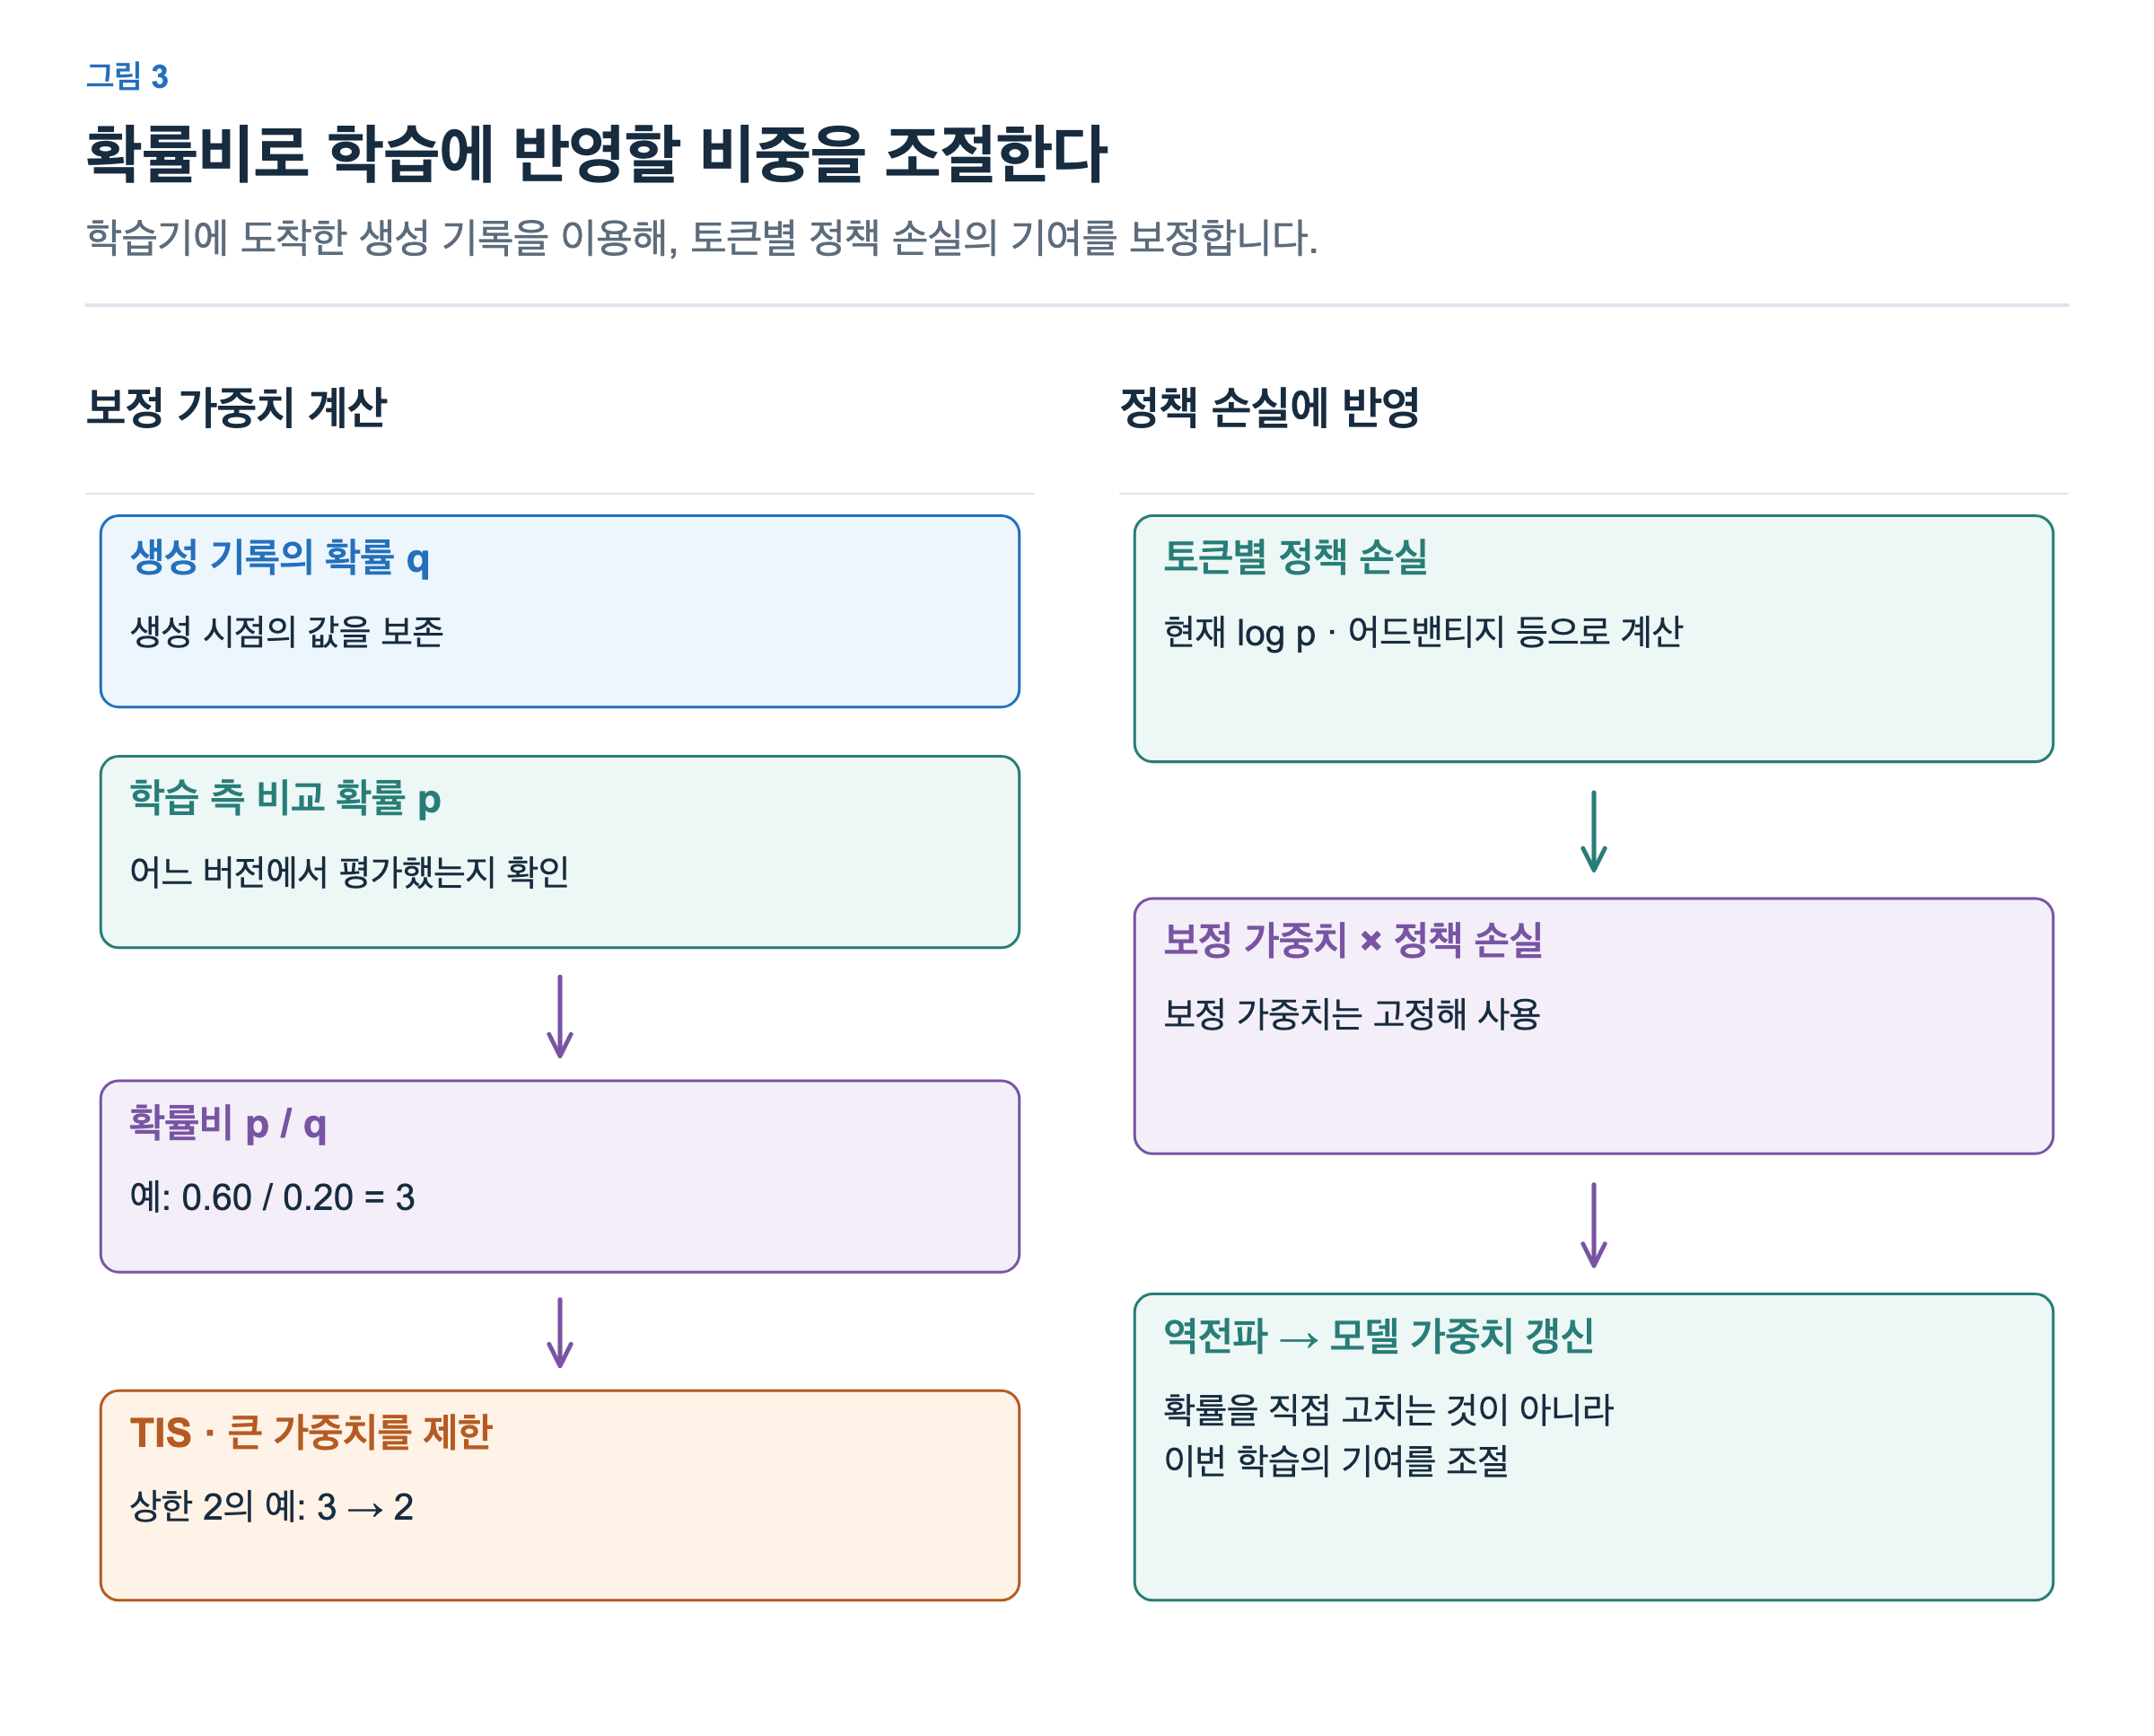
그림 3에서는 비율이 더 큰 경우를 보겠습니다. 생성 확률 0.20, 비교 확률 0.60이면 비율은 3입니다. TIS(Truncated Importance Sampling)는 이 가중치에 상한을 두며, 상한이 2라면 3 대신 2를 사용합니다. 큰 기여를 제한하는 대신 원래 비율을 그대로 적용한 추정과는 달라집니다. 토큰별 보정만으로 긴 응답 전체의 분포 차이를 완벽하게 없앤다는 의미도 아닙니다.
Miles의 TIS 경로는 이렇게 만든 보정 가중치를 고정해 토큰 정책 손실에 곱하고, 그 손실을 역전파합니다. 비교 확률은 보통 업데이트 전 학습 측 재평가에서 얻으며, 그 평가를 생략하는 설정에서는 현재 forward의 값을 고정해 사용합니다. 따라서 그림 2의 현재 확률 비율을 모든 구현에서 그대로 한 번 더 곱한다고 이해하면 안 됩니다. Miles v0.1.0 정책 손실, 보정 구현
2편의 PPO clipping과도 역할을 구별해야 합니다. PPO는 어드밴티지의 부호까지 고려해 정책을 유리한 방향으로 과도하게 바꾸는 것을 제한합니다. 여기서 본 TIS는 추가 보정 가중치의 큰 값을 자르는 방법입니다. 두 연산은 하나의 손실 구성 안에 함께 들어갈 수도 있습니다.
계산 정렬은 두 엔진의 차이가 생기는 원인을 줄이고, 확률비 보정은 남은 차이를 고려해 데이터가 학습에 기여하는 비중을 조절합니다. 다음 글에서는 생성과 학습을 동시에 진행할 때 모델 버전 차이가 어떻게 커지고, 오래된 경험을 어떻게 관리하는지 살펴보겠습니다.