RL · 2026-09-25
생성 기록을 학습으로 이어가기: TITO와 R3
TITO로 실제 토큰 ID를 보존하고, R3로 생성 당시 선택한 MoE 전문가를 학습에서도 사용하는 과정을 살펴봅니다.
앞 글에서는 추론 엔진이 만든 경험을 학습 엔진으로 보내는 흐름을 보았습니다. 학습기는 그 기록을 다시 계산해 모델을 업데이트합니다. 이때 사람이 읽는 응답만 같으면 원래 경험을 그대로 학습한다고 볼 수 있을까요?
문자열이 같아도 토큰 ID가 다를 수 있고, 같은 토큰을 넣어도 MoE의 전문가 선택이 달라질 수 있습니다. 이 글에서는 생성 때의 기록을 학습으로 이어주는 두 방법을 살펴봅니다. TITO는 실제 토큰 ID를 보존하고, R3는 생성 때 선택한 전문가 정보를 전달해 학습에서도 그 경로를 사용합니다.
문자열로 되돌리면 토큰 경계가 사라진다
모델은 문자열을 한 번에 생성하지 않고 토큰 ID를 하나씩 선택합니다. 설명을 위해 토큰 101은 “A”, 202는 “B”, 303은 “AB”라는 문자열에 대응한다고 하겠습니다. 실제 토크나이저에서 측정한 값이 아닌 교육용 예입니다.
모델이 101, 202를 차례로 생성했다면 사람이 읽는 결과는 “AB”입니다. 그런데 이 문자열을 다시 토큰화할 때 토크나이저가 “AB”를 하나의 토큰 303으로 표현할 수 있습니다. 보이는 글자는 같지만 모델이 실제로 선택했던 두 토큰은 보존되지 않았습니다. 문자열에는 원래 어느 경계에서 토큰을 나눴는지가 남아 있지 않기 때문입니다.
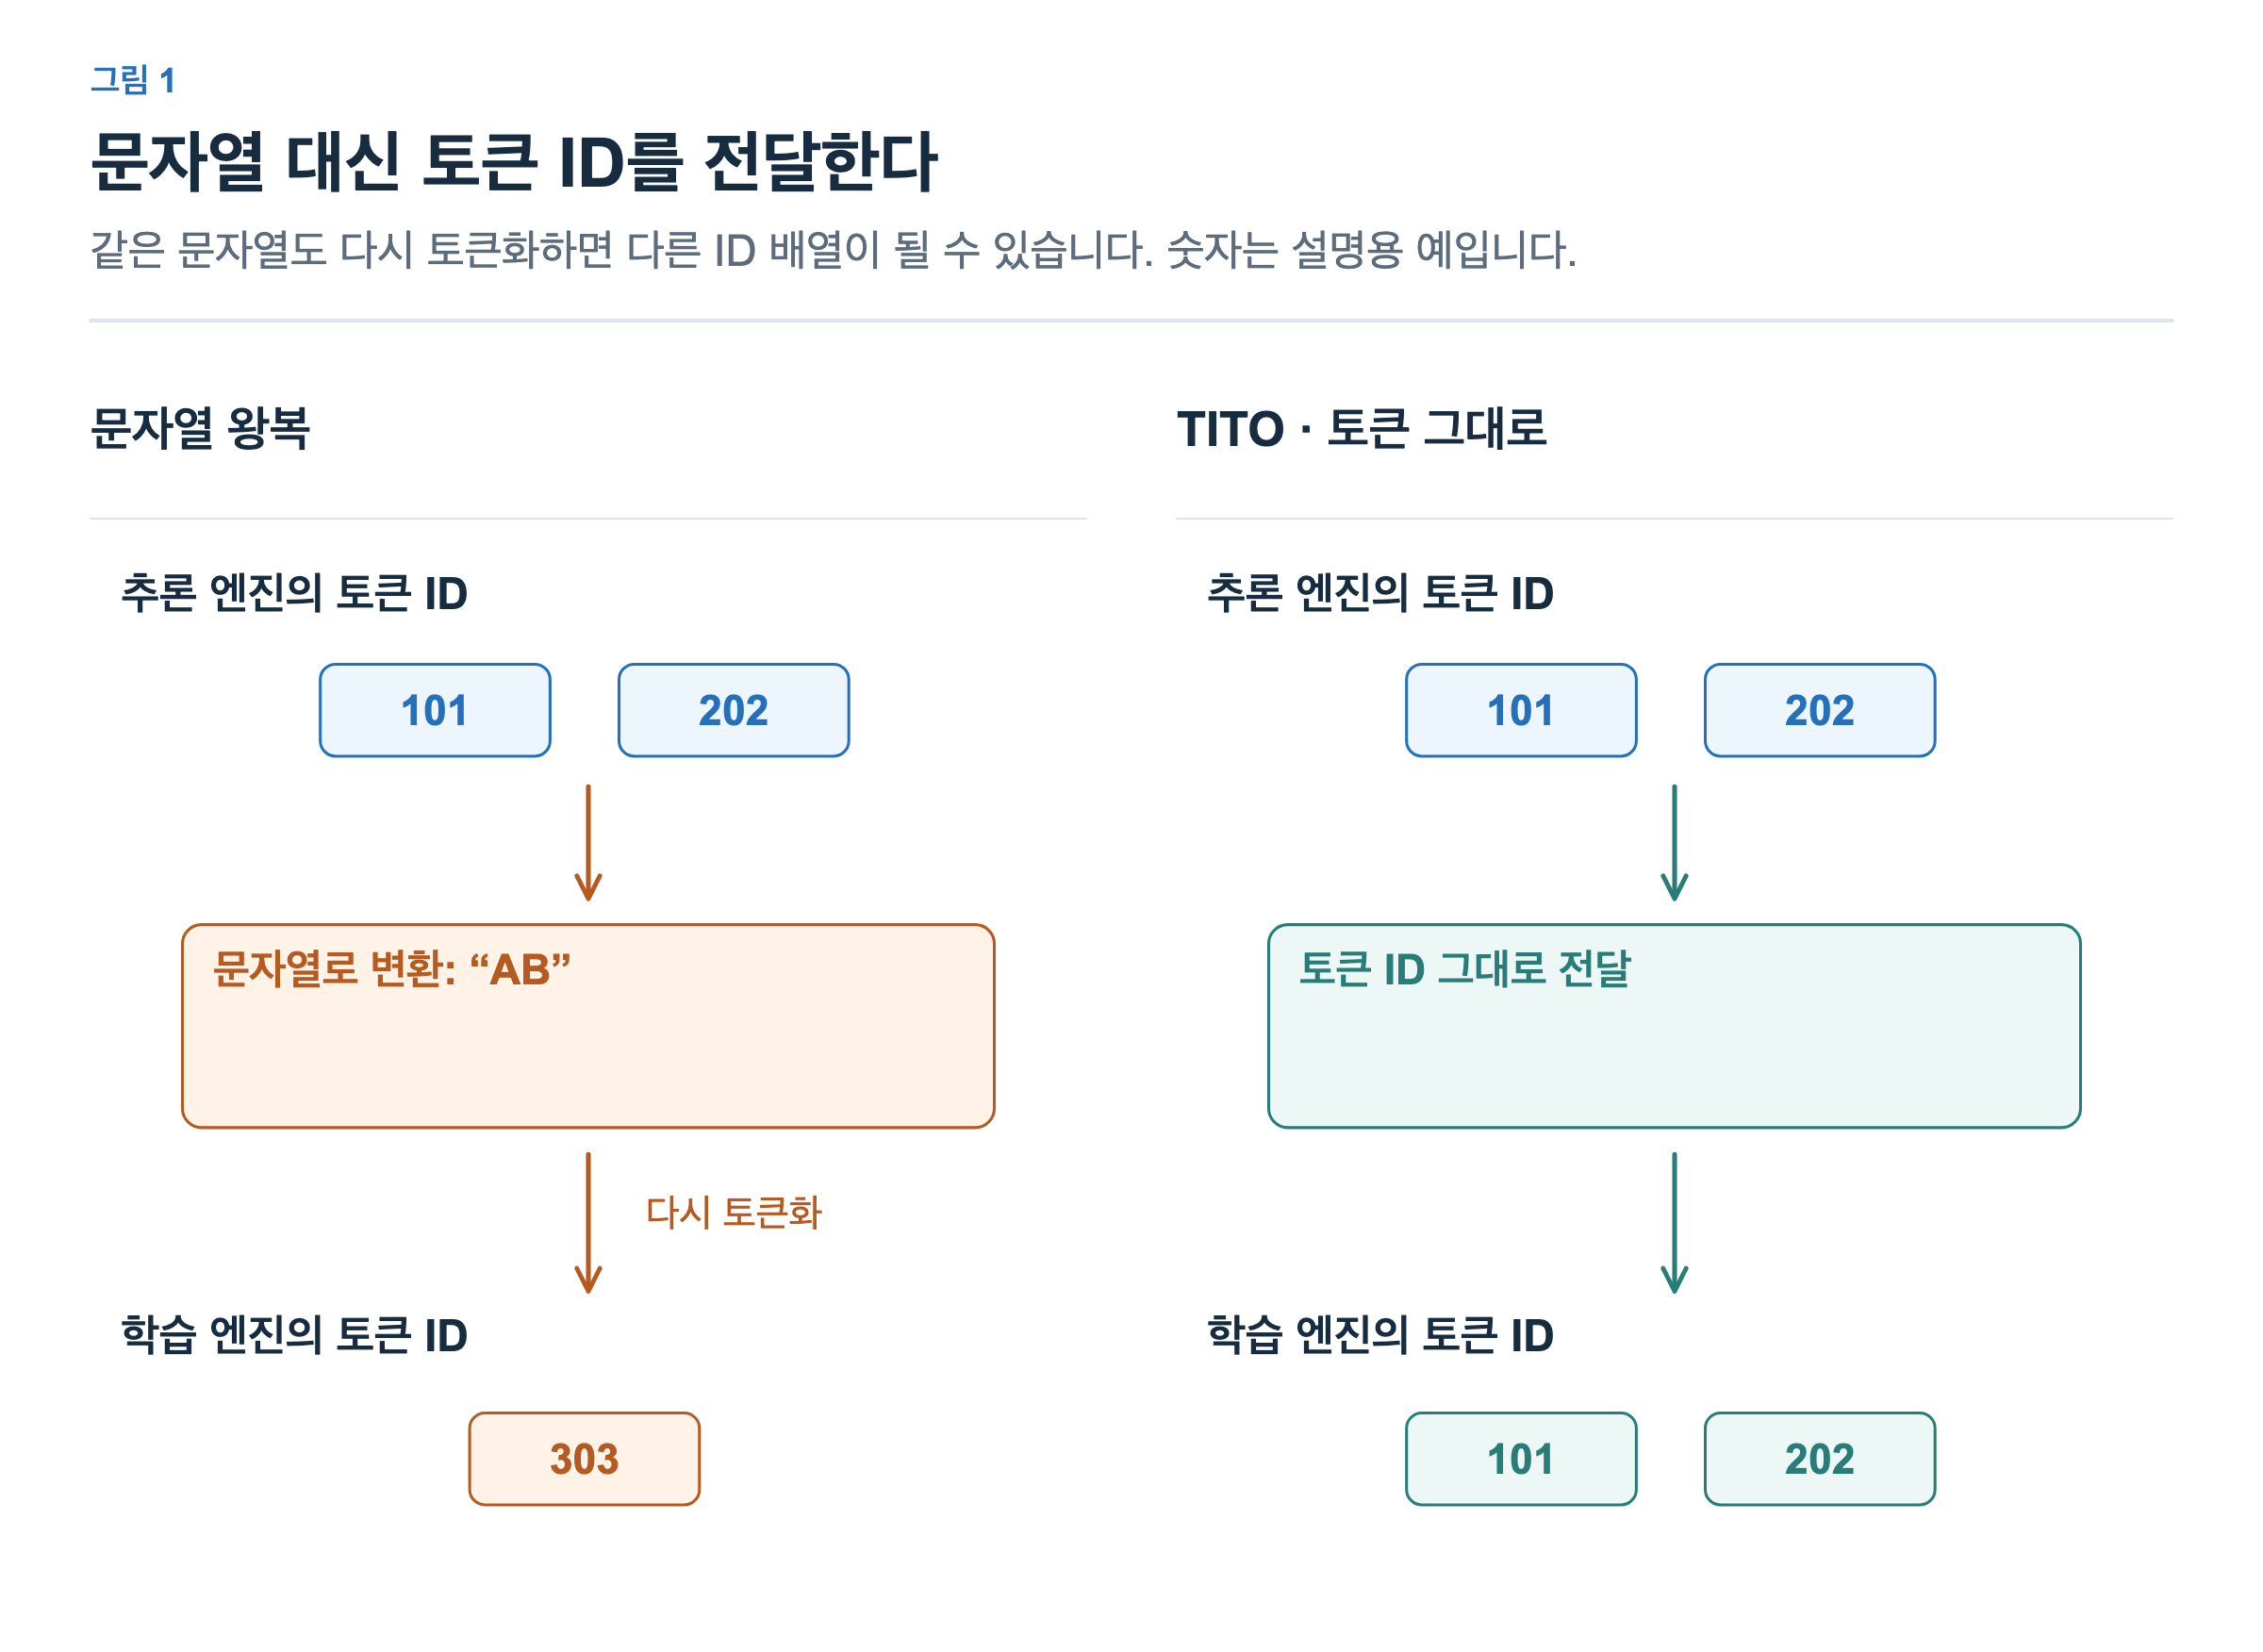
학습기가 303을 사용하면 원래 생성했던 101과 202의 선택을 학습하는 것이 아닙니다. 저장해둔 두 토큰의 생성 로그확률도 새 토큰 하나와 그대로 짝지을 수 없습니다. 이전 생성 결과를 다음 호출의 입력으로 사용한다면, 그 입력의 토큰열까지 달라집니다.
재토큰화가 언제나 다른 ID를 만드는 것은 아닙니다. 중요한 것은 문자열이 같다는 사실만으로 원래 토큰열이 복원됐다고 보장할 수 없다는 점입니다. 메시지 템플릿 적용이나 도구 호출 내용의 재구성이 더해지면 입력 문자열 자체도 달라질 수 있습니다.
TITO는 실제 토큰 ID를 전달한다
TITO(Token-In, Token-Out)는 입력과 생성 결과를 토큰 ID 기준으로 이어 관리하는 접근입니다. 그림 1의 오른쪽처럼 학습에 필요한 기록은 문자열에서 다시 만들지 않고, 추론 엔진이 실제로 사용하고 생성한 ID를 그대로 전달합니다. 응답을 사용자에게 보여줄 문자열은 별도로 만들 수 있습니다.
멀티턴에서도 같은 원리를 적용합니다. 기존 입력과 응답의 토큰 기록을 보존하고, 새 사용자 메시지나 도구 결과는 필요한 메시지 구분 토큰과 함께 토큰화해 뒤에 붙입니다. 이미 생성한 응답을 문자열에서 다시 복원할 필요가 없습니다. 이때 해당 토큰의 생성 로그확률도 같은 순서로 연결해 전달합니다. Miles v0.1 §2.4, Miles TITO 구현
앞서 정책 손실에서는 생성한 토큰이 주어진 문맥에서 나올 확률을 계산했습니다. TITO가 보존하는 것은 바로 그 계산의 대상인 실제 입력 토큰과 선택된 토큰입니다.
MoE에서는 전문가 선택도 기록한다
MoE 층은 여러 전문가 신경망 중 일부를 골라 계산합니다. Router는 전문가를 고르는 모듈이고, expert는 선택되어 실행되는 계산 모듈입니다. 여기서 전문가는 별도로 호출하는 챗봇이 아니라 모델 내부의 일부입니다.
추론 엔진이 한 토큰을 처리하며 E1과 E2를 선택했다고 하겠습니다. 같은 입력과 가중치라도 수치 계산의 작은 차이로 학습 엔진에서는 E1과 E3가 선택될 수 있습니다. 그러면 생성 때 사용했던 전문가 경로와 다른 경로로 학습 계산을 수행하게 됩니다.
R3(Rollout Routing Replay)는 생성 때 선택한 전문가 ID를 기록하고, 학습에서도 그 선택을 다시 사용하는 방법입니다. 그림 2에서는 [1, 2]를 경험과 함께 전달해 학습에서도 E1과 E2를 실행합니다. R3 논문 §3–4
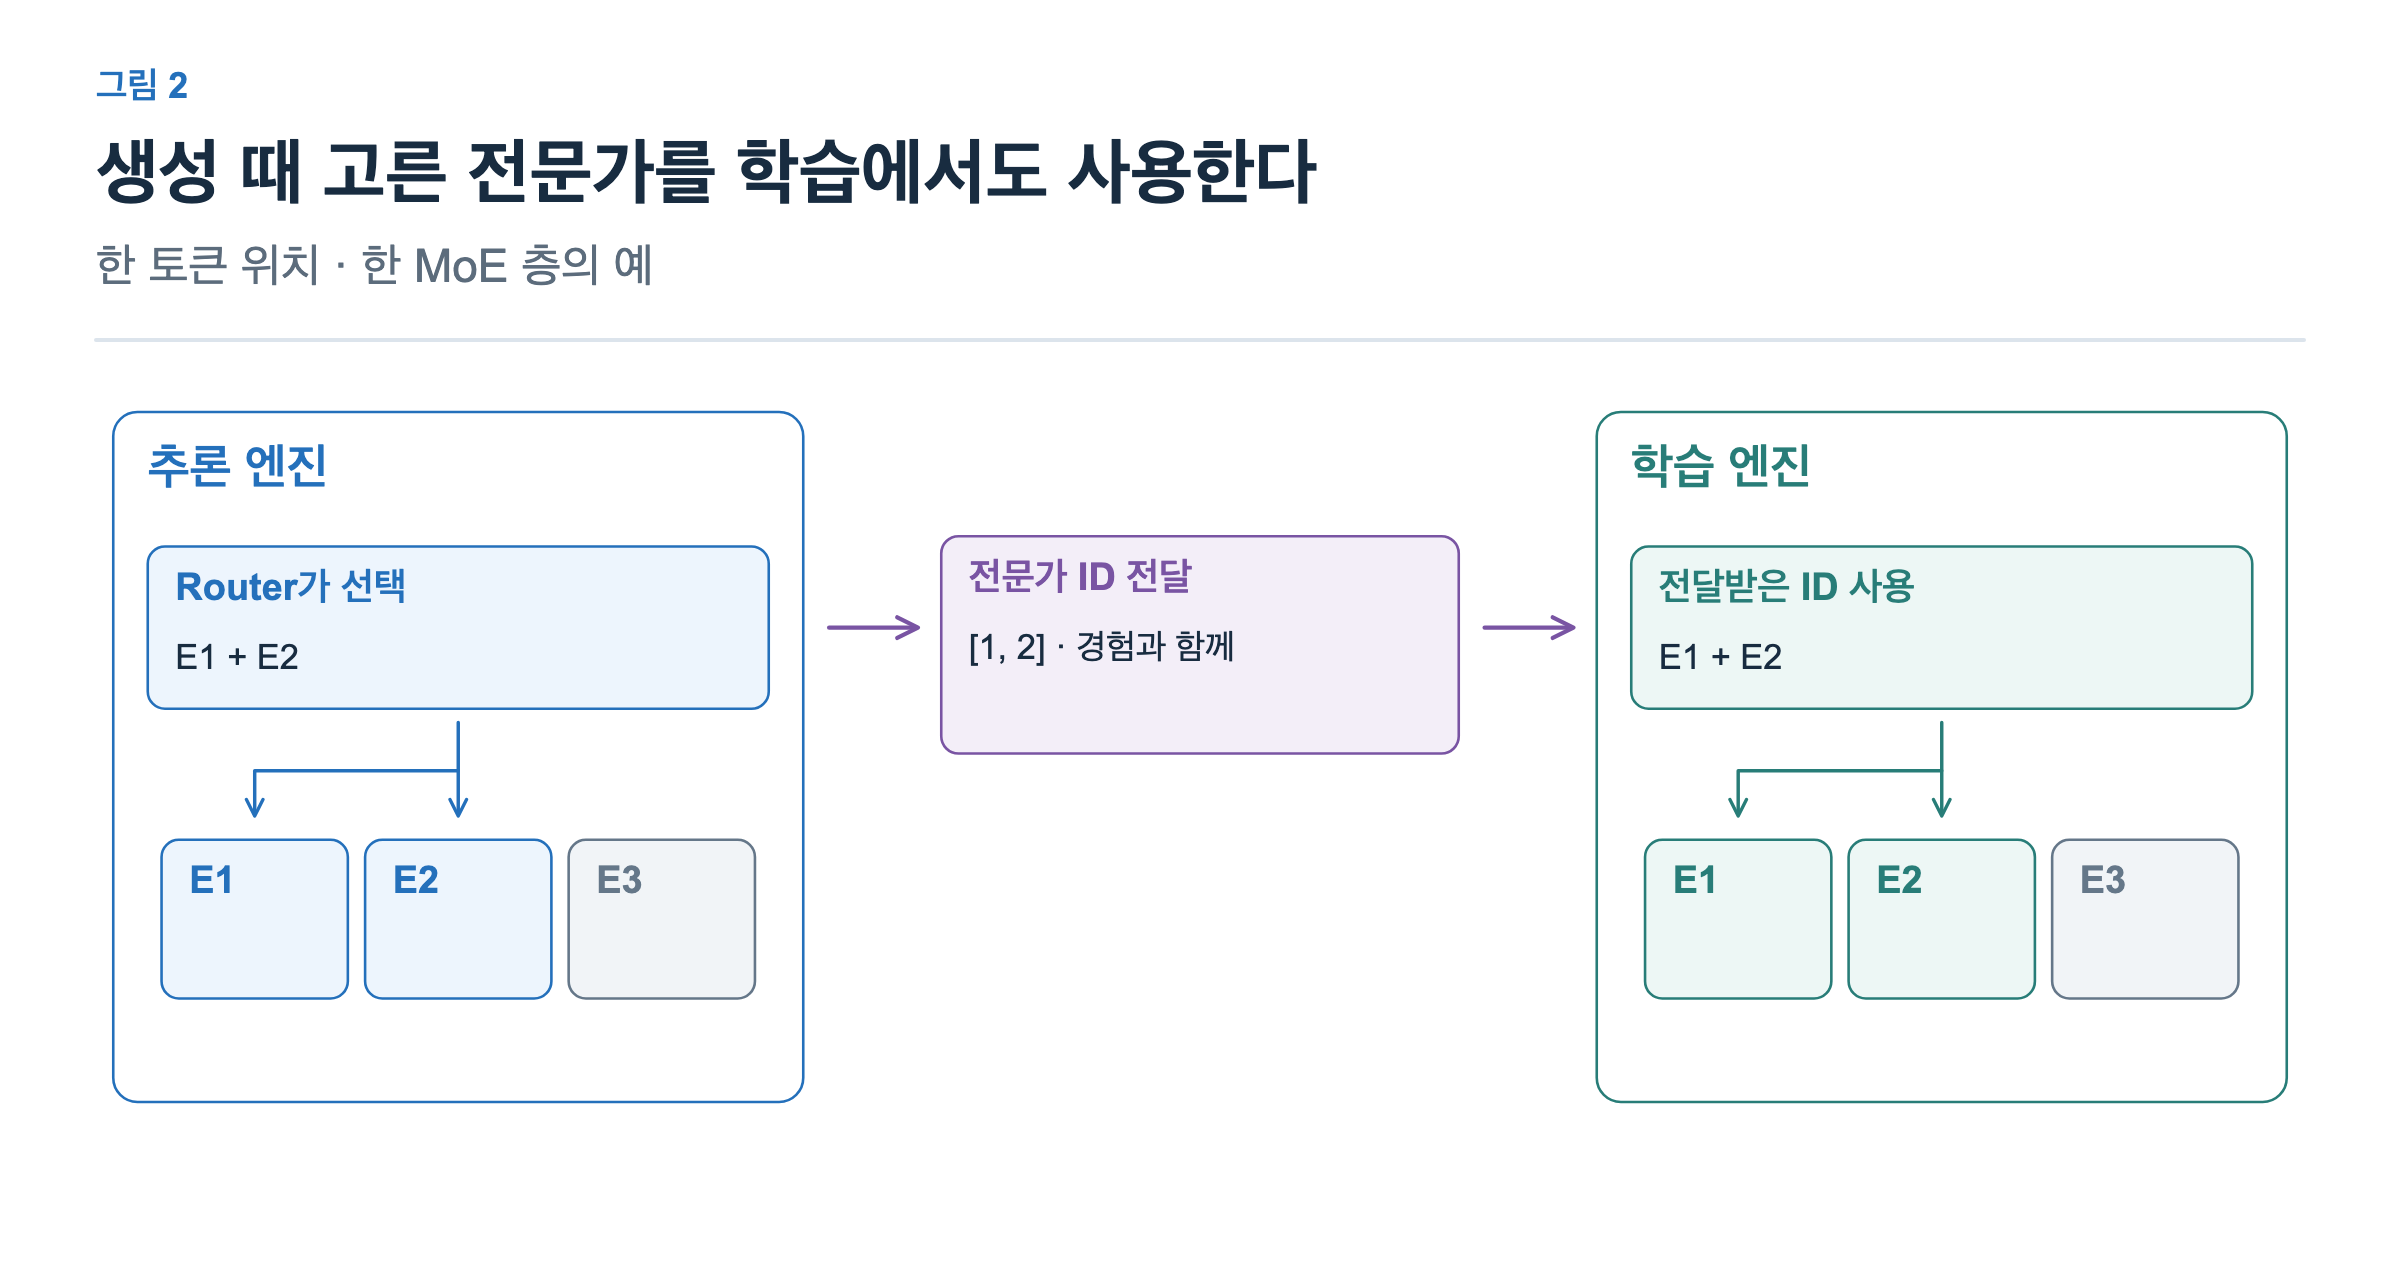
실제 기록은 응답 전체에 전문가 목록 하나를 붙이는 방식이 아닙니다. 토큰 위치와 MoE 층마다 선택이 달라질 수 있으므로, 각각의 위치와 층에 맞는 ID를 보관해 전달해야 합니다.
같은 전문가에서 현재 가중치로 학습한다
R3가 재사용하는 것은 어느 전문가를 선택했는가입니다. 생성 때의 전문가 출력값을 복사해서 학습 계산을 끝내는 것은 아닙니다.
학습 엔진은 전달받은 E1과 E2를 현재 가중치로 실행합니다. 두 출력을 섞는 router의 결합 가중치도 현재 계산에서 구하고, 그 결과로 손실과 역전파를 수행합니다. 전문가 선택을 재현하면서도 전문가와 router의 가중치는 학습할 수 있습니다. R3 §4.1
6편의 경험 전달 경로에 연결하면, TITO는 실제 토큰 ID를 전달하고 R3는 토큰·층별 전문가 ID를 함께 전달합니다. 학습 엔진은 이 기록을 받아 생성 때의 입력과 전문가 선택을 재현합니다.