RL · 2026-09-25
LLM RL 시스템은 어떻게 연결되는가
경험을 생성해 학습기로 보내고, 새 가중치를 추론기로 돌려보내는 두 흐름을 따라 LLM RL 시스템의 역할과 데이터, GPU 배치를 살펴봅니다.
앞의 글들에서는 보상과 교사 확률에서 학습 신호를 얻고, 손실과 역전파로 모델을 바꾸는 방법을 살펴봤습니다. 직전 글에서는 RL과 OPD를 전체 학습 전략으로 연결했습니다. 이제 그 전략에 필요한 생성과 평가, 업데이트가 실제 시스템의 어디에서 실행되는지 연결해보겠습니다.
LLM RL 시스템에는 두 방향의 이동이 있습니다. 생성한 경험은 학습기로 이동하고, 학습한 가중치는 추론기로 돌아갑니다. 먼저 전체 지도를 보고 질문 하나가 이 경로를 통과하는 과정을 따라가겠습니다. 이어서 학습기에 보내야 할 정보와 준비 조건을 살펴보고, 마지막에는 두 엔진을 GPU에 배치하는 방법을 구별하겠습니다.
경험과 가중치가 오가는 두 방향
추론 엔진은 모델을 실행해 다음 토큰을 생성합니다. 학습 엔진은 기록된 토큰을 입력으로 손실을 계산하고, 역전파와 옵티마이저를 통해 가중치를 바꿉니다. 이때 생성하고 학습하는 대상인 정책 모델을 actor라고 부릅니다. 여기서 actor는 critic이나 교사가 아니라, 우리가 생성 능력을 바꾸려는 모델입니다.
추론과 학습은 같은 정책을 서로 다른 실행 상태로 다룹니다. 추론 쪽은 빠른 생성에 맞는 배치와 캐시를 사용하고, 학습 쪽은 가중치 외에도 그래디언트와 옵티마이저 상태 등을 관리합니다. 그림 1은 Miles v0.1 논문이 제시한 생성과 학습의 연결 구조입니다. 하나의 정책을 학습한다는 사실과, 두 엔진의 가중치 버전이나 계산 결과가 언제나 같다는 주장은 구별해야 합니다.
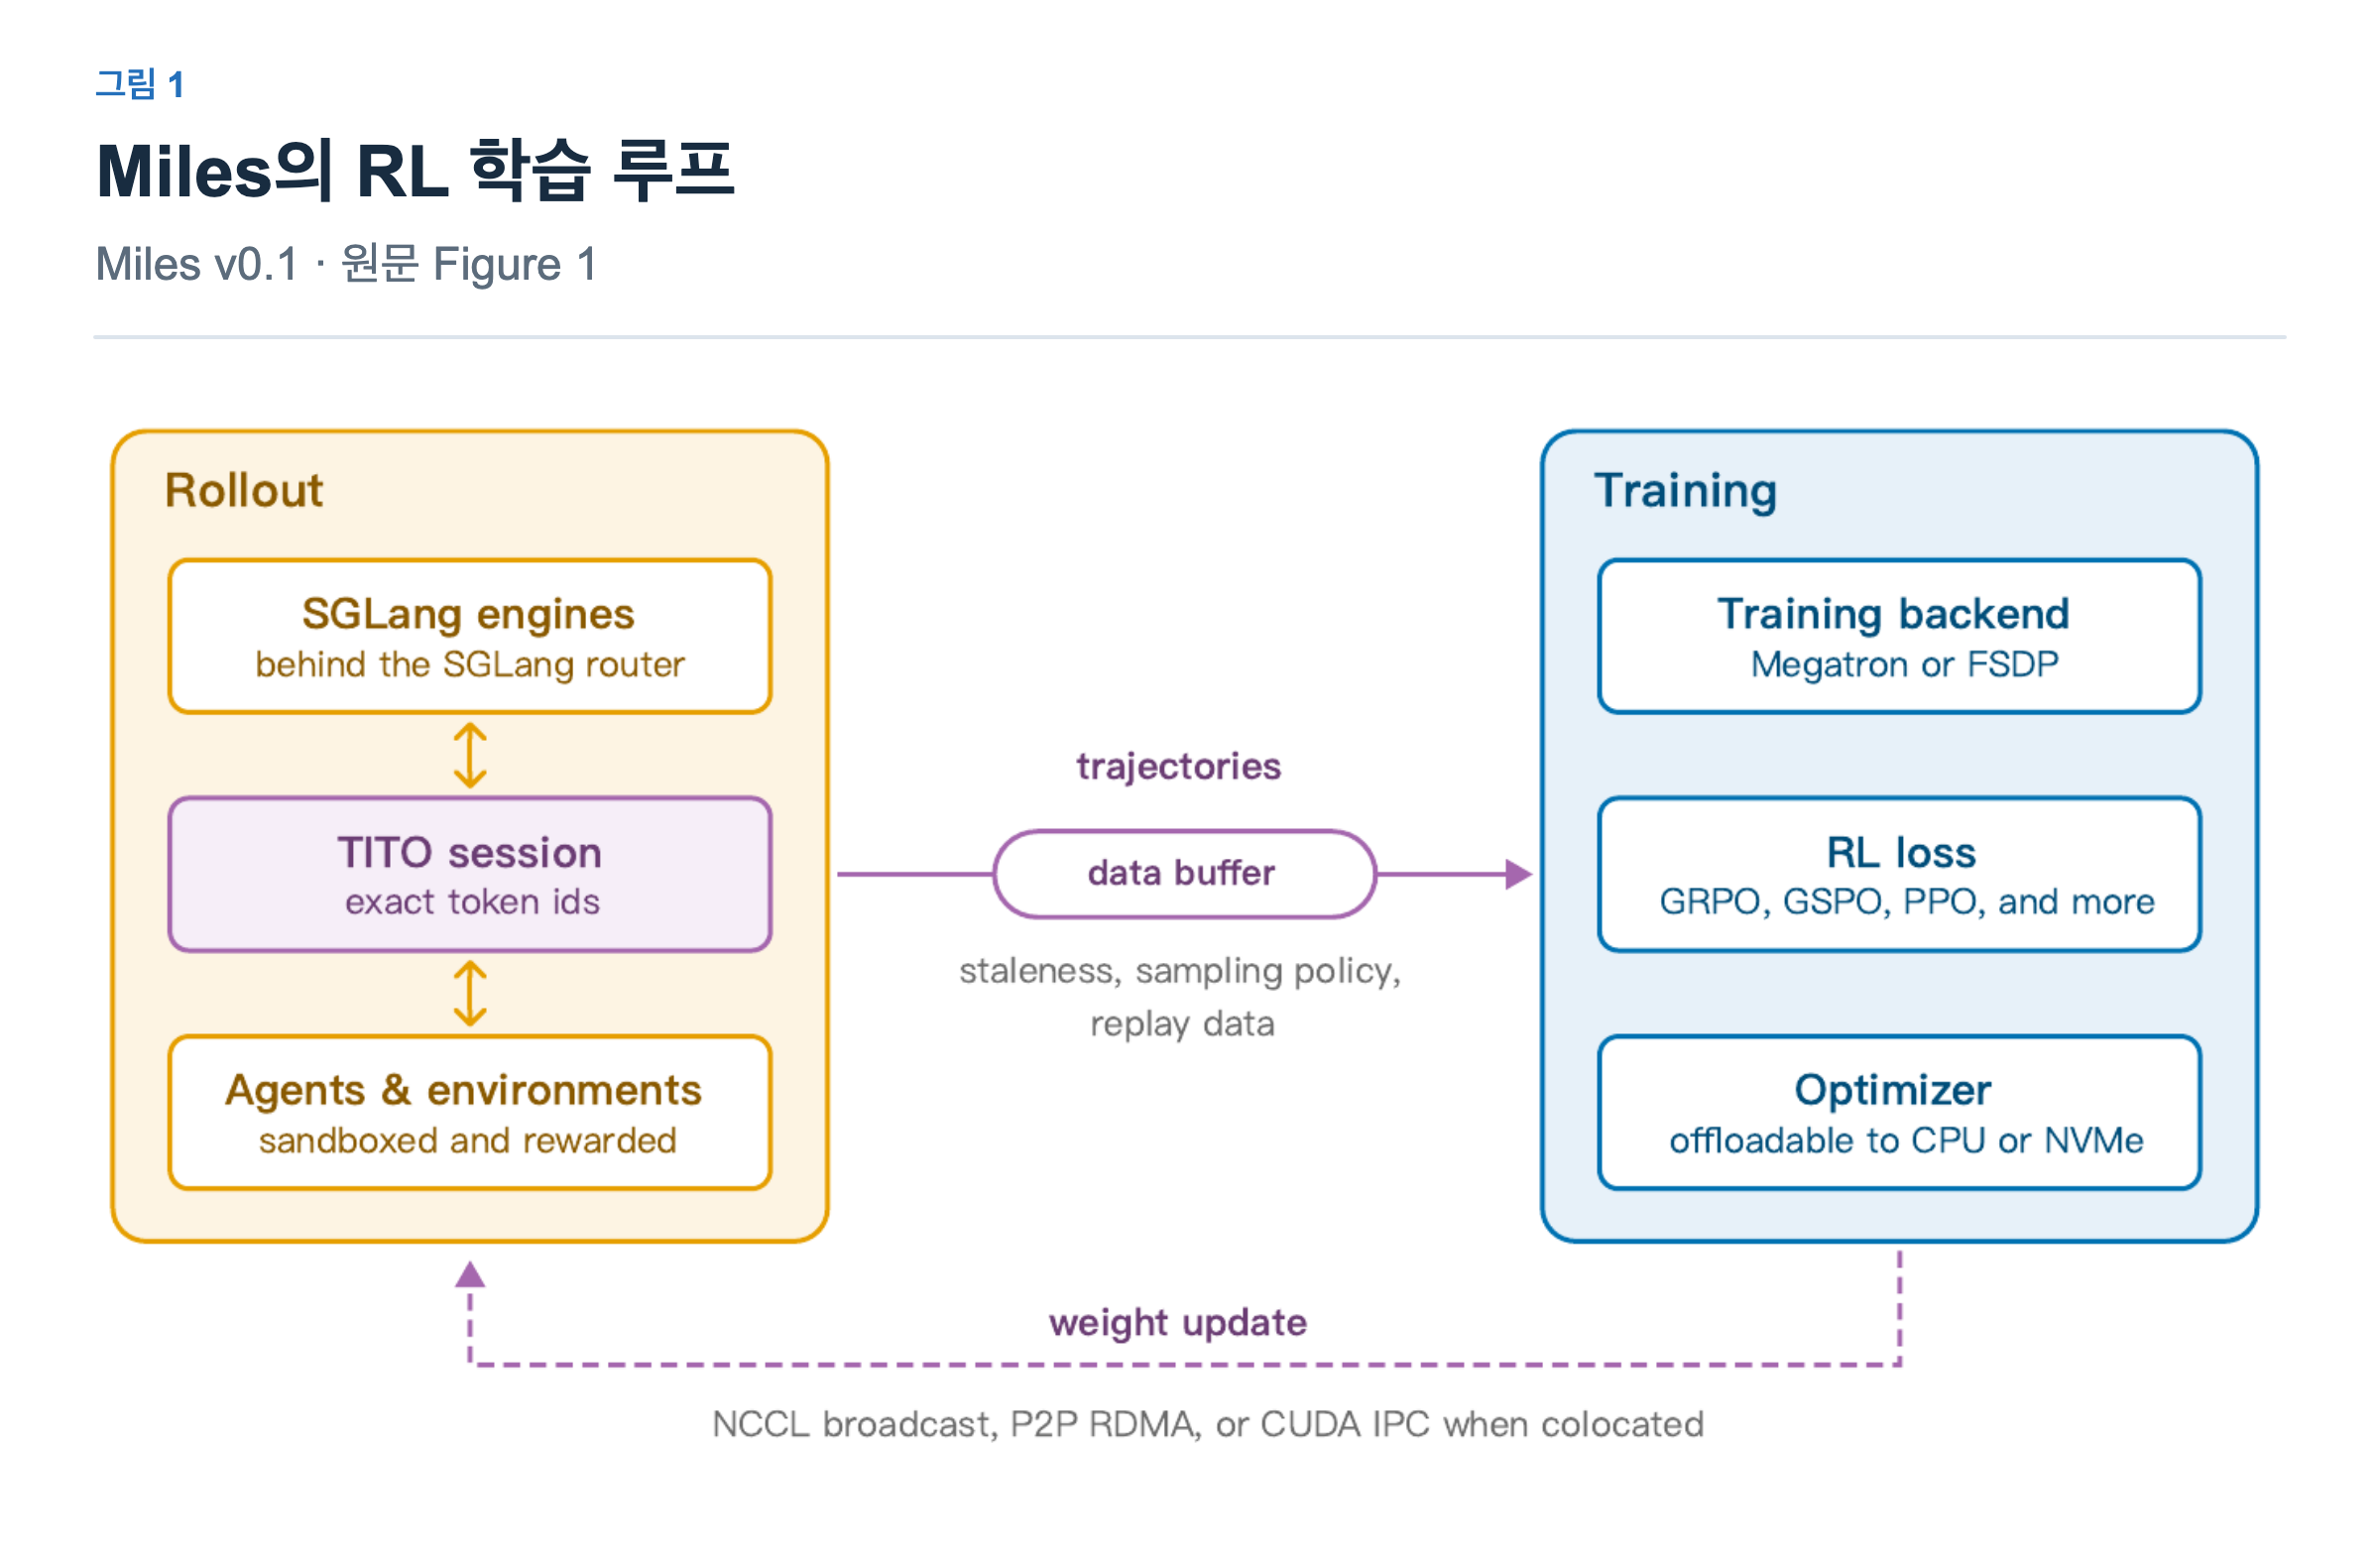
출처: RadixArk, Miles v0.1: Production-Level Post-Training, Figure 1(논문 2쪽). 원문의 도식과 영어 라벨을 그대로 인용했습니다. 그림을 누르면 큰 이미지로 볼 수 있습니다.
그림에서 먼저 네 가지를 짚어보겠습니다. 왼쪽 SGLang engines가 추론 엔진이고, 오른쪽 Training backend가 학습 엔진입니다. 가운데 trajectories → data buffer → Training이 경험 전달 경로이고, 아래 점선 weight update가 학습한 가중치를 추론 쪽으로 돌려보내는 경로입니다. TITO와 버퍼의 데이터 선택, 가중치 전달 방식은 이후 글에서 더 자세히 다룹니다.
이 구성이 모든 구현의 필수 형태는 아닙니다. 예를 들어 NeMo RL의 Megatron 생성 경로는 정책 worker 내부에 통합됩니다. 이 글에서는 역할과 데이터 흐름을 먼저 나누어 읽되, 이를 곧바로 프로세스 개수로 해석하지 않겠습니다. NeMo RL 생성 설계
그림의 ‘Agents & environments’에 포함된 에이전트는 한 과제를 해결하기 위해 모델 호출과 도구 호출을 이어주는 코드입니다. 단일 응답 과제라면 질문을 보내고 답을 받는 것으로 끝날 수 있습니다. 코드 수정 과제라면 모델이 파일을 읽고, 수정하고, 테스트 결과를 확인한 뒤 다시 생성하도록 이어줍니다. 이런 반복을 제어하는 에이전트와, 토큰을 계산하는 추론 엔진은 서로 다른 역할입니다.
평가·검증은 그 경험에 과제 점수를 붙입니다. 결과를 검사하는 코드일 수도 있고, 응답을 평가하는 보상 모델일 수도 있습니다. OPD를 사용한다면 교사의 확률을 얻는 경로도 추가됩니다. critic과 reference 역시 학습 구성에 따라 필요한 계산을 제공합니다. 어느 모델도 이름이 등장했다는 이유만으로 모든 실행에 추가되는 것은 아닙니다.
프레임워크는 이 작업들의 실행 순서와 자원 배치를 조정합니다. 어떤 경험이 준비됐는지, 어느 학습 데이터 묶음(batch)에 들어가는지, 갱신한 가중치를 언제 추론기에 반영할지를 관리합니다. Miles v0.1.0 구조 문서는 추론 서버, 학습 프로세스, 데이터 소스 사이의 한 실행 경로를 보여줍니다.
질문 하나가 새 정책으로 이어지기까지
간단한 동기 실행을 예로 들겠습니다. 추론기가 정책 버전 10으로 수학 질문 하나의 응답 네 개를 생성하고, GRPO로 한 차례 업데이트한다고 하겠습니다. 숫자와 버전 이름은 실행 흐름을 설명하기 위한 예입니다.
- 실행 관리 코드가 질문과 그룹 ID를 정하고, 추론기에 네 응답의 생성을 요청합니다.
- 추론기는 실제 입력과 생성 토큰, 각 선택의 로그확률을 남깁니다. 도구를 쓰는 과제라면 생성 제어가 도구 결과를 문맥에 추가하며 이 과정을 이어갑니다.
- 평가 코드가 응답을 채점합니다. 학습 쪽에서는 필요한 정보를 모아 그룹 어드밴티지를 계산할 수 있게 됩니다.
- 학습 엔진이 기록된 토큰을 현재 actor에 넣고 정책 손실을 계산합니다. 역전파와 옵티마이저 업데이트로 가중치를 바꿉니다.
- 새 가중치를 추론 엔진에 반영합니다. 반영이 끝난 새 정책을 버전 11이라고 하면, 이후 생성은 버전 11을 사용할 수 있습니다.
4단계에서 학습기는 보통 그 응답을 다시 샘플링하지 않습니다. 기록된 토큰을 다시 계산해 현재 모델이 그 선택에 부여하는 확률을 구합니다. 데이터의 토큰은 그대로인 채 그 확률을 높이거나 낮추는 방향으로 가중치를 갱신합니다.
5단계가 weight sync, 즉 가중치 동기화입니다. 여기서 추론기에 전달하려는 것은 다음 생성을 수행할 모델 가중치입니다. 학습을 계속하기 위한 옵티마이저 상태 전체를 추론기가 받아야 하는 것은 아닙니다. 병렬 분할이나 메모리 형식이 다르면 가중치를 추론기의 분할과 저장 형식에 맞게 바꾸는 작업도 필요할 수 있습니다.
이 예는 생성과 학습의 순서를 단순하게 보여주기 위해 동기 실행을 택했습니다. 생성이 계속되는 동안 학습을 진행하는 구성에서는 버전과 소비 시점의 관계가 더 복잡해집니다. 어느 경우든 “이 경험을 만든 정책은 무엇이고, 이번 업데이트 결과가 다음 생성에 언제 반영되는가”를 추적해야 합니다.
응답 텍스트 외에 전달해야 할 정보
학습기에 “정답은 42입니다”라는 문자열만 보내면 충분할까요? 이 문자열은 결과를 읽는 데는 충분하지만, 어떤 문맥에서 어떤 토큰을 선택했는지를 그대로 복원해주지는 않습니다. 정책 손실에는 그 선택의 입력과 확률, 학습 신호가 필요합니다.
이때 과제를 수행하며 쌓은 경험 기록을 trajectory, 궤적이라고 부릅니다. 대화나 도구 사용이 있다면 여러 번의 모델 호출과 관찰이 포함될 수 있습니다. 그림 2는 그림 1의 추론 엔진에서 data buffer로 향하는 경로를 확대해, 경험 기록에 연결되는 정보를 펼쳐 보여줍니다. 필드명은 프레임워크 공통 API가 아닌 개념명입니다. 모든 정보를 추론 엔진이 만드는 것은 아닙니다. 환경 기록과 평가, 실행 관리에서 얻는 정보도 함께 연결되며, 이를 모으는 위치와 버퍼에 저장하는 시점은 구현에 따라 다릅니다.
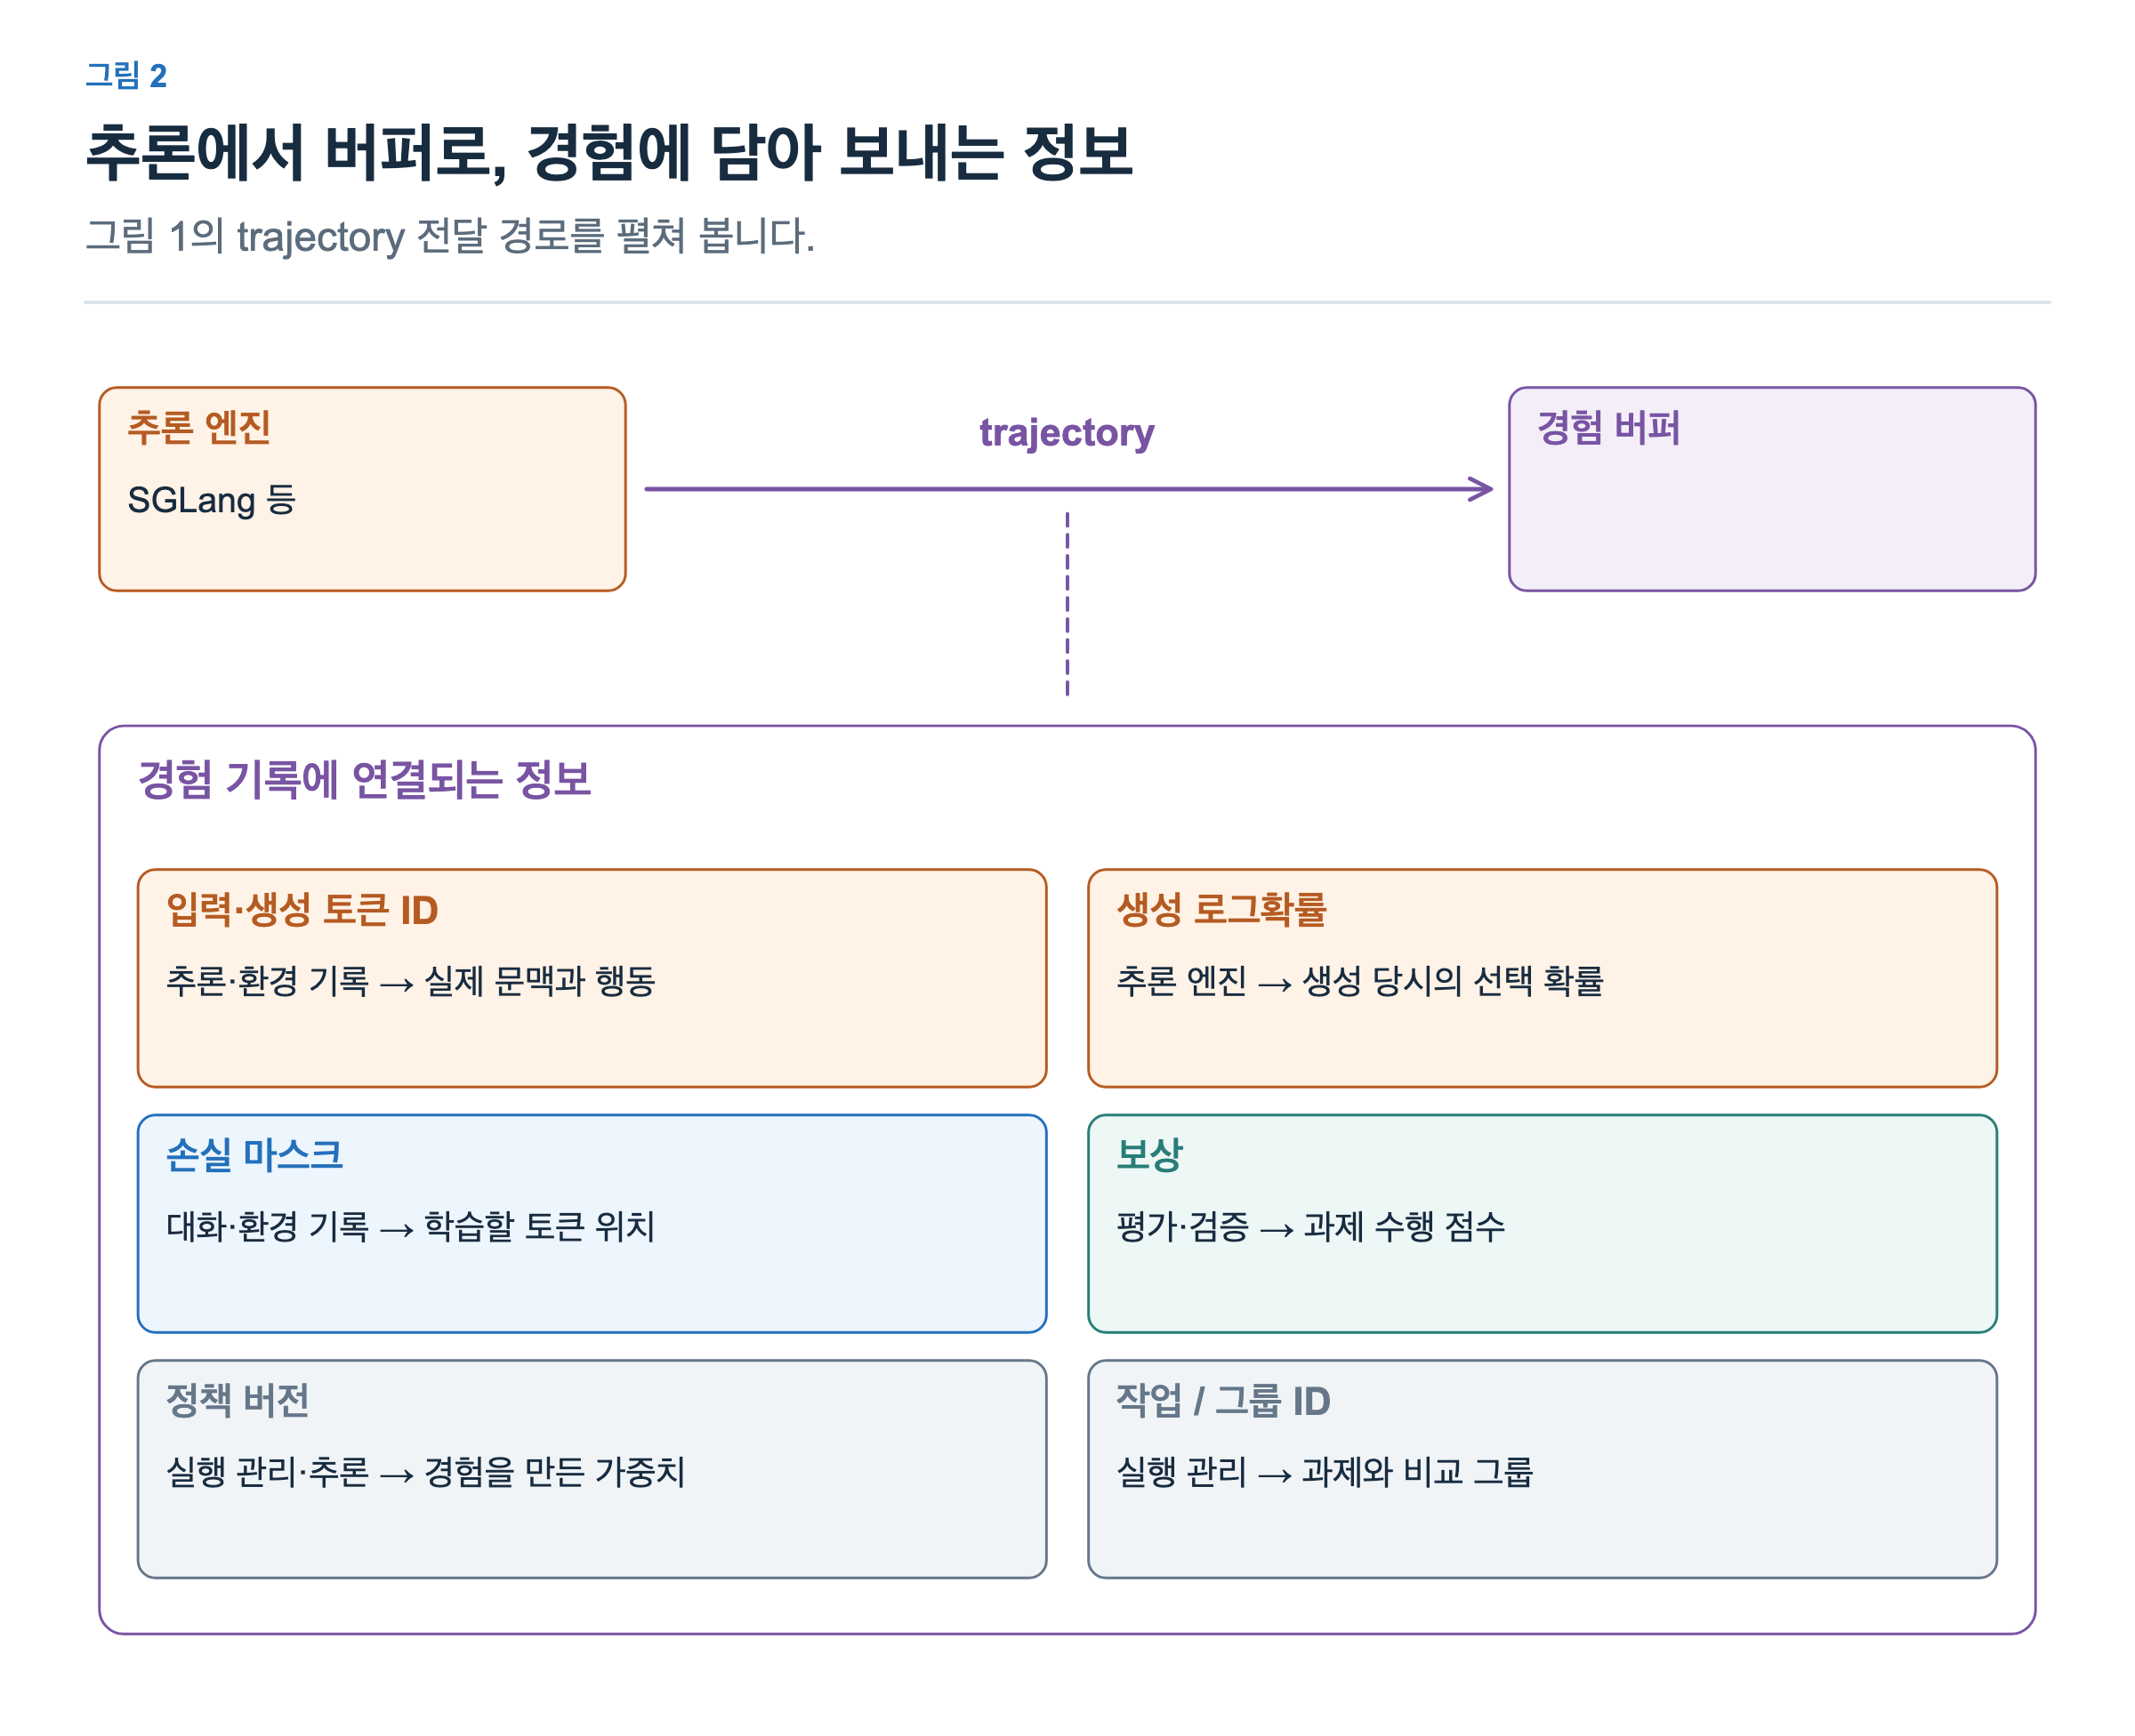
토큰 ID는 실제로 모델이 본 입력과 선택한 행동을 보존합니다. 같은 문장처럼 보여도 토큰 분할이나 템플릿이 달라지면 다른 입력이 됩니다. 특히 도구 결과나 대화 이력을 합칠 때는 텍스트만으로 원래의 계산을 재현할 수 있다고 가정하면 안 됩니다.
Loss mask는 어떤 위치에 정책 손실을 적용할지 표시합니다. 사용자 질문이나 도구가 돌려준 결과는 actor가 선택한 행동이 아닙니다. 이 글의 기본 구성에서는 이런 위치를 actor의 생성 토큰과 구별합니다. 도구 결과는 손실 대상이 아니어도 이후 행동을 결정하는 입력 문맥에는 포함됩니다.
생성 로그확률은 경험을 만들 때의 선택 확률을 기록합니다. 2편에서 본 현재 정책과의 비교에 필요한 출처입니다. 실제로 어떤 확률을 분모로 쓰고 추가 보정을 하는지는 학습 구성에 따라 달라질 수 있으므로, 기록한 생성 확률과 학습기에서 다시 구한 확률은 구별해 보관해야 합니다.
보상과 식별 정보는 경험을 올바른 비교와 업데이트에 연결합니다. 보상은 평가 결과이고, 정책 버전은 어느 가중치로 생성했는지를 알려줍니다. 작업 ID는 어떤 과제인지, 그룹 ID는 어느 응답들과 비교해야 하는지를 알려줍니다. 여러 버전에 걸쳐 생성한 궤적이라면 하나의 최종 버전 숫자만으로 이력을 표현할 수 없을 수도 있습니다.
구현에 따라 교사 확률, critic 값, 길이, 종료 사유 등의 정보가 더 필요할 수 있습니다. 이 중 일부는 전달 전에 만들고 일부는 학습 쪽에서 계산합니다. 중요한 기준은 모든 값을 한 프로세스가 만들었는지가 아니라, 손실을 계산할 때 해당 토큰과 문맥에 맞는 값이 준비되어 있는가입니다.
생성 완료와 학습 준비 완료
생성과 평가, 기록 정리는 반드시 직렬로 실행되는 단계가 아닙니다. 어떤 응답은 생성 도중 필요한 기록이 이미 준비되어 있고, 생성 직후 채점을 시작할 수 있습니다. 다른 응답의 생성과 이 응답의 채점이 겹칠 수도 있습니다.
GRPO의 그룹 비교를 예로 들면, 한 응답이 생성을 마쳐 추론기의 실행 자리를 비워도 다른 응답의 점수가 아직 없을 수 있습니다. 그 응답 자체는 생성 완료지만, 정한 그룹으로 비교하기 위한 정보는 아직 준비되지 않았습니다. 생성 자원 반환과 학습 데이터 준비는 서로 다른 사건입니다.
버퍼는 이 속도 차이를 받아주는 역할입니다. 준비 전의 기록을 먼저 저장하고 상태를 갱신할 수도 있고, 필요한 그룹을 모두 준비한 뒤 넣을 수도 있습니다. 따라서 “버퍼에 있다”는 말만으로 학습 가능한 상태라고 판단하면 안 됩니다. 실제 구현이 무엇을 저장하고 어떤 조건으로 소비하는지 확인해야 합니다.
Miles의 구조 문서에 나오는 데이터 소스는 학습 쪽에서 소유하는 Python 객체입니다. 반면 완전 비동기 경로에는 계속 실행되는 생성 작업과 큐가 등장합니다. 이런 차이를 하나의 중앙 버퍼 서버로 고정해서 그리면 구현을 오해하기 쉽습니다. 그림 1의 data buffer 역시 별도 서버의 존재보다 저장·대기·선택의 역할을 중심으로 읽어야 합니다. Miles v0.1.0 실행 구조
준비된 경험도 곧바로 모두 학습에 들어가는 것은 아닙니다. 배치 크기, 길이, 데이터 선택 규칙 등에 따라 일부가 다음 배치를 기다릴 수 있습니다. 선택된 경험을 한 번 사용할지 여러 업데이트에 재사용할지도 별도 설정입니다.
같은 GPU에 둘 것인가, 나눠 둘 것인가
지금까지는 실행 역할을 보았습니다. 이제 같은 전체 GPU 자원에 이 역할을 어떻게 배치할지 보겠습니다.
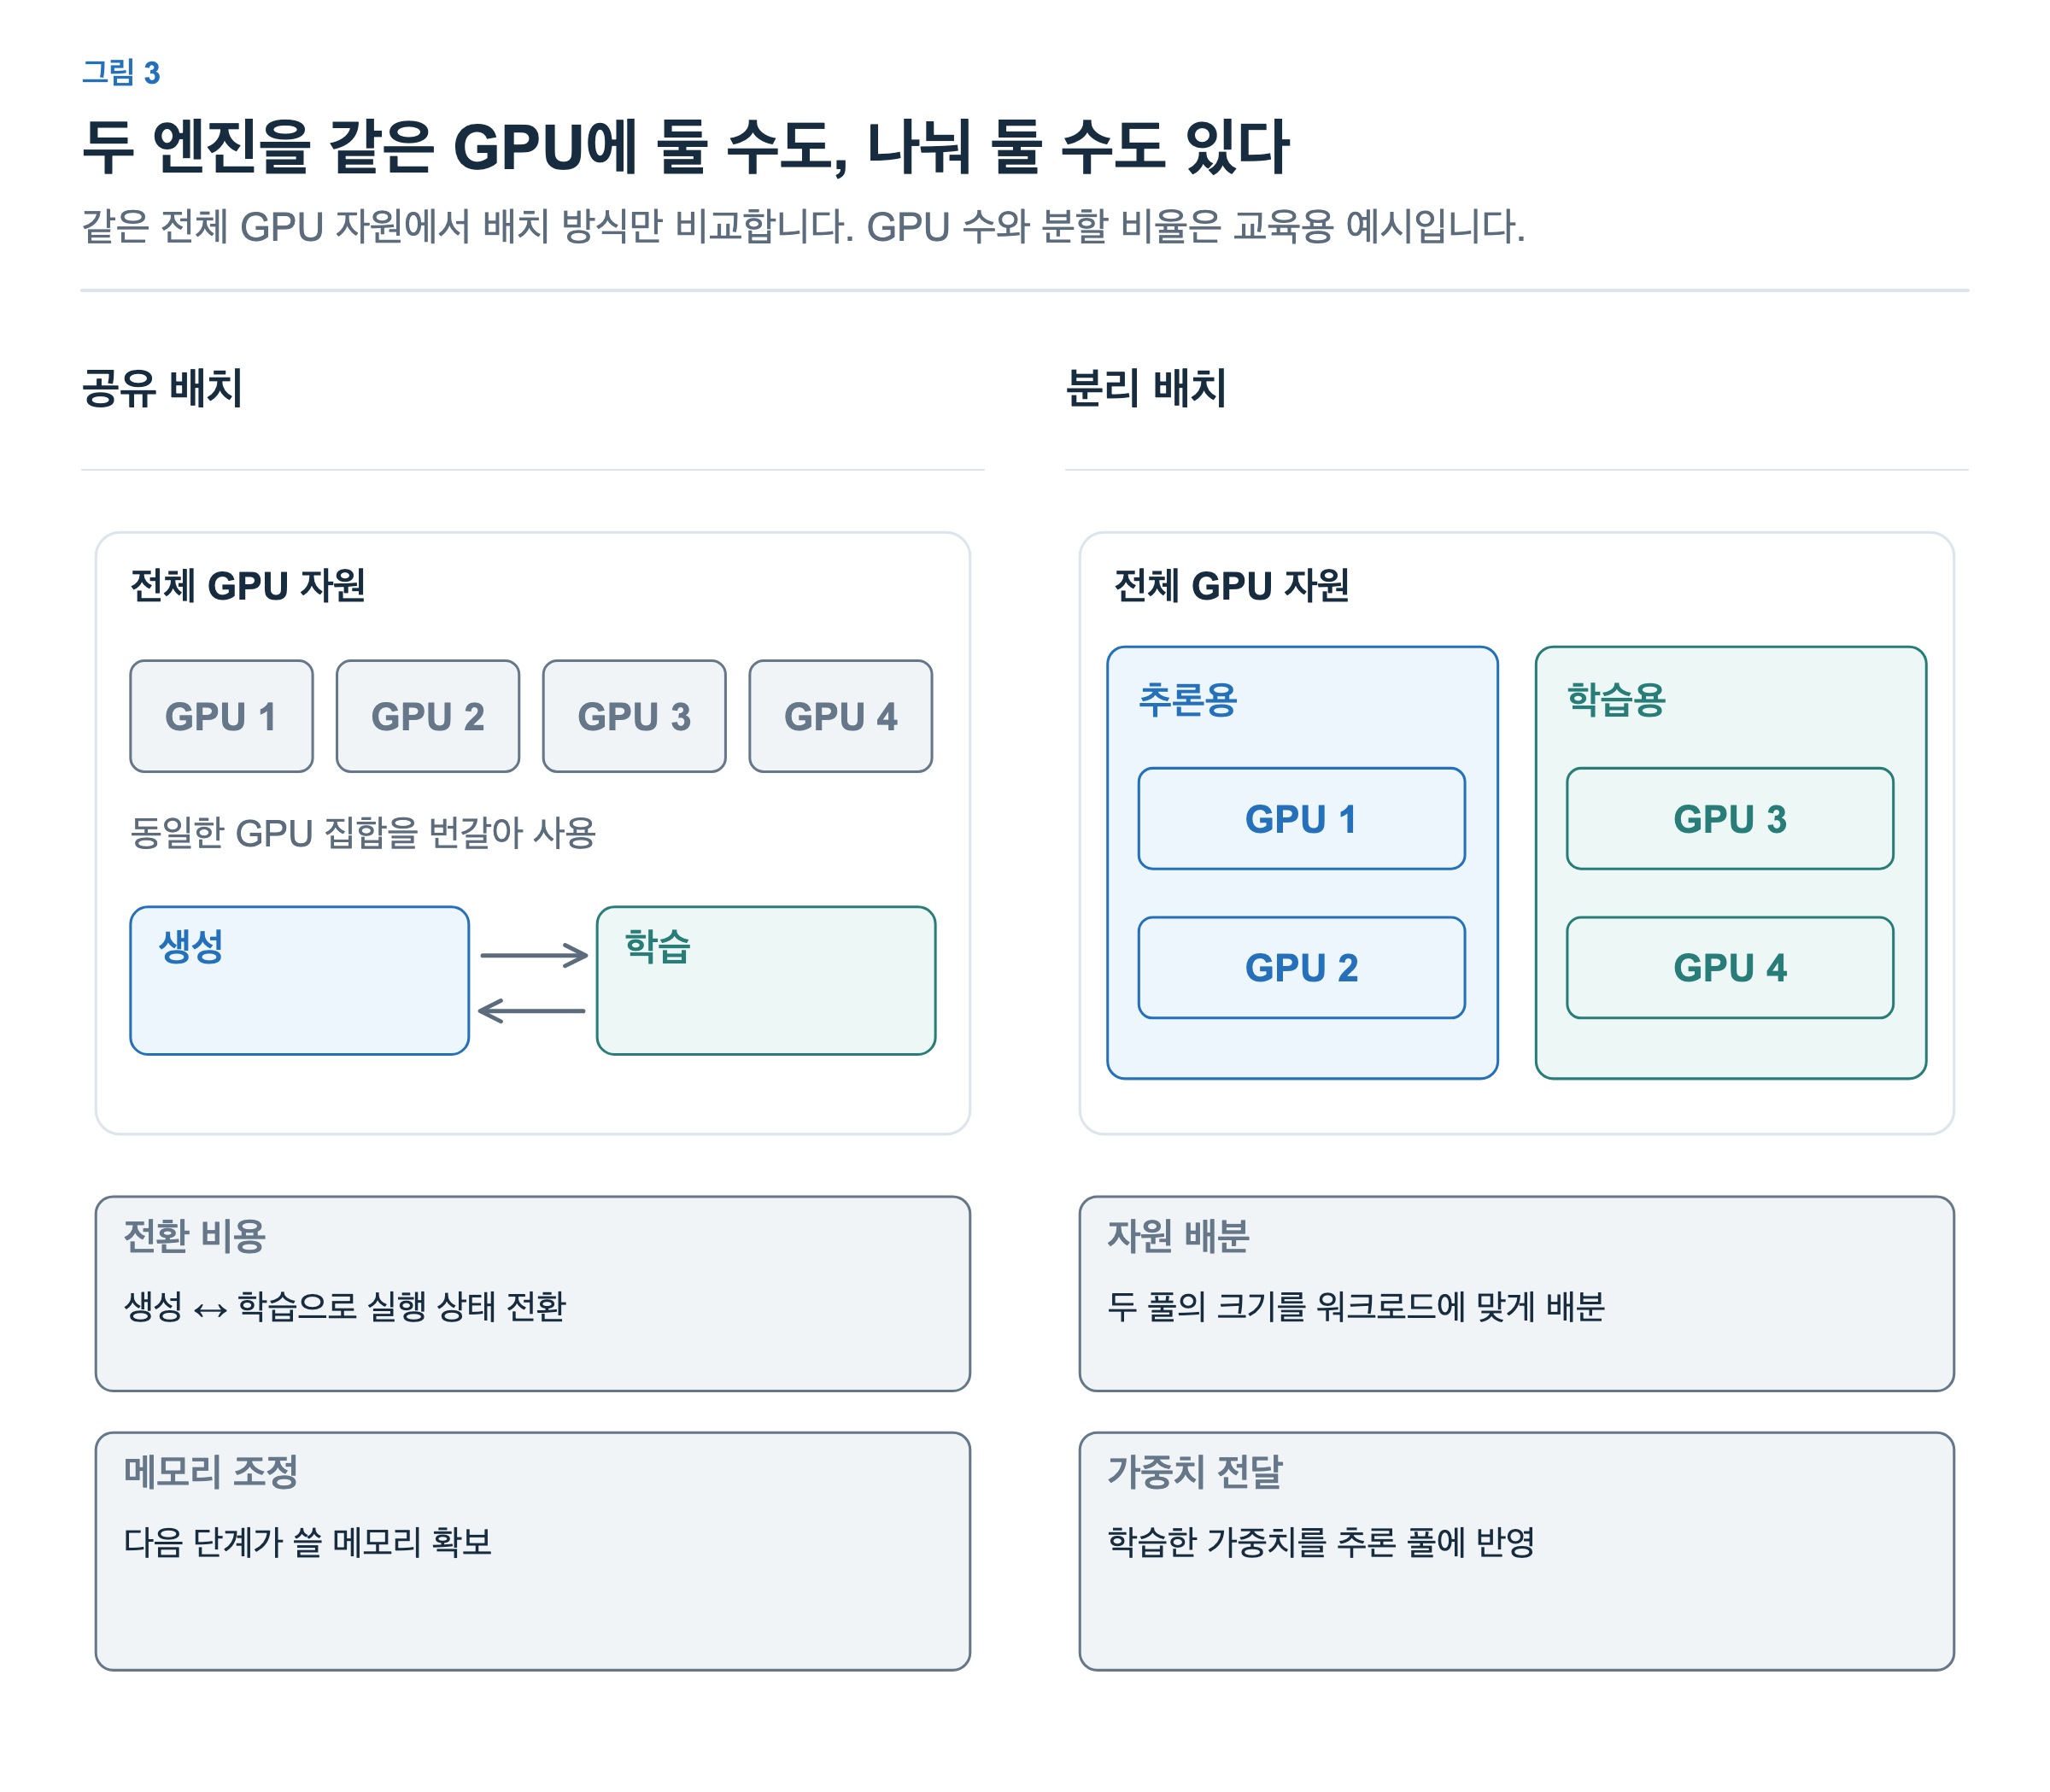
공유 배치의 예에서는 같은 GPU 네 개를 생성과 학습이 번갈아 사용합니다. 각 단계가 전체 자원을 사용할 수 있지만, 전환할 때 다음 단계에 필요한 메모리를 확보해야 합니다. 추론 캐시를 정리하거나 학습 상태를 옮기는 등 실행 구성에 따른 비용이 생길 수 있습니다.
분리 배치의 예에서는 추론과 학습에 GPU 두 개씩을 배정합니다. 서로 다른 자원에서 실행할 수 있으므로 두 작업을 겹칠 여지가 생깁니다. 대신 생성과 학습의 작업량에 맞게 자원을 나눠야 합니다. 추론이 느린데 학습기에 자원을 지나치게 배정하면 학습기가 데이터를 기다릴 수 있습니다. 새 가중치를 다른 GPU 집합으로 전달하는 경로도 필요합니다.
GPU를 분리했다는 사실만으로 비동기 RL이 되는 것은 아닙니다. 추론용 GPU가 생성을 마친 뒤 학습용 GPU가 업데이트하고, 동기화가 끝날 때까지 다음 생성을 기다리도록 실행할 수도 있습니다. 자원의 위치와 작업을 겹치는 시점은 별개의 설계입니다. 또한 그림의 고려 사항은 배타적인 목록이 아닙니다. 공유 배치에서도 생성용 가중치를 갱신하는 절차가 필요할 수 있습니다. Miles v0.1.0 GPU 배치 설명
또한 모델 역할 수와 GPU 수는 일대일로 대응하지 않습니다. 큰 actor 하나가 여러 GPU에 걸칠 수 있고, 여러 평가 역할이 시간차를 두고 자원을 사용할 수도 있습니다. “actor, critic, reference, teacher가 있으니 GPU 네 개”처럼 모델 이름만 세어 배치를 정할 수는 없습니다.
프레임워크를 이 지도에서 읽기
Slime, Miles, NeMo RL을 볼 때도 먼저 생성, 학습, 경험 전달, 가중치 반영이 어디에 있는지 찾으면 구조를 읽기 쉽습니다. 아래는 공통 지도를 각 프로젝트에 연결하기 위한 출발점입니다. 지원 기능이나 성능의 순위표는 아닙니다.
| 프로젝트 | 공통 지도에서 찾아볼 연결 |
|---|---|
| Slime | SGLang 기반 생성, 학습 백엔드, 이 둘 사이의 데이터 관리 |
| Miles v0.1.0 | 추론 서버와 Router, 학습 프로세스, 데이터 소스와 가중치 동기화 |
| NeMo RL | 생성과 환경 상호작용, 정책 학습, 실행 자원 및 가중치 동기화 |
실제 도입 시에는 필요한 모델과 학습 구성이 해당 버전에서 지원되는지 확인해야 합니다. Slime 공식 저장소, Miles v0.1.0, NeMo RL 공식 저장소
이 지도는 전체 post-training 과정 중 경험을 생성하며 정책을 갱신하는 구간을 확대해서 본 것입니다. SFT 체크포인트에서 RL을 시작하거나, 학습한 모델을 다른 학생의 교사로 사용하는 등 앞뒤 단계는 학습 구성에 따라 이어집니다. 여러 단계를 하나의 프로세스가 연속으로 수행해야 한다는 뜻은 아닙니다.
다음 글에서는 TITO로 실제 토큰 ID를 보존하고, R3로 생성 당시의 MoE 전문가 선택을 학습에서 재현하는 방법을 살펴보겠습니다.