RL · 2026-09-25
에이전트 전체를 보고 스케줄링하기
모델 호출과 도구 실행을 잇는 프로그램의 상태를 추적하고, KV 보존과 재계산 사이에서 실행·일시중지·재배치를 결정하는 방법을 살펴봅니다.
앞 글에서는 요청을 어느 엔진으로 보내고 어떻게 함께 생성할지 보았습니다. 그런데 코딩 에이전트가 테스트 도구를 호출하면 모델의 생성은 잠시 끝나도 작업은 끝나지 않습니다. 테스트 결과를 받은 뒤 같은 파일과 대화 기록을 바탕으로 다시 생성해야 합니다.
이번 글에서는 모델 호출보다 오래 살아 있는 프로그램을 기준으로 생각해 보겠습니다. 먼저 연산·KV·도구 환경의 수명을 나누고, 메모리가 부족할 때 어떤 프로그램을 쉬게 할지 살펴봅니다. 마지막에는 도구 환경의 준비와 실행 대기가 다음 추론을 어떻게 늦추는지까지 시야를 넓힙니다. ThunderAgent의 program-aware scheduling이 중심 사례입니다. 사용자 관점에서는 에이전트 작업 전체를 고려하는 scheduling으로 이해할 수 있습니다.
호출이 끝나도 작업은 남는다
프로그램 P가 코드 작성, 테스트, 수정, 재시험을 순서대로 수행한다고 해보겠습니다. 모델은 코드를 만들고 테스트 실행을 요청합니다. 도구가 결과를 돌려주면 모델은 실패 원인을 읽고 수정합니다. 각 모델 호출은 별개지만, 파일과 기록을 이어 사용하는 하나의 작업입니다.
여기서 Reasoning은 모델이 다음 응답이나 도구 호출을 생성하는 단계, Acting은 도구가 실제로 실행되는 단계입니다. Reasoning을 특정한 추론 토큰 형식으로 제한해서 읽을 필요는 없습니다.
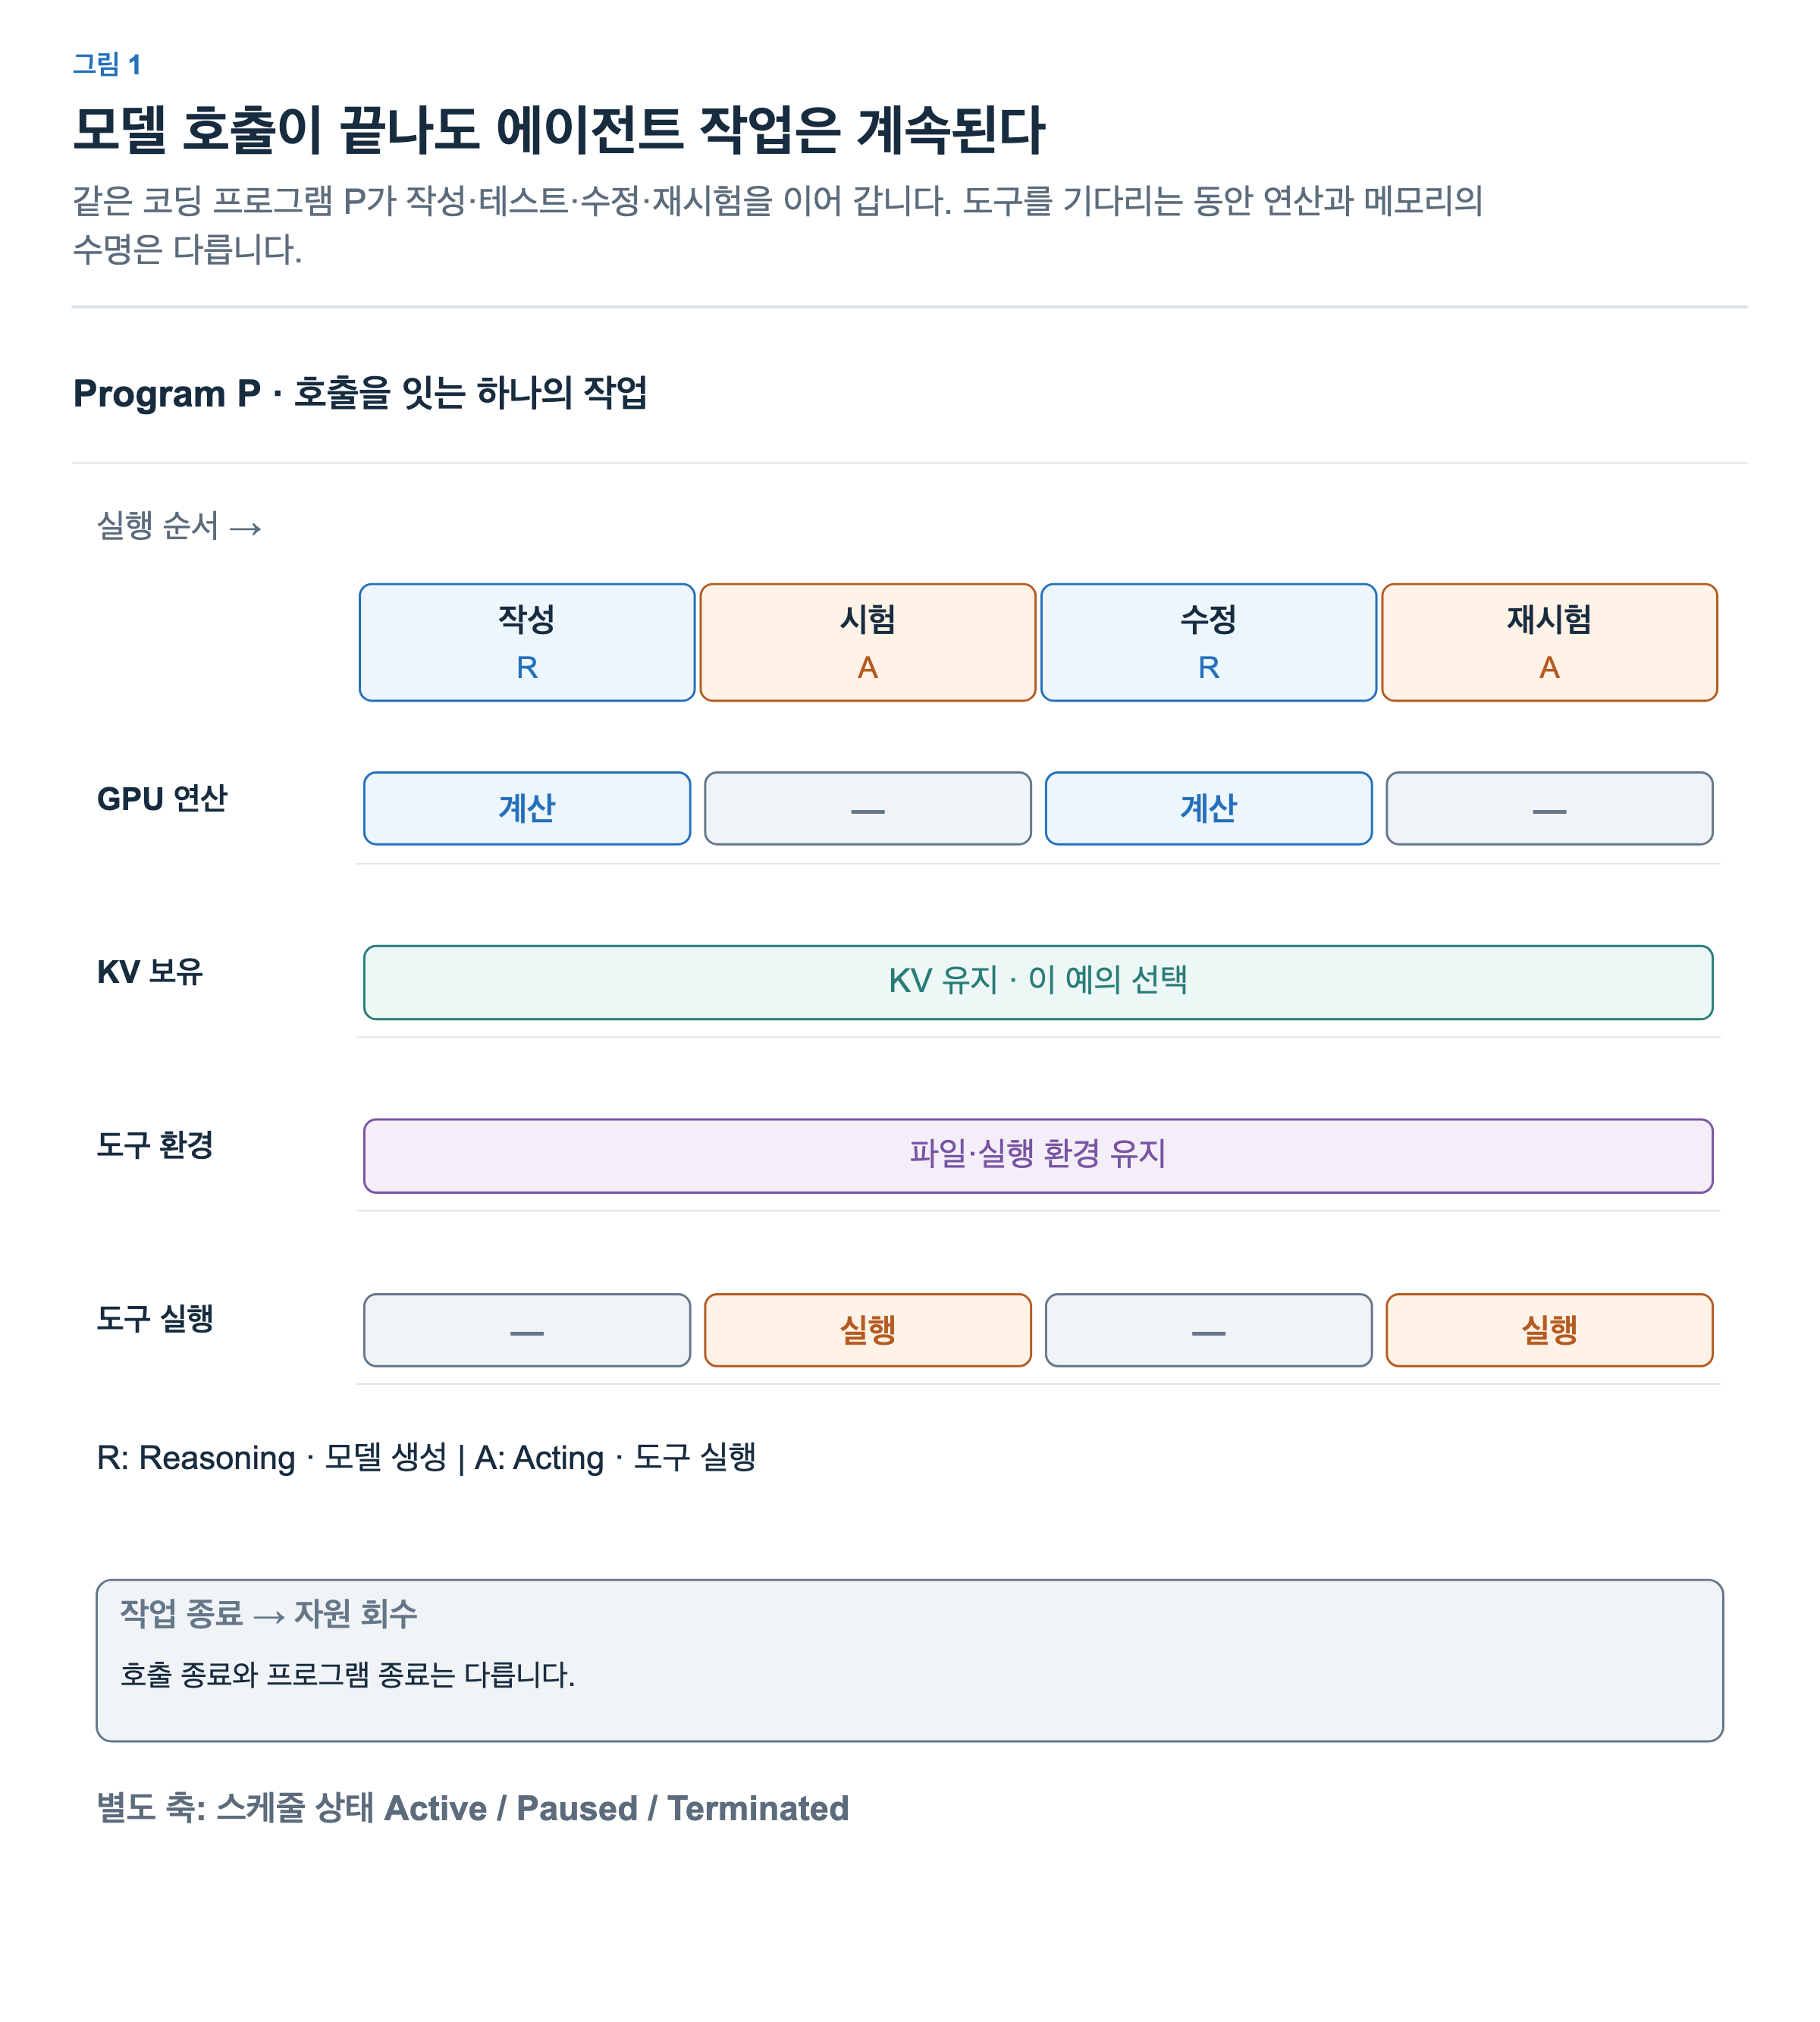
GPU 연산 행을 보면 작성과 수정 구간에서 P를 위한 모델 계산이 일어납니다. 테스트 구간의 빈칸은 P가 모델을 계산하지 않는다는 뜻입니다. 그 GPU가 다른 프로그램의 생성을 진행할 수 있으므로 GPU 전체가 쉰다는 뜻은 아닙니다.
KV 보유 행은 더 길게 이어집니다. 이 예에서는 테스트를 기다리며 P의 KV를 남겨 둡니다. 결과가 돌아왔을 때 앞선 문맥을 다시 계산하는 비용을 줄이기 위해서입니다. 하지만 그동안 메모리는 계속 점유합니다. 이는 가능한 선택 하나이며, 모든 도구 대기 중 KV를 반드시 GPU에 유지해야 하는 규칙은 아닙니다.
파일과 실행 환경도 따로 봐야 합니다. 수정한 파일이 다음 테스트에서 사라진다면 같은 작업을 이어갈 수 없습니다. 환경은 모델 호출이 끝날 때마다 새로 만드는 대신 작업에 맞는 수명으로 관리해야 합니다. 반대로 프로그램이 끝났는데도 환경을 계속 남겨 두면 디스크나 포트 같은 자원이 누적됩니다.
이 관계를 관리하려면 요청 내용만으로는 부족합니다. ThunderAgent는 program ID에 문맥 길이, 도구 환경, 배정된 추론 엔진(backend), 실행 단계와 스케줄 상태를 연결합니다. 실행 단계인 Reasoning/Acting과 스케줄 상태인 Active/Paused/Terminated는 다른 축입니다. 도구를 실행 중인 Acting 프로그램도 현재 backend에 배치된 Active 상태일 수 있습니다. ThunderAgent §4.1
보존 비용과 재계산 비용
KV를 남기면 돌아왔을 때 유리합니다. 그러나 많은 프로그램이 동시에 도구를 기다리면 그 캐시가 현재 생성 중인 프로그램에 필요한 공간을 차지합니다. 모두 보존하는 정책이 항상 가장 빠르지는 않습니다.
반대로 도구 호출 때마다 KV를 퇴거시키면, 긴 문맥을 반복해서 읽을 수 있습니다. 문맥이 2천 토큰인 작업과 5만 토큰인 작업이 있다고 해보겠습니다. 둘 다 캐시를 없앴다가 돌아오더라도 재계산할 입력의 길이는 크게 다릅니다. 정확한 시간은 모델과 엔진에 달려 있지만, 두 작업을 단순히 “대기 중인 요청 하나”로 같게 취급할 이유는 없습니다.
이때 필요한 판단은 얼마나 오래 어떤 메모리를 점유할지, 회수하면 나중에 무엇을 다시 계산할지입니다. 캐시 hit 비율만 최대화하면 빈 엔진을 두고 한 엔진을 과도하게 채울 수 있습니다. 동시 프로그램 수만 늘리면 KV를 내보냈다 다시 만드는 일이 잦아질 수 있습니다. 이런 반복적인 퇴거와 재계산을 KV cache thrashing이라고 부릅니다.
11편의 routing이 요청을 보낼 위치를 다뤘다면, 여기서는 이미 진행 중인 프로그램을 언제 계속 실행하고 언제 쉬게 할지도 결정합니다. 실제 시스템에서 위치 선택과 실행 순서가 완전히 분리되는 것은 아닙니다.
상태를 보고 Pause와 Restore하기
추론 엔진 A에서 P는 생성 중이고 Q는 도구 실행 중이라고 해보겠습니다. Q의 KV가 남아 있는 동안 P와 다른 작업의 KV가 늘어 A의 메모리가 부족해집니다.
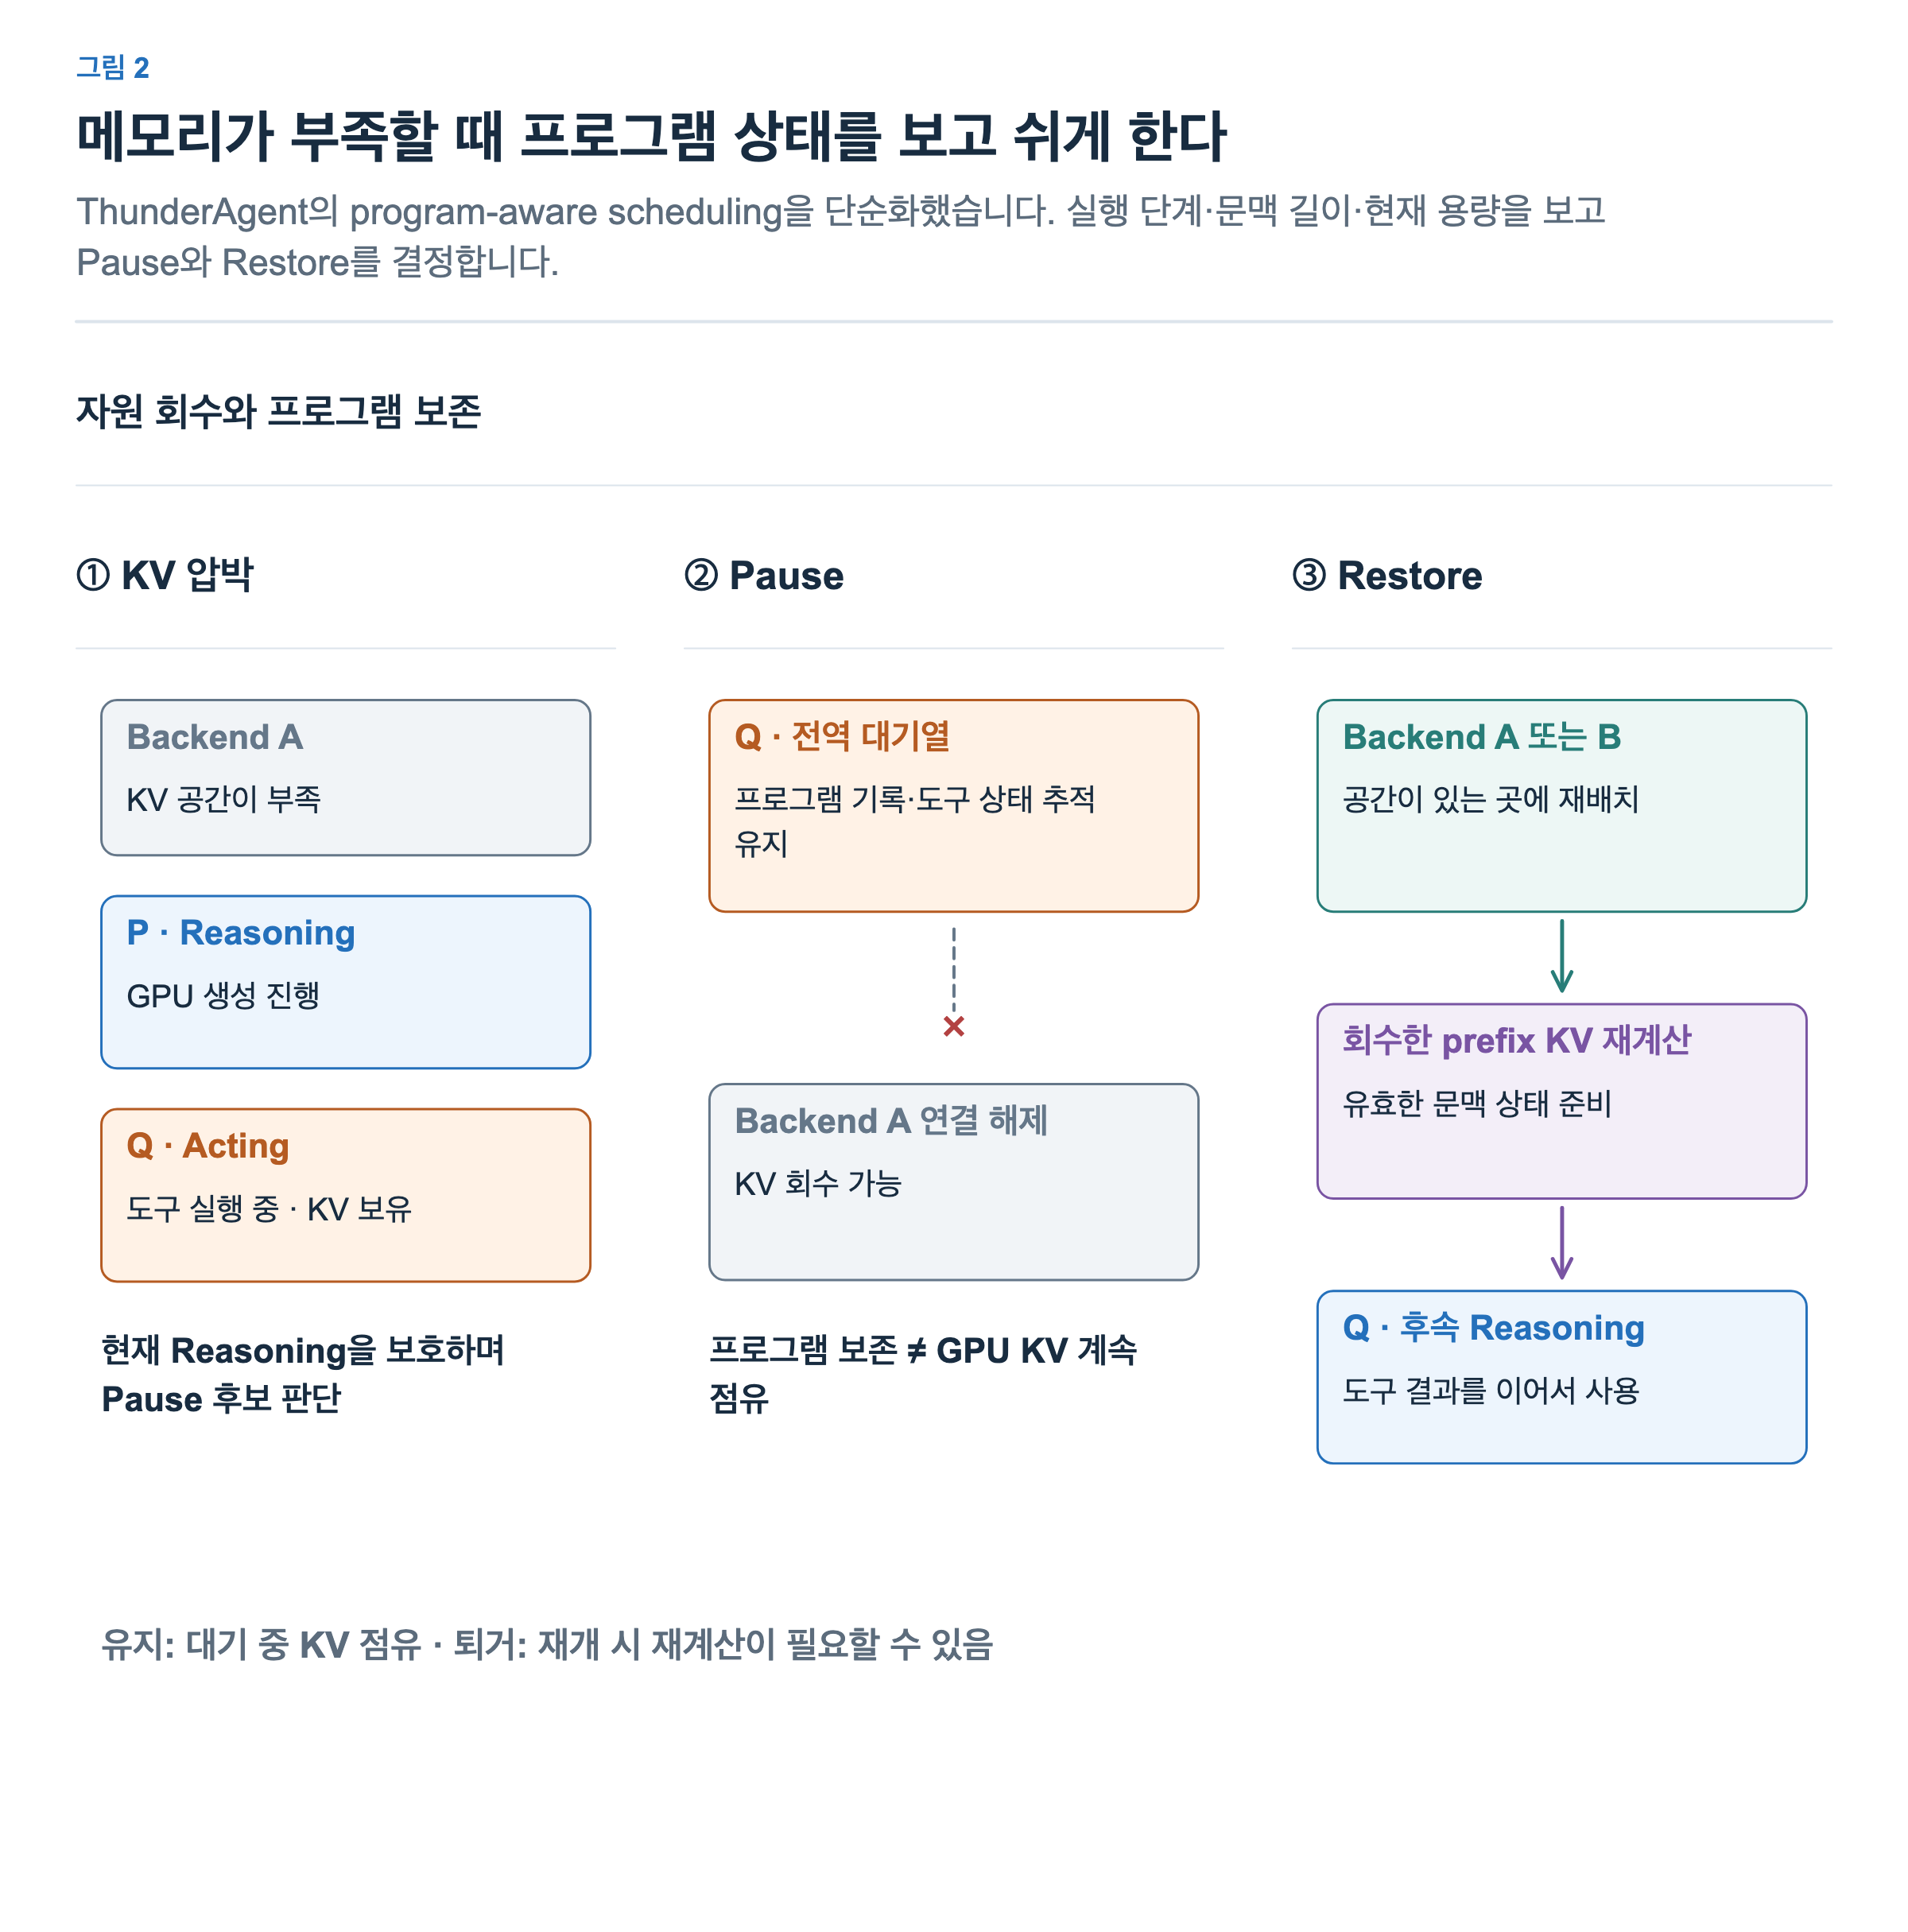
그림의 순서를 따라가면 다음과 같습니다.
- A에서 현재 진행 중인 생성과 도구 대기 프로그램의 상태를 확인합니다.
- Q를 Pause하여 추론 엔진 배정을 해제하고 KV를 회수할 수 있게 합니다. Q의 기록과 도구 상태 추적은 남깁니다.
- 공간이 있는 backend에 Q를 Restore합니다. 이후 생성에 필요한 KV가 사라졌다면 보존한 문맥으로 다시 계산합니다.
Q를 Pause한다는 표현을 이미 실행 중인 외부 테스트 프로세스를 반드시 멈춘다는 뜻으로 읽으면 안 됩니다. 이 그림의 Pause는 추론 backend의 실행 배치와 KV 관리에 관한 동작입니다. 도구 결과를 받는 것과 다음 모델 호출을 실행할 자리를 얻는 것은 별도 사건입니다.
ThunderAgent의 논문은 주기적으로 용량을 확인하고, Pause할 때 Acting 프로그램을 우선 고려하며 문맥 길이도 사용합니다. Restore에는 생성할 준비가 된 Reasoning 프로그램을 우선하는 정책을 둡니다. 전역 대기열은 작업을 원래 backend에만 묶어 두지 않고 여유 있는 다른 backend에 배치할 수 있게 합니다. 이는 모든 대기 프로그램을 무조건 퇴거시키는 규칙과 다릅니다. ThunderAgent §4.3
여기서 Restore는 프로그램을 여유 있는 추론 backend에 다시 배정해 Active 상태로 만드는 동작입니다. CPU RAM에 KV를 옮겨 두었다가 GPU로 복사해 오는 동작을 뜻하지 않습니다. ThunderAgent의 이 분석은 Pause된 프로그램의 KV가 이미 퇴거됐다고 가정하므로, 재개할 때 보존한 문맥을 다시 prefill해 KV를 만듭니다. ThunderAgent §4.3.1–4.3.2
다음은 캐시 보존 여부가 다른 구현까지 생각할 때의 일반적인 조건입니다. 다른 backend로 옮기면 부하는 나눌 수 있지만 기존 캐시의 이점을 잃을 수 있습니다. 같은 backend에 돌아와도 그사이 캐시가 회수됐다면 재계산이 필요합니다. 반대로 유효한 prefix KV가 남아 있다면 재사용할 여지가 있습니다. Restore라는 이름만으로 GPU 사이에서 KV를 직접 복사한다고 추정할 수는 없습니다.
도구 환경의 준비와 종료까지 연결하기
코딩 환경을 준비하는 데 시간이 든다면 모델의 첫 생성과 준비를 겹칠 수 있습니다. 예를 들어 모델이 문제를 읽고 첫 도구 호출을 만드는 동안 필요한 실행 환경을 준비합니다. 첫 도구 실행 시점까지 준비가 끝나면 대기가 줄어듭니다. 준비가 더 오래 걸리거나 첫 생성부터 환경 결과가 필요하다면 그 의존성을 기다려야 합니다.
종료도 프로그램의 수명과 연결합니다. 작업이 끝났다는 사실을 자원 관리에 전달해야 더 이상 사용하지 않는 환경을 회수할 수 있습니다. 여러 프로그램이 공유하는 자원이라면 마지막 사용자가 끝났는지도 확인해야 합니다. ThunderAgent는 비동기 환경 준비와 종료 시점의 자원 회수 hook을 이런 프로그램 정보에 연결합니다. ThunderAgent §4.4
CPU 도구 환경까지 함께 보기
에이전트가 테스트를 요청한 뒤 다음 수정안을 만들려면 먼저 테스트 결과가 돌아와야 합니다. 이 구간에서는 GPU의 생성 속도뿐 아니라 환경을 준비하는 시간, 실행할 자리를 기다리는 시간, 도구가 실제로 실행되는 시간이 중요합니다. 도구 요청을 보냈다고 바로 실행이 시작되는 것은 아닙니다.
추론은 GPU 클러스터에서, 코드와 테스트 실행은 별도 CPU 서버에서 처리하는 구성을 생각해 보겠습니다. ThunderAgent 논문의 실험도 LLM 추론용 GPU 클러스터와 Docker 환경용 CPU 클러스터를 분리합니다. 아래 그림은 이런 배치의 큰 구조를 보여줍니다. 도구에는 외부 API나 다른 모델 호출도 있으므로 모든 도구가 CPU에서 실행된다는 뜻은 아닙니다. ThunderAgent §5.1
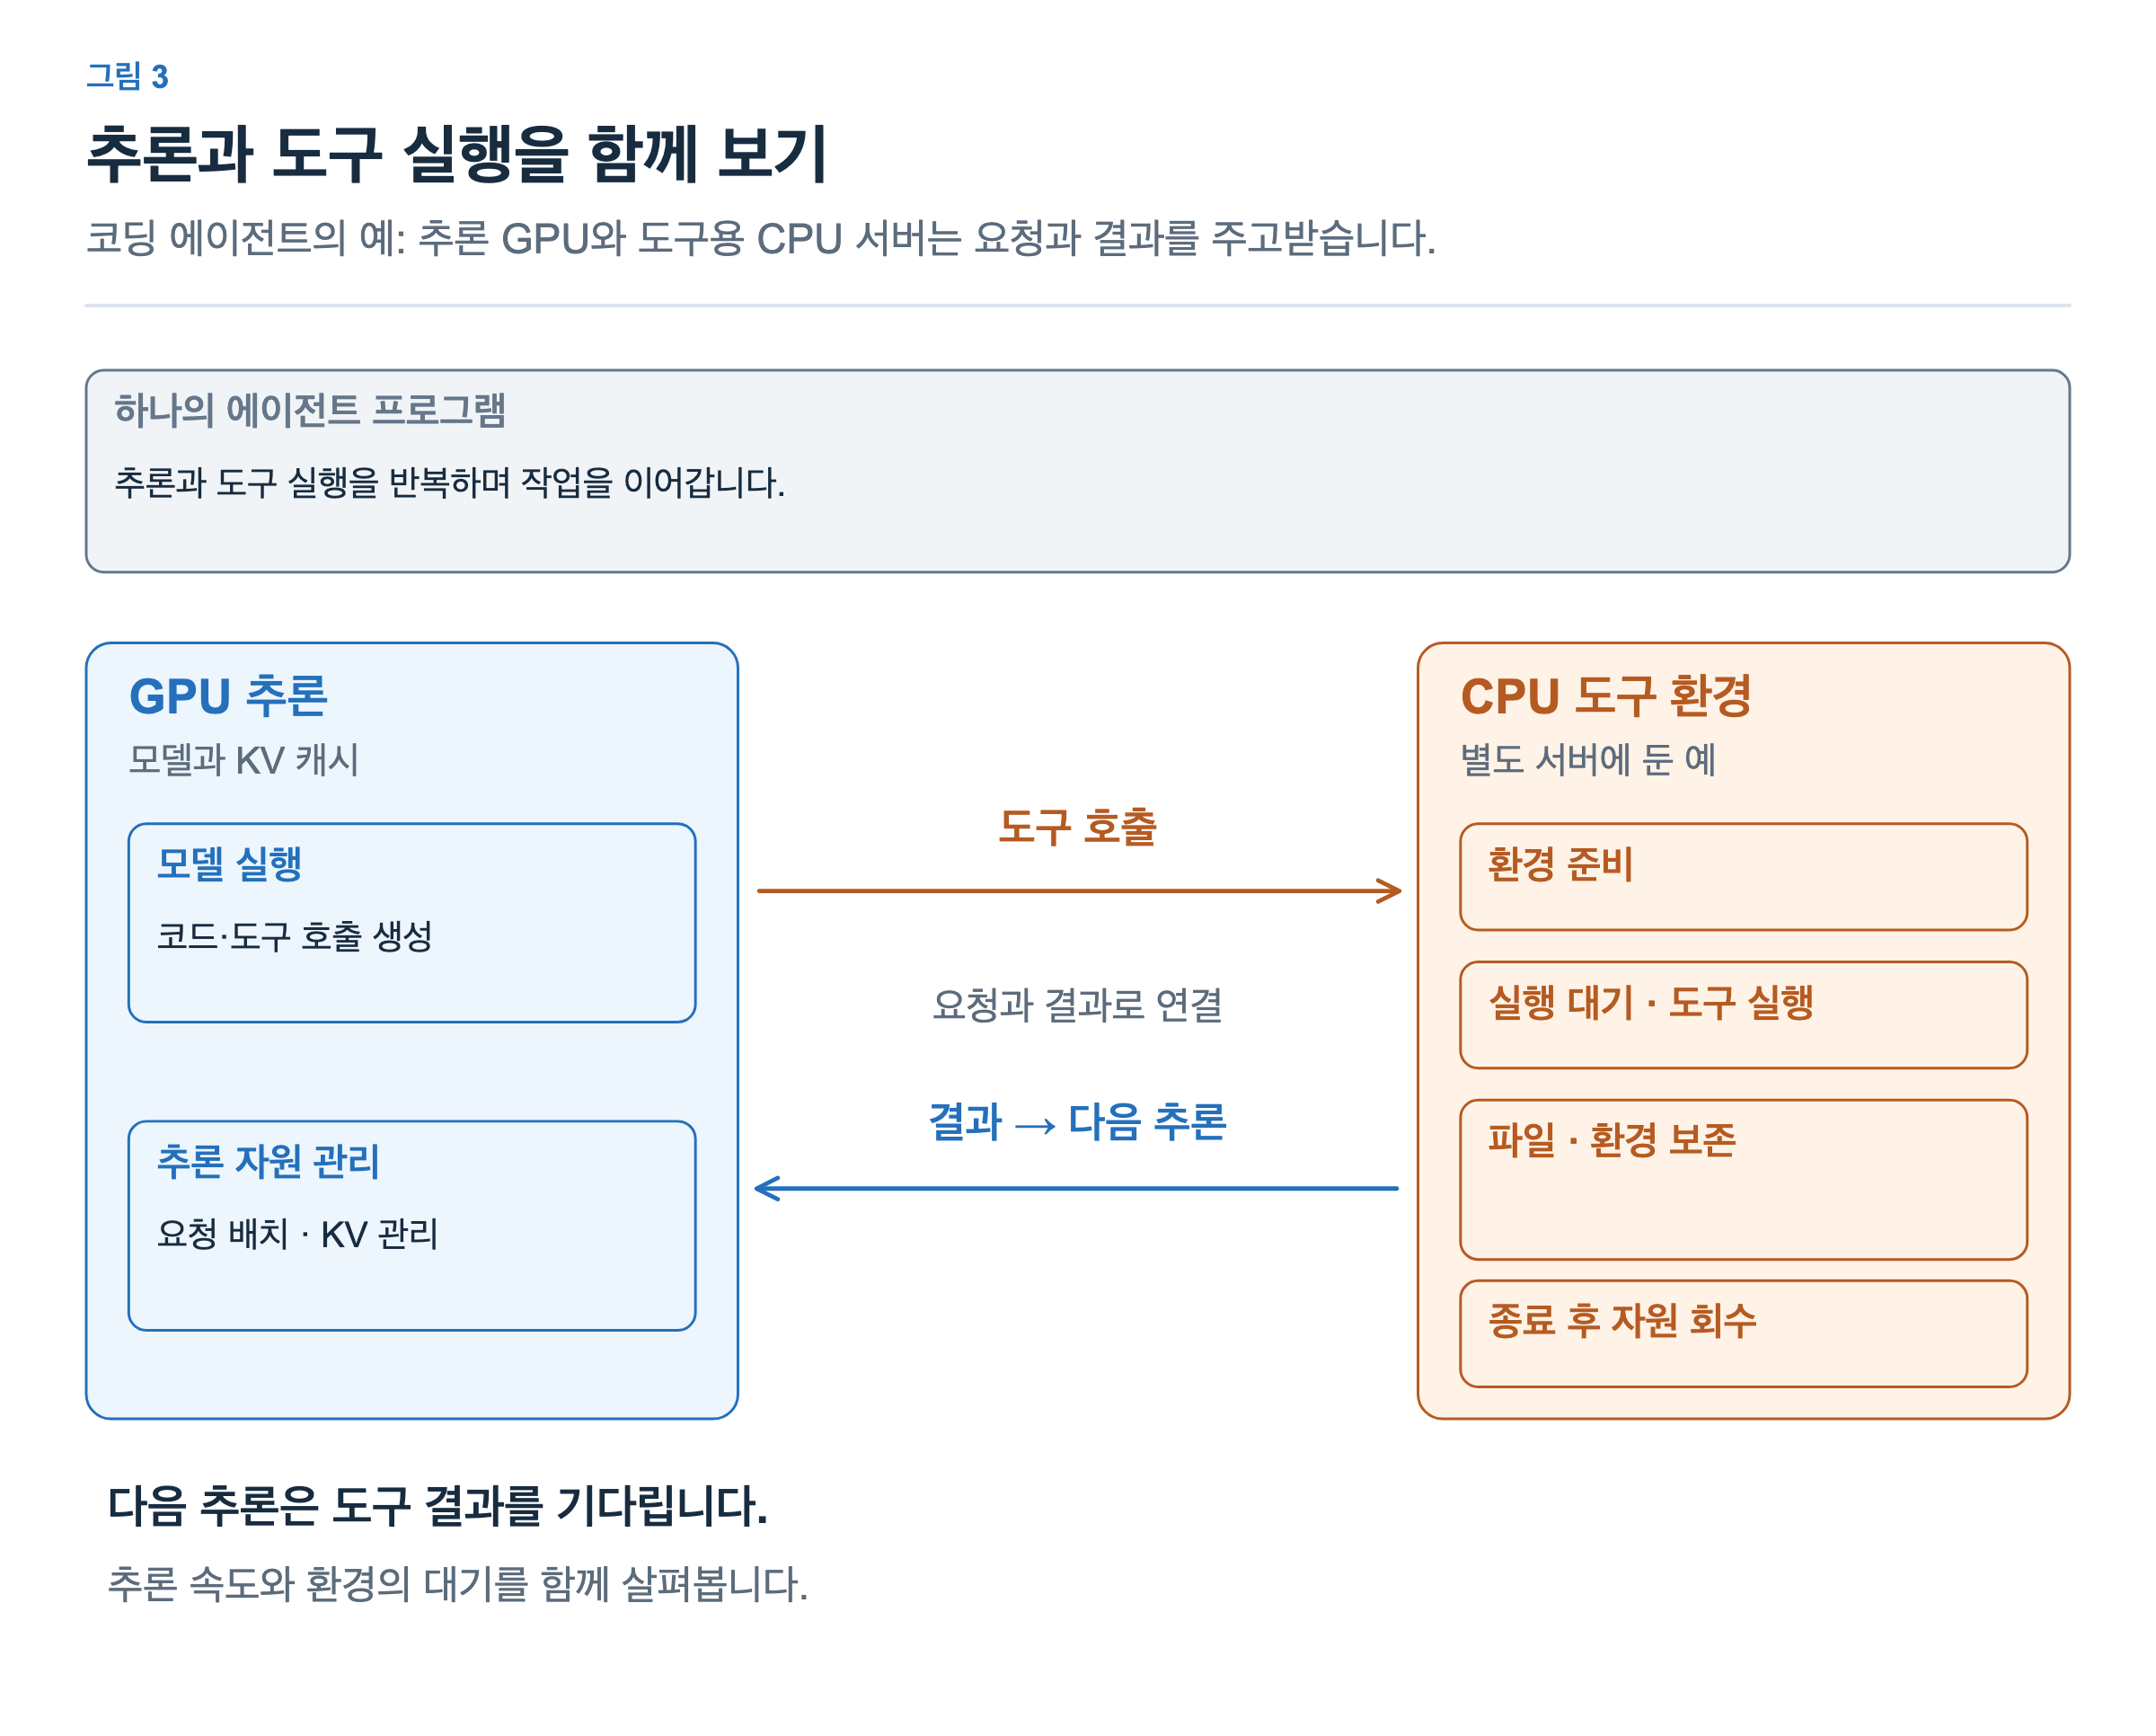
GPU 쪽에서는 요청을 배치하고 KV를 관리하며 생성을 빠르게 합니다. CPU 쪽에서는 필요한 환경을 미리 준비하고, 여러 환경이 CPU·메모리를 효율적으로 쓰도록 배치하며, 작업이 끝나면 자원을 회수합니다. 환경이 준비되어 있어도 실행 자리가 부족하면 기다릴 수 있습니다. 또 한 번의 테스트가 끝났더라도 수정한 파일과 실행 환경은 다음 도구 호출에서 다시 필요할 수 있습니다. 도구 실행의 종료와 환경 수명의 종료를 구별해야 합니다.
DeepSeek의 DSec(DeepSeek Elastic Compute)은 이 CPU 도구 환경 쪽을 효율화하는 사례입니다. 환경 이미지를 필요한 만큼 불러오고, 여러 샌드박스가 메모리를 공유하거나 사용하지 않는 메모리를 회수하며, CPU 실행을 조율해 같은 서버에서 많은 환경을 운영합니다. ThunderAgent가 프로그램의 진행 상태를 보고 추론 배치와 환경의 수명을 연결한다면, DSec은 그 도구들이 실행되는 기반 시설의 준비 비용과 자원 사용을 줄이는 데 초점을 둡니다. 두 시스템이 실제로 결합되어 있다는 뜻이 아니라, 에이전트 실행을 서로 다른 계층에서 최적화하는 사례로 보는 것입니다. DSec 논문
예를 들어 추론을 빠르게 해 테스트 요청이 더 많이 도착해도, CPU 쪽의 실행 자리가 이미 가득 차 있다면 요청은 대기열에 쌓입니다. 반대로 도구 결과가 빨리 돌아와도 추론 자리가 없으면 다음 생성이 기다립니다. 그래서 에이전트 전체를 최적화하려면 어느 단계가 무엇을 기다리는지 함께 봐야 합니다. 한 프로그램이 도구를 기다리는 동안 GPU는 다른 프로그램을 처리할 수 있으므로, 이 대기가 GPU 전체의 유휴 시간을 뜻하지는 않습니다.
이 최적화의 결과는 우선 같은 자원에서 완료한 프로그램 수와 소요 시간으로 확인할 수 있습니다. KV 재계산량, 도구 준비 대기, 남겨진 환경의 자원 사용도 원인을 설명해 줍니다. RL에 적용한다면 완료한 작업이 실제 학습에 쓰였는지까지 연결해야 합니다. Rollout 처리량이 늘었다는 결과를 같은 비율의 전체 학습 시간 단축으로 바꾸어 읽을 수는 없습니다.
다음 글에서는 학습한 새 가중치를 추론 엔진에 전달하는 weight sync를 살펴보겠습니다. 학습기와 추론기의 가중치 분할을 맞추고, 전달을 마친 뒤 새 정책으로 생성을 재개하는 과정으로 이어집니다.