RL · 2026-09-25
새 가중치를 추론 엔진으로 전달하기
학습기와 추론기의 가중치 분할을 맞추고, 전송 경로를 선택하고, 일관된 새 정책으로 생성을 재개하는 과정을 살펴봅니다.
6편의 시스템 지도에는 두 방향의 화살표가 있었습니다. 생성한 경험은 학습기로 가고, 학습한 가중치는 다시 생성기로 갑니다. 이번 글은 두 번째 화살표인 weight sync를 확대합니다.
먼저 가중치를 추론 GPU가 받을 분할과 형식으로 준비합니다. 다음으로 배치와 통신 환경에 맞는 경로를 골라 전달합니다. 마지막으로 새 가중치를 실제 계산에 사용할 준비와 기존 요청·캐시 처리를 마친 뒤 생성을 재개합니다. 준비 → 전송 → 재개의 세 단계를 따라가며, 왜 복사 시간만으로 weight sync 비용을 설명할 수 없는지 살펴보겠습니다.
같은 가중치를 다른 분할에 맞추기
가중치 텐서 하나를 4×4 행렬로 생각해 보겠습니다. 그림의 1~16은 조각의 위치를 추적하기 위한 교육용 값입니다. 학습 GPU 0은 왼쪽 두 열, GPU 1은 오른쪽 두 열을 가지고 있습니다. 추론 GPU 0은 위쪽 두 행, GPU 1은 아래쪽 두 행이 필요합니다.
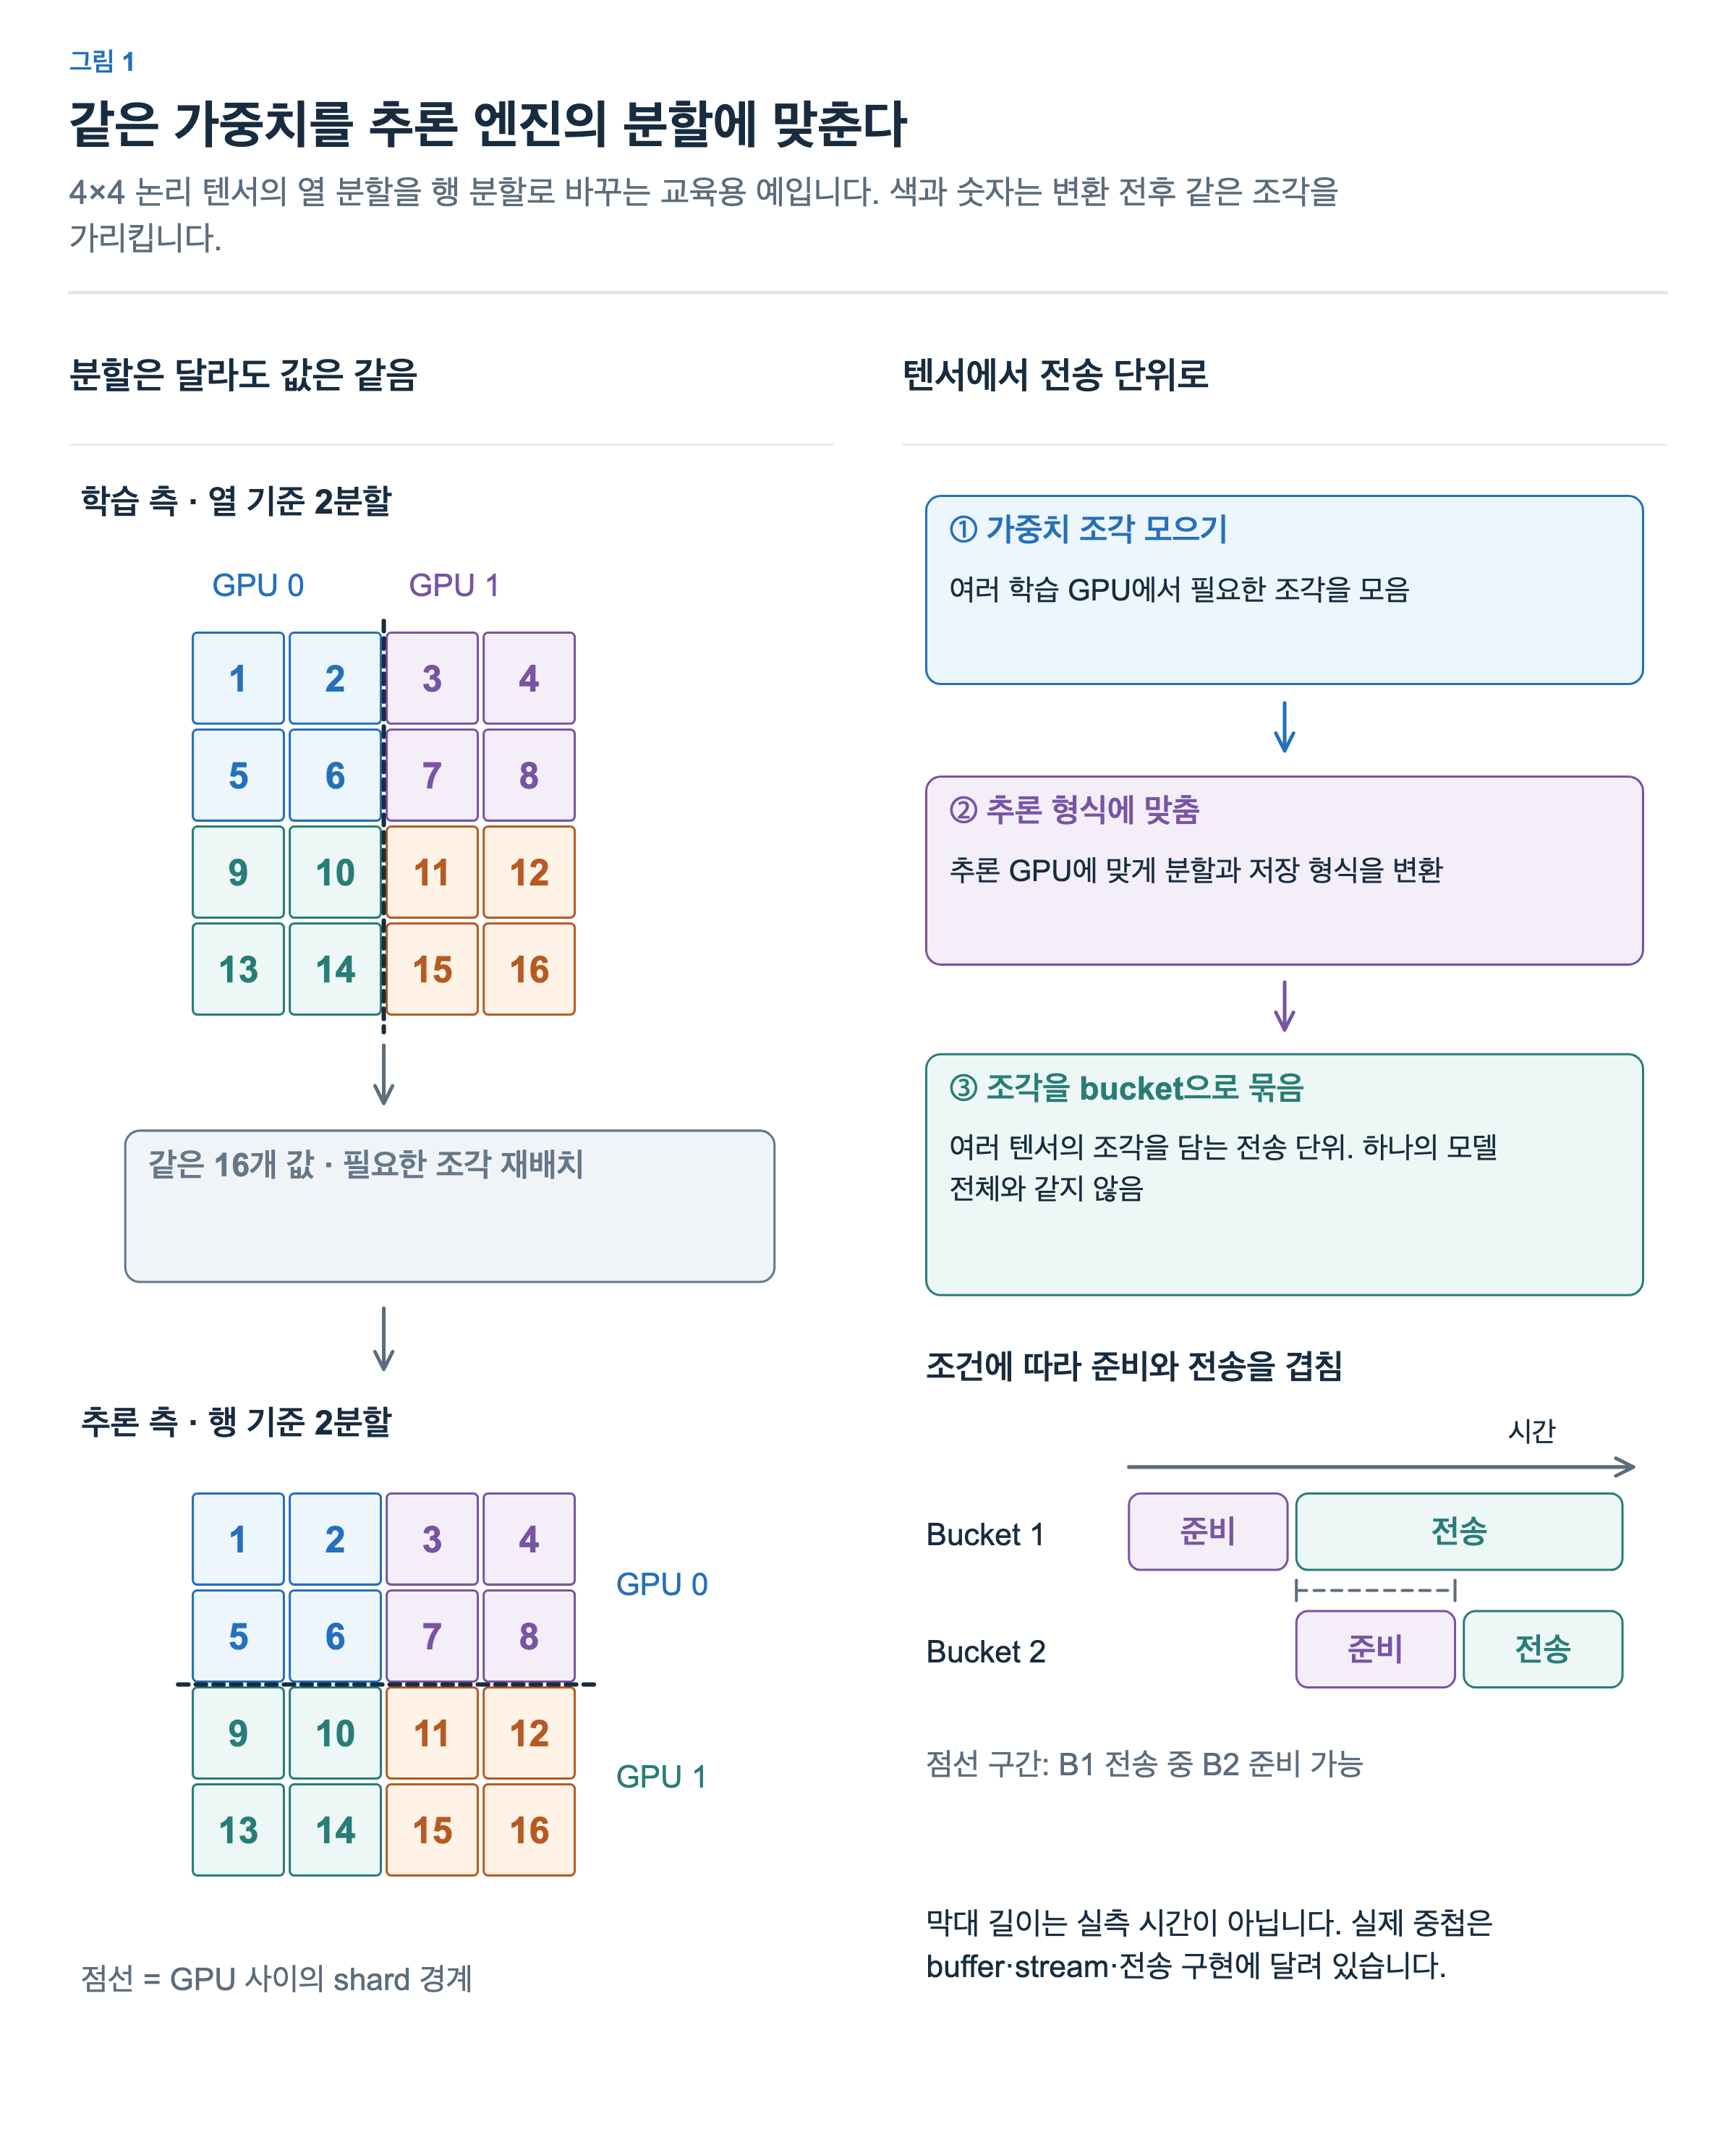
추론 GPU 0에 필요한 첫 행 [1, 2, 3, 4]를 보겠습니다. [1, 2]는 학습 GPU 0에, [3, 4]는 학습 GPU 1에 있습니다. 어느 학습 GPU의 메모리만 통째로 복사해서는 필요한 첫 행을 완성할 수 없습니다. 여러 위치의 조각을 받아 추론 측이 기대하는 순서로 배치해야 합니다. 이런 분할 변경을 resharding이라고 부릅니다.
실제 모델은 텐서가 많고 병렬화 방식도 다양합니다. Tensor parallelism(TP)은 한 텐서의 계산을 여러 GPU로 나누고, expert parallelism(EP)은 MoE 전문가를 나누어 배치합니다. 전문가 내부의 텐서를 나누는 ETP도 있습니다. 학습과 추론의 병렬 구성이 다르면 그 차이를 전달 과정에서 맞춰야 합니다.
Miles의 Megatron 경로에는 개별 weight의 TP·ETP 조각을 모으고, 필요하면 EP로 나뉜 전문가를 모으는 작업이 포함됩니다. 이렇게 개별 텐서를 모으는 것과 모든 가중치를 동시에 한 GPU에 모으는 것은 다릅니다. 전체 모델을 한 번에 담을 수 있어야만 weight sync가 가능한 것은 아닙니다. Miles v0.1.0 가중치 변환 코드
또한 텐서 이름, 여러 가중치를 합쳐 저장한 배열 방식, 자료형과 양자화 부가 정보도 추론기의 규약에 맞아야 합니다. 8편에서 본 양자화 값과 scale은 의미가 연결된 데이터입니다. 숫자 배열만 전달하고 대응하는 scale이나 분할 정보를 잘못 적용하면 같은 정책을 전달한 것이 아닙니다.
전송 단위를 묶고 준비를 겹치기
작은 텐서마다 독립적으로 전송을 시작하면 반복적인 호출 비용이 커질 수 있습니다. Bucket은 여러 텐서 또는 텐서 조각을 묶는 전송 단위입니다. 전체 모델을 하나의 bucket으로 만들어야 하는 것은 아닙니다.
그림 1의 아래에서는 bucket 1을 보내는 동안 bucket 2를 준비합니다. 이처럼 준비와 전송을 겹치면 순차적으로 기다리는 시간을 줄일 수 있습니다. 다만 버퍼가 여러 개 필요하거나 같은 메모리·통신 자원을 두고 경쟁할 수 있습니다. 모든 구현이 그림처럼 중첩되거나 항상 같은 이득을 얻는다는 뜻은 아닙니다.
Bucket을 크게 하면 호출 횟수는 줄어들 수 있지만 첫 전송을 시작하기까지 더 기다리고 임시 메모리가 커질 수 있습니다. 작게 하면 먼저 보내기 쉬운 대신 반복 비용이 늘 수 있습니다. 따라서 bucket 크기와 측정한 모델·분할 구성을 함께 보아야 합니다.
이 과정에서 추론에 필요한 모델 가중치를 전달하는 것과 학습을 완전히 복구할 checkpoint를 저장하는 것도 구별해야 합니다. Optimizer 상태처럼 학습 재개에 필요한 정보가 일반적인 추론 weight sync의 대상과 반드시 같지는 않습니다.
Broadcast, P2P, disk-delta의 경로
Miles v0.1은 분리 배치의 전송 방식으로 broadcast, P2P, disk-delta를 설명합니다. 아래 그림은 값이 지나가는 메모리와 저장소를 보여줍니다. 선의 길이가 짧다고 더 빠르다는 뜻은 아닙니다.
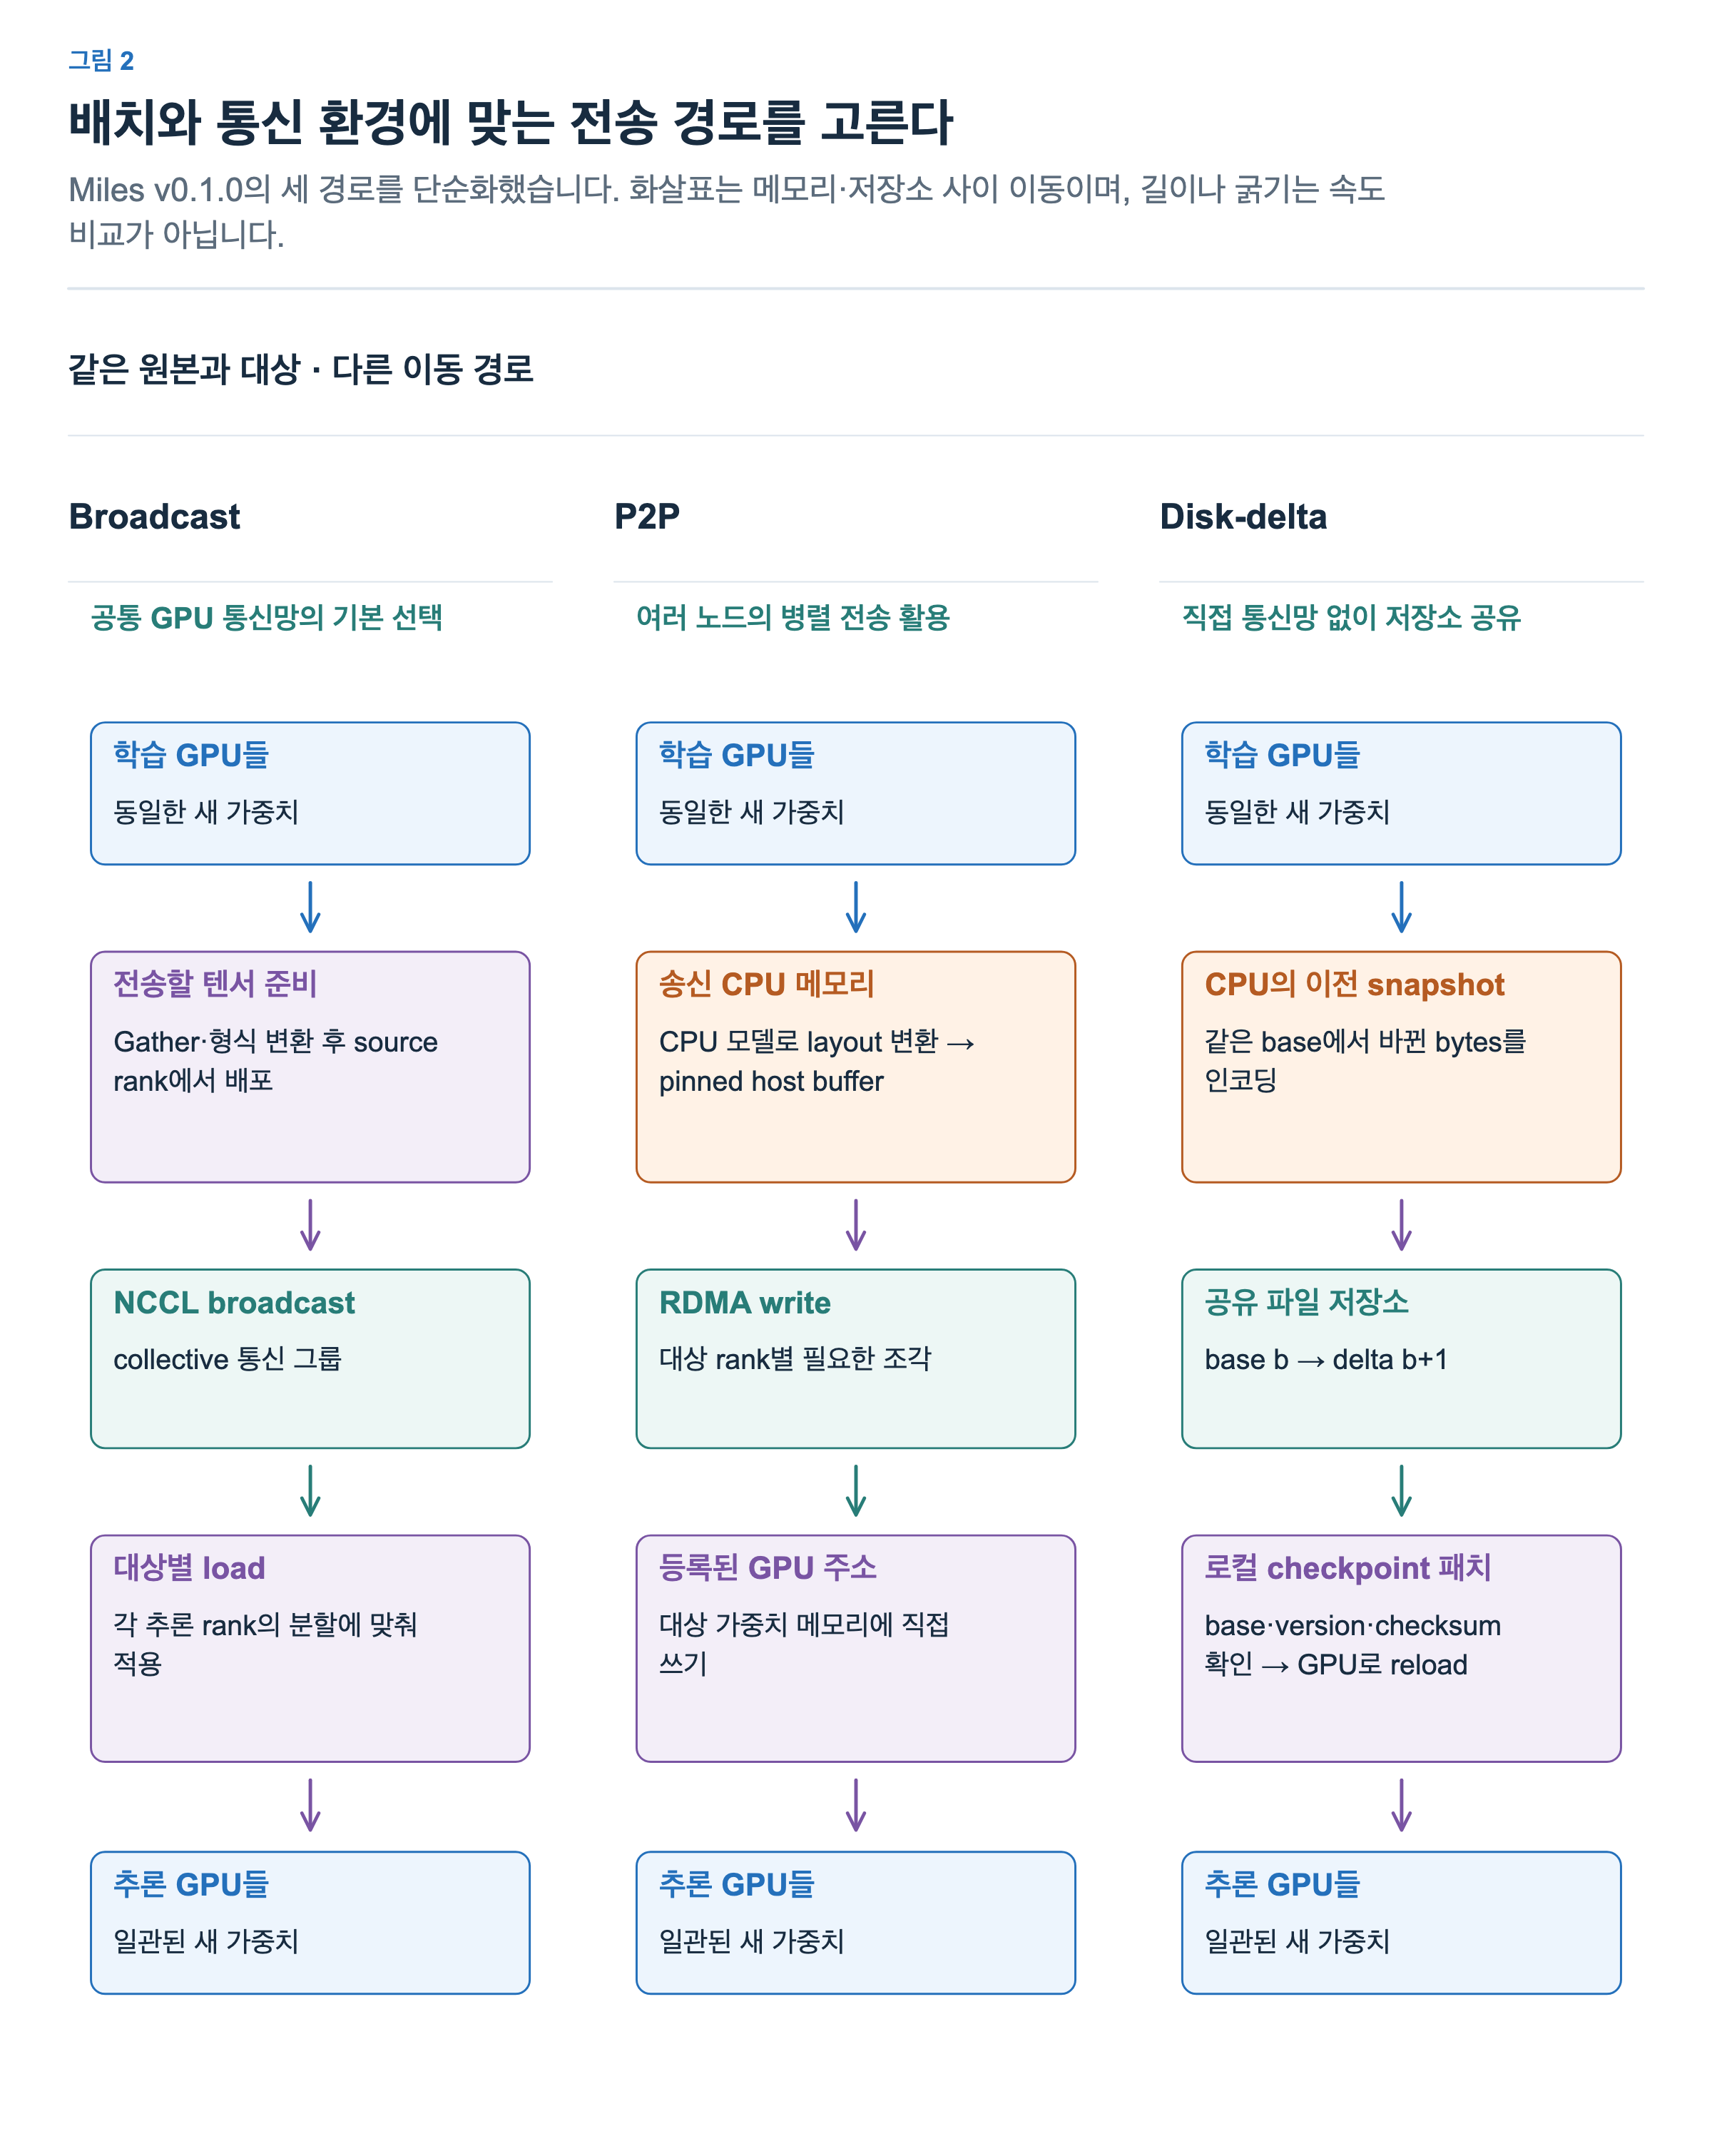
Broadcast는 준비한 가중치를 통신 그룹의 참여자들에게 배포합니다. NCCL은 여러 GPU가 함께 데이터를 주고받는 collective 통신에 사용하는 라이브러리입니다. 수신한 뒤에는 각 추론 rank, 즉 분산 실행의 참여 프로세스가 자신의 분할에 맞춰 가중치를 적용합니다. 실제 source와 통신 그룹의 구성은 병렬 배치에 따라 달라집니다.
P2P는 필요한 조각을 대상에 직접 전달하도록 구성한 경로입니다. 그러나 “대상을 직접 지정한다”는 사실과 “GPU에서 GPU로만 이동한다”는 사실은 다릅니다.
Miles의 이 구현은 학습 GPU의 weight를 추론용 배열로 변환하기 위해 송신 측 CPU 메모리에 둔 모델 사본에 적용하고, pinned host buffer를 사용합니다. Pinned memory는 전송 중 위치를 안정적으로 사용할 수 있게 고정한 호스트 메모리입니다. RDMA는 등록된 원격 메모리에 직접 데이터를 읽고 쓰는 통신 방식입니다. 이후 RDMA로 등록된 대상 추론 GPU의 weight 주소에 씁니다. 따라서 송신 CPU 메모리를 거치는 구간이 있습니다. Miles P2P 문서, 송신 코드, SGLang 수신 코드
RDMA를 사용한다는 말도 전체 경로에서 CPU 메모리가 사라진다는 뜻은 아닙니다. 이 구현의 장점과 비용은 source의 병렬 전송, 배열 변환, 송신 호스트 메모리에서 전송 데이터를 준비하는 단계, 연결망과 대상 후처리를 함께 포함해 판단해야 합니다. 여기서 고정한 수신 코드가 논문의 모든 성능 실험에 사용된 정확한 revision이라는 주장도 아닙니다.
Disk-delta는 공유 저장소를 통해 변경 데이터를 전달합니다. 이때 delta는 수학적으로 새 weight에서 이전 weight를 뺀 값과 동일한 개념이 아닙니다. Miles 경로는 이전 snapshot에 대응하는 byte 변경을 인코딩하고, 수신 측의 일치하는 기준 checkpoint에 적용한 뒤 GPU로 읽는 방식입니다. 기준 버전이 어긋나면 변경 데이터만으로 올바른 새 상태를 만들 수 없습니다. Miles disk-delta 코드
파라미터 값의 변화가 작아도 그 byte 표현이 얼마나 바뀌고 압축되는지는 별도 문제입니다. Delta가 항상 작다고 가정할 수 없으며 저장·읽기·패치·reload 비용도 남습니다. 이 구현은 파일을 받아 로컬 checkpoint를 패치하는 작업을 생성과 겹칠 수 있고, 실제 GPU 가중치를 reload하기 전에 생성을 멈춥니다. 따라서 전송 전체 동안 반드시 생성이 멈춰 있는 것은 아닙니다.
학습과 추론이 같은 GPU를 번갈아 쓰는 구성에는 local 전달이나 프로세스 간 메모리 공유인 IPC 같은 다른 경로가 가능합니다. 위 세 가지와 한 줄의 보편적인 속도 순위로 묶기 어렵습니다. 또한 여기서 설명한 Megatron 경로의 옵션을 FSDP 등 다른 학습 backend가 그대로 지원한다고 가정해서는 안 됩니다.
환경에 맞는 전송 방식 고르기
세 방식의 선택 기준은 모델 크기뿐 아니라 양쪽의 노드 수와 사용할 수 있는 통신 경로입니다.
| 방식 | 먼저 고려할 상황 |
|---|---|
| Broadcast | 공통 GPU 통신망에서 기본 선택. 특히 노드 수가 적을 때 |
| P2P | 학습과 추론이 각각 여러 노드에 걸쳐 있을 때 |
| Disk-delta | 직접 GPU 통신망이 없거나 전체 전송량이 부담일 때 |
Miles 논문에서는 단일 노드의 P2P가 broadcast보다 느렸고, 학습·추론 양쪽의 노드 수가 늘수록 P2P의 이득이 커졌다고 보고합니다. 여러 송신자의 대역폭을 함께 활용하고 불필요한 조각 전송을 줄일 수 있기 때문입니다. 작은 구성에서는 이런 이득보다 CPU에서 가중치를 준비하는 비용이 두드러질 수 있습니다. 이는 논문의 측정 조건에서 관찰한 결과이며, 모든 배치의 속도 순위를 정하는 규칙은 아닙니다. Miles v0.1, §4.2–4.3
새 가중치로 생성을 재개하기
이제 이전 배포 버전 v20에서 새 가중치 v21로 바꾼다고 해보겠습니다. 같은 추론 실행에 참여하는 GPU A/B가 있고, 이 모델은 가중치를 받은 뒤 재양자화가 필요하다고 가정합니다. 아래는 기존 생성을 정리하고 멈춘 뒤 갱신하는 예입니다. 사용 중인 추론 가중치를 처음 변경하기 전에 진행 중인 생성을 안전하게 멈추거나 완료시켰다는 전제가 있습니다.
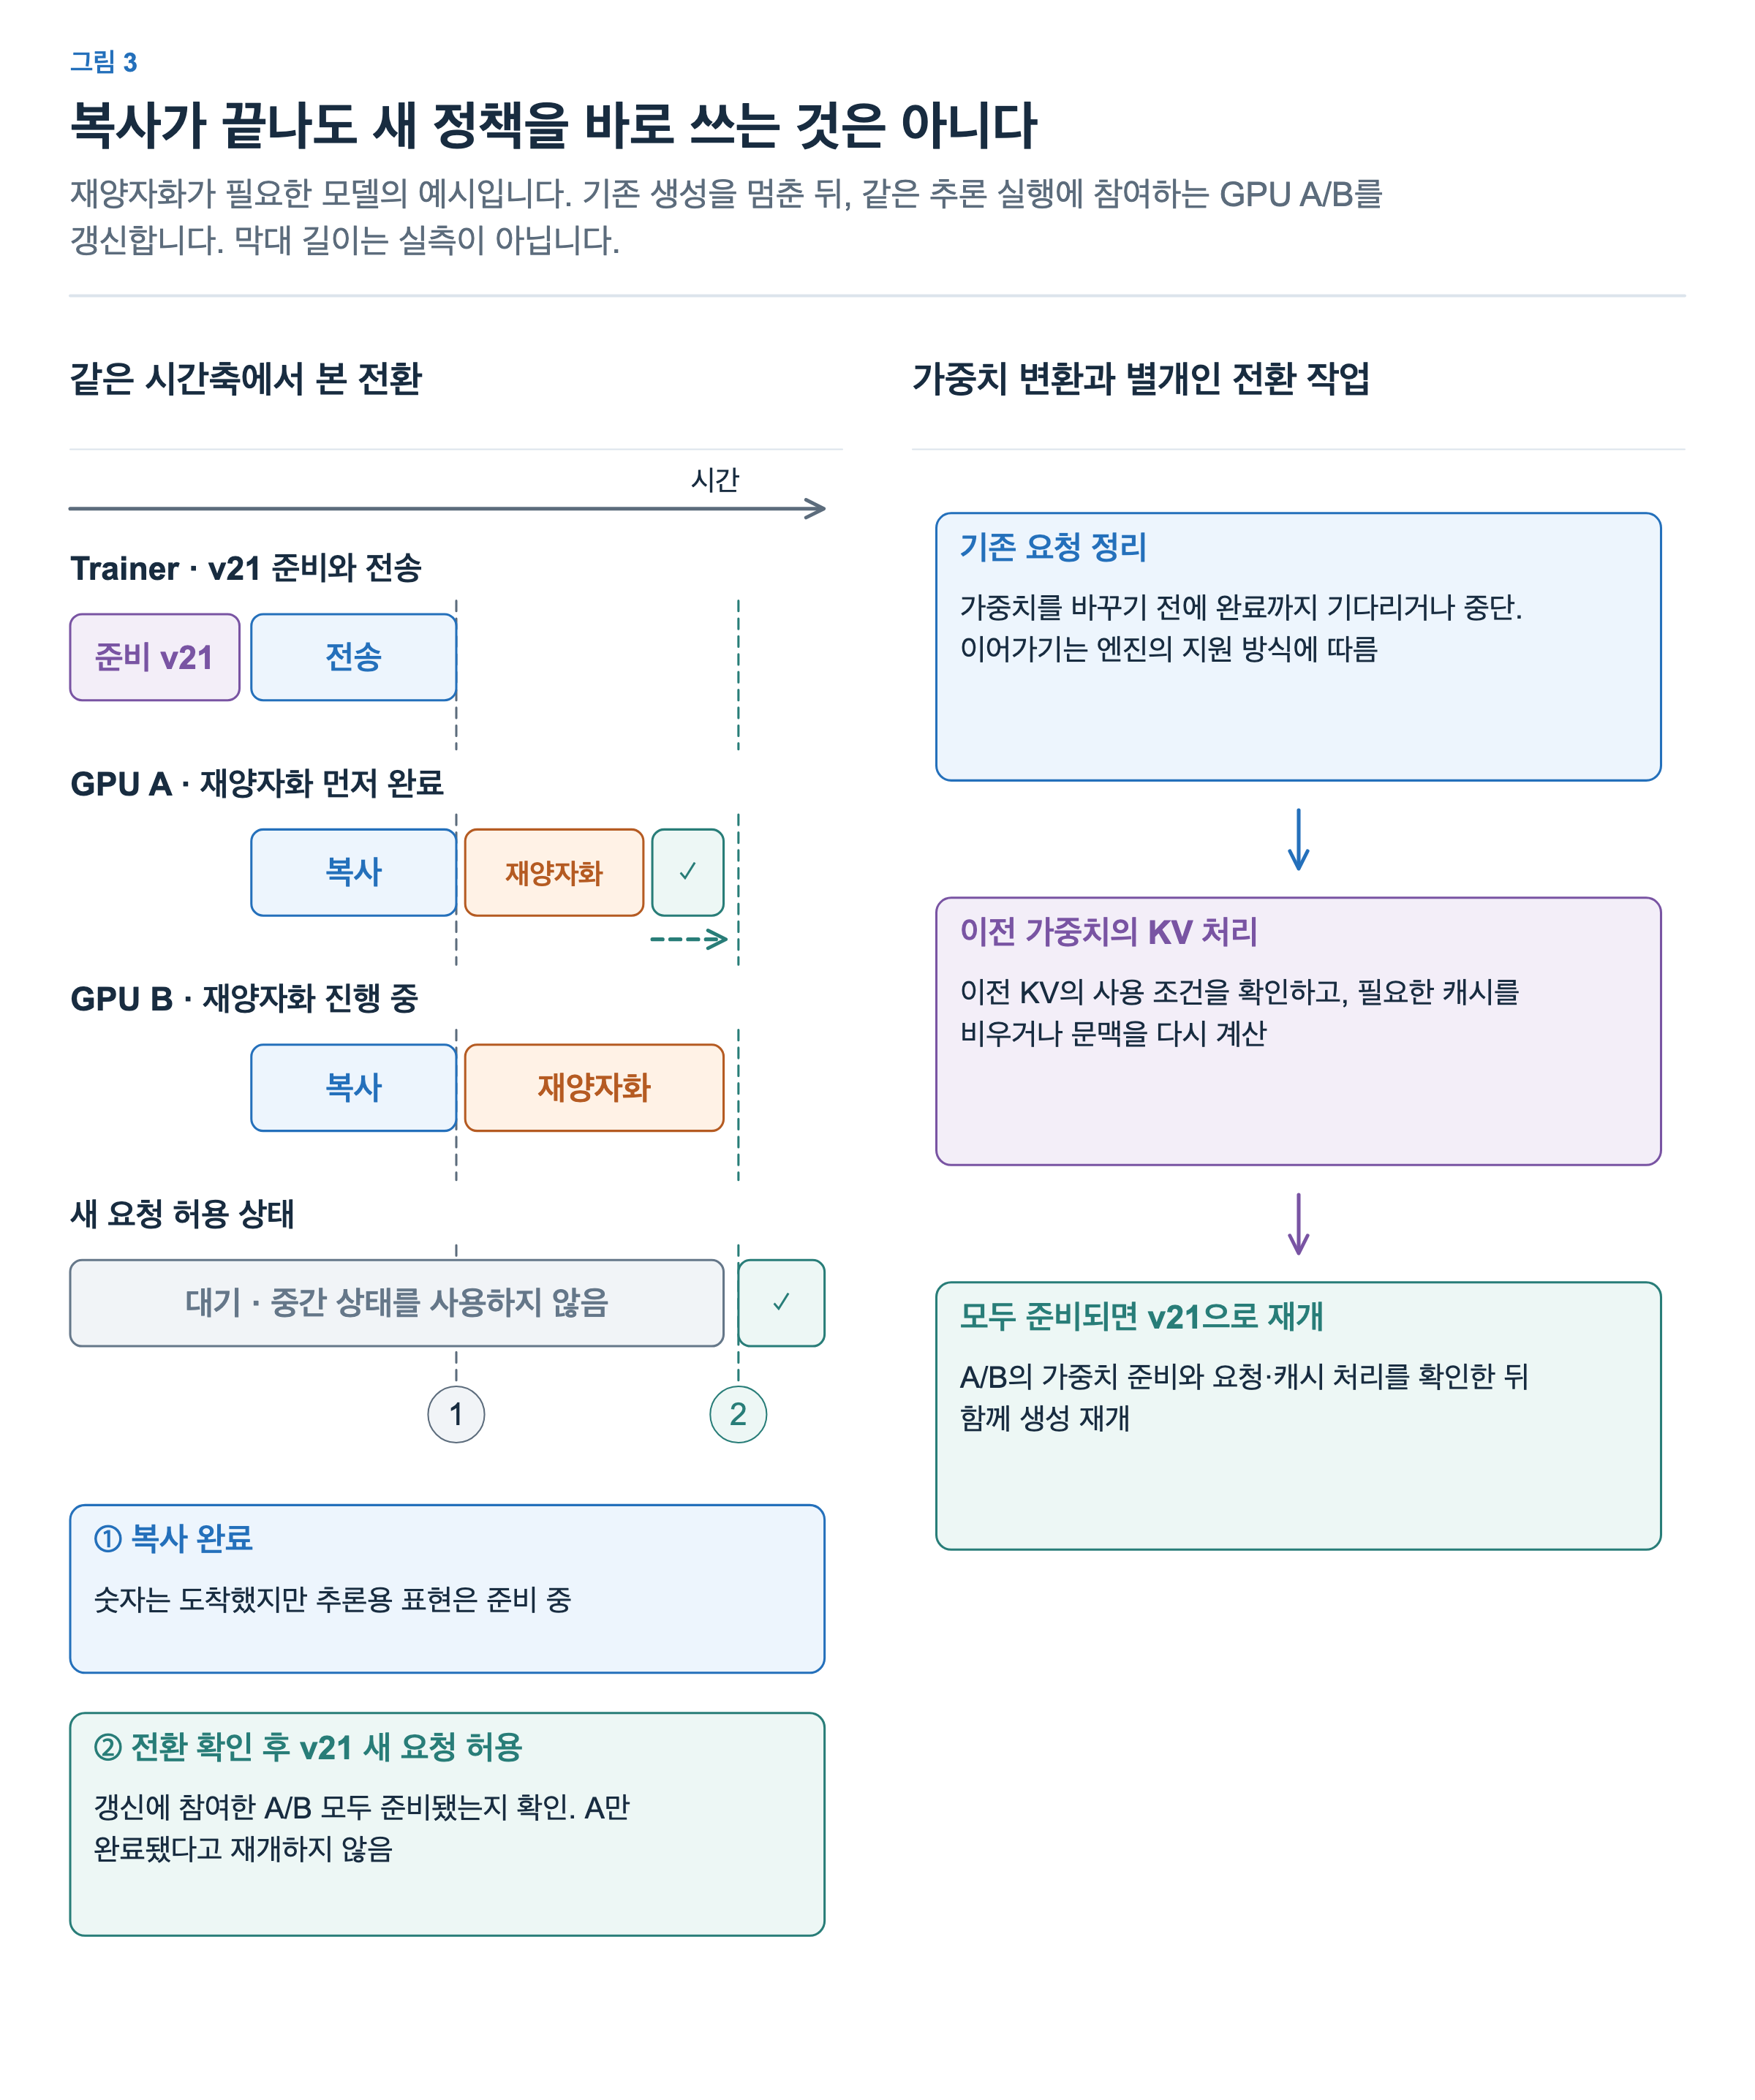
그림에서 A와 B의 복사는 같은 시점에 끝납니다. A는 재양자화를 먼저 마치지만 B는 아직 변환 중입니다. 이 전환 규약에서는 A가 준비됐다는 이유만으로 전체 생성을 재개하지 않습니다. 같은 계산에 참여하는 두 GPU가 모두 일관된 새 가중치를 사용할 준비가 되었는지 확인합니다.
여기서 재양자화는 전달받은 가중치를 추론 커널이 사용할 저정밀도 표현으로 다시 만드는 작업입니다. 필요한 양자화 값과 scale 등의 준비가 끝나야 해당 커널로 계산할 수 있습니다. 숫자가 GPU에 도착한 시점과 추론용 표현이 준비된 시점이 다른 이유입니다. Miles 논문의 Kimi K2 측정에는 전송 후 GPU 재양자화 약 884ms가 포함되어 있습니다. 그림의 막대는 그 시간을 재현한 것이 아니라 순서를 보여주는 예시입니다. Miles v0.1, 표 8
모든 모델이 수신 후 재양자화를 하는 것은 아닙니다. 구현에 따라 추론 커널이 기대하는 순서로 가중치를 재배열하거나 묶어 저장하는 작업도 필요할 수 있습니다. 이런 준비를 송신 측에서 끝냈다면 수신 측에서 같은 작업을 반복할 필요는 없습니다. 앞의 준비 단계와 이 단계는 같은 변환을 무조건 두 번 수행한다는 뜻이 아닙니다.
기존 요청과 KV 캐시 처리는 가중치 자체의 변환과 별개의 전환 작업입니다. 그림 오른쪽은 생성을 재개하기 전에 함께 확인할 항목을 보여줍니다. 버전 문자열을 v21로 바꾸기만 해서는 준비 완료가 보장되지 않으므로, 새 요청을 받는 시점을 실제 완료 신호와 연결해야 합니다.
진행 중이던 v20 요청에는 여러 선택이 가능합니다. 끝날 때까지 기다리거나, 중단하고 다시 시도하거나, 지원되는 방식으로 일부 생성을 이어갈 수 있습니다. 어느 경우든 실제 생성 버전을 기록해야 합니다. 하나의 응답 중간에 정책이 바뀐다면 10편에서 본 것처럼 더 세밀한 버전 기록이 필요할 수 있습니다.
이전 가중치로 계산한 KV도 확인해야 합니다. 같은 토큰이라고 새 가중치와 이전 KV를 무조건 함께 사용할 수는 없습니다. 어떤 캐시를 무효화하고 어떤 문맥을 다시 계산하는지는 엔진의 갱신 규약을 따라야 합니다. 모든 시스템이 동일하게 전체 캐시를 비운다고 단정할 수는 없습니다.
전체 fleet을 한꺼번에 멈추지 않고 worker를 차례로 전환하는 구성도 생각할 수 있습니다. 그때는 어떤 요청이 어느 버전의 일관된 worker 집합에서 실행되는지 관리해야 합니다. 그림은 그 모든 배포 방식을 규정하는 것이 아니라, 일부 텐서만 갱신된 중간 상태에서 생성을 시작하지 않는 조건을 보여줍니다.
동기화 빈도와 전체 시간을 함께 보기
가중치를 자주 전달하면 생성기가 더 최근 정책을 쓰기 쉽지만 변환·통신·재개 비용이 자주 발생합니다. 덜 자주 전달하면 그 비용을 줄이는 대신 학습 중인 정책과 생성 정책의 차이가 커질 수 있습니다. 10편의 staleness 관리와 같은 결정에 연결됩니다. 설정의 갱신 주기가 rollout 반복 기준인지 실제 optimizer update 기준인지도 확인해야 합니다. 두 횟수는 자동으로 같은 단위가 아닙니다.
짧은 학습 업데이트마다 큰 모델을 전달한다면 weight sync 시간이 업데이트 시간보다 클 수도 있습니다. 이는 학습 연산량, 전달 크기, GPU·노드 배치와 연결망에 따라 달라지는 조건부 상황입니다. 항상 생성이 가장 오래 걸린다거나, 어떤 전송 방식이 항상 가장 빠르다고 정해 둘 수 없습니다.
측정에는 전송 바이트뿐 아니라 재분할·형식 변환, 실제 이동, 적용·후처리, 확인·재개를 포함해야 합니다. KV를 다시 계산해서 첫 요청이 느려진다면 그 비용도 관찰할 필요가 있습니다. 순수 네트워크 전송은 빨라졌는데 전체 RL은 빨라지지 않았다면, 비용이 다른 단계로 이동했는지 볼 수 있습니다.
새 가중치가 추론 엔진에 적용되면 다시 경험을 생성할 수 있습니다. 경험을 생성하고, 보상을 바탕으로 학습하고, 새 가중치를 전달하는 순환으로 이 시리즈를 마무리합니다. 각 단계의 계산과 함께 경험과 가중치가 엔진 사이를 어떻게 이동하는지 살펴보면 RL 시스템의 전체 흐름을 이해할 수 있습니다.