학습 · 2026-10-05
학습 한 스텝: Forward에서 가중치 업데이트까지
다음 토큰의 확률로 loss를 계산하고, backward에서 wgrad와 xgrad를 만든 뒤 optimizer가 가중치를 바꾸는 과정을 작은 수치와 실제 모델로 따라갑니다.
LLM의 전체 구조에서 입력 토큰이 벡터로 바뀌고, 여러 층을 거쳐 다음 토큰의 점수인 logits가 만들어지는 과정을 살펴봤습니다. 추론에서는 이 점수로 토큰을 선택합니다. 학습에서는 정답에 준 확률을 평가하고, 그 평가를 바탕으로 모델의 가중치를 바꿉니다.
이번 글에서는 학습 한 스텝을 따라가겠습니다. Forward로 예측을 만들고, 정답과 비교해 loss를 계산합니다. Backward는 이 loss가 각 가중치에 얼마나 민감한지 계산하며, optimizer가 그 결과를 사용해 새 가중치를 씁니다. 특히 backward에서 현재 층의 가중치를 위한 gradient와 이전 층으로 전달할 gradient가 어떻게 갈라지는지 살펴보겠습니다.
학습 한 스텝의 흐름
모델이 I like를 읽었다고 생각해 보겠습니다. 추론에서는 이어질 토큰 하나를 골라 입력 뒤에 붙입니다. 학습 문장이 I like AI라면 이미 다음 정답인 AI를 알고 있으므로, 모델이 AI에 얼마나 높은 확률을 주었는지 평가할 수 있습니다.
그림 1은 이 평가가 가중치 변경으로 이어지는 전체 경로입니다. 주황색은 loss와 gradient, 보라색은 optimizer의 업데이트입니다.
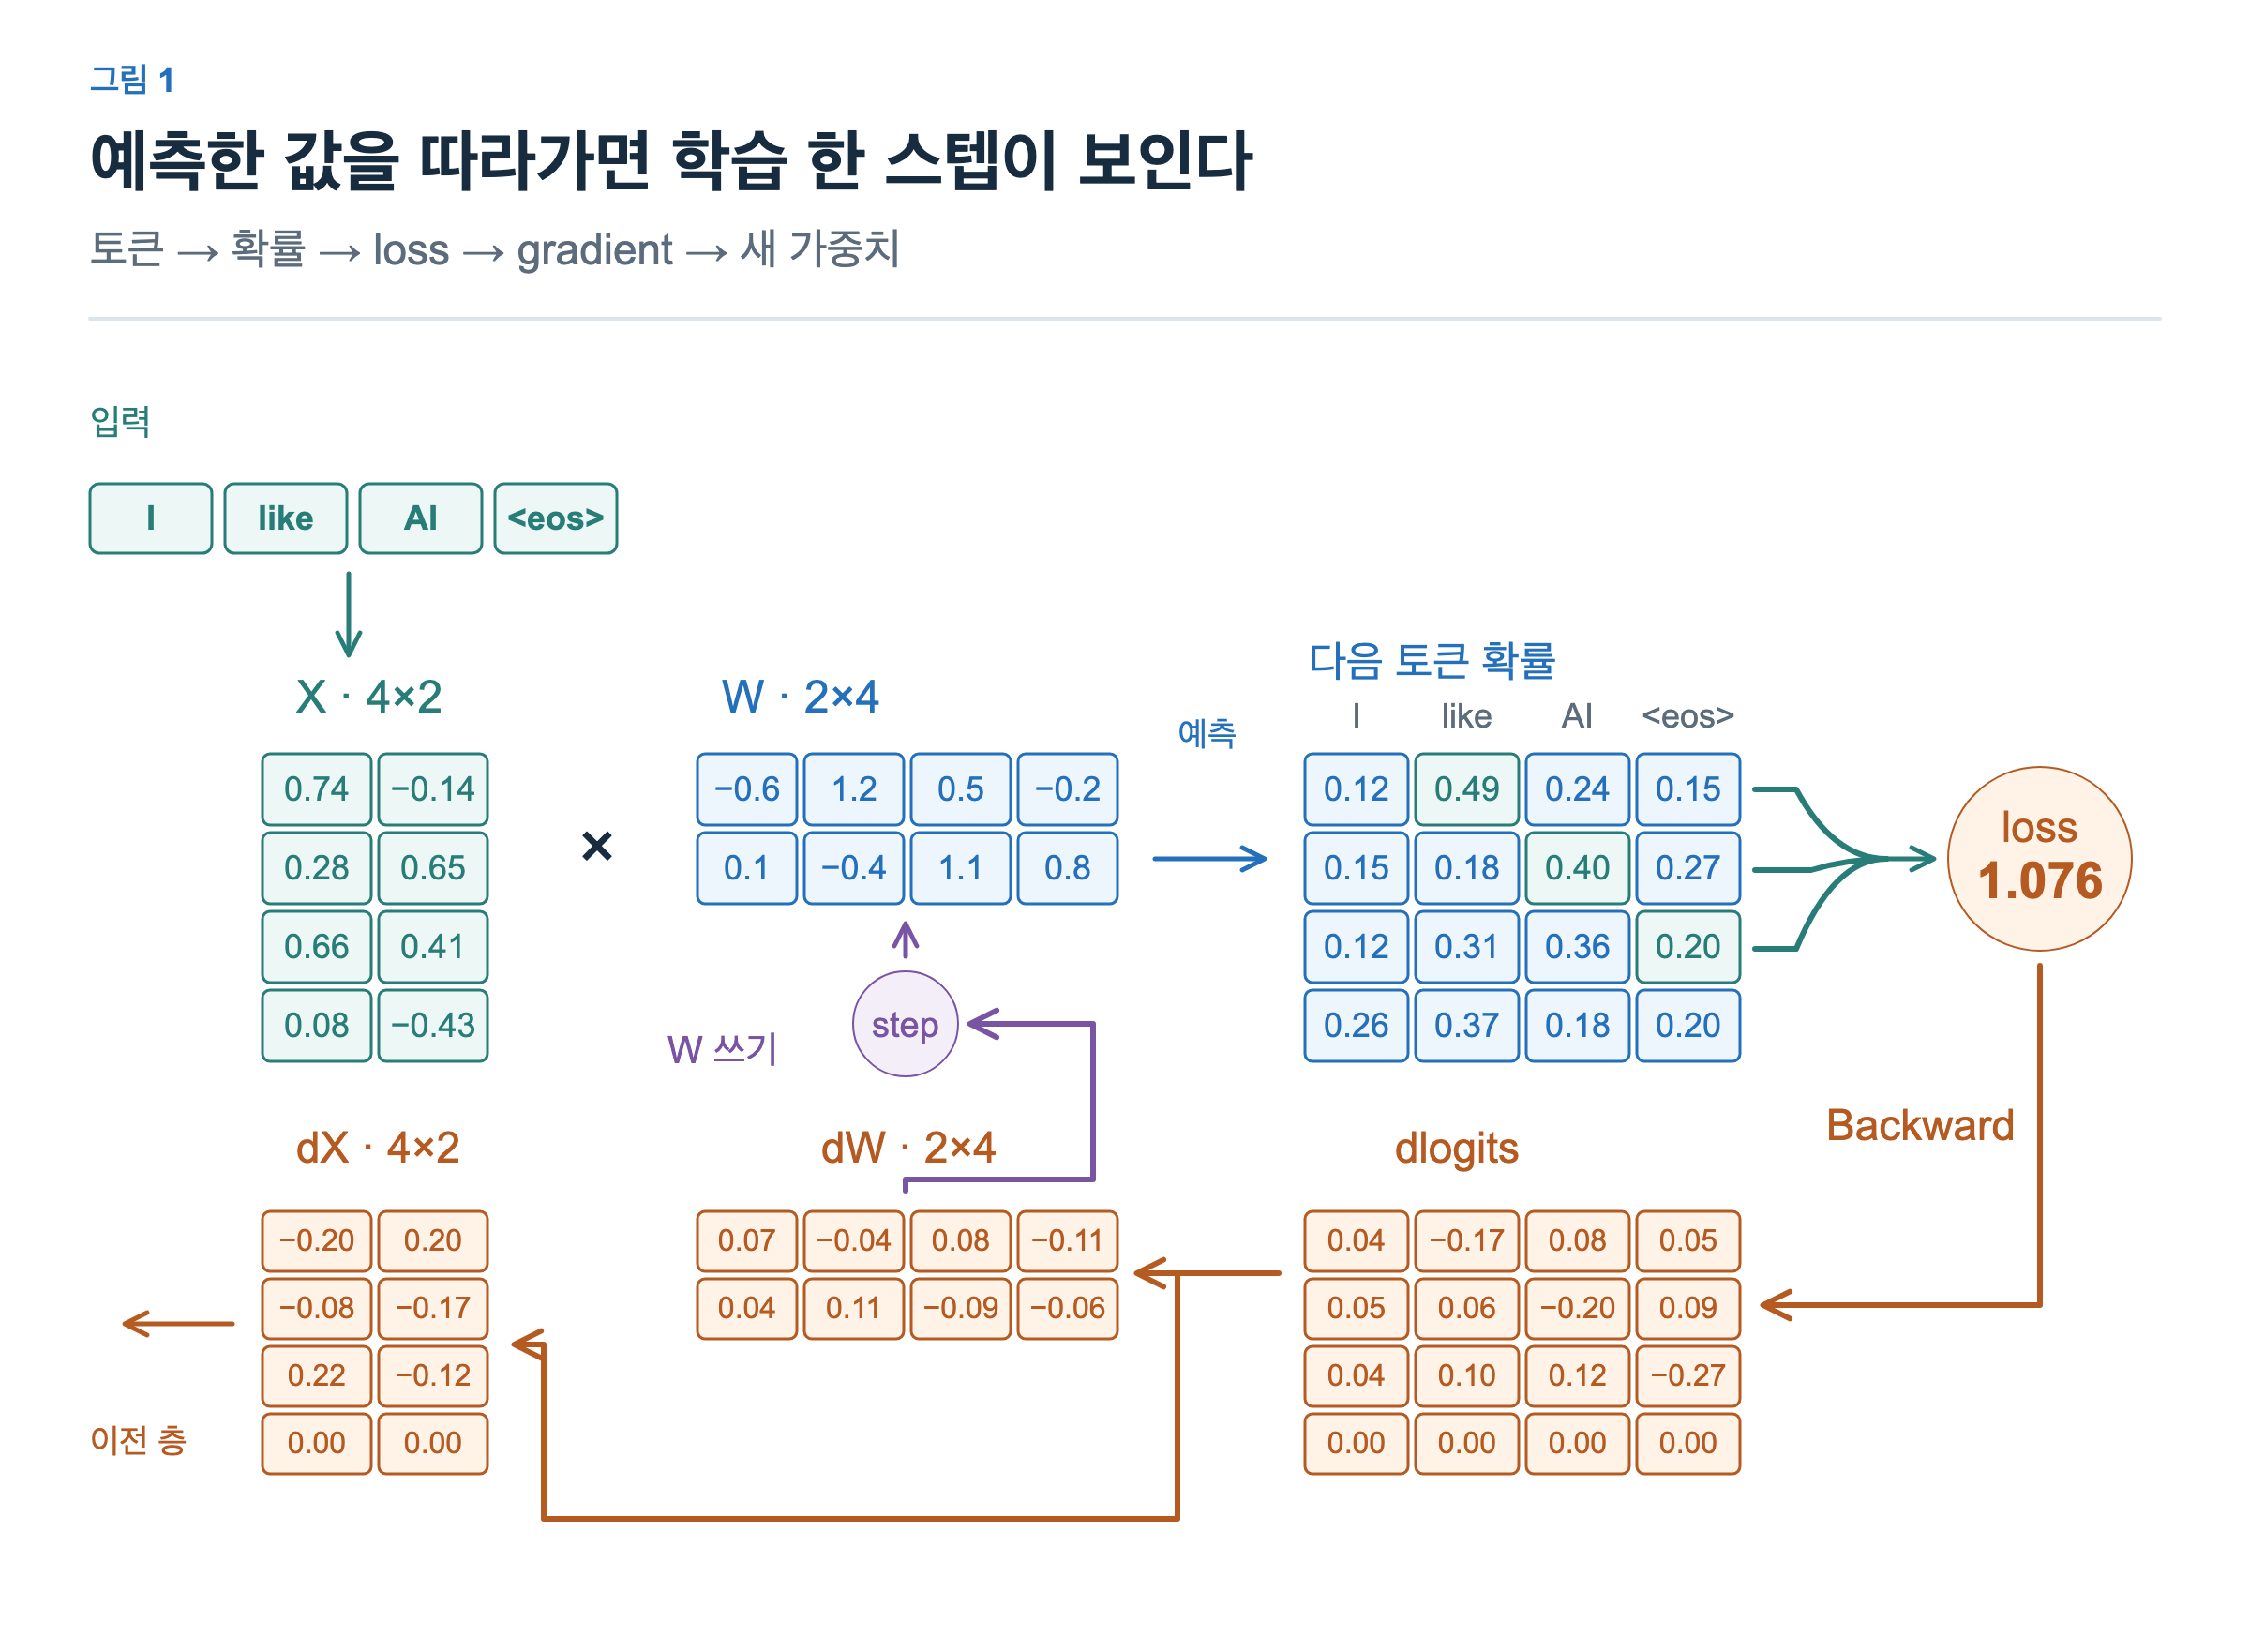
Forward는 현재 가중치로 예측을 만들고, backward는 가중치를 바꾸기 위한 gradient를 만듭니다. 실제로 가중치 값을 바꾸는 동작은 optimizer update입니다. loss.backward()를 호출했다고 해서 학습 한 스텝이 끝난 것은 아닙니다.
그림의 숫자는 계산을 따라가기 위한 작은 CPU 예제에서 얻었습니다. 어휘는 I, like, AI, <eos> 네 개이며, 문맥을 섞는 attention은 생략했습니다. 실제 LLM의 품질이나 GPU 성능을 보여 주는 결과가 아닙니다. 뒤에서 별도의 허깅페이스 모델을 실행해 같은 네 단계가 실제 모델에서도 이어지는지 확인하겠습니다.
각 위치가 다음 토큰을 예측합니다
Forward의 출력은 마지막 위치의 예측 하나만이 아닙니다. 입력에 네 토큰이 있다면 각 위치에서 어휘 전체에 대한 logits가 나옵니다. 배치 크기를 B, 입력 길이를 T, 어휘 크기를 V라고 하면 출력의 형태는 [B, T, V]입니다.
생성할 때는 마지막 입력 위치의 logits를 사용합니다. 반면 학습에서는 각 위치의 출력을 바로 다음 위치의 정답과 연결합니다. 그림 2에서 열은 입력 위치, 행은 어휘입니다. 청록색 칸은 그 위치에서 맞혀야 할 다음 정답의 확률입니다.
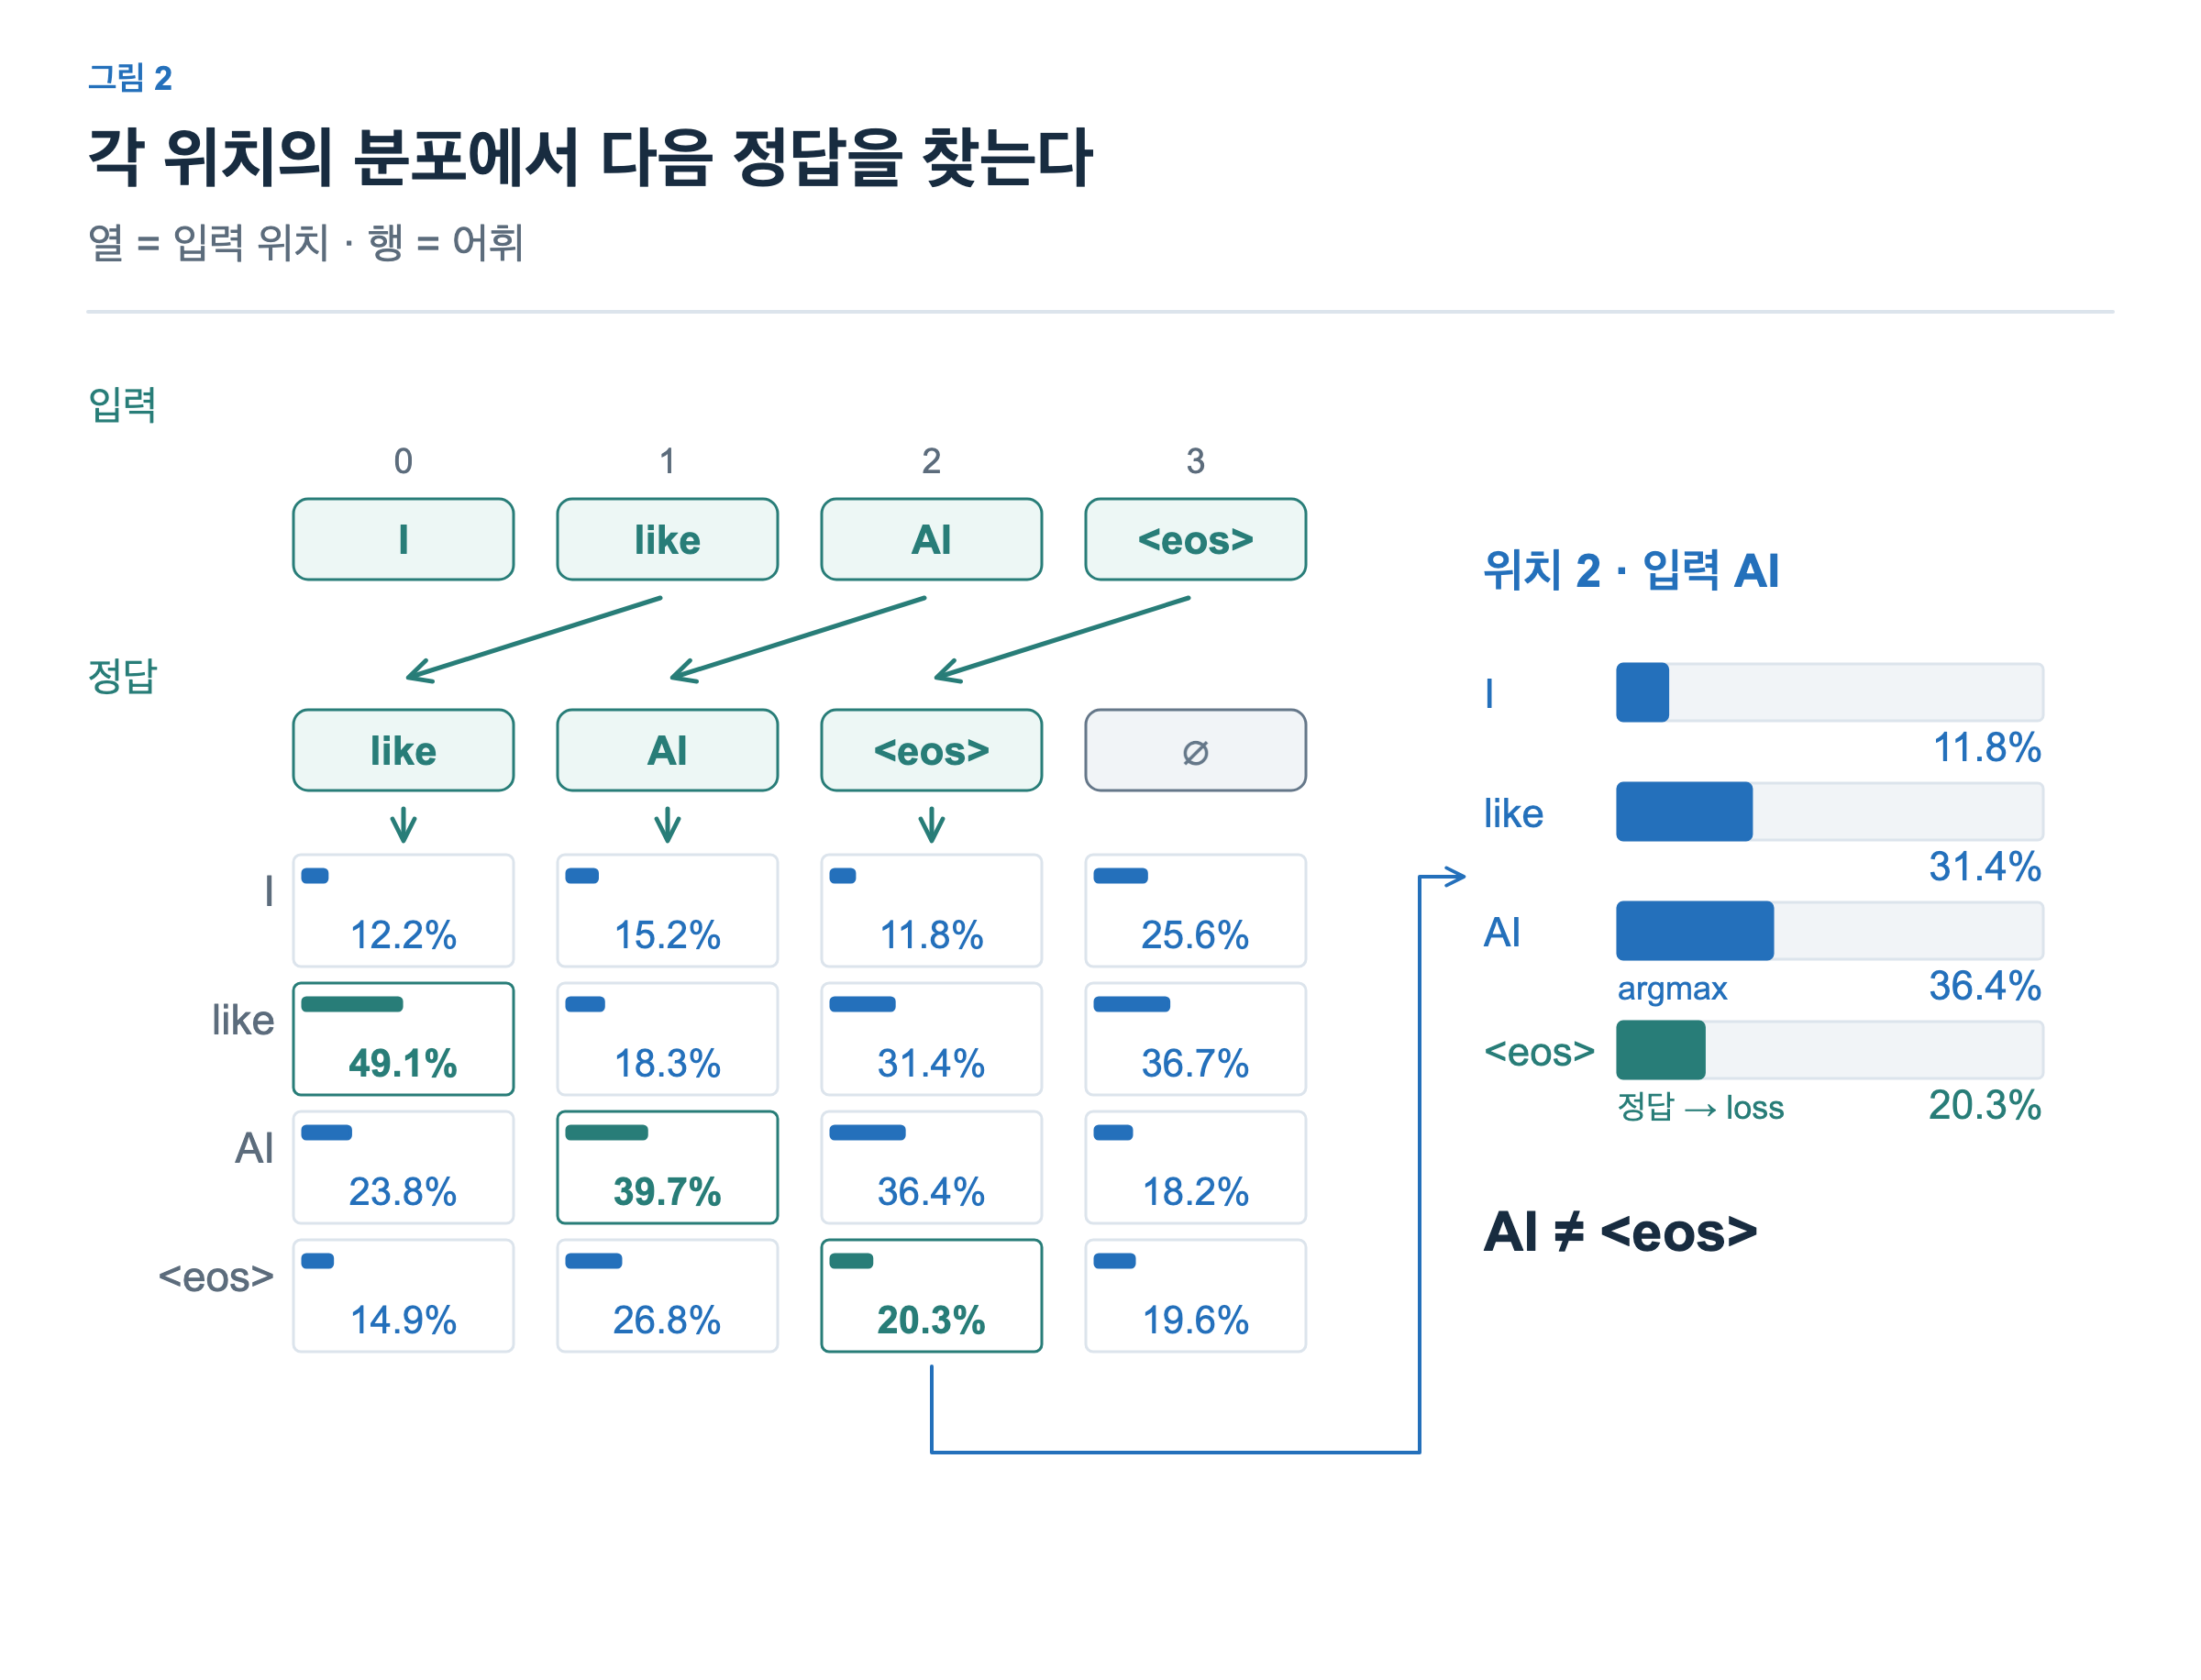
그림의 토큰열을 실제 causal LLM에 넣으면, 위치 0은 I를 읽고 like를 예측합니다. 위치 1은 I like까지 읽고 AI를 예측합니다. 위치 2는 I like AI까지 읽고 문서의 끝을 나타내는 <eos>를 예측합니다. 마지막 <eos> 위치에도 출력은 있지만, 이 예제 안에는 그다음 정답이 없으므로 loss에 포함하지 않습니다.
이때 입력에 정답 문장 전체가 들어 있어도 각 위치가 미래 토큰을 읽을 수 있는 것은 아닙니다. Causal attention은 현재 위치와 그 앞의 위치만 읽도록 제한합니다. 따라서 AI를 맞혀야 하는 위치 1이 입력 위치 2의 AI를 미리 볼 수 없습니다. 그림의 작은 CPU 모델에는 attention이 없지만, 실제 causal LLM에서는 이 경계가 필요합니다.
학습에서는 앞선 위치에 모델이 생성한 토큰을 넣는 대신 데이터에 있는 토큰을 넣습니다. 이렇게 정답 prefix를 주고 다음 토큰을 예측하는 방식을 teacher forcing이라고 합니다. 한 번의 forward로 여러 위치의 예측을 함께 계산할 수 있습니다. Hugging Face의 causal language modeling 설명도 같은 다음 토큰 예측 목적을 사용합니다.
그림 2의 위치 2에서 가장 높은 확률을 받은 토큰은 AI입니다. 하지만 정답은 <eos>입니다. 학습은 “가장 큰 확률의 토큰을 골랐는가”만 평가하지 않습니다. 정답 토큰에 부여한 확률을 사용합니다. 정답을 argmax로 맞힌 경우에도 정답 확률이 0.51일 때와 0.99일 때의 평가는 다릅니다.
정답 확률을 loss로 바꿉니다
정답에 준 확률을 p라고 하겠습니다. p가 클수록 작은 값을, p가 작을수록 큰 값을 내는 평가가 필요합니다. 다음 토큰 학습에서 사용하는 cross-entropy, 줄여서 CE loss는 정답 확률에 음의 자연로그를 취한 값입니다.
정답 확률이 1이면 loss는 0입니다. 확률이 0.5이면 약 0.693, 0.1이면 약 2.303입니다. 정답에 거의 확률을 주지 않을수록 loss가 크게 증가합니다. 그림 3의 곡선이 이 관계를 보여 줍니다.
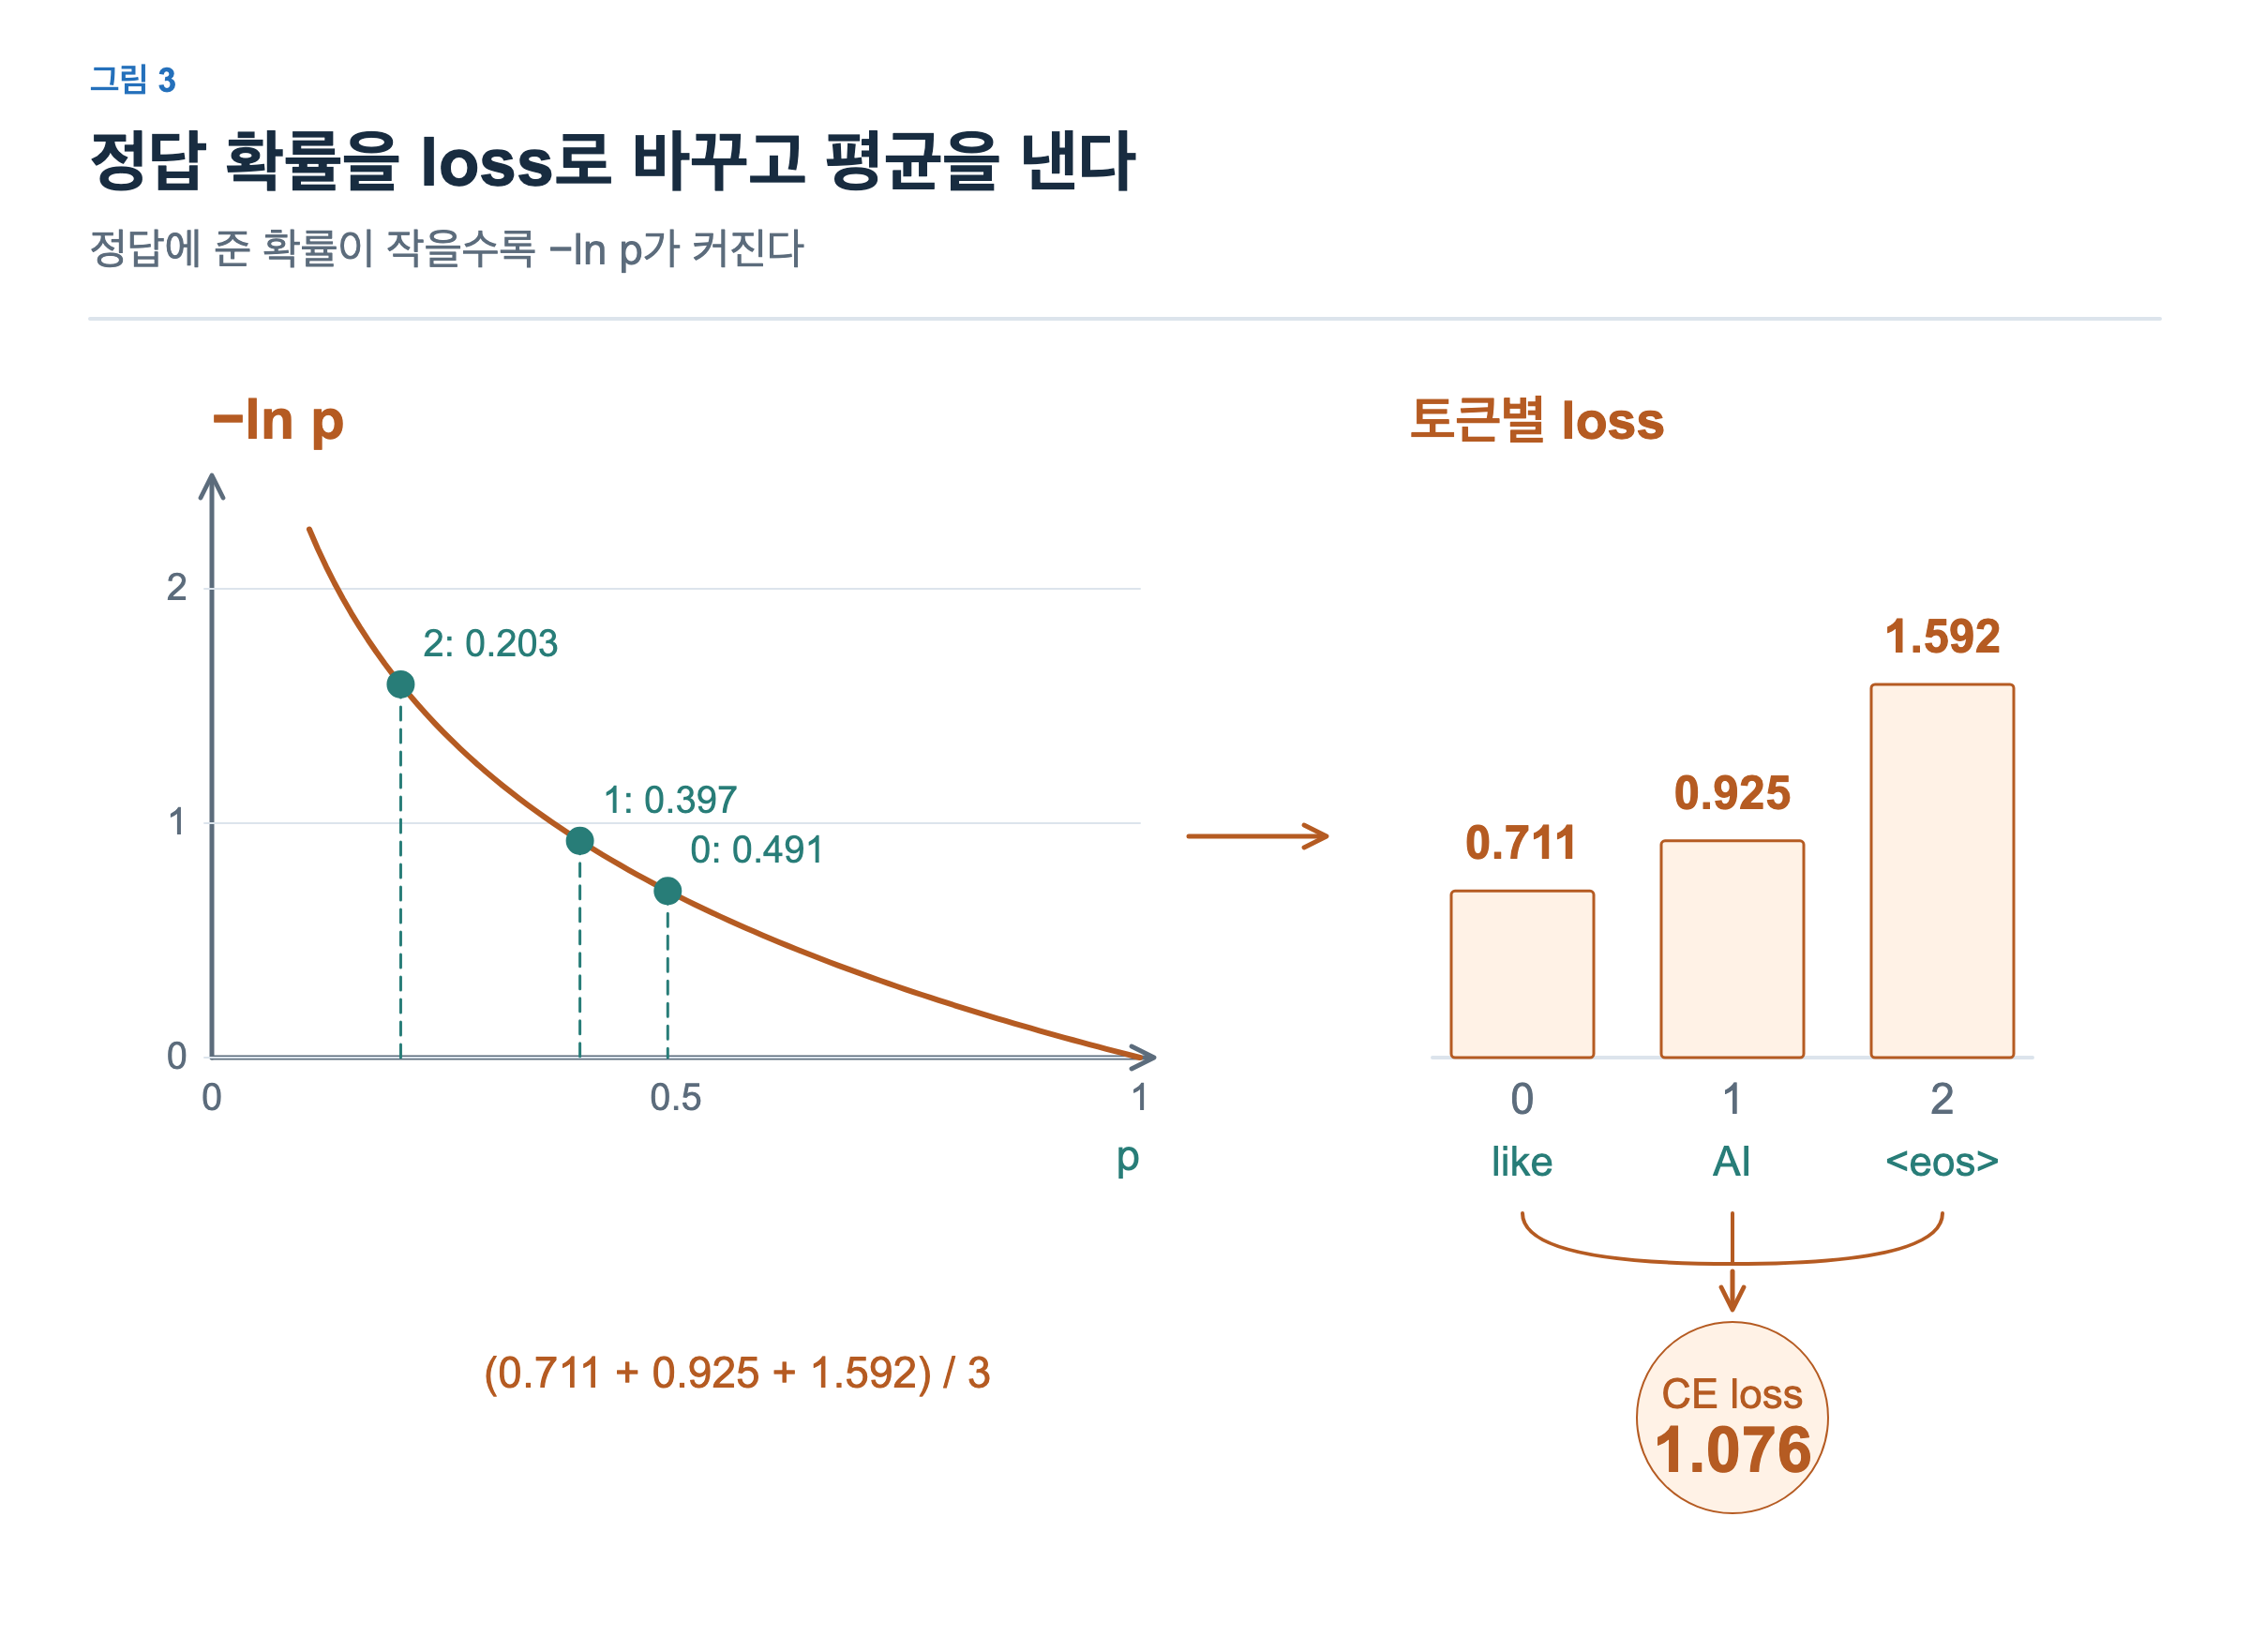
그림 2에서 고른 정답 확률 세 개는 약 0.491201, 0.396573, 0.203472입니다. 음의 자연로그를 취하면 토큰별 loss는 약 0.710903, 0.924894, 1.592225가 됩니다. 이 세 값을 평균한 1.076007이 예제의 CE loss입니다. 그림에는 반올림해 1.076으로 표시했습니다.
분모가 입력 길이 4가 아니라 유효한 정답 수 3이라는 점도 중요합니다. 마지막 위치처럼 정답이 없거나 padding인 위치는 합과 분모에서 제외합니다. 문서 경계와 padding을 다루는 데이터 파이프라인은 준비편의 주제이며, 여기서는 패딩 없는 한 문서만 사용합니다.
그림은 이해를 돕기 위해 logits를 확률로 바꾼 뒤 정답 칸을 고릅니다. 실제 코드는 확률에 직접 로그를 취하기보다 logits를 입력으로 CE를 안정적으로 계산합니다. argmax나 sampling으로 토큰 하나를 고르는 과정은 loss 계산에 들어가지 않습니다. PyTorch의 cross_entropy는 어휘별 logits와 정답 ID를 받습니다.
import torch.nn.functional as F

# logits: [B, T, V], input_ids: [B, T]
# 한 문서, padding 없음
prediction = logits[:, :-1, :]  # 마지막 위치는 다음 정답이 없음
answer = input_ids[:, 1:]       # 다음 위치의 토큰이 정답
loss = F.cross_entropy(
    prediction.reshape(-1, prediction.shape[-1]),
    answer.reshape(-1),
)
이렇게 예측과 정답을 한 칸 어긋나게 맞추는 것을 shift라고 합니다. 허깅페이스의 causal LM에 labels=input_ids를 전달하면 모델 내부에서 이 정렬을 수행합니다. 직접 CE를 계산할 때와 모델의 내부 loss를 대조하되, 이미 shift한 labels를 다시 내부 shift 경로에 넣어 두 번 밀지 않아야 합니다.
Loss에서 이전 층으로 이어지는 backward
Loss는 예측을 평가한 숫자 하나입니다. 이 숫자만 보고서는 수많은 가중치 중 어느 값을 얼마나 바꿔야 하는지 알 수 없습니다. 필요한 것은 각 값이 조금 달라졌을 때 loss가 어떻게 달라지는가입니다. 이를 미분으로 구한 값이 gradient입니다.
가중치 한 칸의 gradient가 양수라면, 다른 조건을 고정한 아주 작은 변화에서 그 가중치를 올리는 방향으로 loss가 증가한다는 뜻입니다. 음수라면 반대입니다. Gradient는 이 민감도이며, 그 자체가 가중치에 곧바로 더할 변동량은 아닙니다.
먼저 logits 쪽에서 gradient가 만들어집니다. 정답 확률을 높이는 방향은 loss를 줄이고, 그 확률을 낮추는 방향은 loss를 키웁니다. Softmax와 평균 CE를 함께 미분하면 유효 위치 하나의 각 logit에 대한 gradient는 다음과 같습니다. N은 유효한 정답 수이며, 정답 여부는 해당 어휘가 정답이면 1, 아니면 0입니다.
여기서 는 위치 t의 어휘 v에 대한 logit이고, 는 그 확률입니다. 는 위에서 설명한 정답 여부입니다.
예를 들어 그림 2의 위치 2에서 <eos> logit의 gradient는 (0.203472 − 1) / 3, 약 −0.265509입니다. 이 값은 출력 쪽에서 만들어진 gradient입니다. 모델 안쪽의 가중치가 어떤 영향을 주었는지는 각 연산을 거꾸로 따라가며 계산해야 합니다.
그림 4는 이 전달 경로를 보기 위해 두 선형층으로 이루어진 별도 예제를 사용합니다. 실제 Transformer의 attention, 정규화, activation 함수는 접어 두었습니다. 그림의 출력 gradient [0.1, −0.2]는 앞선 CE 숫자에서 가져온 값이 아니라, 두 층의 미분을 계산하기 위해 주어진 작은 예시입니다.
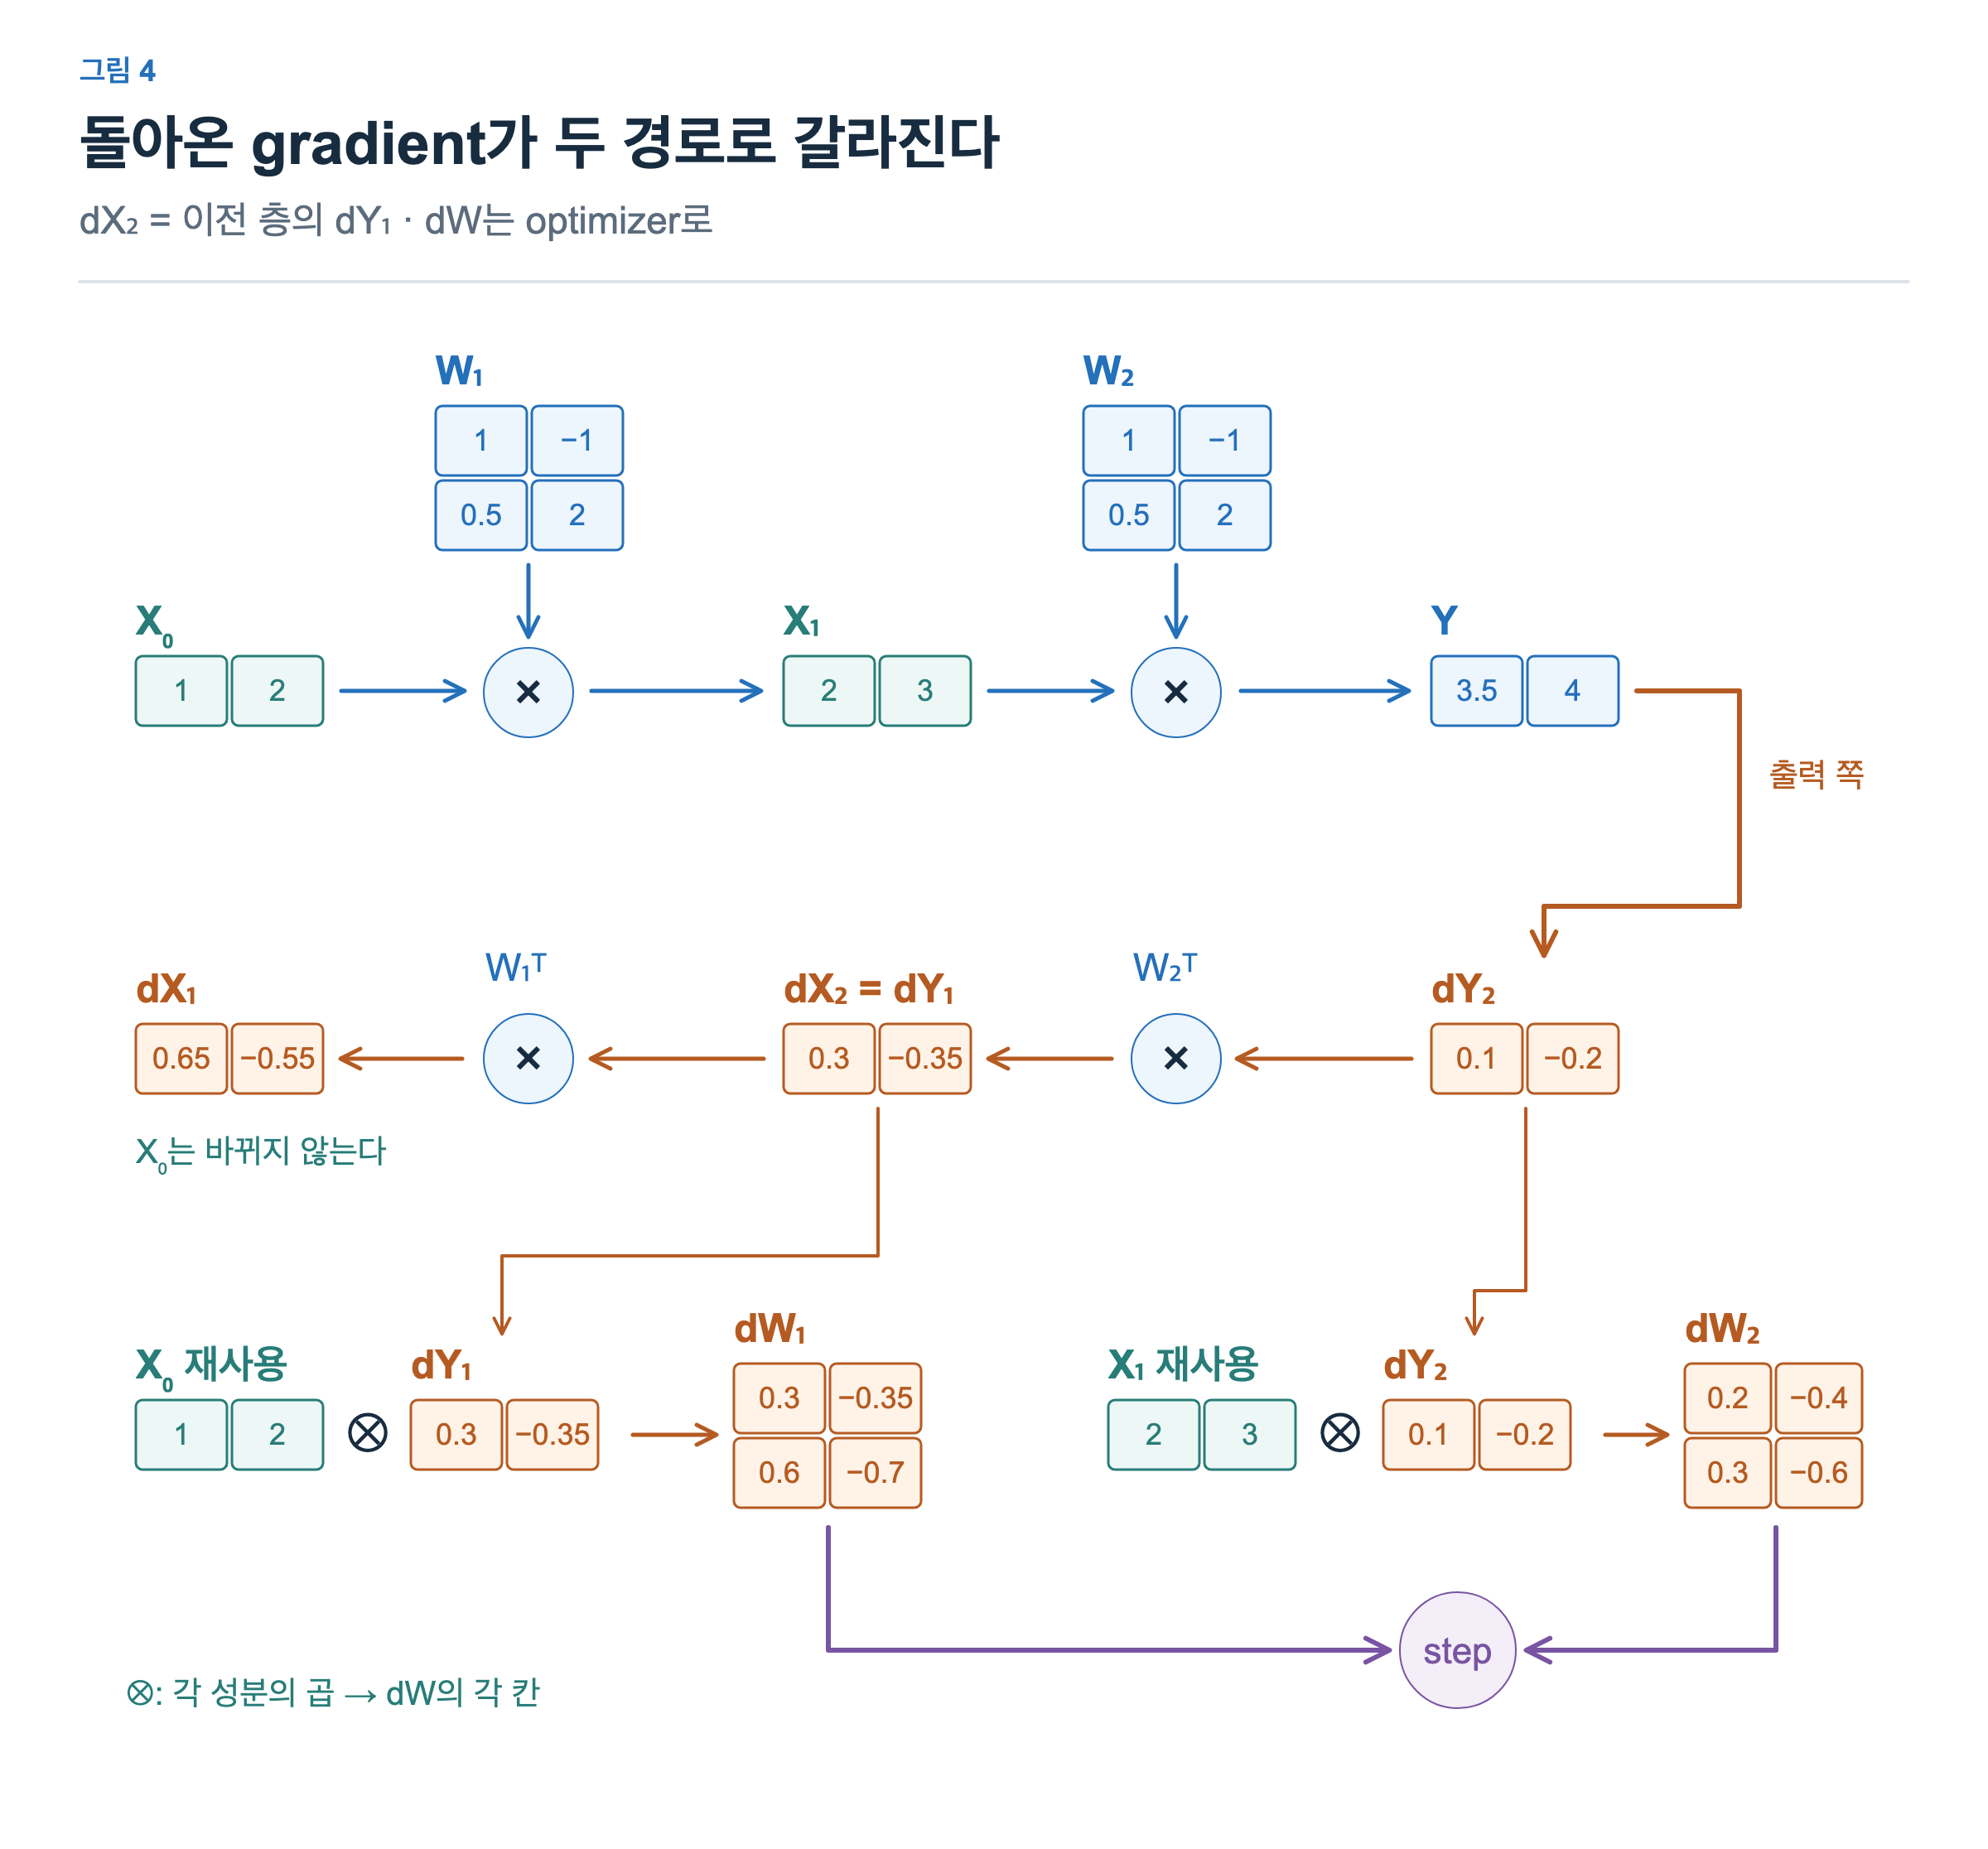
두 번째 층은 출력 쪽에서 받은 gradient로 두 가지를 계산합니다. 하나는 자신의 가중치에 대한 wgrad, 다른 하나는 자신의 입력에 대한 xgrad입니다. 이 입력은 첫 번째 층의 출력이므로, 두 번째 층의 xgrad가 그대로 첫 번째 층의 출력 gradient가 됩니다. 그림의 dX₂ = dY₁ 연결이 이 관계입니다.
첫 번째 층도 같은 방식으로 자신의 wgrad와 xgrad를 계산합니다. 각 층의 wgrad는 optimizer가 사용할 값으로 남고, xgrad는 앞선 계산으로 전달됩니다. 이것이 연쇄법칙으로 loss의 영향을 앞쪽 가중치까지 연결하는 과정입니다. Loss 값 자체를 층마다 전달하는 것이 아니라, 해당 층의 출력에 대한 미분을 받아 입력과 가중치에 대한 미분으로 바꿉니다.
PyTorch에서는 loss.backward()가 forward 때 기록한 연산 관계를 따라 이 계산을 수행합니다. Scalar loss에서 시작할 때의 미분은 1입니다. 중간 tensor의 gradient를 따라가며 최종적으로 학습할 파라미터의 .grad에 결과가 모입니다. 이 계산 그래프와 필요한 중간값의 저장은 PyTorch autograd 설명에서 확인할 수 있습니다.
한 층에서 wgrad와 xgrad가 갈라집니다
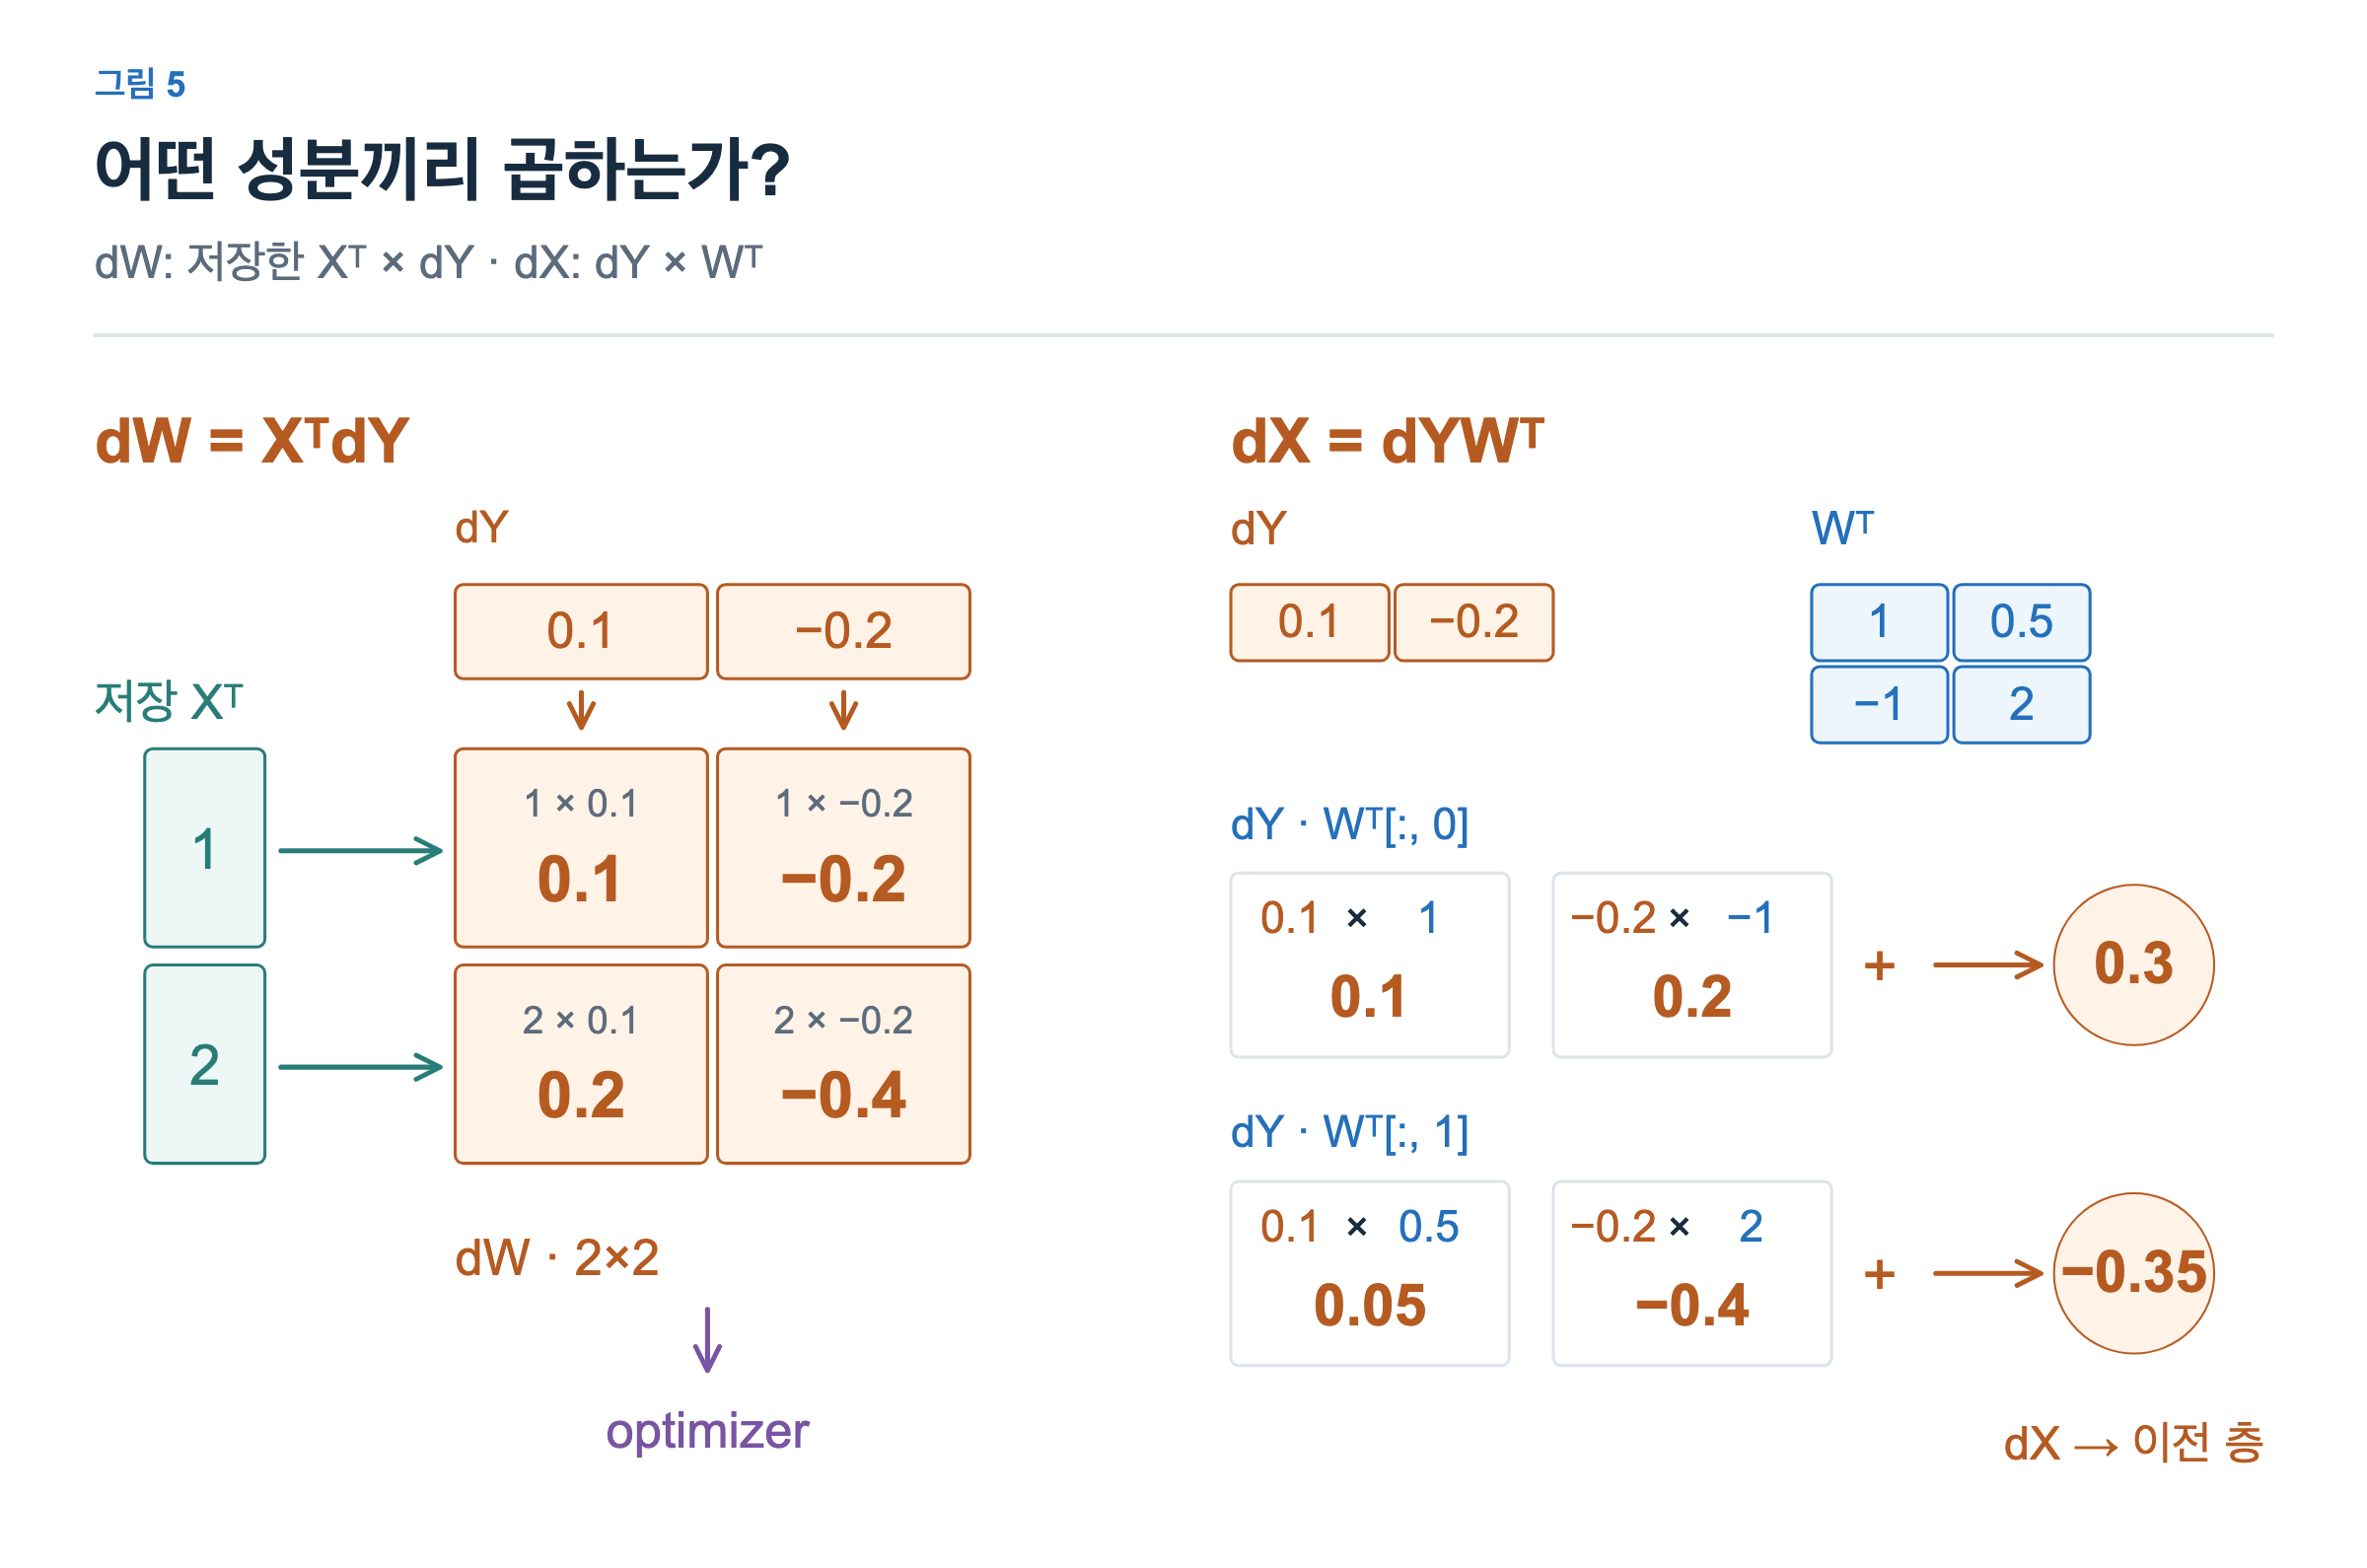
한 선형층을 더 작게 펼쳐 보겠습니다. 이 글에서는 입력을 행벡터로 두고 Y = XW로 씁니다. X는 입력 성분, W는 가중치, Y는 출력입니다. dY는 loss의 숫자가 아니라 출력 Y의 각 성분에 대한 loss의 gradient입니다. dW와 dX도 각각 W와 X에 대한 gradient입니다.
그림 5의 입력은 X = [1, 2], 가중치는 W = [[1, −1], [0.5, 2]]입니다. Forward 결과는 Y = [2, 3]입니다. 이 출력에 대한 gradient dY = [0.1, −0.2]가 도착했다고 하겠습니다.
W를 위한 gradient: XᵀdY
입력의 첫 번째 성분 1에 연결된 두 가중치를 생각해 보겠습니다. 각 가중치가 출력에 기여하는 배율은 그 입력 성분인 1입니다. 따라서 해당 출력의 gradient 0.1과 −0.2를 각각 곱해 첫 번째 행 [0.1, −0.2]를 얻습니다. 두 번째 입력 성분은 2이므로 두 번째 행은 [0.2, −0.4]입니다.
Xᵀ는 2×1 세로 벡터, dY는 1×2 가로 벡터입니다. 두 벡터의 모든 성분 쌍을 곱해 2×2 행렬을 만드는 외적입니다. 각 결과 칸은 같은 위치의 가중치 칸에 대응합니다. 여러 입력 행을 함께 처리한다면 각 행의 기여를 더하므로, 일반적으로는 X가 N×I, dY가 N×O일 때 dW가 I×O인 행렬 곱입니다.
여기서 forward 때의 입력 X가 필요합니다. dY만으로는 가중치의 영향이 입력 성분의 몇 배였는지 알 수 없습니다. Forward가 끝난 뒤에도 이전 activation이 backward에 필요하다는 말은 이런 계산을 가리킵니다.
이전 층을 위한 gradient: dYWᵀ
이번에는 입력의 첫 번째 성분이 두 출력에 미친 영향을 모읍니다. 이 성분은 가중치 1을 통해 첫 번째 출력에, −1을 통해 두 번째 출력에 기여했습니다. 두 경로의 영향을 더하면 0.1 × 1 + (−0.2) × (−1) = 0.3입니다.
두 번째 입력 성분의 영향은 0.1 × 0.5 + (−0.2) × 2 = −0.35입니다. 이렇게 dX = [0.3, −0.35]를 얻습니다.
그림 오른쪽은 수식 순서대로 dY를 왼쪽에, Wᵀ를 오른쪽에 놓았습니다. Wᵀ의 첫 번째 열 [1, −1]은 첫 번째 입력 성분에 연결된 가중치이고, 두 번째 열 [0.5, 2]는 두 번째 입력 성분에 연결된 가중치입니다. 각 열과 dY를 곱하고 더해 dX의 한 성분을 만듭니다. 이 계산에는 현재 층의 가중치 W가 필요합니다.
dX를 만들었다고 해서 X에 새 값을 덮어쓰는 것은 아닙니다. X가 이전 층에서 나온 activation이라면 dX를 그 층의 출력 gradient로 사용해 backward를 이어갑니다. 학습할 대상은 그 과정에서 찾아가는 파라미터입니다. 입력 토큰 ID 자체를 gradient로 수정하지도 않습니다. 입력 쪽까지 필요한 경로를 따라가며, 임베딩 테이블처럼 학습할 파라미터에는 gradient가 모입니다.
이 두 계산을 코드로 대조할 수 있습니다. 여기서는 loss부터 계산하는 대신, 이미 도착한 dY를 y.backward(dy)에 전달합니다.
import torch

x = torch.tensor([[1., 2.]], dtype=torch.float64, requires_grad=True)
w = torch.tensor([[1., -1.], [.5, 2.]],
                 dtype=torch.float64, requires_grad=True)
dy = torch.tensor([[.1, -.2]], dtype=torch.float64)
y = x @ w

y.backward(dy)

dw = x.detach().T @ dy
dx = dy @ w.detach().T
torch.testing.assert_close(w.grad, dw)
torch.testing.assert_close(x.grad, dx)
print(w.grad)  # [[0.1, -0.2], [0.2, -0.4]]
print(x.grad)  # [[0.3, -0.35]]
이 예제에서 명시적으로 계산한 두 식과 autograd의 최대 절대 오차는 모두 0이었습니다. 부동소수점 출력의 0.3은 내부적으로 약 0.30000000000000004로 저장될 수 있으므로, 숫자 대조에는 torch.testing.assert_close를 사용했습니다.
실제 torch.nn.Linear는 가중치를 [출력 성분, 입력 성분] 순서로 저장합니다. 이 글의 W가 [입력 성분, 출력 성분]인 것과 전치된 관계입니다. 저장된 가중치를 A라고 부르면 forward는 X @ A.T, 저장 형태의 wgrad는 dY.T @ X, xgrad는 dY @ A입니다. 그림의 수식과 실제 코드의 .weight를 비교할 때 이 방향을 맞춰야 합니다.
지금까지는 선형층을 펼쳤습니다. Activation 함수나 attention 같은 다른 연산은 backward에 필요한 값이 다를 수 있습니다. 모든 연산이 입력 X만 저장하면 된다는 뜻은 아닙니다. 다음 편에서는 이 값들이 실제로 언제 생기고 언제 필요 없어지는지 메모리에서 관찰하겠습니다.
Optimizer가 새 가중치를 씁니다
Backward가 끝나면 파라미터와 같은 형태의 gradient가 준비됩니다. 파라미터 하나의 값에 대응하는 gradient 값도 하나입니다. 하지만 gradient와 실제 가중치의 변동량은 다릅니다. Optimizer는 gradient에 학습률과 알고리즘의 규칙을 적용해 업데이트를 정합니다.
그림 6은 처음 CPU 예제로 돌아가 W[0,1] 한 칸을 따라갑니다. Forward 전의 값은 1.2입니다. Backward 뒤에도 1.2이며, 이때 gradient −0.0384565가 생겼습니다.
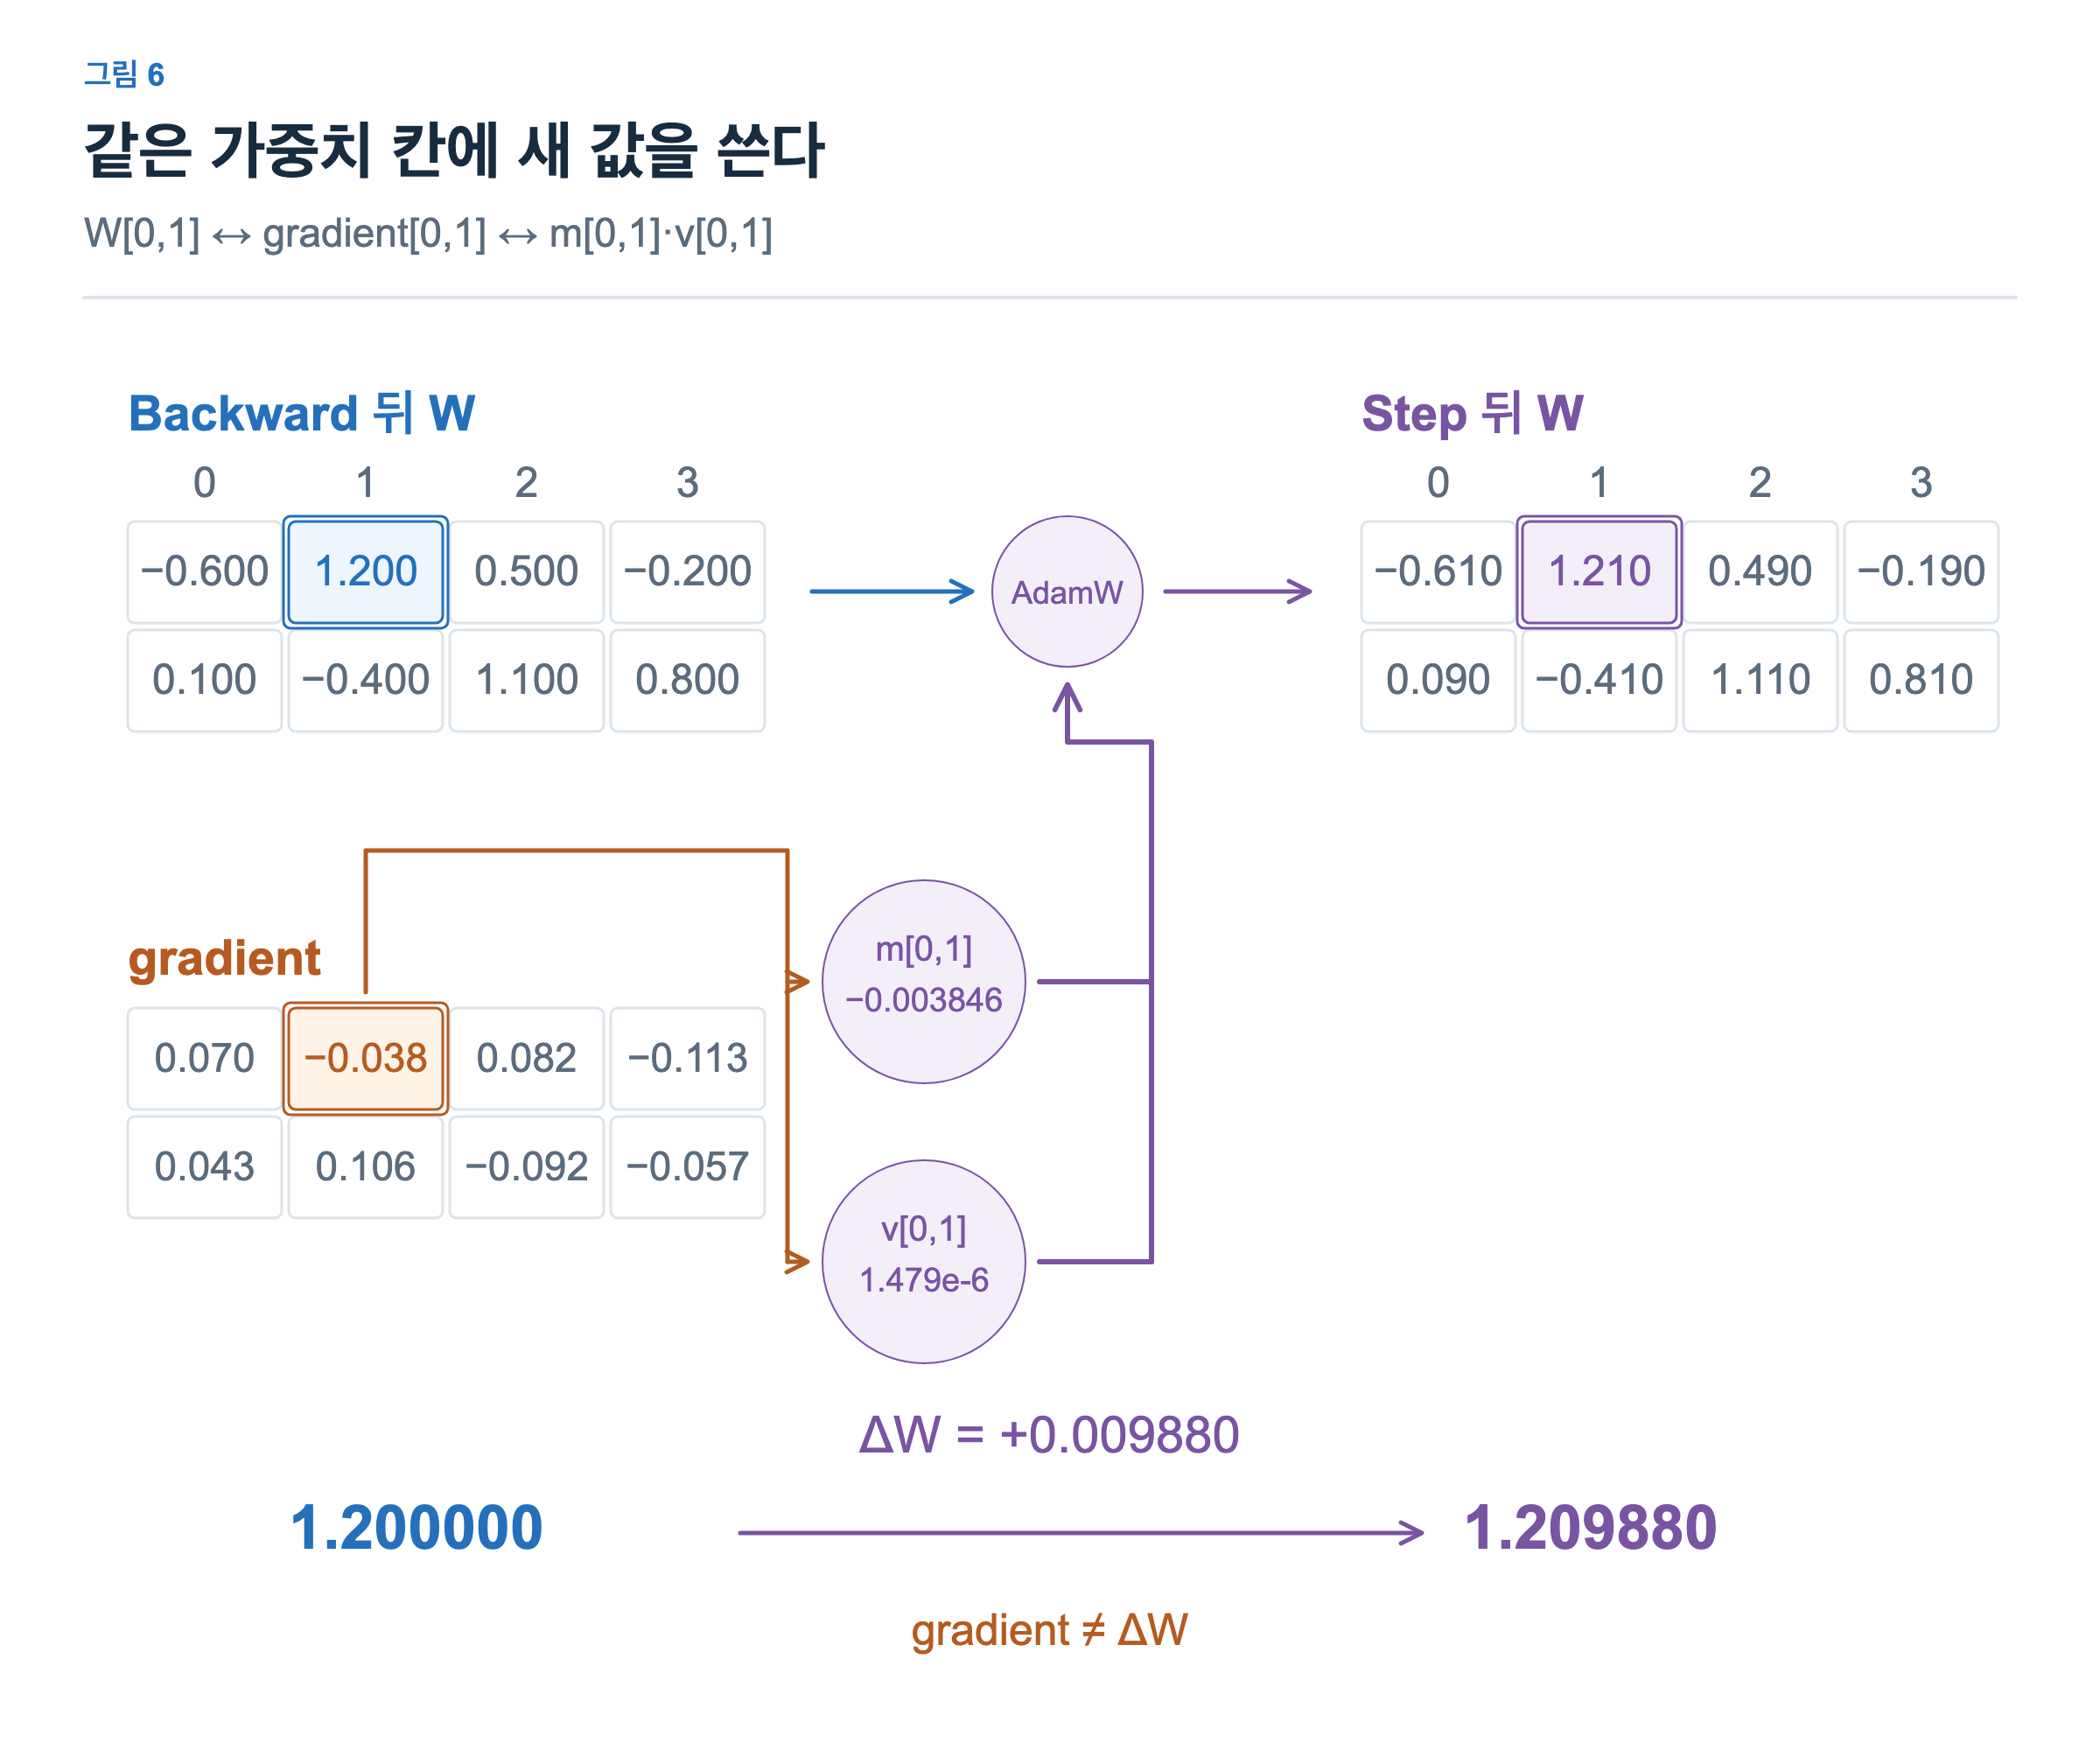
AdamW의 step()을 호출한 뒤 같은 칸의 값은 약 1.209880이 됩니다. 실제 변화는 약 +0.009880입니다. Gradient −0.0384565를 그대로 가중치에 더한 결과가 아닙니다. 그림의 설정은 학습률 0.01과 weight decay 0.01입니다.
AdamW는 현재 gradient뿐 아니라 파라미터마다 유지하는 상태도 사용합니다. m은 gradient의 방향을 누적해서 반영하는 평균이고, v는 gradient의 제곱을 누적해서 반영하는 평균입니다. 처음에는 0에서 시작하고, 이후에는 이전 스텝의 값에 새 gradient를 반영합니다. 그림의 m/v는 이번 스텝에 갱신되어 업데이트에 사용된 값입니다. 이런 상태 덕분에 현재 gradient 하나와 실제 업데이트가 일대일로 같지 않습니다. AdamW의 공식 정의에 나오는 m/v와 weight decay의 계산은 optimizer를 다루는 4편에서 펼쳐 보겠습니다.
학습 코드에서는 다음 순서가 드러나야 합니다.
optimizer.zero_grad(set_to_none=True)
outputs = model(input_ids=input_ids, labels=input_ids, use_cache=False)
loss = outputs.loss
loss.backward()
optimizer.step()zero_grad()는 지난 스텝의 파라미터 gradient를 비웁니다. PyTorch는 backward 결과를 기존 .grad에 누적하므로, 스텝마다 새 gradient를 사용할 때 이 경계가 필요합니다. 여기서는 한 번의 backward 뒤에 한 번 update합니다. 여러 backward의 결과를 모으는 gradient accumulation은 3편에서 다루겠습니다.
실제 모델에서 한 스텝 확인하기
같은 경로가 실제 모델에서도 이어지는지 확인하겠습니다. 실습은 HuggingFaceTB/SmolLM2-135M 사전학습 모델을 사용합니다. CPU에서도 짧은 입력으로 전체 파라미터의 gradient와 AdamW update를 관찰할 수 있도록 선택했습니다. 준비편의 기준 모델은 GPT-2 tokenizer를 사용하지만, GPT-2 가중치를 불러온 모델은 아닙니다. 직접 정의한 GPT 계열 Decoder를 무작위 초기화해 FineWeb으로 사전학습하는 구성입니다. 이 편에서는 사전학습된 모델의 다음 토큰 예측을 바로 관찰하기 위해 별도로 SmolLM2를 사용합니다.
모델과 tokenizer는 같은 revision 93efa2f097d58c2a74874c7e644dbc9b0cee75a2로 고정했습니다. 실행 환경은 Python 3.12.8, PyTorch 2.8.0, Transformers 4.57.1이며 CPU에서 FP32로 계산했습니다. 이 편에서는 혼합 정밀도와 실행 최적화를 도입하지 않습니다.
마지막 위치로 다음 토큰 만들기
먼저 I like를 입력하고 마지막 위치에서 가장 높은 확률의 토큰을 하나 고릅니다. 여기서는 생성 규칙을 단순하게 하기 위해 argmax를 사용합니다.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_id = "HuggingFaceTB/SmolLM2-135M"
revision = "93efa2f097d58c2a74874c7e644dbc9b0cee75a2"
tokenizer = AutoTokenizer.from_pretrained(model_id, revision=revision)
model = AutoModelForCausalLM.from_pretrained(
    model_id, revision=revision, dtype=torch.float32,
    attn_implementation="eager",
)
model.eval()
inputs = tokenizer("I like", return_tensors="pt", add_special_tokens=False)
with torch.no_grad():
    logits = model(**inputs, use_cache=False).logits
    next_id = logits[:, -1, :].argmax(-1, keepdim=True)
    generated = torch.cat([inputs.input_ids, next_id], dim=1)
print(tokenizer.decode(generated[0]))  # I like to
실행에서 선택한 토큰은 ID 288의 to였습니다. 완성된 문자열은 I like to입니다. 모델이 생성한 to를 뒤에 붙여 다음 생성으로 이어 갈 수 있지만, 다음 학습에서는 생성 결과 대신 데이터의 정답 AI를 사용합니다.
model.eval()은 dropout 등 층의 동작 모드를 바꾸고, torch.no_grad()는 gradient를 위한 기록을 끕니다. 둘은 다른 역할입니다. 학습 forward에는 no_grad()를 사용하지 않으며 모델을 train() 모드로 전환합니다.
위치별 CE와 모델의 loss 대조하기
학습 입력은 I like AI 뒤에 EOS ID를 붙인 [57, 702, 5646, 0]입니다. Tokenizer의 표기는 I, Ġlike, ĠAI, <|endoftext|>이며 Ġ는 앞 공백을 나타냅니다. 그림의 <eos>는 이 문서 끝 토큰을 단순하게 표시한 이름입니다. 실제 어휘 크기는 49,152이므로 logits는 [1, 4, 49152]입니다.
| 입력 위치 | 입력 토큰 | 다음 정답 | 정답 확률 | 토큰 CE |
|---|---|---|---|---|
| 0 | I |
Ġlike |
0.00126005 | 6.676604 |
| 1 | Ġlike |
ĠAI |
0.00002470 | 10.608803 |
| 2 | ĠAI |
<|endoftext|> |
0.00084043 | 7.081603 |
| 3 | <|endoftext|> |
없음 | 제외 | 제외 |
유효한 정답 세 개의 평균 CE는 8.122337입니다. 앞서 본 직접 shift한 CE와 labels=input_ids로 얻은 모델 내부 loss의 차이는 이 실행에서 0이었습니다. 그림의 1.076007과는 서로 다른 모델의 결과입니다. 두 loss 값의 크기로 모델 품질을 비교하지 않습니다.
전체 실습 코드는 각 위치의 top-5와 그 밖의 확률 질량도 기록합니다. 예를 들어 위치 1에서 가장 높은 확률의 토큰은 Ġto로 약 0.274680이었지만, loss는 정답 ĠAI의 확률을 사용했습니다. 확률분포의 표시와 학습 목표가 서로 어떻게 연결되는지 실제 출력으로 확인할 수 있습니다.
대표 선형층의 gradient와 update 확인하기
첫 번째 decoder block의 MLP down_proj를 관찰했습니다. 이 층의 입력 X는 [1,4,1536], 출력 gradient dY는 [1,4,576]이고, 저장된 weight A는 [576,1536]입니다. Batch와 위치를 합쳐 입력 행을 네 개로 보면 dA = dY.T @ X, dX = dY @ A로 대조할 수 있습니다.
실습 코드의 hook은 forward 때 이 층의 입력과 출력을 관찰하고, retain_grad()로 중간 gradient를 확인할 수 있게 합니다. 이는 관측을 위한 코드입니다. 일반적인 학습에서 모든 activation의 .grad를 별도로 보관해야 한다는 뜻은 아닙니다. 이렇게 구한 gradient와 두 행렬식의 최대 절대 오차는 이 실행에서 모두 0이었습니다.
Backward 뒤 gradient가 0이 아닌 가중치 칸 하나를 골라 update 전후를 기록했습니다. 아래는 이 모델의 실제 저장 형태 A[507,1365]에 대한 결과입니다. 그림 6의 W[0,1]과는 다른 칸이며, 학습률도 0.0001로 다릅니다.
| 관측 지점 | 가중치 값 | gradient |
|---|---|---|
| Forward 전 | 0.484375000 | 없음 |
| Backward 뒤 | 0.484375000 | +0.311700791 |
| AdamW step 뒤 | 0.484274536 | +0.311700791 |
Backward 전후에는 관찰한 weight 행렬 전체가 정확히 같았습니다. Step 뒤 선택한 칸의 변화는 약 −0.000100464였습니다. .grad는 optimizer step만으로 자동 삭제되지 않으므로 마지막 행에도 같은 gradient가 남아 있습니다. 다음 스텝의 zero_grad()에서 비웁니다.
이 실행으로 확인한 것은 예측·loss·gradient·가중치 변경의 연결입니다. 한 문장에 대한 한 번의 업데이트는 검증 성능이나 언어 능력의 개선을 증명하지 않습니다. 이후 편에서 기법을 비교할 때는 공통 학습 데이터와 별도 검증 데이터로 학습 결과를 확인하겠습니다.
독립 실행 코드는 저장소의 labs/training/chapters/01-forward-backward/train.py에 있습니다. 의존성을 설치한 뒤 저장소 루트에서 다음과 같이 실행합니다. 첫 실행은 공개 모델을 내려받습니다.
python -m pip install -r labs/training/chapters/01-forward-backward/requirements.txt
python labs/training/chapters/01-forward-backward/train.py --device cpu
기본 출력 results/chapter-01.json에는 위치별 확률, token loss, gradient 대조 결과와 파라미터 변화가 기록됩니다. GPU에서는 --device cuda로 실행할 수 있지만, 위 수치는 CPU 실행 결과이며 GPU에서 측정한 처리량이나 메모리 수치가 아닙니다.
다음 편: 계산에 필요했던 값의 수명
Forward는 현재 가중치로 예측을 만들었습니다. 정답 확률을 loss로 바꾼 뒤, backward는 각 층에서 wgrad와 xgrad를 계산했습니다. xgrad는 앞선 층으로 전달되고, 파라미터의 gradient는 optimizer가 새 가중치를 쓰는 데 사용했습니다.
이 과정에서 wgrad를 구하려면 forward 때의 activation이 다시 필요했습니다. 그렇다면 forward와 backward 사이에 그 값은 어디에 있었고, 언제부터 필요 없어졌을까요? 다음 편에서는 같은 학습 경로의 메모리 스냅샷과 타임라인을 보며, activation이 쌓이고 사용된 뒤 해제되는 과정을 살펴보겠습니다.