학습 · 2026-10-05
학습 준비 2: FineWeb에서 학습 배치까지
FineWeb 문서를 학습·검증으로 나누고, 긴 문서의 독립 분할과 실행 시점 best-fit packing을 거쳐 padding 없는 입력과 다음 토큰 정답을 만드는 과정을 설명합니다.
첫 준비편에서는 GPU 실험을 실행하고 결과를 회수하는 경로를 마련했습니다. 이번에는 그 실험에 넣는 데이터를 준비하겠습니다. 원본 문서가 여러 조각으로 나뉘고 다른 문서와 같은 배치에 들어가더라도, 어디까지가 같은 문맥이고 무엇을 다음 정답으로 예측하는지는 유지해야 합니다.
우리 기본 파이프라인은 FineWeb 문서를 학습·검증으로 분리하고, 문서별 토큰을 보관한 뒤 실행 시점에 배치를 구성합니다. 4k 안에 들어오는 문서는 유지하고, 긴 문서는 독립 조각으로 나눕니다. 문서·조각 사이 attention은 차단하며 모델에는 padding 없이 실제 토큰만 넣습니다. 이 선택이 모든 사전학습에 가장 좋은 정책이라고 가정하지는 않습니다. 이번 글에서는 선택한 정책과 구현이 보장하는 경계를 함께 살펴보겠습니다.
문서에서 다음 토큰 정답 만들기
사전학습은 원문에 있는 다음 토큰을 맞히는 것으로 시작합니다. 별도로 사람이 정답 문장을 작성하지 않아도, 문서를 한 칸 이동해 입력과 정답을 만들 수 있습니다. 이후 SFT에서는 대화 형식과 어떤 위치를 loss에 포함할지까지 추가로 정해야 하지만, 이번에는 일반 텍스트의 다음 토큰 학습에 집중합니다.
원본은 FineWeb의 sample-10BT를 사용합니다. 영어 웹 텍스트로 구성된 데이터의 표본이며, 우리는 그중 실습에 필요한 예산만 읽습니다. “10BT 표본 사용”이 매번 전체 10B 토큰을 다운로드하거나 학습한다는 뜻은 아닙니다. Tokenizer는 openai-community/gpt2로 고정합니다.
| 대상 | 이 실습의 고정값 |
|---|---|
| 원본 dataset | HuggingFaceFW/fineweb |
| 표본·Parquet 경로 | sample-10BT · sample/10BT |
| Dataset revision | 9bb295ddab0e05d785b879661af7260fed5140fc |
| Tokenizer | openai-community/gpt2 |
| Tokenizer revision | 607a30d783dfa663caf39e06633721c8d4cfcd7e |
| 독립 문맥 상한 | 4,096 predictor tokens |
Tokenizer로 문서 전체를 토큰 ID로 바꾸고 실제 문서 끝에 EOS 하나를 붙입니다. GPT-2 tokenizer의 EOS ID는 50256입니다. 문서 중간을 자른 곳에 새 EOS를 넣지 않습니다. Tokenization 단계에서도 길이 때문에 원문을 미리 잘라 버리지 않습니다.
설명을 위한 작은 문서가 다음처럼 토큰화되었다고 하겠습니다. 여기서 숫자와 EOS ID 99는 직접 만든 예시이며 실제 GPT-2 tokenizer 출력은 아닙니다.
문서 tokens:  [11, 12, 13, 14, 15, 99]
입력 x:      [11, 12, 13, 14, 15]
정답 y:      [12, 13, 14, 15, 99]
EOS까지 포함해 원본 토큰이 N개이면 이 문서의 next-token 쌍은 N−1개입니다. 마지막 실제 토큰은 EOS를 예측하지만 EOS 자체의 다음 정답은 만들지 않습니다. 별도 BOS는 넣지 않으므로 첫 토큰을 맞히는 쌍도 없습니다.
우리 엔진은 데이터 단계에서 이미 inputs와 targets를 이렇게 정렬합니다. 따라서 loss를 계산할 때 다시 한 칸 shift하지 않습니다. 1편에서 허깅페이스 모델에 labels=input_ids를 넘기면 모델 내부에서 shift하는 방식과는 호출 경계가 다릅니다.
원본 문서부터 학습·검증을 나누기
학습한 데이터와 검증할 데이터를 구분하려면 조각으로 나누기 전에 원본 문서의 소속을 결정해야 합니다. 긴 문서의 앞 조각은 train에, 뒷 조각은 validation에 들어가면 같은 원문이 양쪽에 걸칠 수 있습니다.
현재 코드는 문서 텍스트의 SHA-256을 문서 ID로 사용합니다. 그 ID와 고정된 split seed를 다시 hash해 train 또는 validation에 배정합니다. 그러면 같은 텍스트와 seed는 다시 읽어도 같은 split에 들어갑니다. 그 뒤 만들어지는 모든 조각이 원본의 split을 따릅니다.
import hashlib
from training_lab.data import document_split

text = "A short example document."
document_id = hashlib.sha256(text.encode()).hexdigest()
split = document_split(document_id, seed=20261003,
                       validation_fraction=0.05)
동일한 텍스트를 다시 만나면 한 번만 사용합니다. 이는 정확히 같은 텍스트의 중복 제거입니다. 조금 다르게 복사되거나 일부가 겹치는 근사 중복까지 모두 제거하는 구현은 아닙니다. 원본 문서 ID의 교집합이 0이라는 검사와 의미상 유사한 내용이 없다는 주장은 구별해야 합니다.
validation_fraction=0.05는 hash로 배정할 확률을 정합니다. 수집한 최종 토큰의 5%가 반드시 validation이 된다는 뜻은 아닙니다. Train과 validation에 별도 token budget을 두고, 각 예산이 찰 때까지 문서 전체를 수집합니다. 마지막 문서를 보존하므로 실제 수집량은 설정한 예산보다 조금 커질 수 있습니다.
Cache에는 문서와 offset을 보관하기
준비한 데이터를 처음부터 4k짜리 행으로 고정해 저장하지 않습니다. 문서의 토큰을 binary 파일에 이어 쓰고, 각 문서의 시작 offset과 길이를 별도 index에 기록합니다.
data-cache/<identity>/
  train.bin          # EOS를 포함한 문서별 토큰, uint32
  train.jsonl        # 문서 ID·시작 offset·길이
  validation.bin
  validation.jsonl
  manifest.json      # 원본·tokenizer·정책·개수·파일 hash
토큰 파일에서 문서 A 뒤에 B가 저장되어 있어도 attention이나 정답이 자동으로 이어지는 것은 아닙니다. Index의 문서 경계를 읽어 각각의 입력과 정답을 만듭니다. EOS 다음에 다른 문서의 첫 토큰을 정답으로 연결하지 않습니다.
Cache identity에는 원본·tokenizer revision과 split·수집 정책이 들어갑니다. 반면 최대 문맥 길이는 이 cache identity에서 제외합니다. 원본 토큰을 다시 만들지 않고 실행할 때 문맥 상한과 packing을 바꿀 수 있게 한 선택입니다. 현재 설정 검사는 문맥 길이 2–4096을 허용합니다. 문맥 상한을 바꾸면 모델의 위치 임베딩 구성도 달라질 수 있으므로, 모델 checkpoint까지 그대로 호환된다는 뜻은 아닙니다.
Cache를 재사용할 때는 manifest의 파일 hash와 실제 파일을 대조합니다. 존재하는 폴더를 무조건 믿지 않고 손상 여부를 확인합니다. 동일 cache를 여러 프로세스가 동시에 준비하는 경우까지 처리한 설계는 아니므로 준비 작업은 한 번에 하나씩 실행합니다.
긴 문서는 나누되 정답을 빠뜨리지 않기
4k 이내 문서는 빈 공간을 채우기 위해 추가로 자르지 않습니다. 4k를 넘는 문서는 연속된 독립 조각으로 나누고 마지막 짧은 조각도 사용합니다. 예를 들어 본문 9,000토큰 뒤에 EOS가 붙으면 입력·정답 쌍은 9,000개이며 4,096 + 4,096 + 808개로 나뉩니다.
같은 원본에서 나왔더라도 조각 사이의 attention은 연결하지 않습니다. 두 번째 조각은 첫 번째 조각의 앞 문맥을 읽지 못합니다. 모든 토큰 쌍을 사용하는 것과 긴 문맥 전체를 보존하는 것은 다른 일입니다. 이 실습은 앞 문맥을 복사해 넣는 overlap이나 이전 조각의 상태를 넘기는 방식을 사용하지 않습니다.
다만 잘라 놓은 입력에 각각 shift를 적용하면 경계의 정답을 하나씩 빠뜨리기 쉽습니다. 그래서 조각마다 정답용으로 다음 토큰 하나를 더 참조합니다. 앞서 만든 여섯 토큰 문서를 입력 상한 4로 나누면 다음과 같습니다.
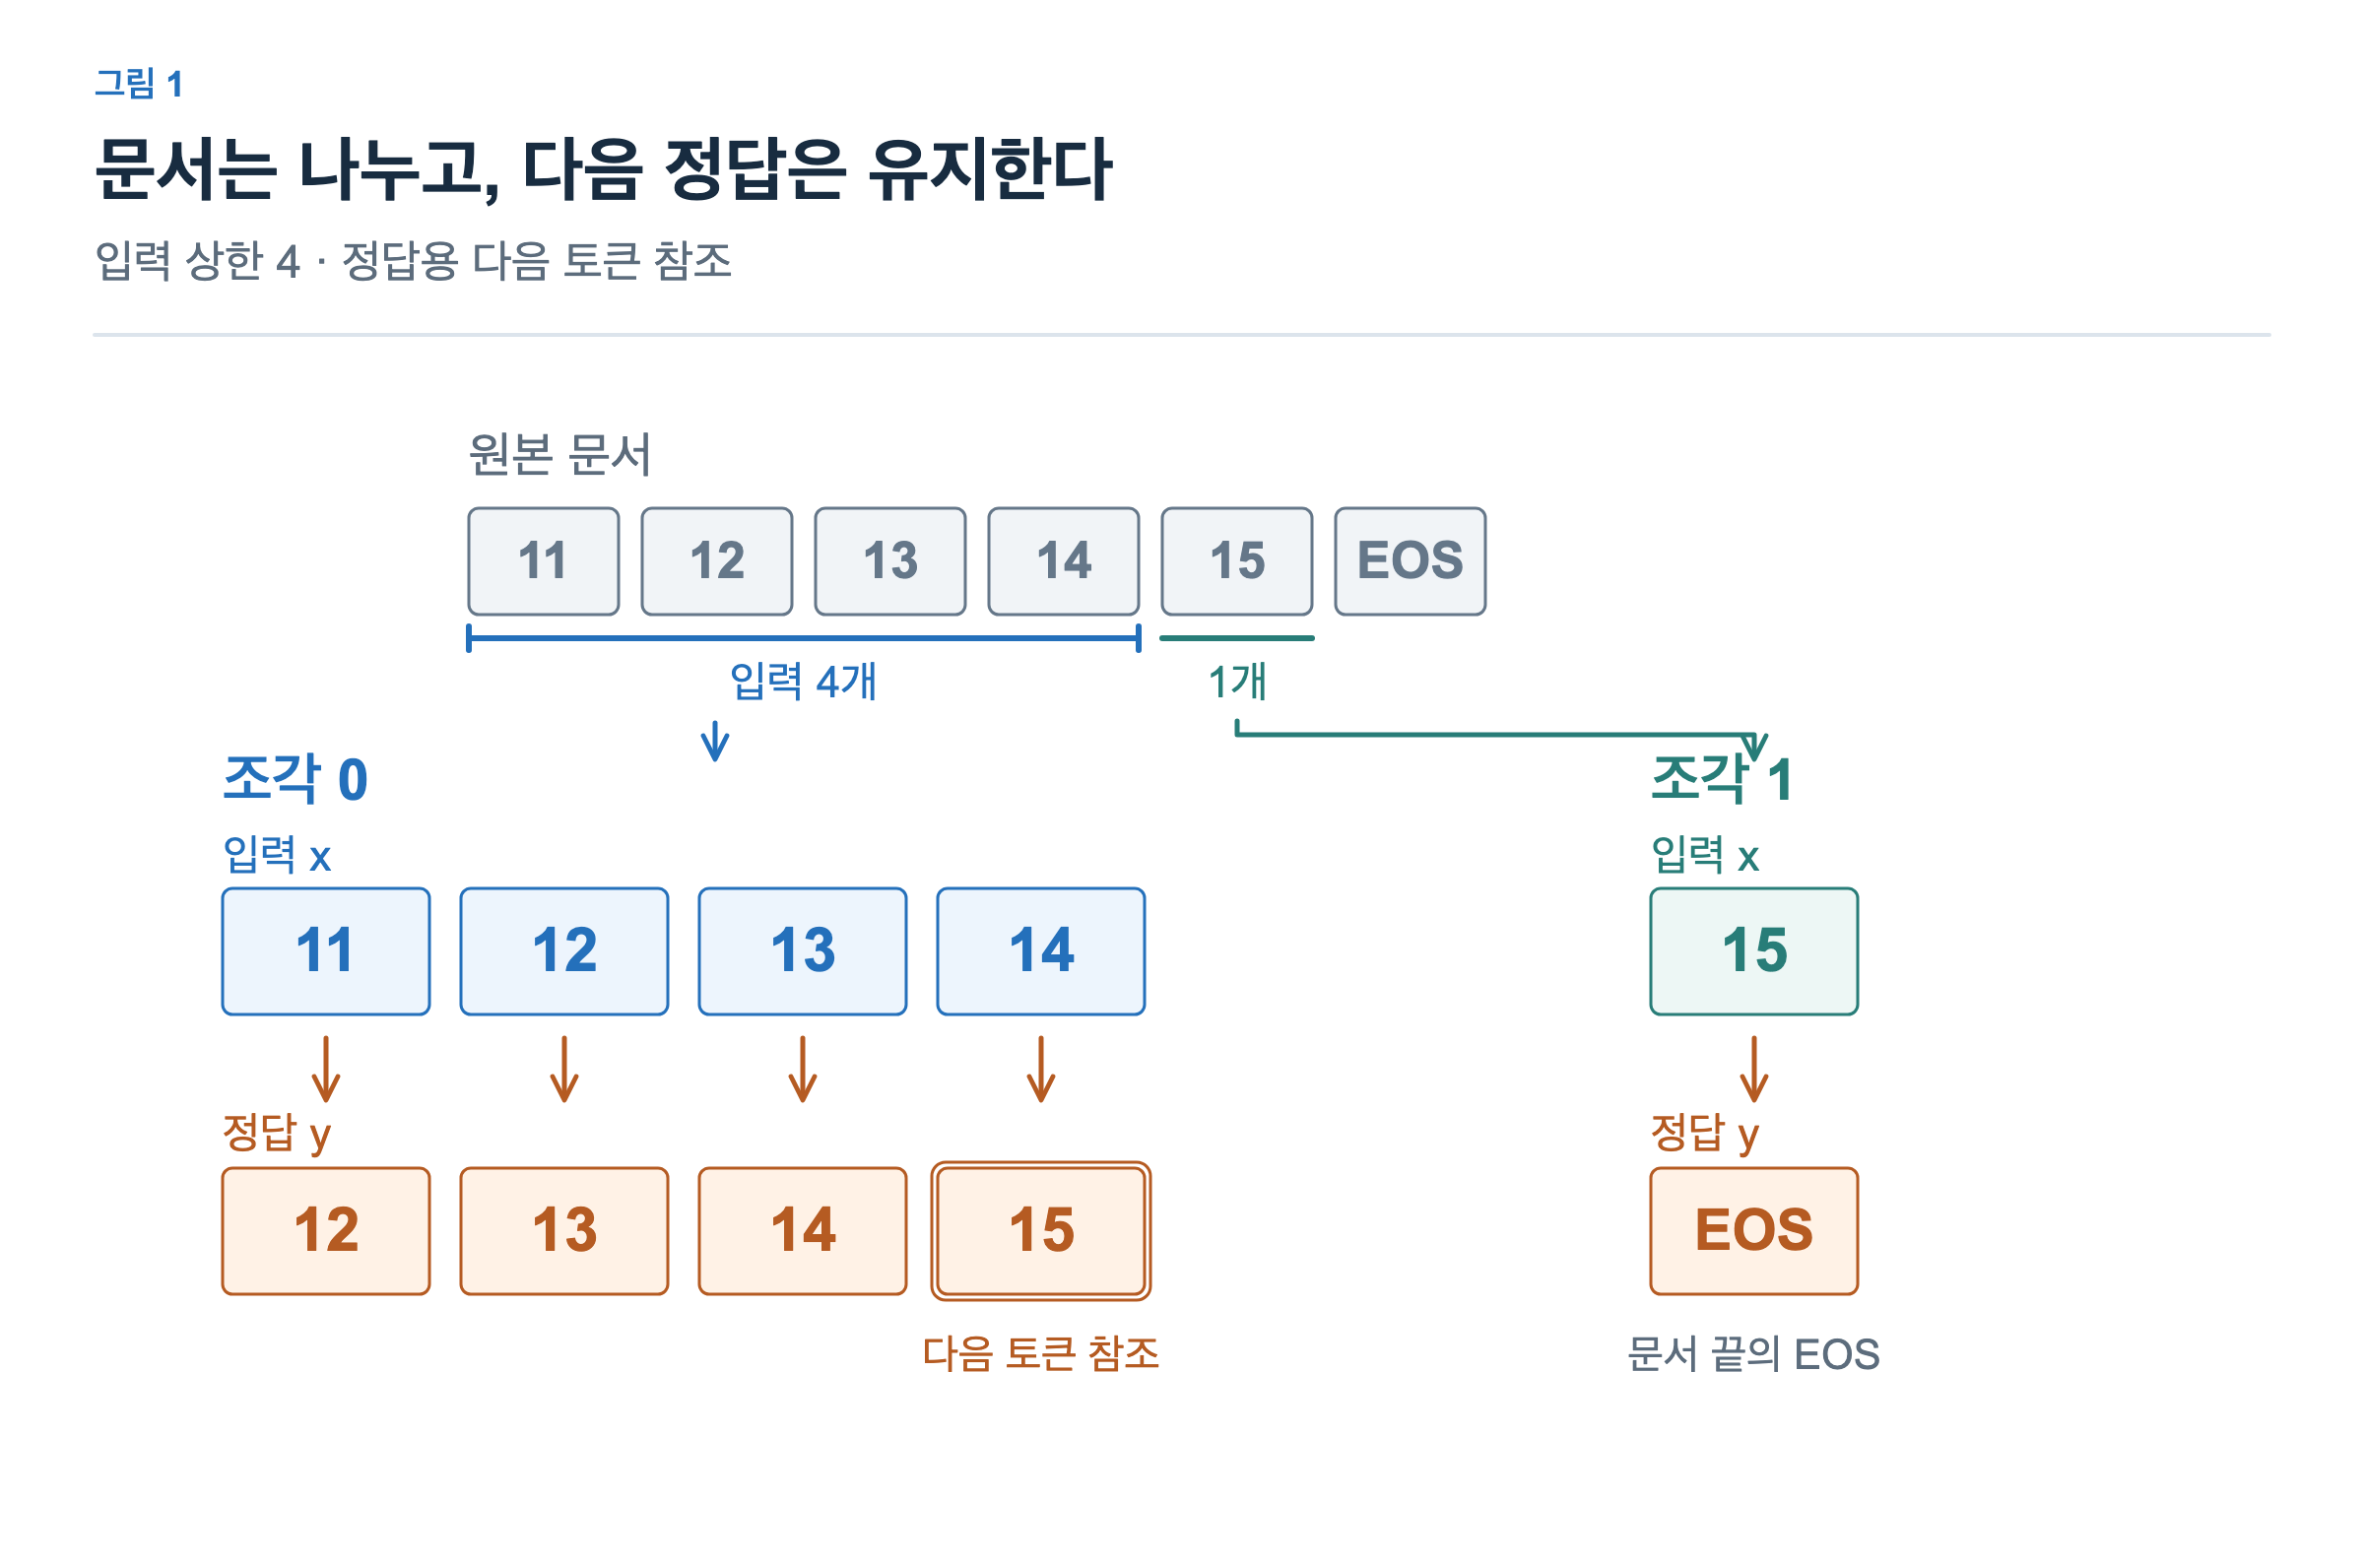
첫 조각의 마지막 입력 14는 다음 토큰 15를 예측합니다. 15는 첫 조각에서 읽을 수 있는 입력에 들어가지는 않고 정답으로만 참조됩니다. 다음 조각에서는 15가 입력이 되어 EOS를 예측합니다. 정답의 lookahead가 조각 사이 attention을 연결하는 것은 아닙니다.
구현을 직접 대조할 수 있습니다. labs/training에서 실행하는 예제입니다.
from training_lab.data import split_tokens

tokens = [11, 12, 13, 14, 15, 99]
chunks = list(split_tokens("example", tokens, max_seq_len=4))
assert [len(c.inputs) for c in chunks] == [4, 1]
assert [t for c in chunks for t in c.inputs] == tokens[:-1]
assert [t for c in chunks for t in c.targets] == tokens[1:]
이렇게 원본의 모든 next-token 쌍이 정확히 한 번씩 남는지 확인합니다. Position ID도 독립 조각마다 0부터 다시 시작합니다. 앞 조각의 position이나 attention을 유지하면서 이어서 처리한 것으로 설명하지 않습니다.
실행할 때 배치를 구성하고 best-fit으로 묶기
문서 길이는 제각각입니다. 짧은 문서 하나를 4k 행 하나에 넣고 나머지를 padding으로 채우면 실제 토큰에 비해 많은 행을 처리하게 됩니다. Packing은 여러 문서를 같은 실행 배치에 묶어 이 낭비를 줄입니다. 문서를 함께 넣는 것과 서로의 문맥을 읽게 하는 것은 별개의 선택입니다.
현재 sampler는 제한된 후보 버퍼에서 남은 공간에 들어갈 가장 긴 조각을 선택하고, 공간이 남으면 다시 들어갈 조각을 찾습니다. 이를 반복해 논리 pack을 구성합니다. 전체 데이터에 대한 최적 조합을 푸는 것은 아닙니다. 후보 범위 안에서 길이를 보고 선택하는 best-fit 방식입니다.
예시로 pack 상한을 8, 배치 크기를 2라고 하겠습니다. 후보 문서 A·B·C·D의 입력 길이가 각각 6·4·3·2이면 첫 pack에 A와 D로 8개를, 두 번째 pack에 B와 C로 7개를 넣을 수 있습니다. 문서를 잘라 빈칸을 메우지 않습니다. 남은 한 칸에 들어갈 문서가 없으므로 빈 공간을 남긴 채 다음 pack으로 넘어갑니다.
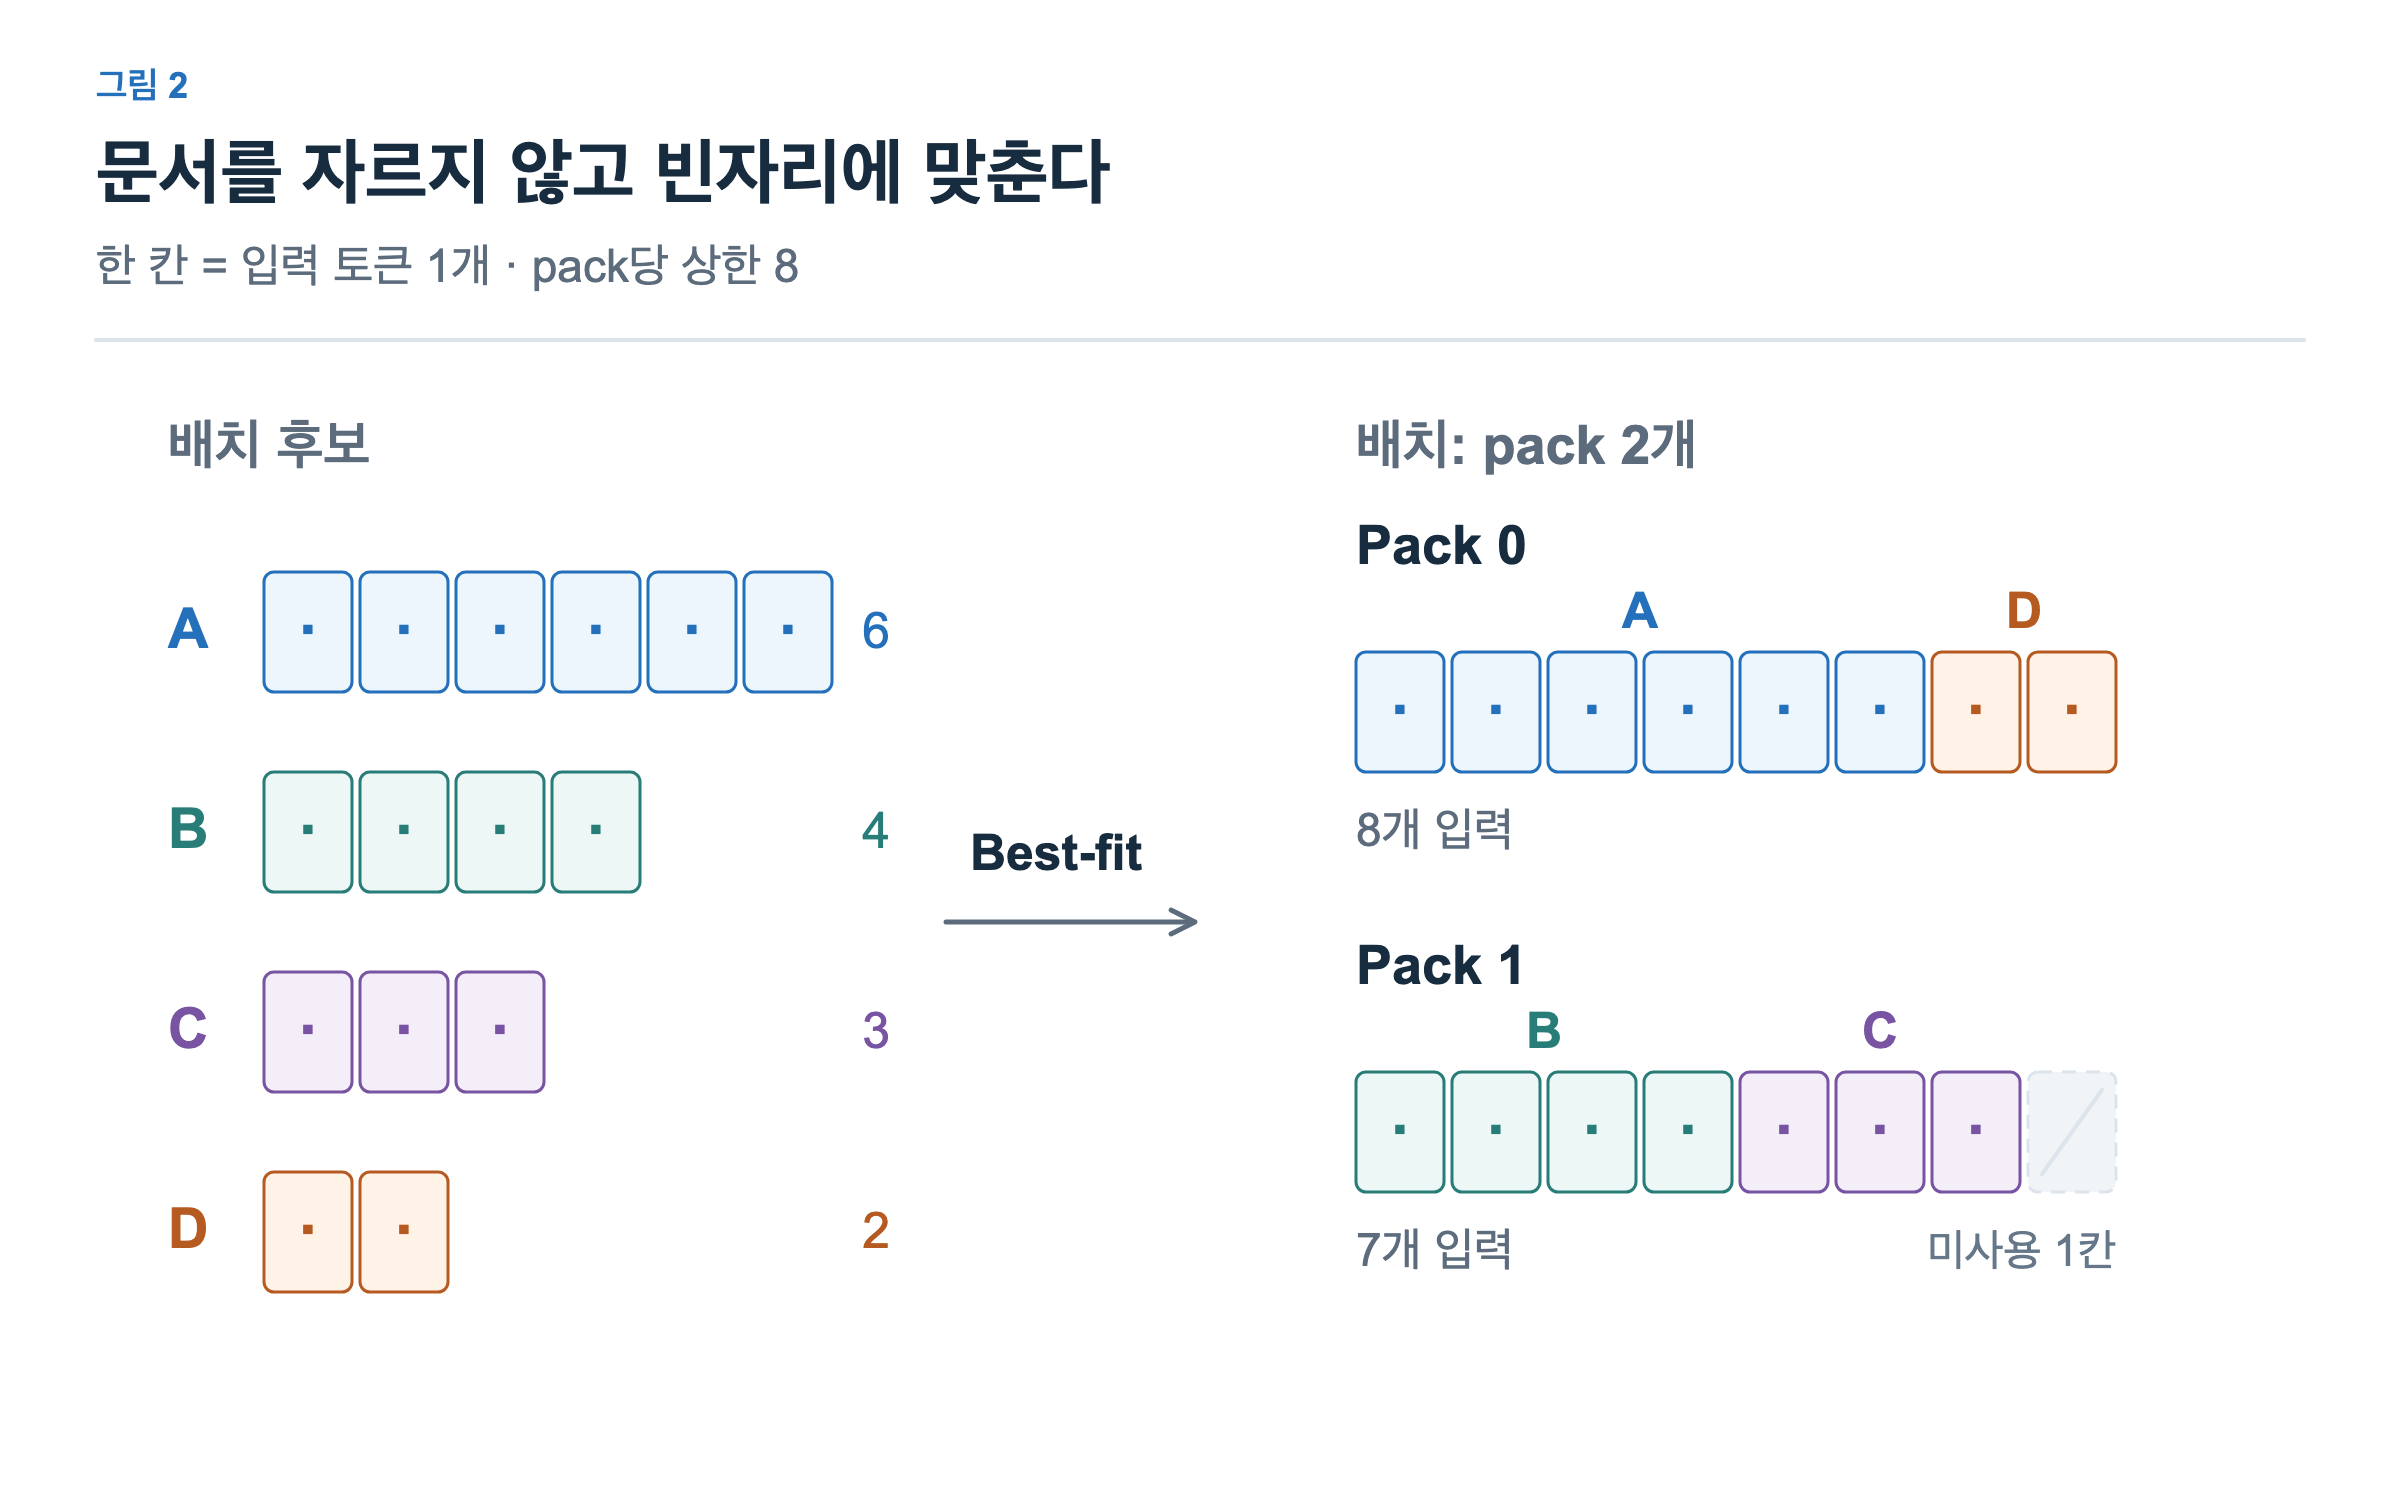
실제 corrected 설정은 다음과 같습니다. 아래는 설정 전체가 아니라 배치 관련 항목만 발췌한 것입니다.
{
  "data": {"max_seq_len": 4096},
  "train": {
    "batch_size": 35,
    "packing_buffer": 64,
    "accumulation": 1,
    "eval_microbatch_tokens": 8192
  }
}
여기서 batch_size는 microbatch의 논리 pack 개수입니다. 한 pack의 최대 용량은 4,096이고 그 안에 문서·조각이 여러 개 들어갈 수 있습니다. 따라서 35개 pack, 독립 조각의 개수, 실제 토큰 수는 서로 다릅니다. 전체 입력 토큰은 최대 35 × 4,096이지만, 빈 공간만큼 줄어들 수 있습니다.
4k는 독립 조각의 문맥 상한이지 microbatch 전체 토큰 수의 상한이 아닙니다. 배치 크기를 바꾸면 한 번에 처리하는 pack 수가 달라지며 조각별 attention 경계는 유지됩니다. 초기 설정의 microbatch_tokens는 비교용으로 남아 있지만, 명시적 batch_size와 동시에 사용하지 않습니다.
이 선택은 문서 순서를 일부 바꿉니다. 재시작 시 같은 입력 순서를 이어가려면 seed뿐 아니라 현재 순서, cursor, 아직 선택하지 않은 후보 버퍼와 RNG 상태를 저장해야 합니다. 우리 checkpoint는 이 sampler 상태도 포함합니다.
Padding 없이 실제 토큰만 모델에 넣기
논리 pack의 빈칸을 실제 padding 토큰으로 만들지 않습니다. 선택한 조각의 실제 입력만 평탄화하고, 조각 경계를 나타내는 metadata를 함께 넘깁니다. Padding-free는 이 실습에서 embedding부터 QKV projection과 MLP까지 padding 행을 처리하지 않는다는 뜻입니다. Loss에서 padding을 제외하는 것만으로 앞선 계산이 사라지는 것은 아닙니다.
앞 그림의 A·D·B·C 순서로 길이 6·2·4·3인 네 문서가 두 pack에 들어갔다면 모델 입력에는 총 15행이 있습니다. 두 번째 pack의 미사용 한 칸은 입력으로 만들지 않습니다. 경계는 다음처럼 표현됩니다.
조각별 입력 길이:  [6, 2, 4, 3]
논리 pack 길이:    [8, 7]
cu_seqlens: [0, 6, 8, 12, 15]cu_seqlens는 누적 길이입니다. 0–5행은 첫 조각, 6–7행은 두 번째 조각처럼 독립 구간을 정합니다. Pack 경계만 표시하면 충분하지 않습니다. 한 pack 안의 서로 다른 문서도 attention을 차단해야 하므로 각 문서·조각의 경계를 사용합니다. Metadata는 int32 tensor이고, 실제 최대 조각 길이도 attention에 넘깁니다.
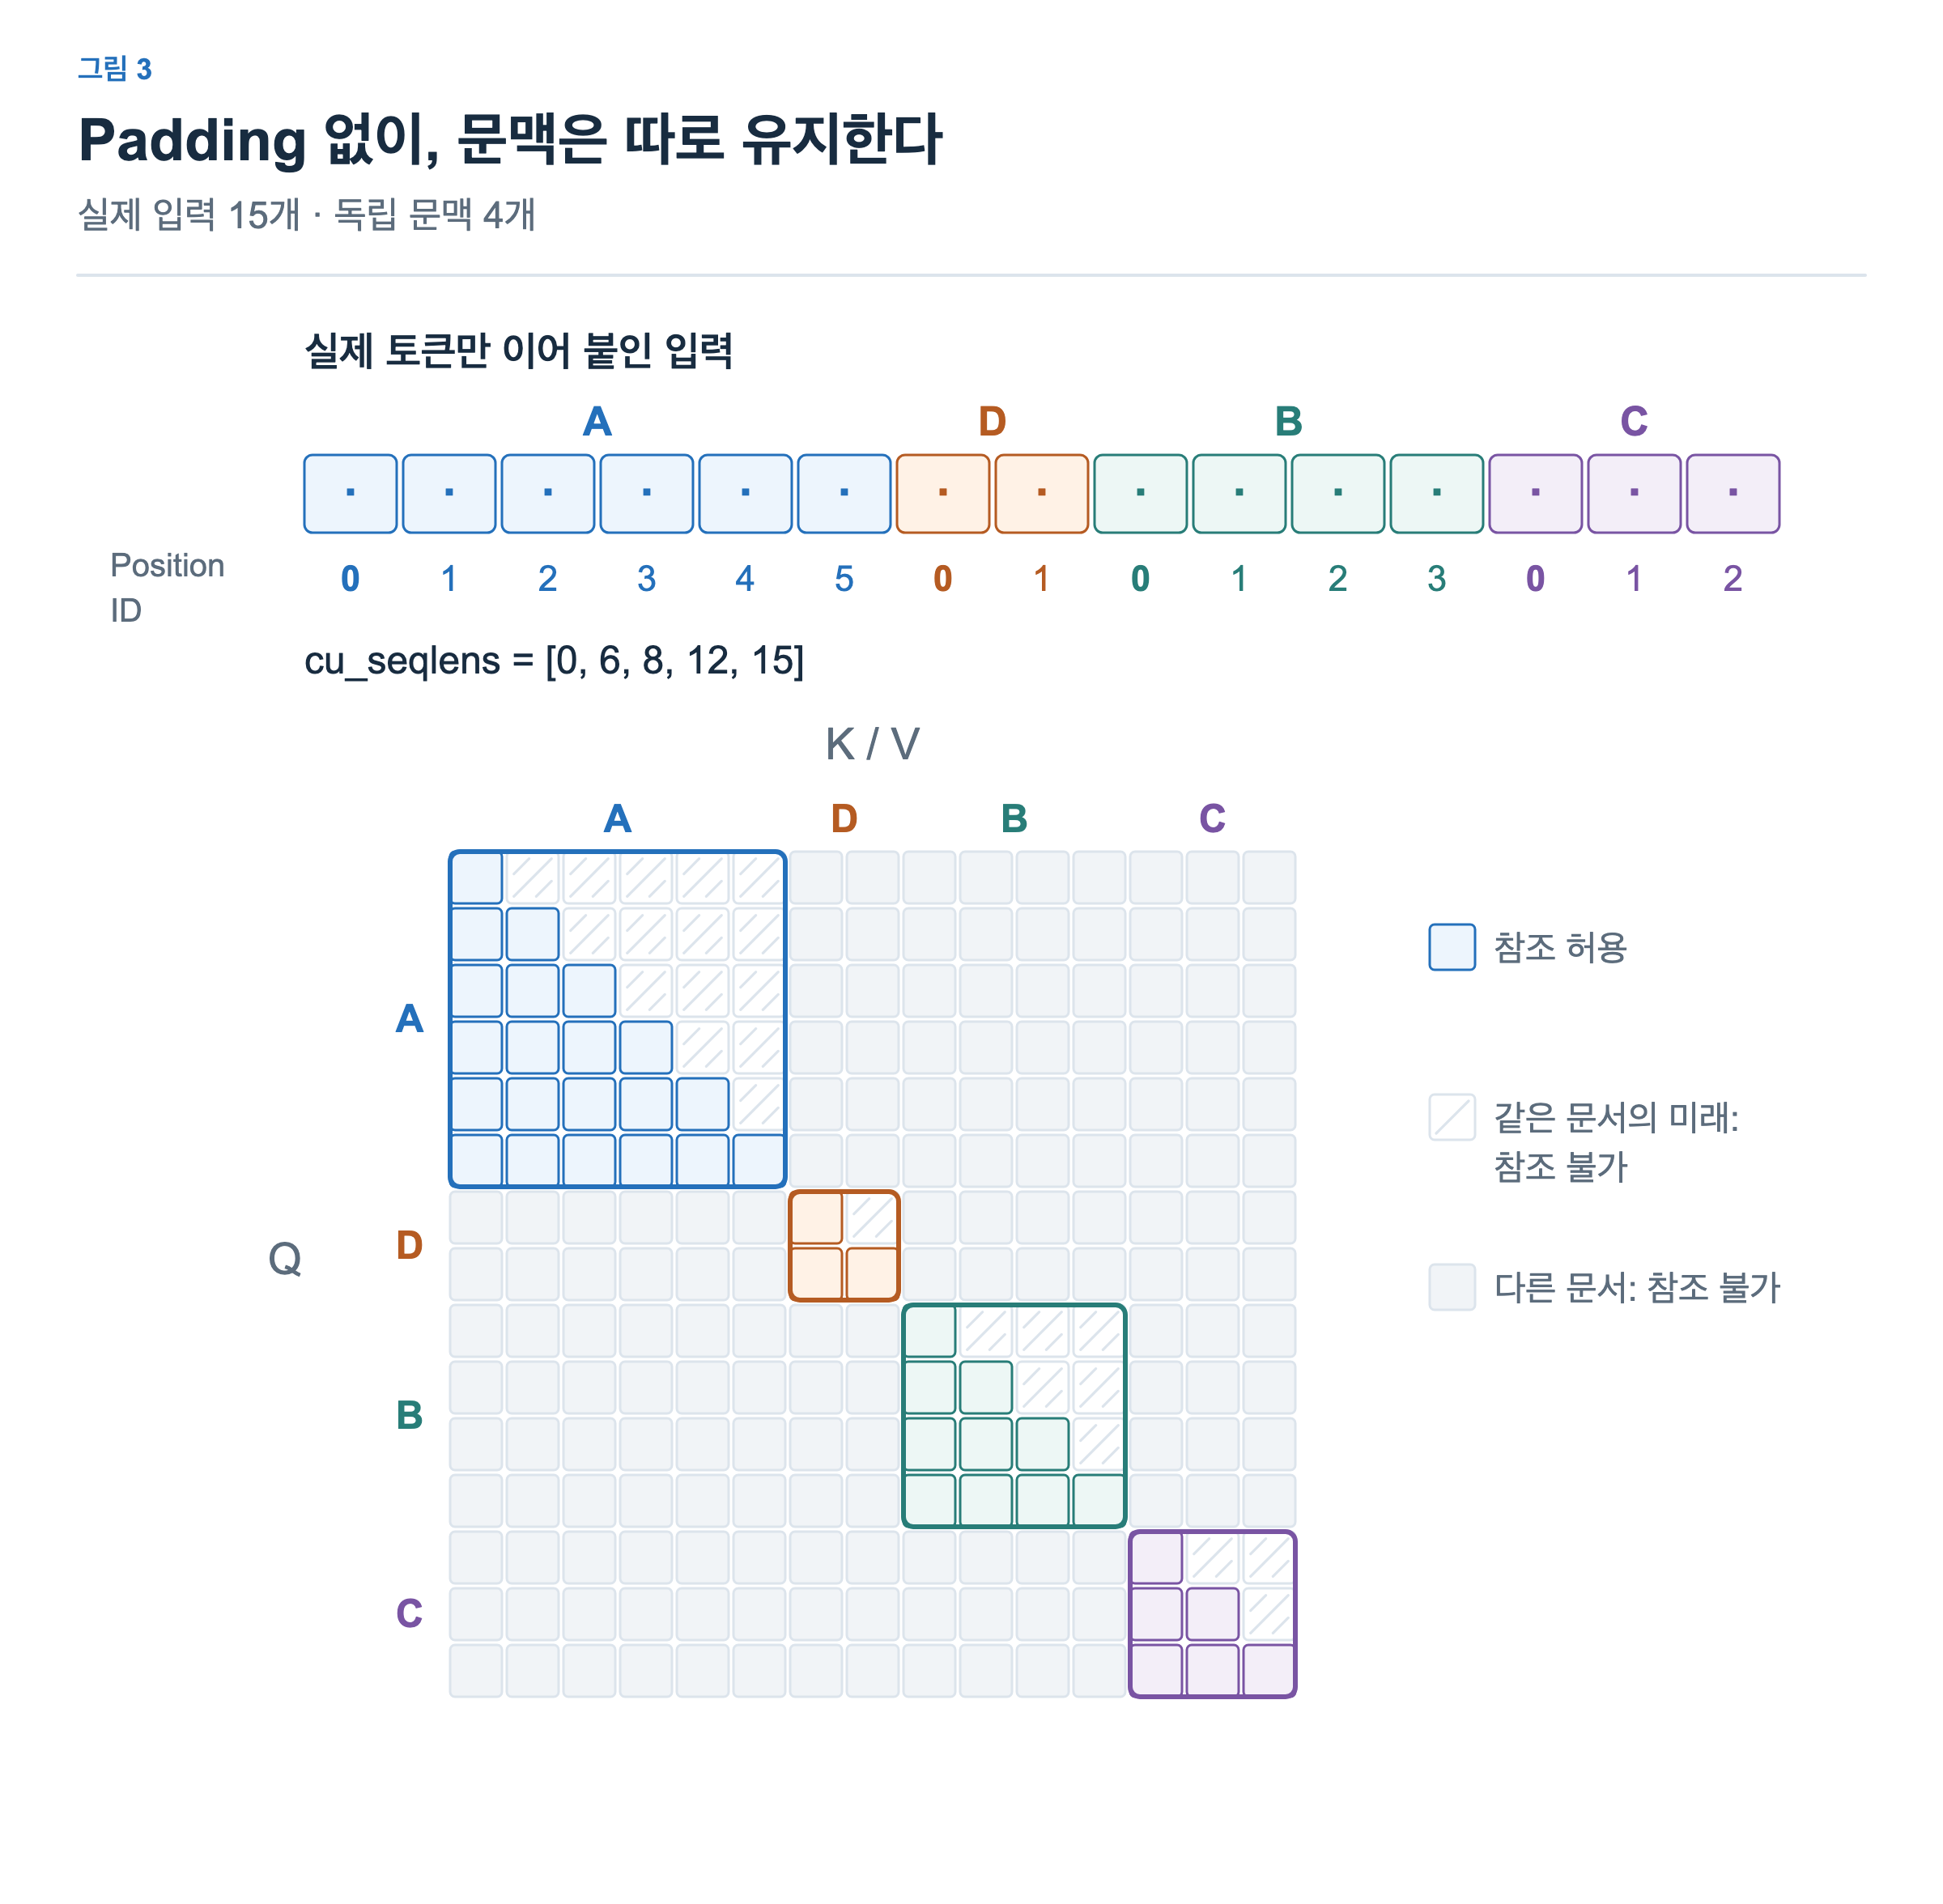
일반 QKV projection과 MLP는 실제 토큰 행을 모아 처리합니다. Attention에서는 PyTorch의 variable-length attention에 경계를 전달합니다. corrected의 GPU 경로는 torch.nn.attention.varlen.varlen_attn이며 window_size=(-1, 0)으로 각 구간의 causal attention을 수행합니다. Q/K/V는 토큰·head·head dimension, 즉 THD 형태로 표현합니다. THD라는 형태 자체만으로 문서가 격리되는 것은 아니며 경계와 causal 설정이 함께 필요합니다.
이 경로에서는 전체 flat T에 대한 T×T 문서 마스크를 만들지 않습니다. 초기 FlexAttention 경로는 문서별 BlockMask를 사용하고, CPU 참조 경로는 조각별 causal SDPA를 실행합니다. 세 경로는 문서 격리라는 같은 의미를 다른 방식으로 표현합니다. GPU 커널 내부의 tile 정렬은 모델 입력에 padding 행을 추가하는 것과 구별합니다.
Loss는 실제 정답 위치의 CE 합을 실제 정답 수로 나눕니다. 문서 길이가 다르다고 문서별 평균 loss를 같은 비중으로 다시 평균하지 않습니다. 여러 microbatch를 누적하는 경우에도 update 전체의 정답 수를 분모로 사용해야 같은 토큰 가중치를 유지할 수 있습니다. Gradient accumulation의 계산은 3편에서 자세히 살펴보겠습니다.
데이터 준비 실행과 확인할 값
RunPod 실행은 데이터 준비도 자동으로 수행합니다. 로컬에서 별도로 준비하려면 Python 3.11 이상의 환경에 requirements-worker.txt의 데이터 의존성을 설치한 뒤 다음 명령을 사용할 수 있습니다. 데이터 준비 자체에는 GPU가 필요하지 않습니다.
cd labs/training
python3 -m pip install -r requirements-worker.txt
python3 -m training_lab prepare --config corrected --cache data-cache
마지막에 출력되는 cache 디렉터리를 다음 검사에 넘깁니다. 아래 CACHE_DIRECTORY는 그 실제 경로로 바꿉니다.
python3 -m training_lab inspect-data CACHE_DIRECTORY \
  --config corrected --output data-stats.json
2026년 10월 4일 H100 실행에 사용한 cache는 다음과 같습니다. Raw tokens에는 문서 끝 EOS가 포함되며, prediction pairs는 각 문서에서 하나씩 적습니다.
| Split | 원본 문서 | Raw tokens | Prediction pairs |
|---|---|---|---|
| Train | 11,450 | 8,000,201 | 7,988,751 |
| Validation | 152 | 100,703 | 100,551 |
이것은 준비한 cache의 크기입니다. 학습 중 cache를 반복해 사용하면 누적 처리 토큰이 더 많아집니다. 검증에서는 같은 sampler 순서와 정해진 배치 수로 일부를 반복 평가합니다. 모든 검증 cache를 매번 소진했다고 해석하지 않습니다.
작은 CPU 데이터 표본에서도 실제 긴 문서를 확인했습니다. EOS를 포함한 8,991토큰 문서는 8,990개의 next-token 쌍을 만들고, 입력 길이 4,096·4,096·798로 나뉩니다. 별도의 packing 표본에서는 네 조각의 실제 입력 4,055토큰을 한 논리 pack에 담았습니다. 4k 용량에서 남은 41칸은 모델 입력에 넣지 않았습니다.
검사에서는 길이 통계와 pack 사용률뿐 아니라 다음 관계를 확인합니다.
- 원본 문서 ID가 train과 validation에 동시에 들어가지 않는다.
- 분할 전후 입력·정답 쌍이 빠지거나 중복되지 않고, 실제 문서 끝 EOS가 유지된다.
- 독립 실행과 packed 실행의 출력·gradient가 허용 오차 안에서 같다.
- 앞 문서의 입력을 바꿔도 다른 문서의 출력이 변하지 않는다.
- 모델 입력 길이는 실제 입력 수이며, 조각별 position이 0부터 시작한다.
- 같은 sampler 상태로 복원하면 다음 배치가 이어진다.
이 조건들은 CPU 참조 검사와 실제 GPU 사전 검사로 확인했습니다. CUDA varlen의 수치 오차와 문서 격리도 각각 대조합니다. Packing 비율이 높다는 것만으로 이런 의미가 보존된다고 판단하지 않습니다.
다른 데이터 구성과의 차이
미리 고정 길이 시퀀스를 만들어 MBS=1로 실행하는 방법도 있습니다. 여러 문서를 포함한다면 그 방식도 경계를 표현해야 합니다. MBS=1이 문서 격리나 padding-free 실행을 자동으로 보장하지는 않습니다. 적절한 경계가 있다면 같은 독립 문맥을 실행할 수 있지만, 배치·packing을 바꾸려면 미리 만든 묶음을 다시 준비할 수 있습니다.
| 선택 | 얻는 것 | 고려할 비용 |
|---|---|---|
| 고정 길이로 추가 절단 | 입력 shape를 일정하게 만들기 쉬움 | 짧은 문서도 pack 경계에서 잘릴 수 있음 |
| Padded batch | 문서별 행과 길이를 표현하기 쉬움 | padding을 embedding·MLP 등에서도 처리할 수 있음 |
| Offline prepacking | 실행 시 조합을 찾는 작업 감소 | 묶는 정책이 바뀌면 재구성이 필요할 수 있음 |
| Runtime best-fit | 같은 문서 cache에서 배치·문맥·packing 변경 | CPU 조합 비용과 순서·재시작 상태 관리 |
Fewer Truncations Improve Language Modeling은 불필요한 문서 절단을 줄이는 packing이 연구의 사전학습 조건에서 학습 결과를 개선했다고 보고합니다. 이는 문서 보존을 기본으로 선택한 근거 중 하나입니다. 우리 FineWeb 표본·모델·실행 예산에서도 항상 더 좋은 품질을 보장하는 결과는 아니며, 현재의 후보 버퍼 구현을 논문의 전체 알고리즘과 동일하다고 설명하지도 않습니다.
우리 기본은 원본 문서 보관 → 독립 조각 생성 → 실행 시점 best-fit 배치 → 실제 토큰과 경계 metadata 전달입니다. 이제 데이터와 실행 환경이 준비되었으므로 1편에서는 입력의 출력 확률을 loss로 바꾸고, backward와 optimizer update로 이어지는 학습 한 스텝을 따라가겠습니다.