특집 · 2026-10-18
DeepSeek의 KV 캐시: 토큰당 3.9 MB에서 890 B까지
DeepSeek의 attention이 V2에서 V4.1까지 어떻게 바뀌었는지, 세대마다 토큰당 KV 캐시를 직접 계산하며 따라갑니다.
긴 문맥 추론에서 중요한 비용 중 하나는 KV 캐시입니다. 새 토큰을 생성할 때마다 이전 위치의 Key와 Value를 다시 계산하지 않으려고 저장해 두는 값입니다. KV 캐시 글에서 본 것처럼, 이 저장량은 문맥 길이에 비례하게 늘고 동시에 처리하는 요청 수만큼 곱해집니다. 그래서 토큰 하나가 늘 때 캐시가 얼마나 늘어나는지가 긴 문맥 추론의 비용을 크게 좌우합니다.
DeepSeek은 V2부터 V4.1까지 attention 구조를 여러 번 바꿨습니다. 이 글은 그 변화를 토큰당 KV 캐시라는 하나의 숫자로 따라갑니다. V2 모델과 같은 크기로 Key와 Value를 모두 저장하는 가상의 MHA 모델은 토큰당 약 3.9 MB를 사용합니다. V4.1-Flash는 토큰당 890 B를 사용합니다(긴 문맥에서 토큰마다 늘어나는 양이며, 최근 위치를 따로 보관하는 local KV는 별도입니다). 약 4,400분의 1입니다.
이 차이는 한 번에 생긴 것이 아닙니다. 토큰당 캐시는 대략 네 요소로 나눠 볼 수 있습니다.
토큰당 KV 캐시 ≈ 저장 벡터의 폭(차원) × 저장하는 층 수 × 원소당 bytes ÷ 압축 비율(토큰 몇 개의 KV를 하나로 합쳐 저장하는가)V2의 MLA는 저장 벡터의 폭을 줄였습니다. V3.2의 DSA는 저장량 대신 읽는 위치를 줄였습니다. V4의 CSA·HCA는 토큰 방향으로 압축해 여러 토큰의 KV를 하나로 합쳐 저장했고, V4.1의 CSA2는 층끼리 KV를 나눠 써서 문맥 전체의 KV를 저장하는 층 수를 줄였습니다. 그 사이 원소당 bytes도 BF16(2 B)에서 FP8(1 B), FP4(0.5 B)로 내려갔습니다. 아래에서는 세대마다 무엇이 바뀌었는지 그림으로 확인하고, 그 숫자를 직접 계산해 보겠습니다.
토큰당 KV 캐시 한눈에 보기
먼저 다섯 모델의 숫자를 한 그림에 놓겠습니다. 막대는 모두 로그 눈금입니다. 한 칸이 10배이므로 막대 길이의 차이를 비율로 읽으면 안 됩니다. 막대 끝의 숫자와 “MHA의 약 1/N”을 함께 보면 됩니다.
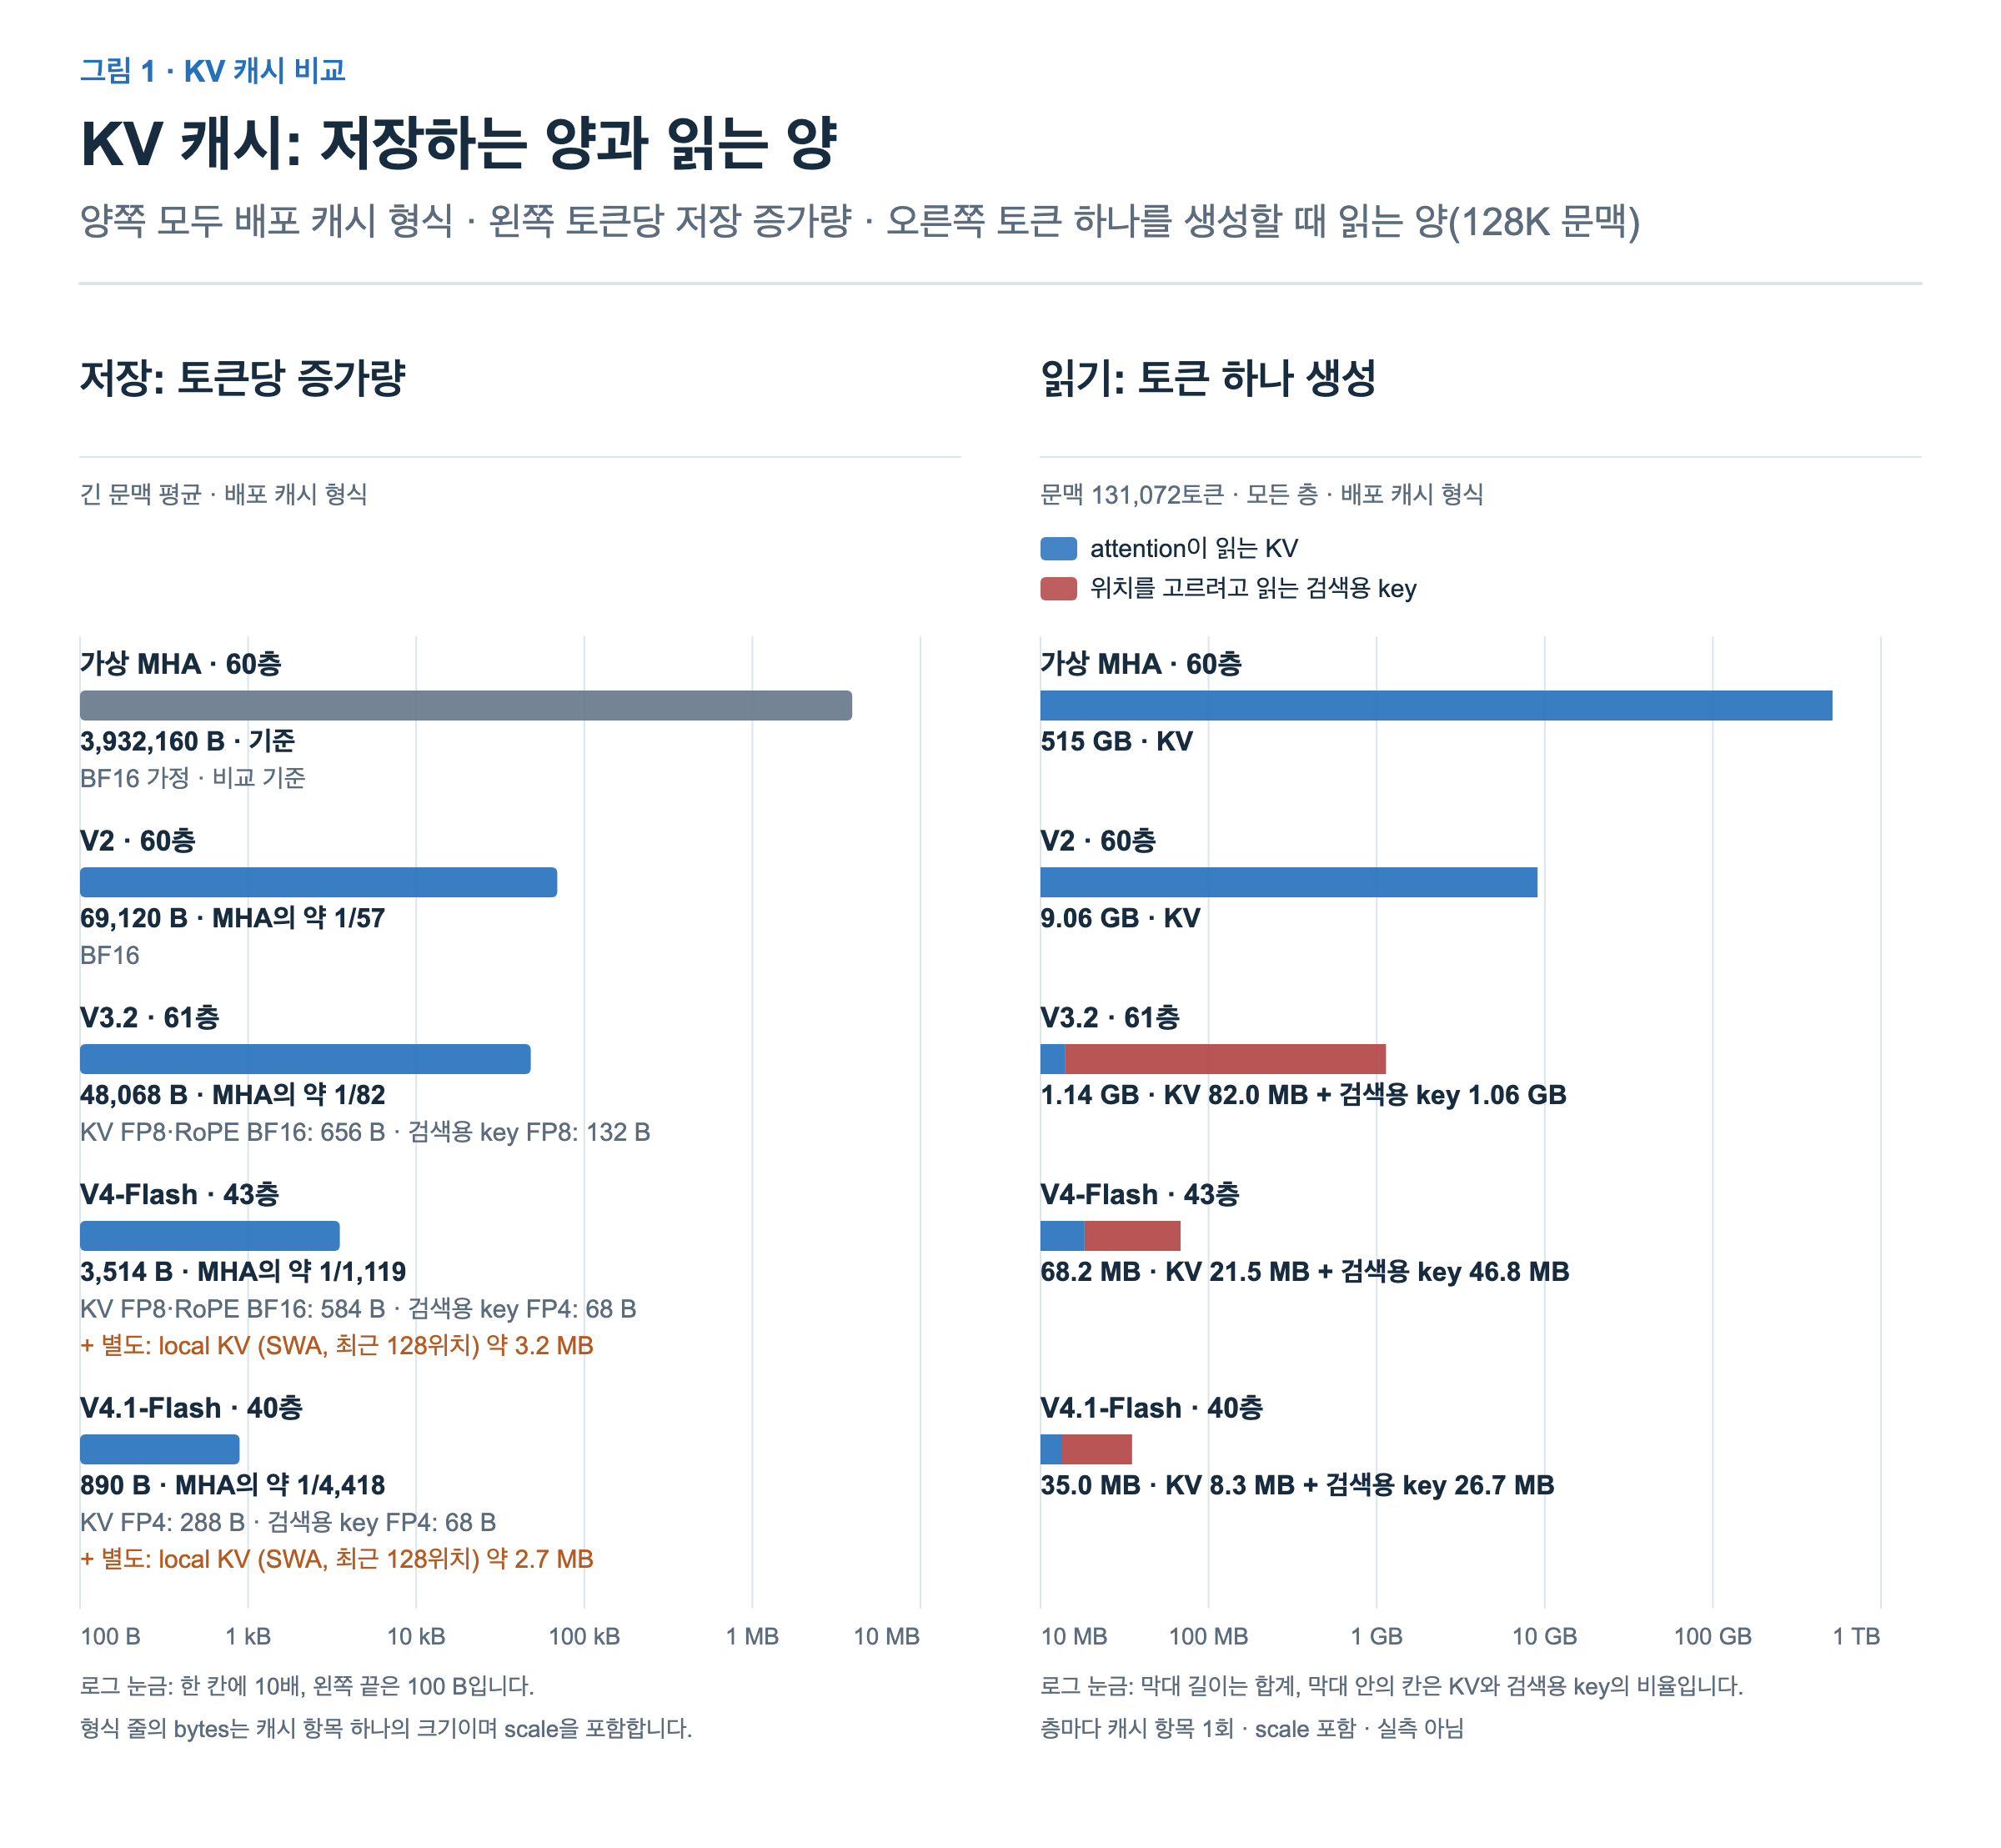
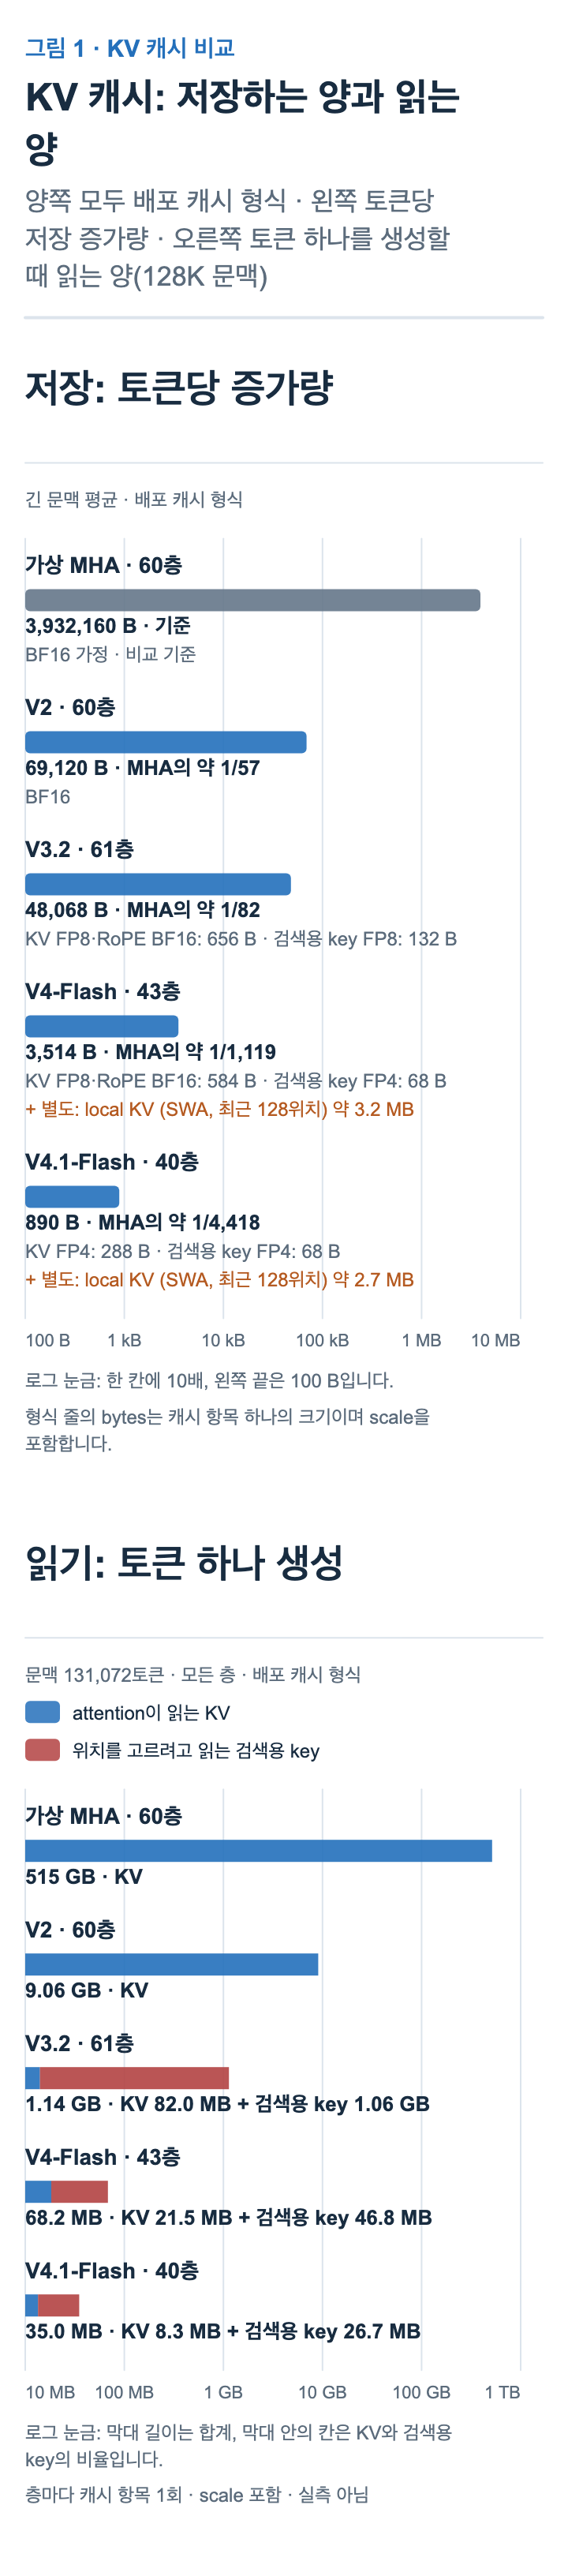
저장량. 긴 문맥에서 토큰당 늘어나는 양을 이 글에서 정한 배포 캐시 형식으로 계산했습니다. 배포 캐시 형식은 실제 서빙 엔진이 캐시를 저장하는 형식(정밀도와 scale 배치)입니다. V2는 BF16, V3.2와 V4는 FP8·BF16 혼합 KV, V4.1은 FP4 global KV(문맥 전체에 걸쳐 쌓이는 KV)입니다. 가상 MHA는 BF16으로 저장한다고 가정한 비교 기준입니다. 이 절에서는 이쪽을 봅니다.
읽는 양. 128K 문맥에서 토큰 하나를 생성할 때 모든 층이 읽는 양입니다. 왼쪽과 같은 배포 캐시 형식으로 계산했습니다. 막대 길이(합계)는 로그 눈금이지만, 막대 안의 색 구간은 KV와 검색용 key의 비율로 나눈 것입니다. 단위가 달라 눈금을 따로 두었고, V3.2 절에서 자세히 다룹니다.
각 막대 아래에 형식과 bytes를 적었습니다. 형식 줄의 bytes는 한 층에 저장하는 항목 하나의 크기이고, 굵은 숫자는 이를 층 수와 압축 비율로 합한 토큰당 값입니다. 그 계산 방식은 각 버전을 다루는 섹션에서 확인할 수 있습니다. 형식 줄의 scale은 낮은 정밀도로 저장한 값을 원래 크기로 되돌리는 배율입니다.
몇 가지가 눈에 띕니다. 왼쪽 저장량에서 V3.2는 V2보다 작지만, 이것은 FP8 저장 덕분입니다. 정밀도를 같게 맞추면 V3.2가 오히려 더 큽니다. 위치를 고르는 데 쓰는 검색용 key를 추가로 저장하기 때문입니다. V4에서 크기가 한 자릿수 이상 줄고, V4.1에서 890 B에 도달합니다. V4와 V4.1 아래에는 주황색으로 “별도: local KV (SWA, 최근 128위치)“가 붙어 있습니다. 최근 128위치만 따로 보관하는 KV입니다. 글을 끝까지 읽으면 이 값들이 왜 이렇게 나오는지 알 수 있습니다.
더 알아보기: 이 글에서 “토큰당 KV 캐시”를 세는 방법
- 긴 문맥에서의 평균 증가량입니다. 압축 모델은 토큰 4개나 128개가 모여야 압축된 KV 하나가 생기기 때문에, 매 토큰 같은 크기가 쌓이지는 않습니다. 문맥이 충분히 길 때 전체 캐시(아래의 local KV는 제외)를 토큰 수로 나눈 값을 씁니다.
- 모델 본체 한 벌, 요청 하나 기준입니다. 동시에 처리하는 요청이 여러 개면 캐시가 요청마다 따로 쌓이므로 그 수만큼 곱하면 됩니다. GPU 한 장의 저장량은 텐서 병렬화가 캐시를 나누는지 복제하는지에 따라 따로 계산해야 합니다. MTP 모듈(다음 여러 토큰을 함께 예측하는 보조 모듈)은 제외했습니다.
- 검색용 key(indexer key)를 포함합니다. V3.2 이후 모델은 읽을 위치를 고르기 위한 작은 key를 따로 저장합니다. 이것도 문맥에 비례해 쌓이므로 함께 셉니다.
- 최근 위치만 보관하는 local KV 캐시는 따로 적습니다. 최근 128위치가 찬 뒤에는 더 늘지 않기 때문에 토큰당 증가량에 넣지 않았습니다. 그림의 local KV 값은 최근 128위치에 해당하는 데이터 크기이며, 압축 중간 상태는 제외했습니다.
- GPU 실측값이 아니라 모델 설정과 캐시 형식으로 계산한 값입니다.
- 가상 MHA는 V2와 같은 크기(60층, head 128개, head당 128차원)로 모든 head의 Key와 Value를 저장한다고 가정한 기준입니다. 실제로 존재하는 모델이 아니며, 같은 성능을 내는 MHA 모델이라는 뜻도 아닙니다.
기준점: 모든 head의 Key와 Value를 저장하는 MHA
출발점은 기본 attention입니다. MHA에서는 층마다 head별 Key와 Value를 만들고, 그 둘을 모두 캐시에 저장합니다. V2의 숫자를 넣으면 토큰 하나를 저장할 때 다음과 같습니다.
가상 MHA: 60층 × 128 head × (Key 128 + Value 128) × 2 B(BF16) = 3,932,160 B ≈ 3.9 MB토큰 하나에 약 3.9 MB이면, 128K 토큰(131,072 위치)의 문맥은 요청 하나의 캐시만으로 약 515 GB가 필요합니다. decode에서는 새 토큰 하나를 만들 때마다 이 캐시 전체를 읽어야 합니다. 저장량과 읽는 양이 함께 문제가 되는 것입니다. MQA·GQA는 여러 head가 Key와 Value를 공유해 이 값을 줄였습니다. DeepSeek은 다른 길을 택했습니다.
DeepSeek-V2
V2는 MLA(Multi-head Latent Attention)로 저장 벡터의 폭을 줄였습니다. head별 Key와 Value 대신, 이를 만들 수 있는 작은 공통 벡터(latent)와 위치용 Key를 저장합니다. MHA의 Key와 Value를 압축했다가 복원하는 것이 아니라, 처음부터 latent에서 Key와 Value를 만드는 구조로 학습한 모델입니다. 아래에서는 무엇을 저장하는지, head별 Key와 Value를 펼치지 않고(캐시에서 다시 만들어 내지 않고) attention을 계산하는 방법을 본 뒤 토큰당 저장량을 계산합니다. 그림 2는 그 효과를 보여 줍니다.
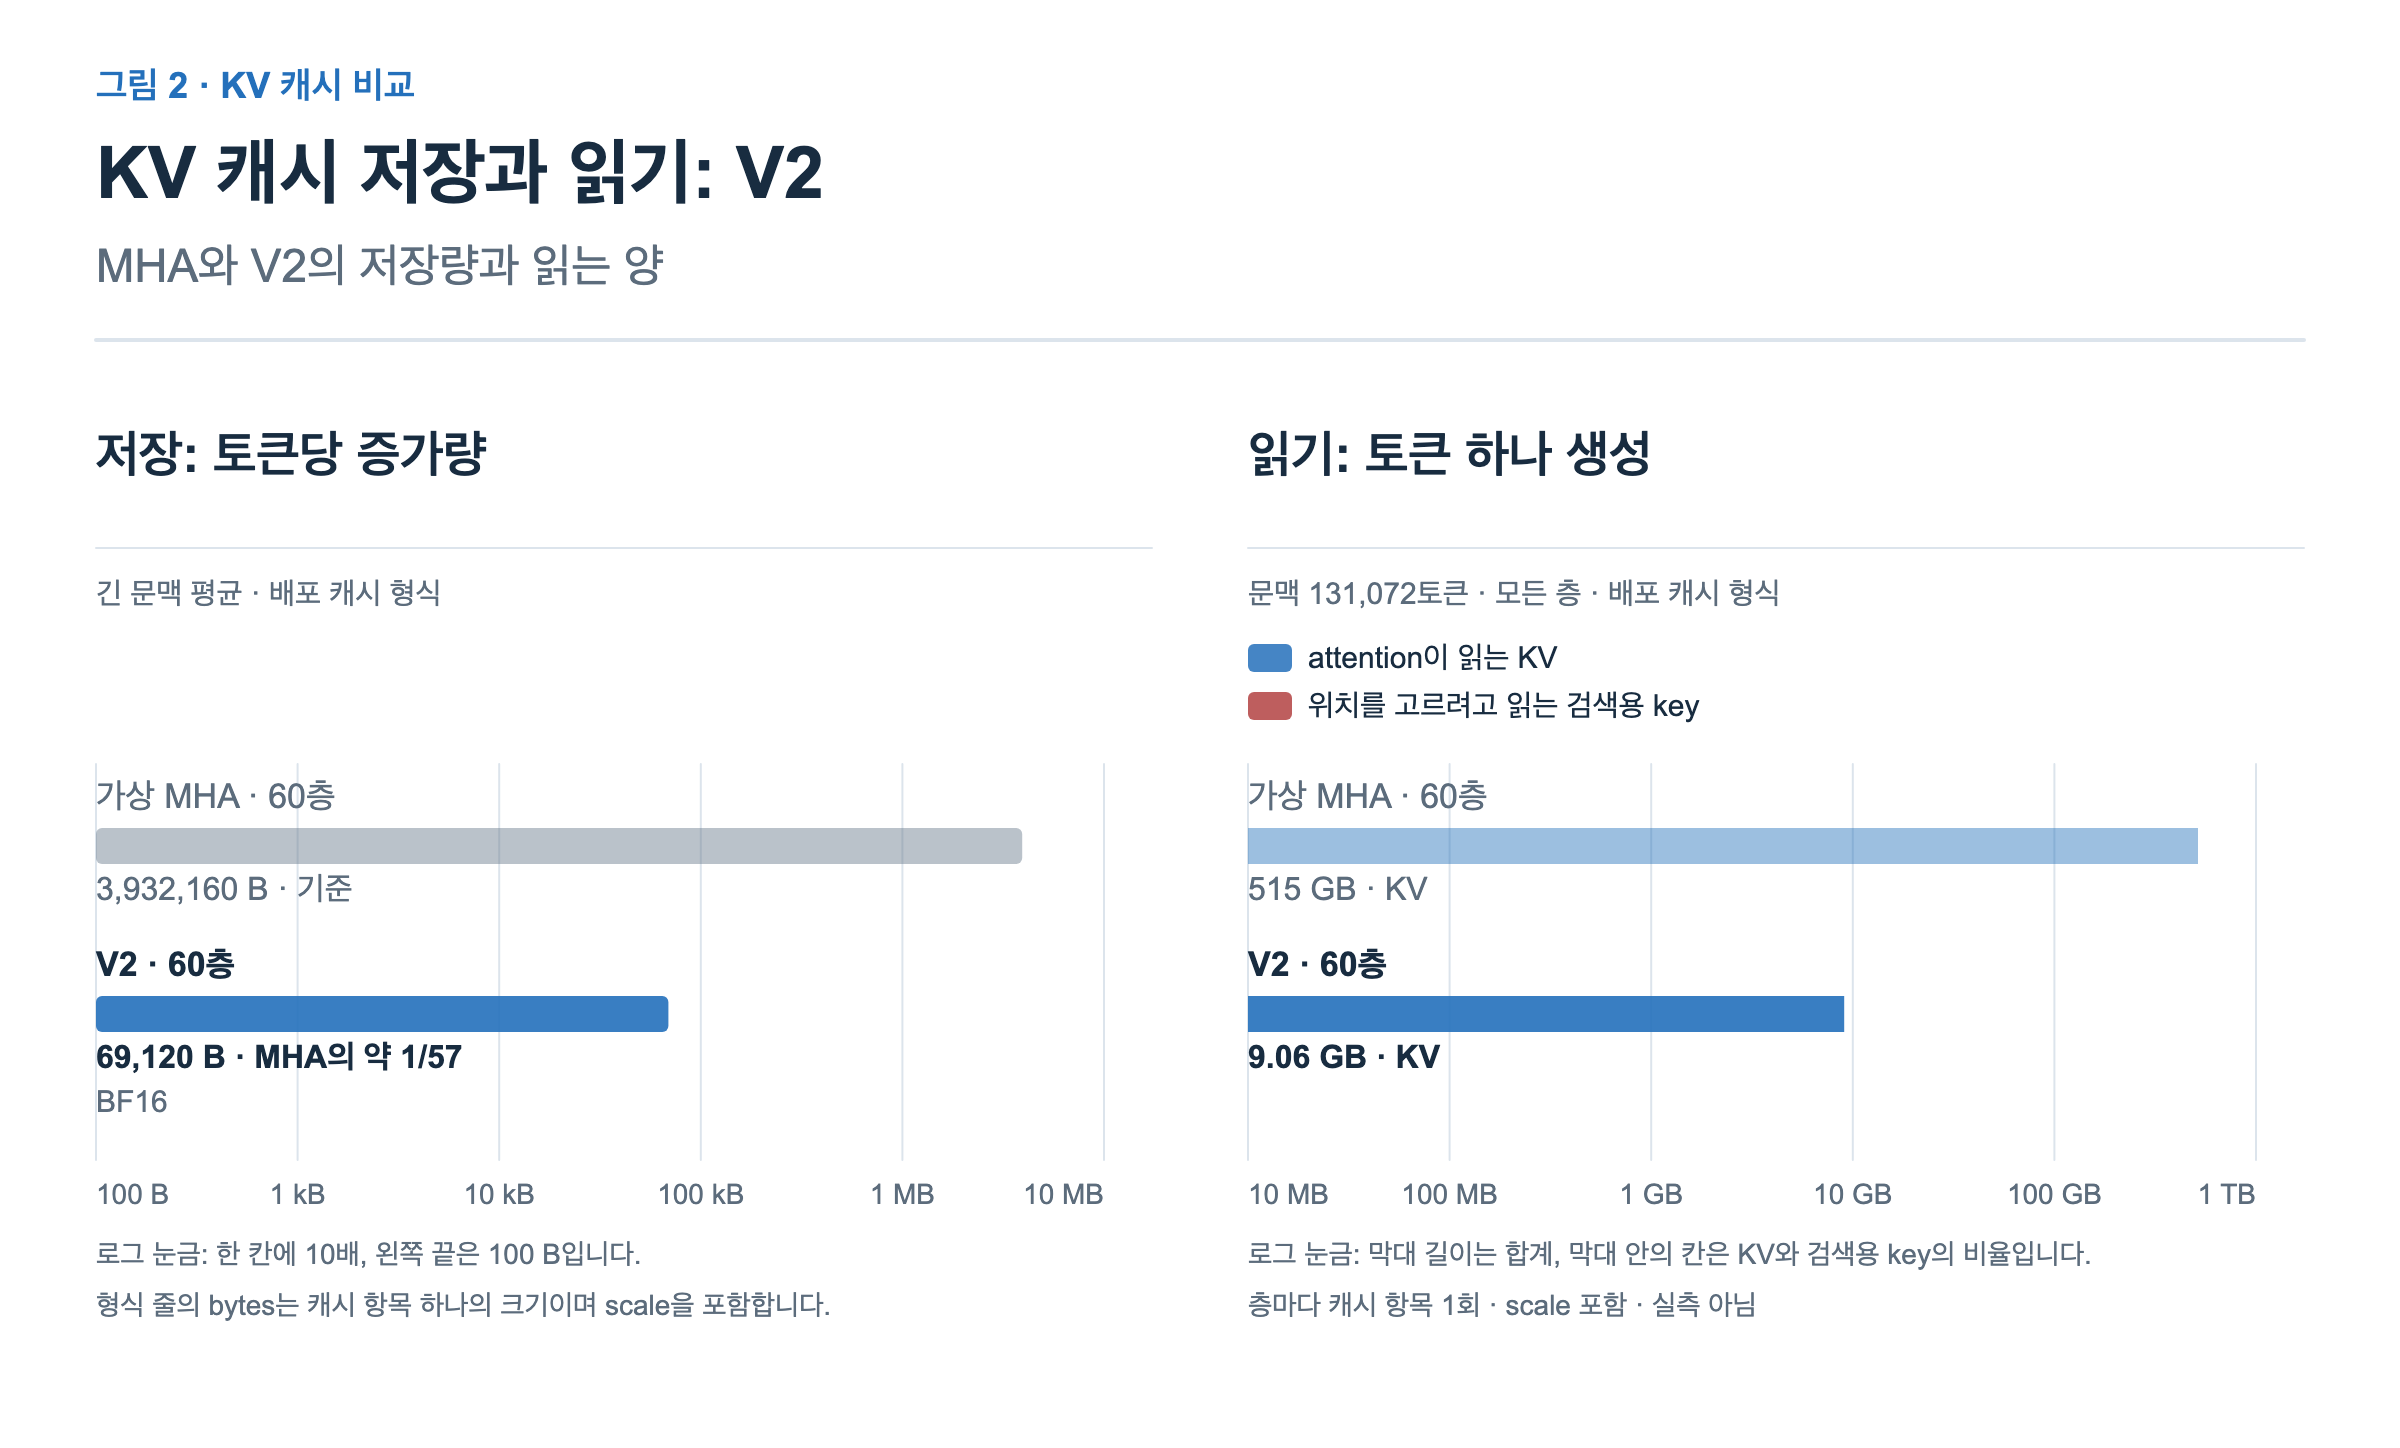
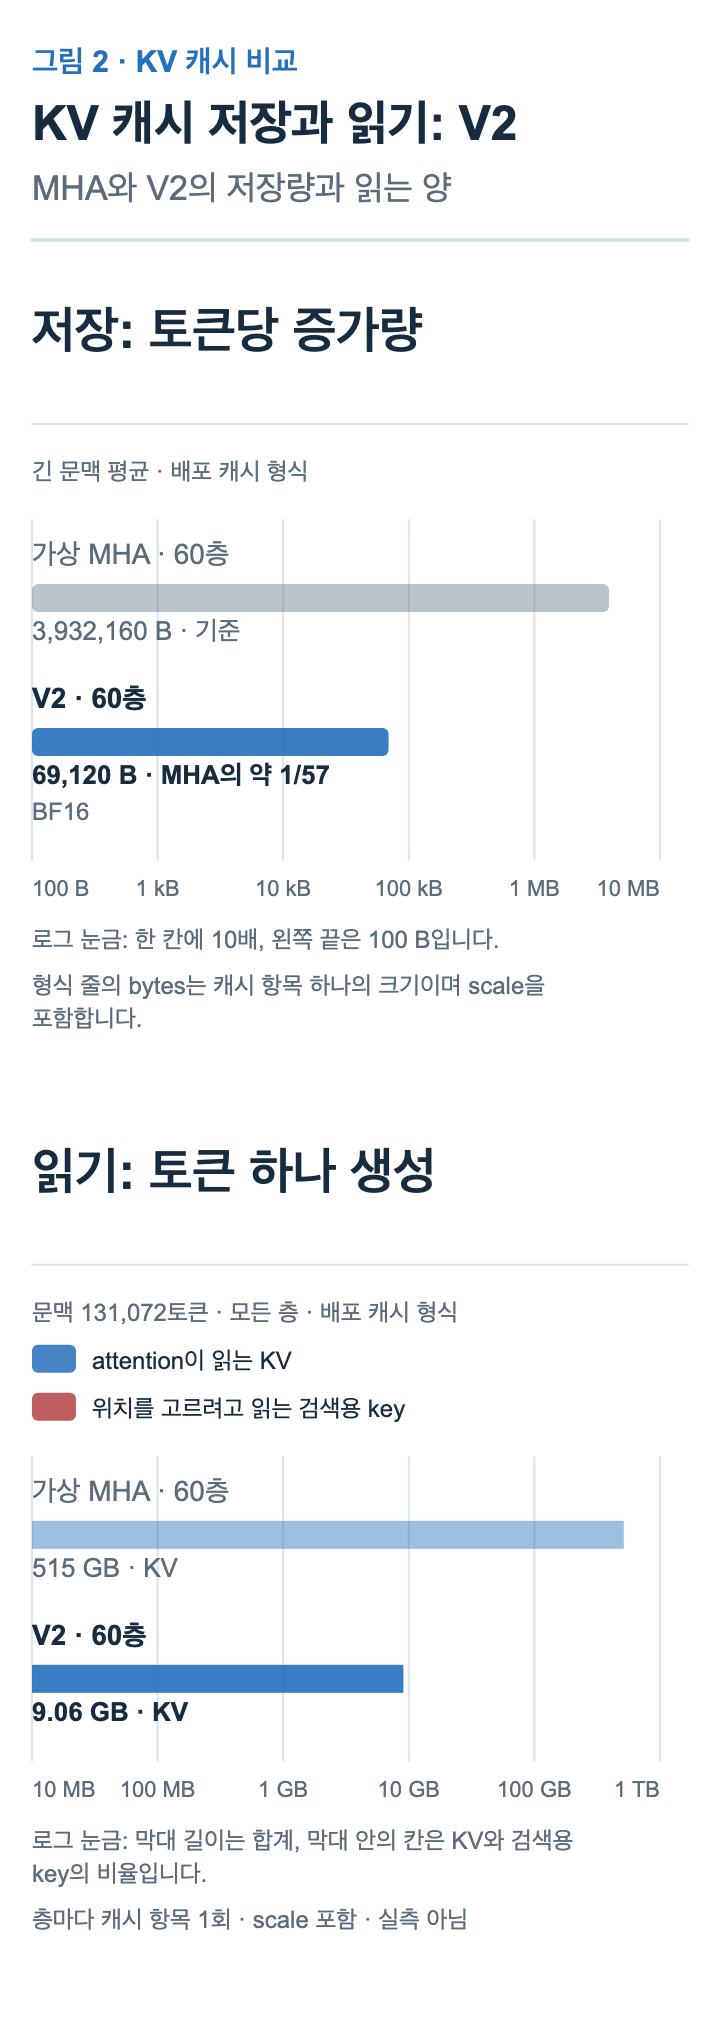
V2는 토큰당 69,120 B로 MHA의 약 1/57입니다.
문맥 131,072토큰에서 토큰 하나를 생성할 때 읽는 양은 가상 MHA의 약 515 GB에서 약 9.06 GB로 줄었습니다. 두 모델 모두 BF16으로 저장합니다.
MLA: 같은 입력에서 갈라지는 세 경로
그림을 보기 전에 표기를 먼저 정리하겠습니다. 이 글의 행렬 그림에서 활성값은 행이 토큰, 열이 특징이고, 가중치는 [입력, 출력] 모양입니다. 상자 폭은 열 차원의 크기 순서만 나타내며 실제 크기에 비례하지 않습니다. 보라색 상자는 학습하는 가중치 W이고, W의 위첨자는 그 가중치가 하는 일을 나타냅니다.
| 표기 | 뜻 | 예 |
|---|---|---|
| D | down-projection. 차원을 줄여 작은 latent를 만듭니다 | WDQ: X → CQ, WDKV: X → CKV |
| U | up-projection. latent에서 head별 값을 다시 만듭니다 | WUQ: CQ → head별 Query, WUK·WUV: CKV → head별 Key·Value |
| Q, K, V, O | 만드는 대상: Query, Key, Value, Output | WO: 출력 투영 |
| R | RoPE(위치 회전)를 적용하는 위치 성분 | WQR, WKR, QRh, KR |
| C | 글자 CQ, CKV는 압축된 latent, 위첨자 C(QCh, KCh)는 내용 성분 | |
| 아래첨자 h | head h의 값. head마다 따로 있습니다 | QCh, WUKh |
| T, D, H | 토큰 수, 입력 X의 폭(hidden 차원), head 수 | X: [T, D] |
| dk, dv, dr, rq, rkv | head당 Key 내용 차원, Value 차원, 위치 차원, Query latent 폭, KV latent 폭 | |
| A, B, BT | 곱셈 기호 옆의 표시. 두 피연산자 중 앞에 곱하는 쪽이 A, 뒤가 B입니다. BT로 표시하면 B를 전치해서 곱합니다 |
그림은 문맥의 T개 토큰을 한꺼번에 계산하는 모습으로 그렸습니다. decode에서 새 토큰 하나를 만들 때는 Query 쪽이 마지막 한 행뿐이고, Key와 Value 쪽은 캐시에 있는 T개 위치 전체입니다.
그림 3은 MLA 한 층에서 입력 X가 세 경로로 갈라지는 모습입니다. Query를 만드는 경로, 공유 KV latent를 만드는 경로, 위치용 Key를 만드는 경로입니다. 경로마다 같은 입력 X에서 다시 시작하도록 나눠 그렸습니다.
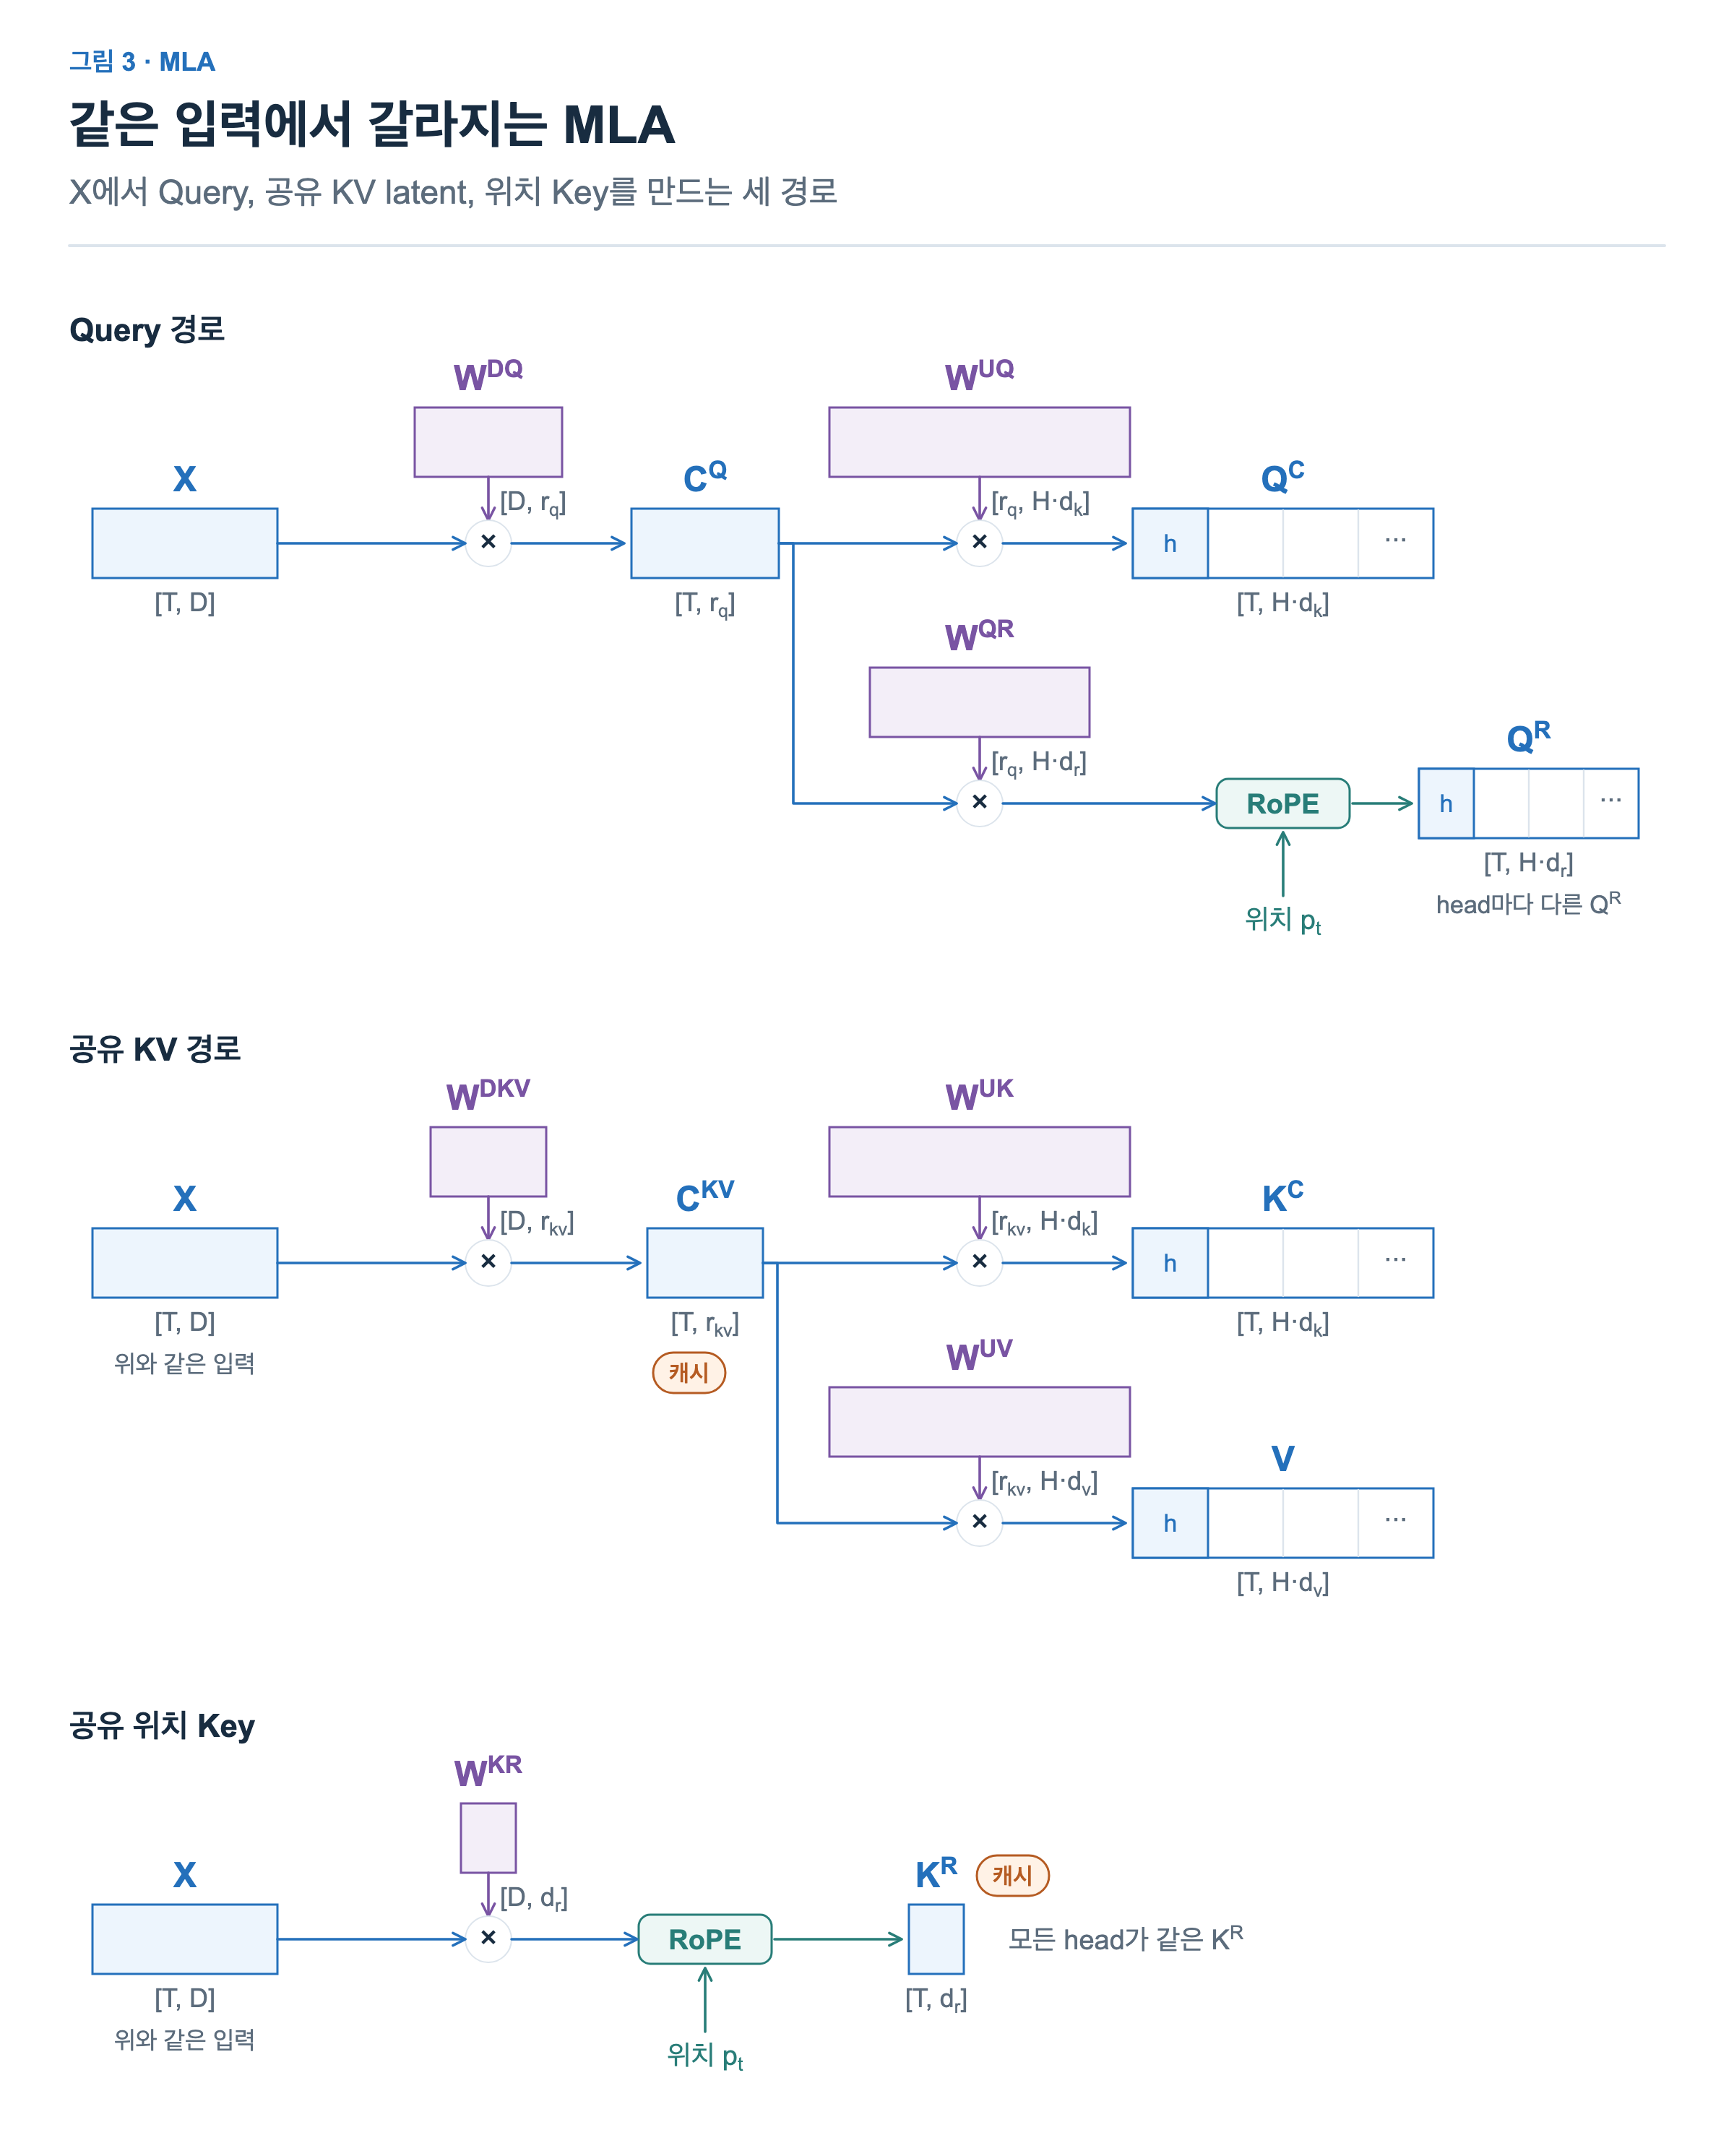
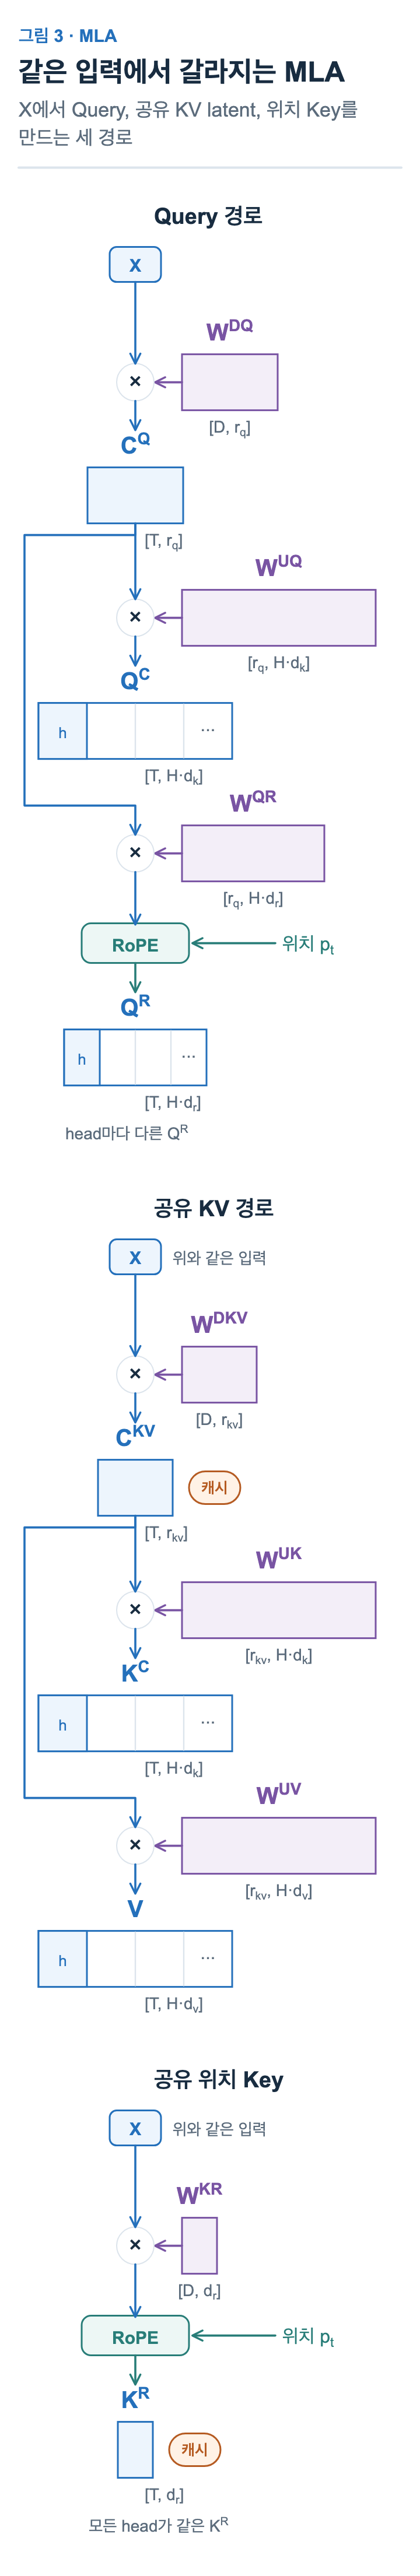
Query 경로. X를 Query latent CQ(1,536차원)로 줄인 뒤, head마다 내용용 QCh와 위치용 QRh를 만듭니다. Query는 이후 토큰을 위한 KV 캐시에 저장하지 않습니다.
공유 KV 경로. X를 512차원 CKV로 줄여 캐시에 저장합니다. head별 Key와 Value는 CKV에 head마다 다른 WUKh, WUVh를 곱해 만들 수 있으므로 저장하지 않습니다.
공유 위치 Key. RoPE를 적용한 64차원 KR을 하나 만들어 모든 head가 공유하고 캐시에 저장합니다. 위치 정보는 이 KR에만 넣고, CKV에는 RoPE를 적용하지 않습니다. 위치 성분을 따로 두는 이유는 뒤의 “흡수”와 관련이 있어서, 흡수를 본 다음에 설명합니다.
캐시에 남는 것은 CKV(512차원)와 KR(64차원) 두 가지입니다.
더 알아보기: RoPE의 회전과 위치 차이
RoPE는 벡터의 차원을 둘씩 짝지어, 위치에 비례하는 각도만큼 회전시킵니다. 위치 t의 Query와 위치 s의 Key를 각각 회전한 뒤 내적하면, 두 회전이 합쳐져 위치의 차이만큼의 회전 하나만 남습니다. 그래서 점수가 절대 위치가 아니라 상대 거리에 따라 달라집니다. 이렇게 위치 정보는 Query와 Key가 만나는 점수 계산 안에, 위치 차이마다 다른 회전 R(t − s)로 들어갑니다. 뒤에서 볼 V4의 역회전도 이 성질을 씁니다.
내용 점수와 위치 점수
그림 4는 한 head의 attention 계산을 두 줄로 나눠 그렸습니다. 위 줄은 점수에서 확률까지, 아래 줄은 확률로 Value를 가중합해 출력까지입니다.
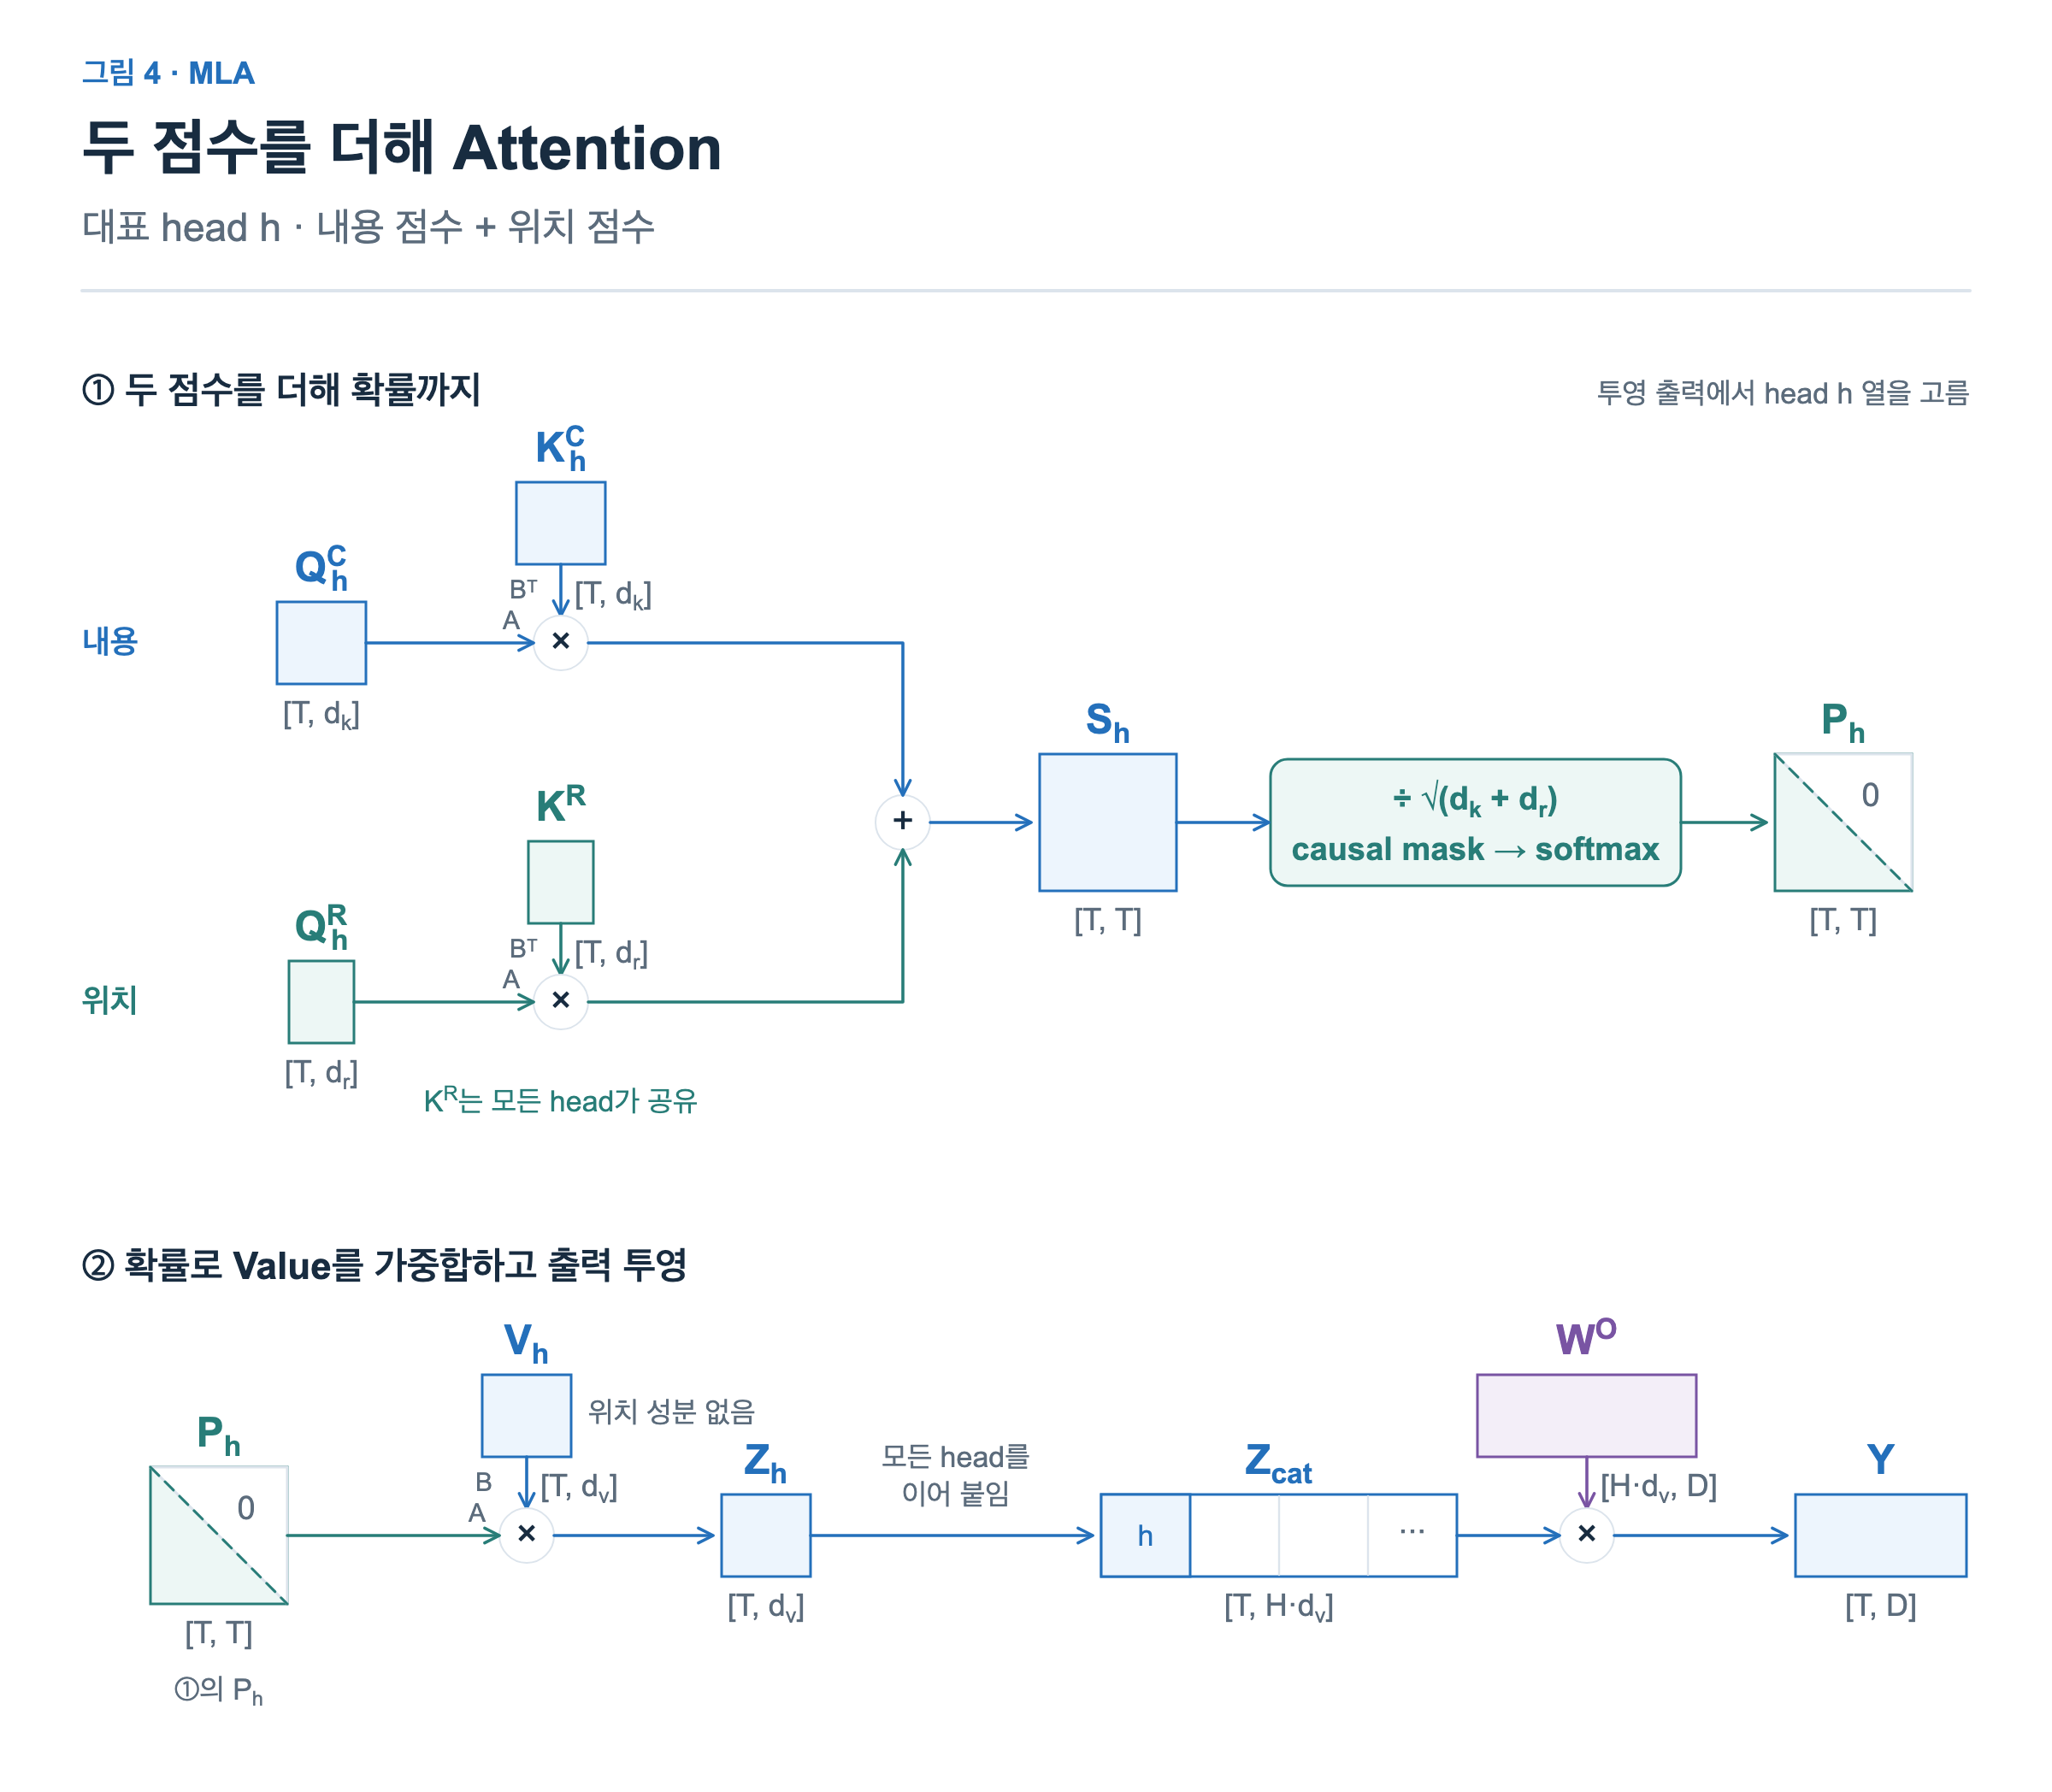
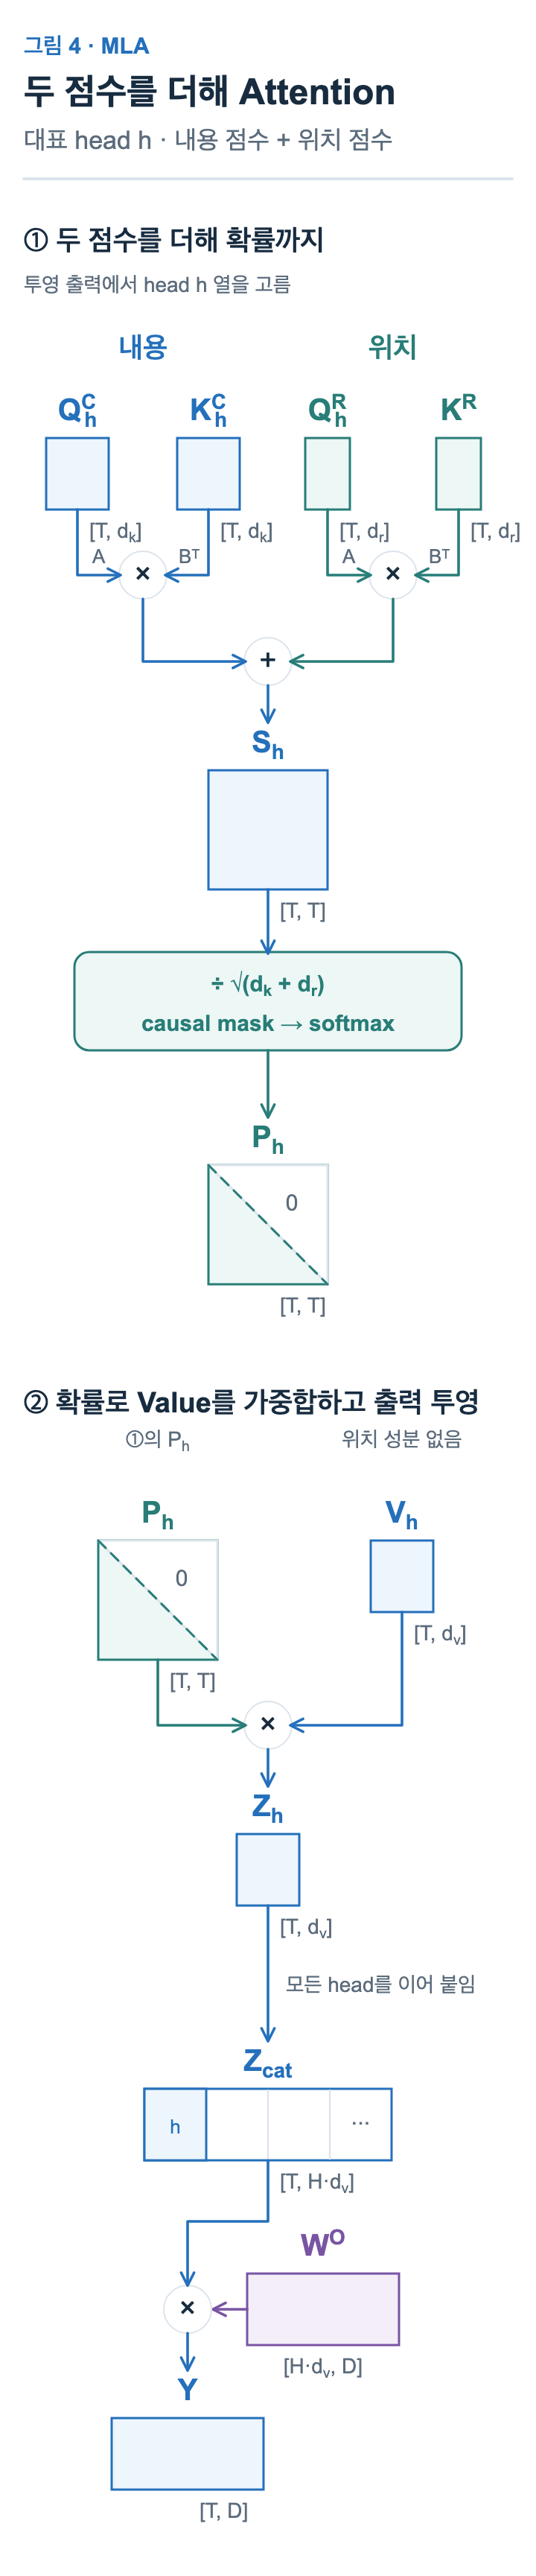
① 점수에서 확률까지. 점수는 두 부분의 합입니다. 내용 성분끼리 곱한 점수 QCh (KCh)T와, 위치 성분끼리 곱한 점수 QRh (KR)T입니다. 두 성분을 이어 붙인 Query와 Key의 내적과 같습니다. 합한 점수 Sh를 √(dk + dr)로 나누고 causal mask와 softmax를 거치면 확률 Ph가 됩니다.
② 출력까지. 확률 Ph로 Vh를 가중합해 Zh를 만들고, 모든 head의 결과를 이어 붙여 WO로 출력 투영합니다.
이 그림만 보면 MLA도 결국 head별 Key와 Value를 모두 펼쳐 계산하는 것처럼 보입니다. 그러면 저장은 작게 해도 매 단계 Key와 Value를 복원하는 계산이 필요해집니다. decode에서는 곱하는 순서를 바꾸는 흡수로 이 복원을 피합니다.
Key와 Value를 펼치지 않고 계산하기
그림 5는 같은 내용 점수를 세 가지 방식으로 계산합니다. 세 줄은 차례로 실행하는 단계가 아니라, 같은 CQ와 CKV에서 같은 결과를 내는 세 가지 계산 순서입니다.
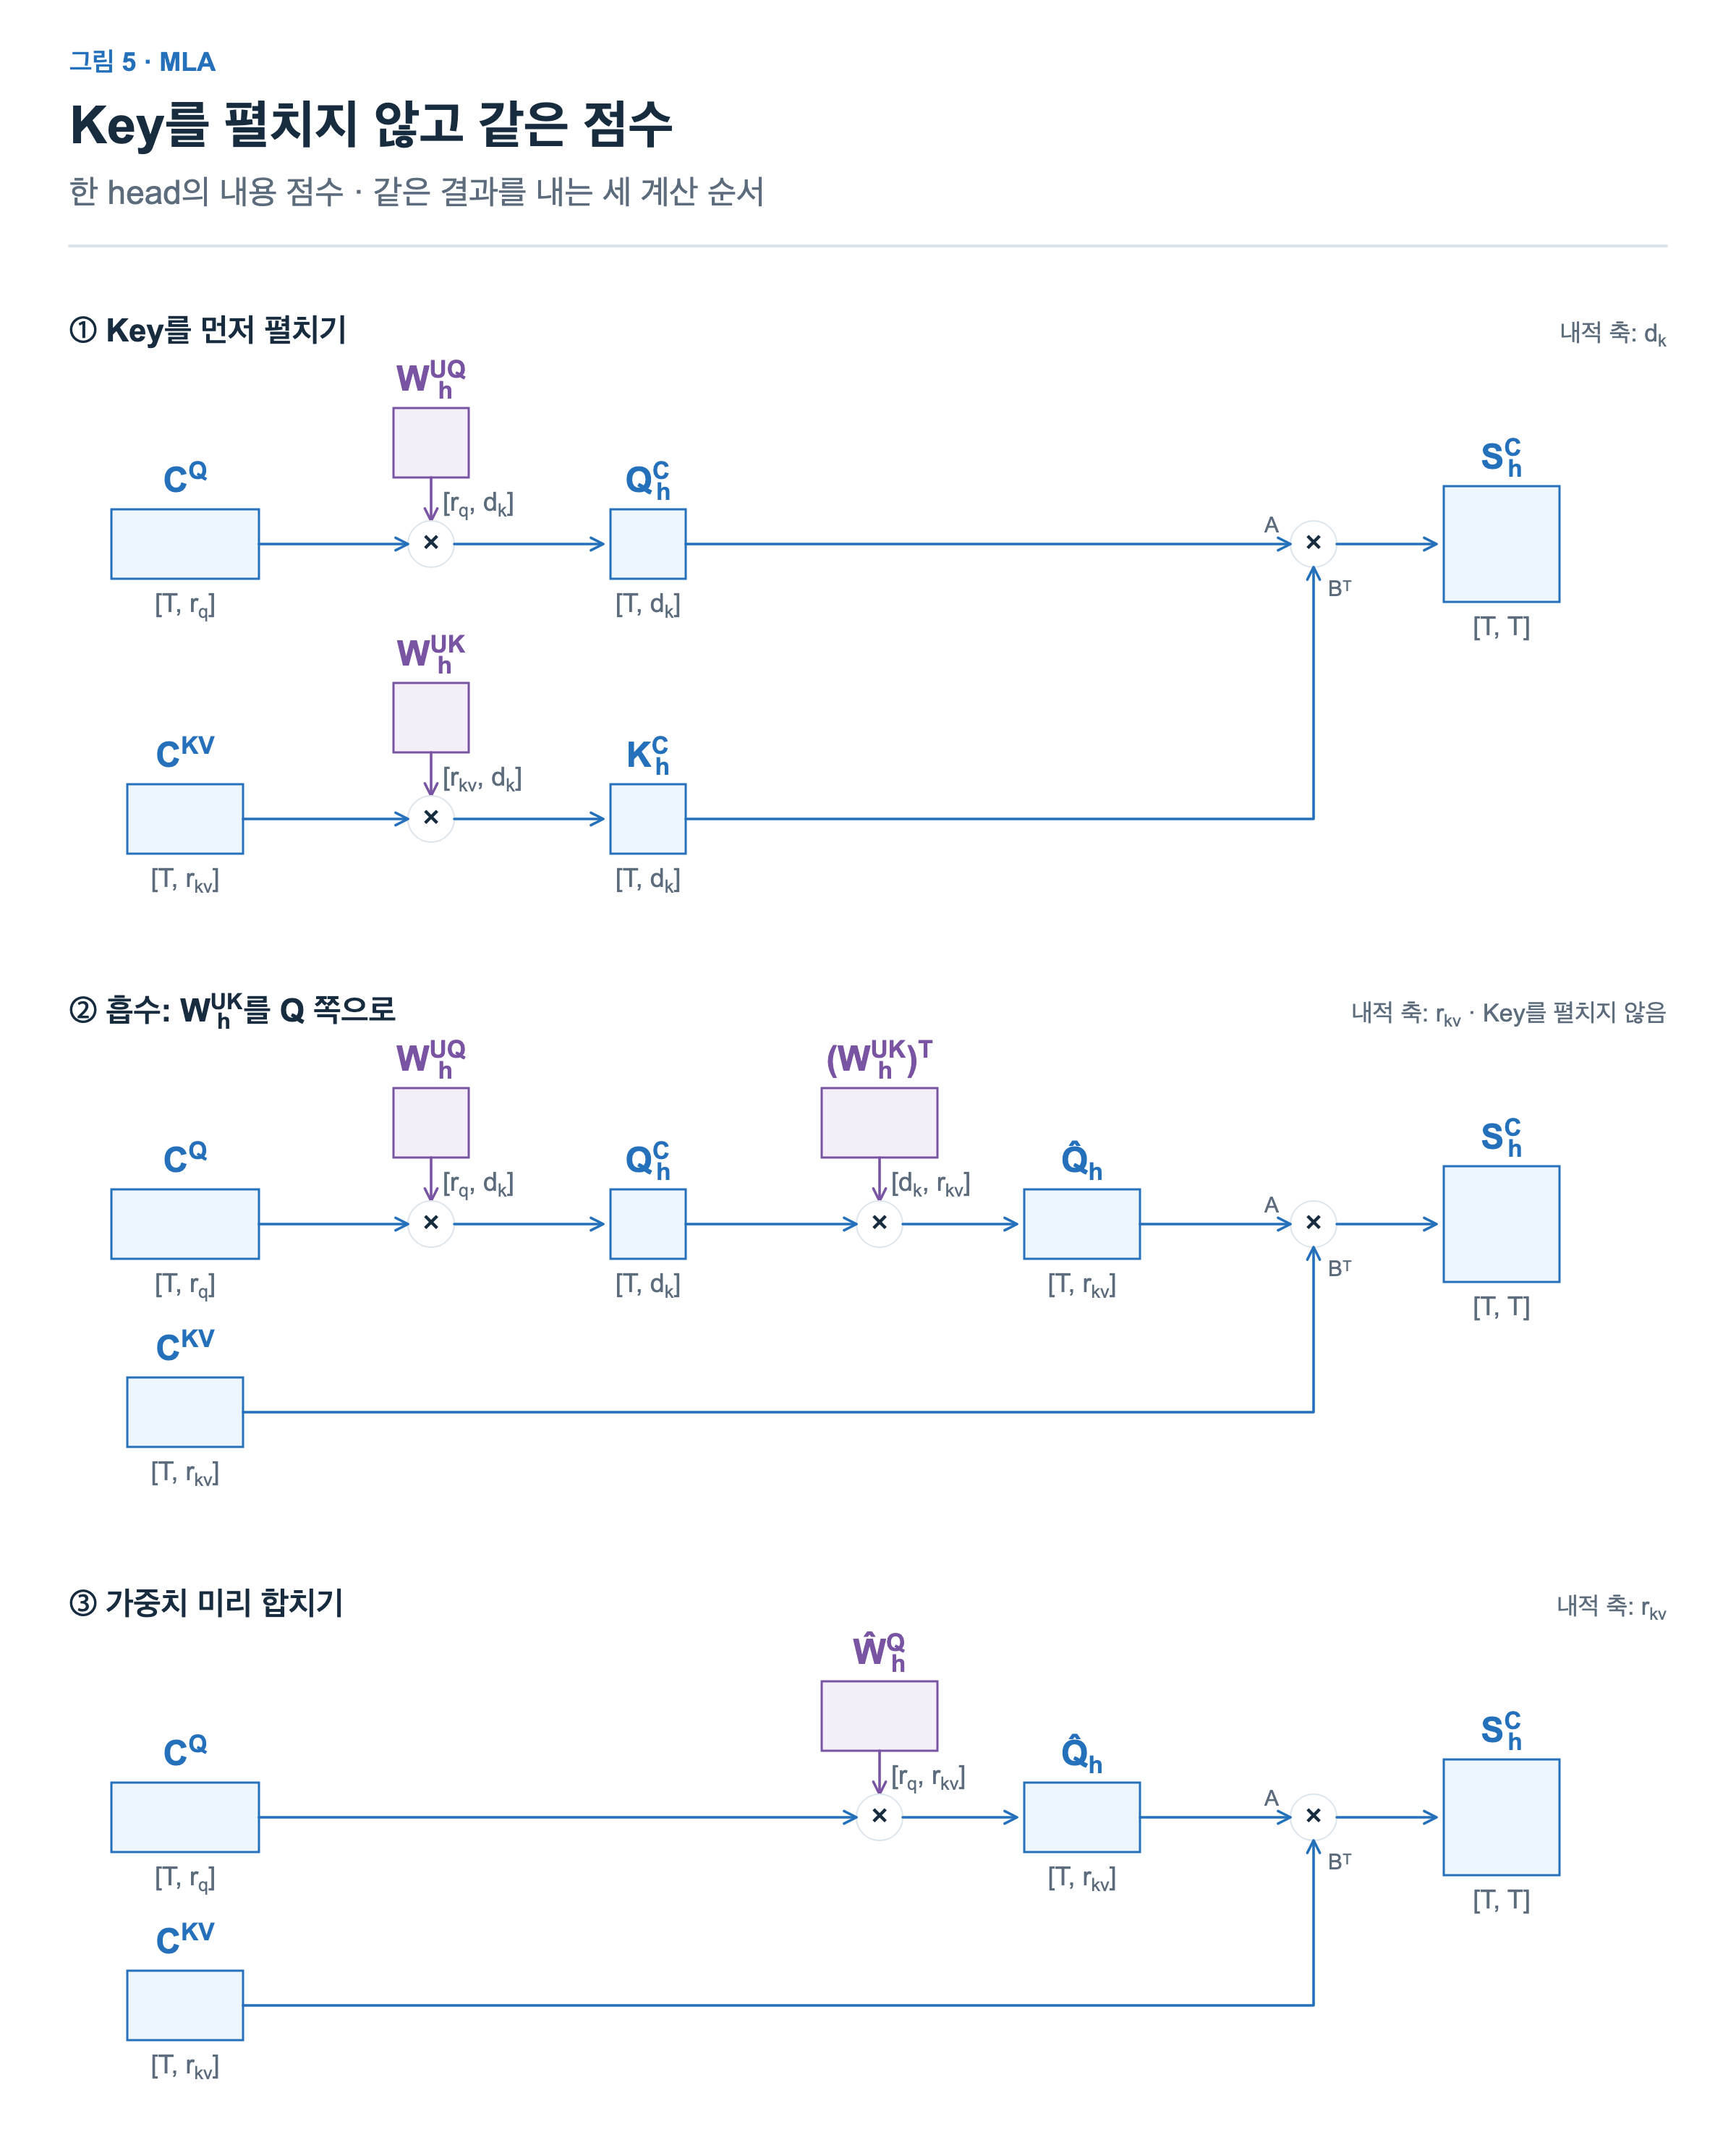
① 펼치기. 그림 4 그대로 head별 KCh를 만든 뒤 Query와 곱합니다. 내적은 dk 차원에서 일어납니다.
② 흡수. 괄호의 위치만 바꿉니다. 행렬 곱의 결합 법칙으로 QCh (CKV WUKh)T = (QCh (WUKh)T) (CKV)T입니다. Query 쪽에서 WUKh를 먼저 곱해 512차원 Q̂h를 만들고, 캐시의 CKV와 바로 곱합니다. Key를 펼치지 않습니다.
③ 가중치 미리 합치기. Query 쪽 두 가중치를 미리 하나로 합칩니다. ŴQh = WUQh (WUKh)T입니다. 수학적으로는 같지만 합친 가중치가 더 커질 수 있어, 실제 구현이 반드시 이 방식을 쓰지는 않습니다.
세 방식은 대수적으로 같은 내용 점수를 만듭니다. 유한 정밀도와 양자화에서는 반올림 오차가 조금 달라질 수 있습니다. 세 방식 모두 내용 점수의 계산 순서만 바꾸며, 위치 점수 QRh (KR)T와 √(dk + dr)로 나누는 scale(저장 형식의 scale과 다른, 점수를 나누는 값)은 그대로입니다.
흡수하면 위치마다 하는 내적은 dk(128)가 아니라 rkv(512) 차원이 되어 4배 길어집니다. 대신 캐시의 모든 위치에 WUKh를 곱해 Key를 펼치는 계산(위치마다 512×128 곱)과 펼친 Key를 읽는 일이 사라지고, Query 쪽에서 WUKh를 한 번 곱하기만 하면 됩니다. Query가 하나뿐인 decode에서는 이 차이가 커서 흡수가 유리합니다. Query가 많은 prefill에서는 한 번 펼친 Key를 모든 Query가 함께 쓰므로, 펼쳐서 계산하는 쪽이 나을 수 있습니다.
위치 성분을 따로 두는 이유. 흡수는 Q̂h 하나를 만들어 모든 위치의 CKV와 곱하는 방식이라, Query와 CKV 사이에 위치마다 달라지는 것이 없어야 합니다. CKV에서 만든 내용 Key에 RoPE를 적용하면, 그림과 같은 행벡터 표기로 위치 s의 점수가 q R(t − s) (WUKh)T csT 꼴이 됩니다(cs는 위치 s의 CKV). 위치마다 다른 R(t − s)가 사이에 끼므로 Q̂h를 하나로 만들 수 없습니다. 그래서 MLA는 위치 정보를 RoPE를 적용한 작은 KR에만 넣고, 흡수는 RoPE가 없는 내용 성분에만 씁니다(MLA 저장 구조 글).
점수를 구했으니, 이제 같은 확률로 Value를 합치는 순서도 바꿔 보겠습니다. 그림 6의 세 줄도 같은 결과를 내는 세 계산 순서입니다. 그림 6의 WOh는 그림 4의 출력 가중치 WO에서 head h에 해당하는 행 묶음이고, Yh는 head h가 최종 출력에 더하는 몫입니다. 모든 head의 Yh를 더하면 그림 4의 Y와 같습니다.
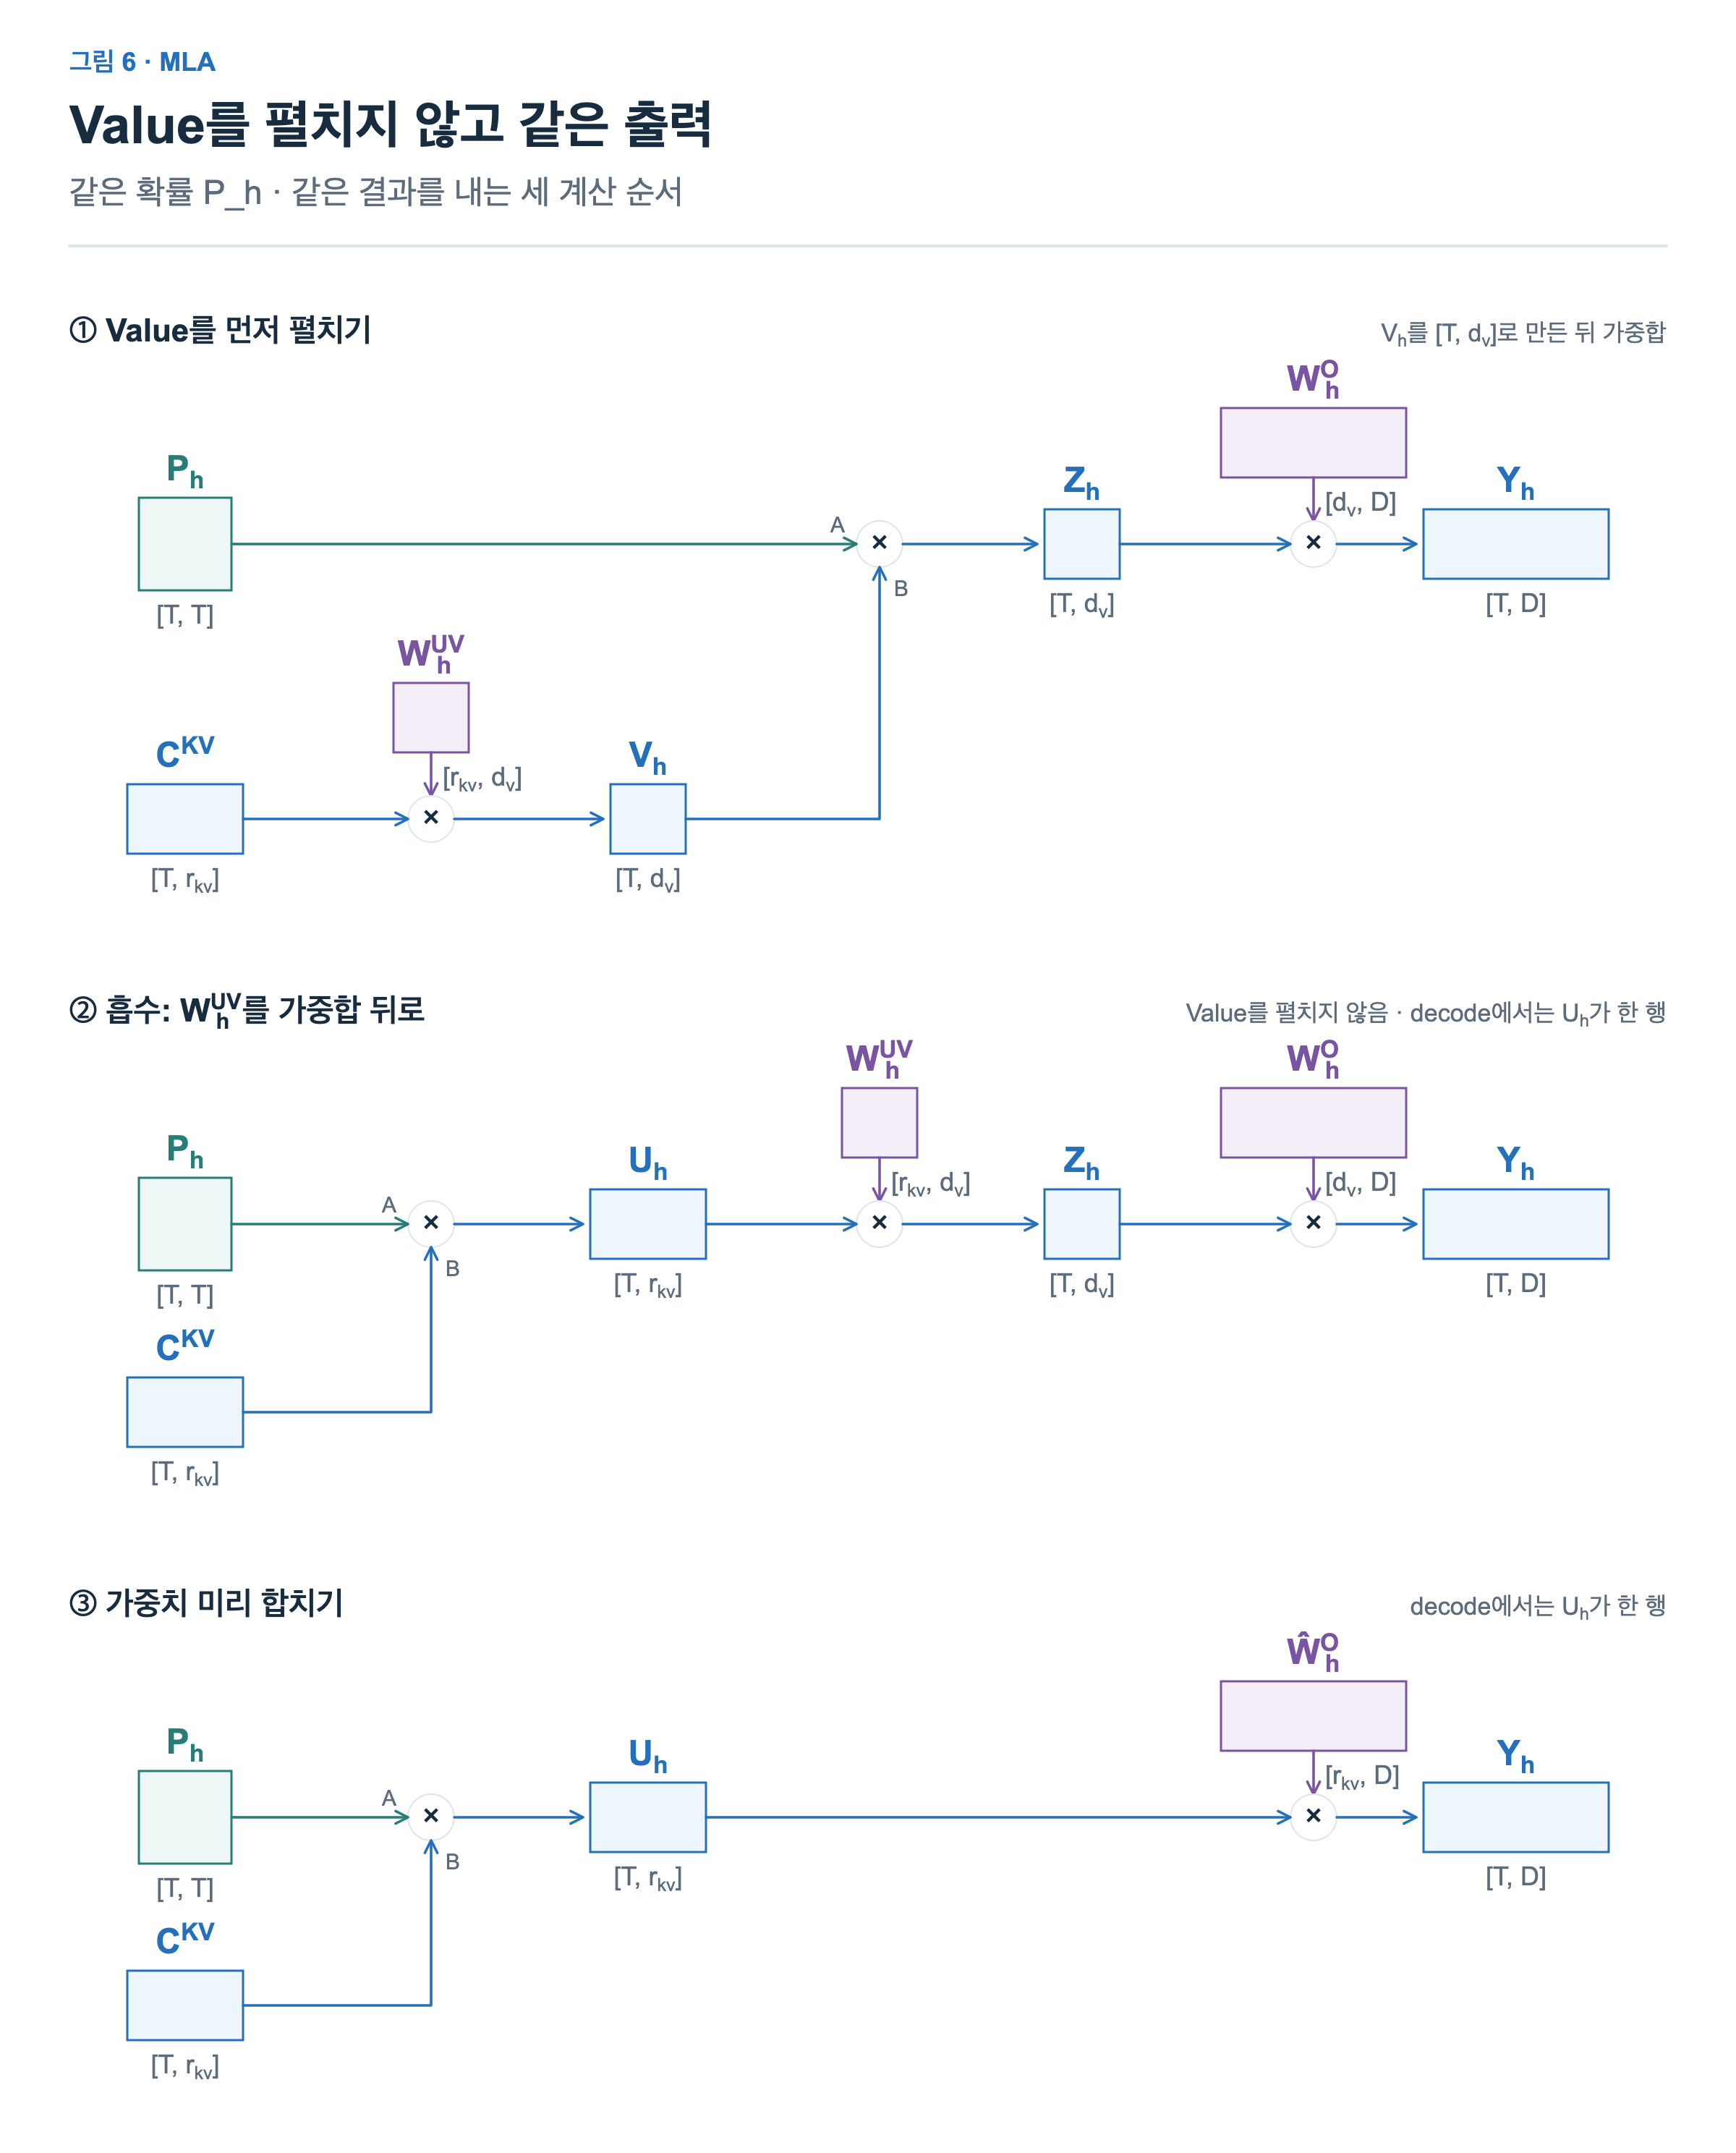
① 펼치기. Vh를 [T, dv]로 펼친 뒤 확률 Ph로 가중합합니다.
② 흡수. 확률로 CKV의 행을 먼저 가중합해 Uh를 만들고, 그 뒤에 WUVh와 출력 가중치를 곱합니다. Value를 펼치지 않습니다. 펼친다는 것은 T개 위치 전체의 Value를 만드는 일이고, ②는 가중합을 마친 결과(decode에서는 한 행)에만 WUVh를 곱합니다.
③ 가중치 미리 합치기. WUVh와 WOh를 미리 하나로 합칩니다. ŴOh = WUVh WOh입니다.
가중합과 행렬 곱의 순서를 바꿔도 결과는 같습니다. 이렇게 하면 decode 한 단계는 캐시에 있는 CKV와 KR만 읽고 계산을 마칩니다. 흡수의 유도 과정은 MLA 계산 글에서 작은 예시로 따라갈 수 있습니다.
V2의 KV 캐시 계산하기
이제 V2의 숫자가 나옵니다. 층마다 CKV 512차원과 KR 64차원을 저장합니다.
V2: 60층 × (C^KV 512 + K^R 64) × 2 B = 69,120 B (MHA의 약 1/57)V3는 같은 MLA 구조에 층이 61개이므로 61 × 576 × 2 = 70,272 B입니다. 이 글에서 V3를 따로 다루지 않는 이유입니다.
MLA로 저장량은 크게 줄었지만 읽는 범위는 그대로입니다. decode 한 단계는 여전히 모든 이전 위치의 CKV를 읽습니다. 128K 문맥에서 V2가 한 단계에 읽는 양은 60층 × 131,072 × 1,152 B ≈ 9.06 GB입니다(1,152 B = (CKV 512 + KR 64) × 2 B). MHA의 515 GB보다 훨씬 작지만, 문맥이 길어질수록 이 값도 계속 늘어납니다.
DeepSeek-V3.2
V3.2는 MLA를 그대로 두고 DSA(DeepSeek Sparse Attention)를 더해 읽을 위치를 고릅니다. 작은 lightning indexer가 점수를 매겨 위치를 최대 2,048개 고르고, 주 attention은 선택된 위치만 사용합니다. 보고서에 따르면 indexer는 주 attention이 실제로 주는 확률 분포를 따라가도록 학습합니다. 아래에서는 검색용 key를 만드는 법, 위치를 고르는 점수, 고른 위치만 쓰는 주 attention을 본 뒤 저장량과 읽는 양을 계산합니다. 그림 7은 그 효과를 보여 줍니다.
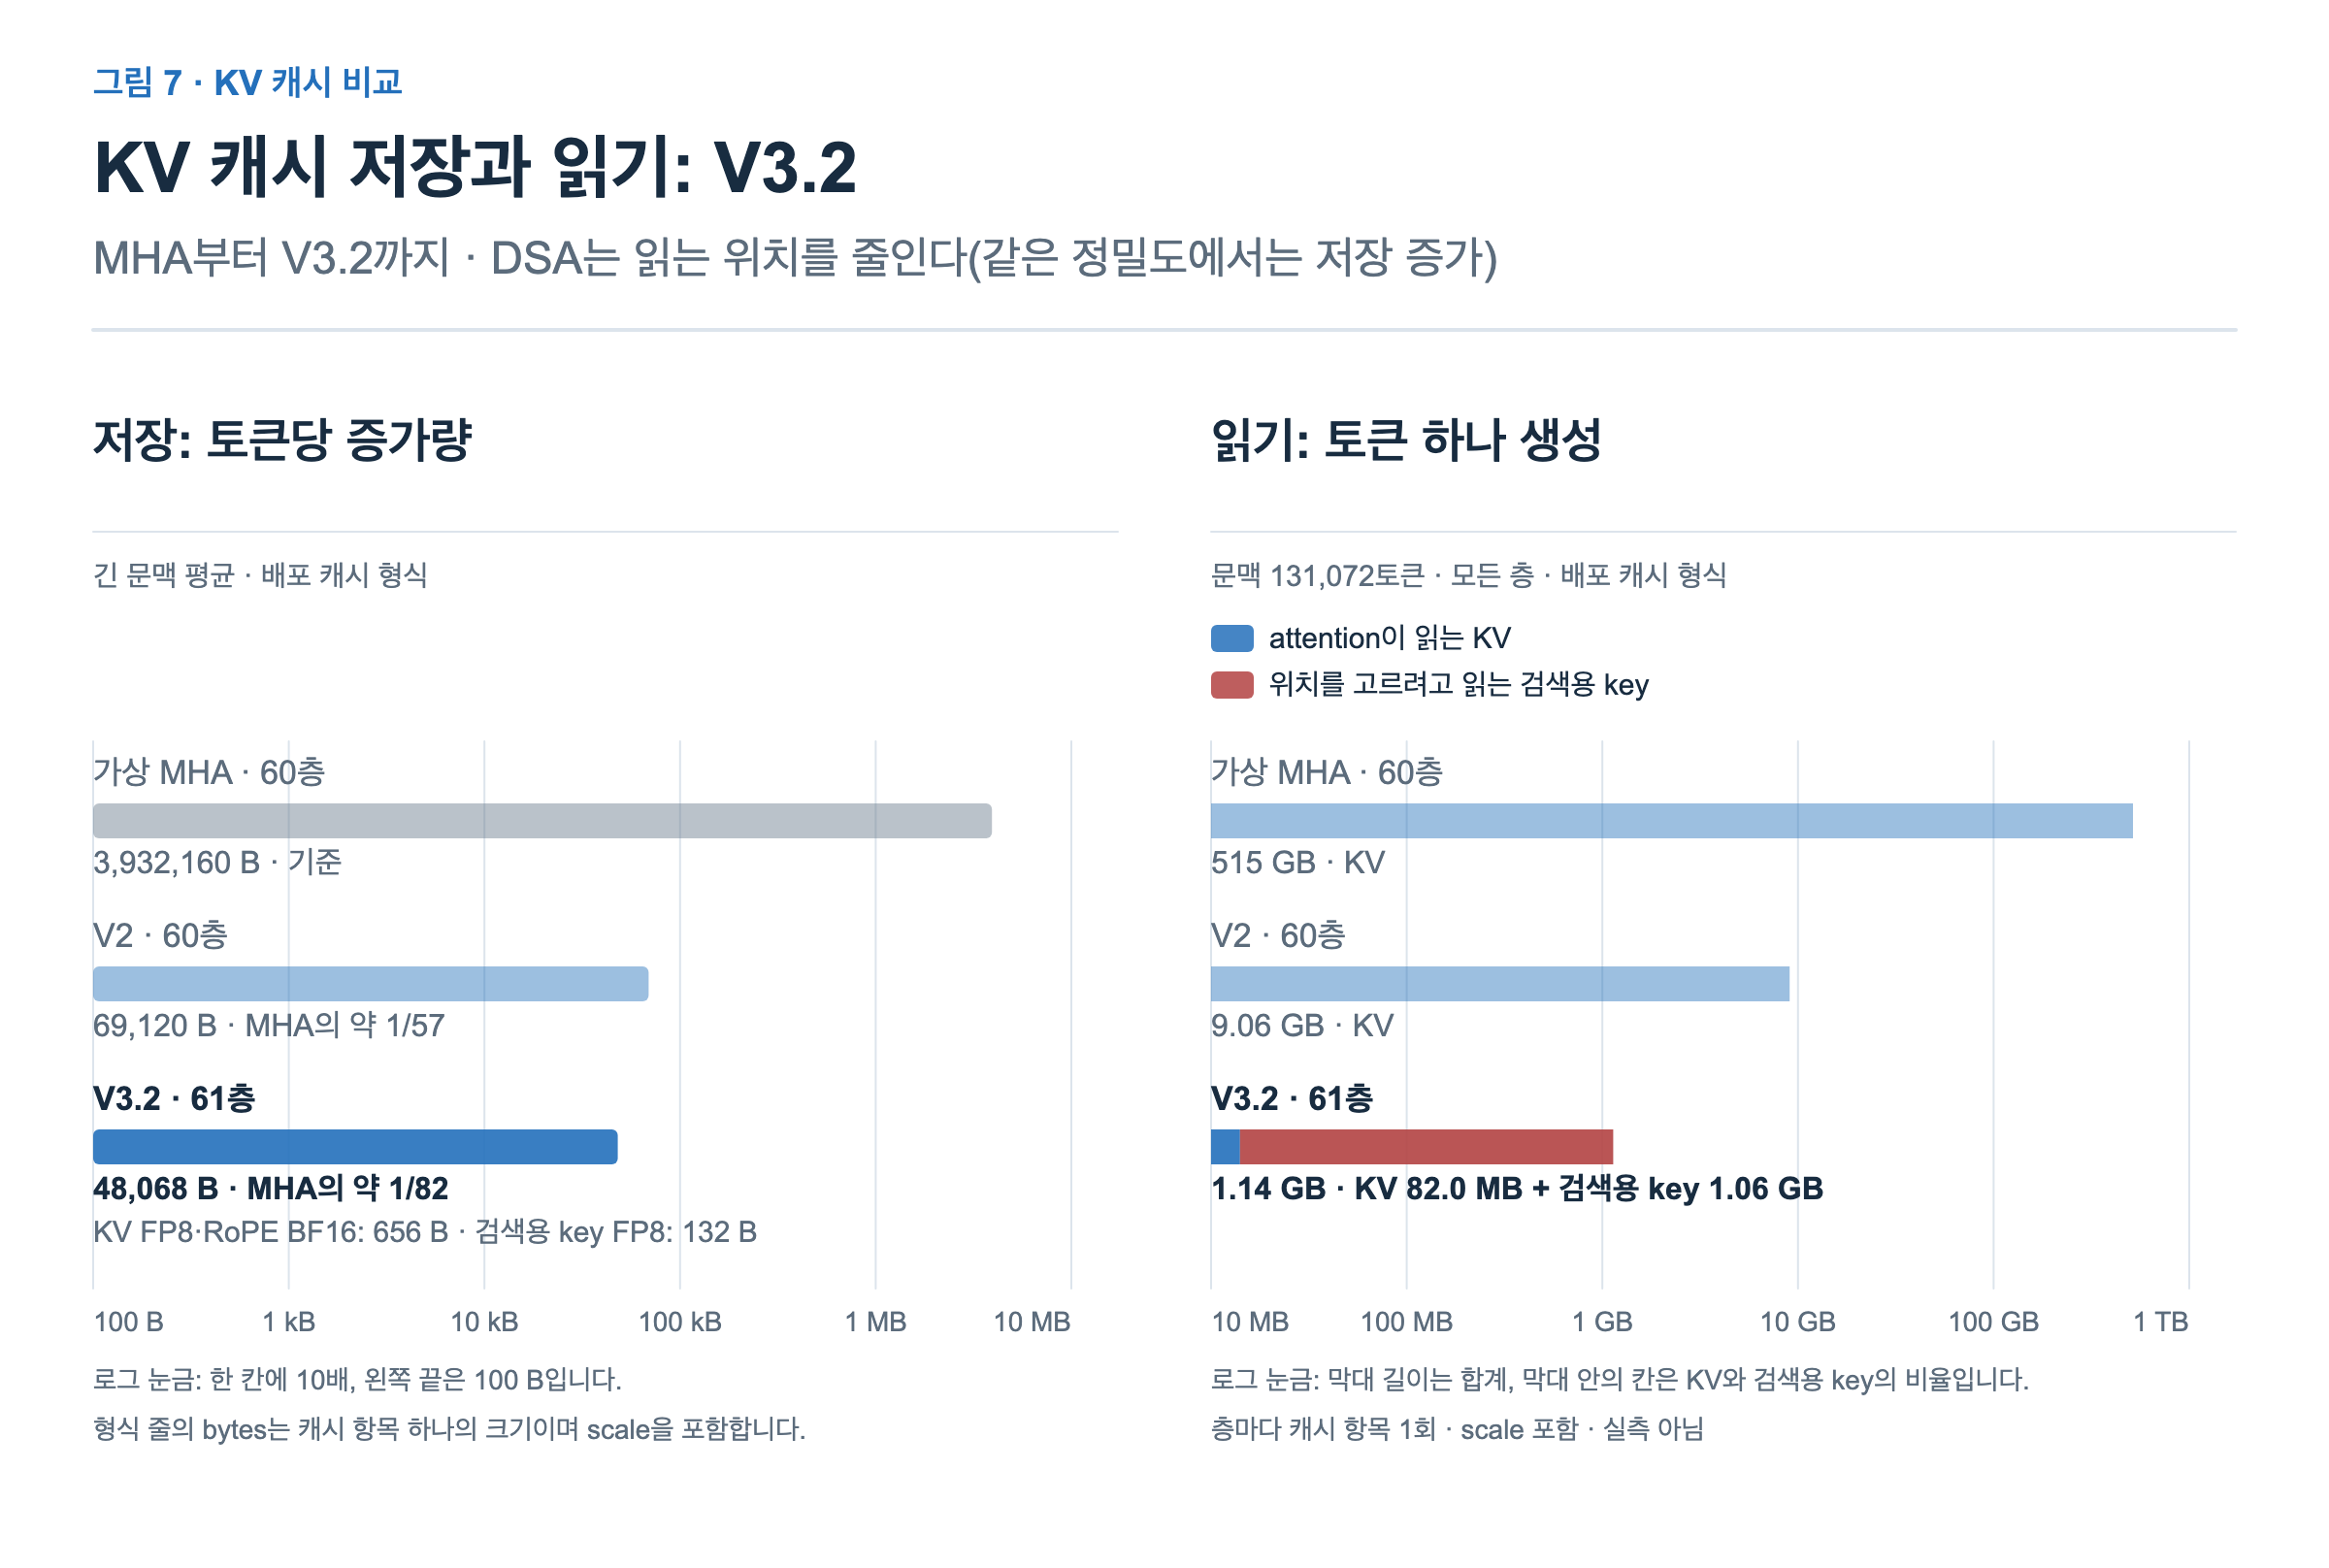
V3.2는 토큰당 48,068 B입니다. V2보다 작은 것은 FP8을 쓰는 배포 형식의 효과입니다. 모든 값을 BF16으로 저장한다고 하면 검색용 key가 더해져 오히려 커집니다.
위치 선택과 낮은 정밀도 저장을 함께 반영한 읽는 양은 약 1.14 GB, V2의 약 1/8입니다. 대부분은 검색용 key입니다.
DSA: indexer가 만드는 세 가지
indexer는 attention의 점수 계산과 비슷한 방식으로 읽을 위치를 고르는 작은 모듈입니다. Value를 가중합해 출력을 만들지는 않습니다. indexer 쪽 값에는 위첨자 I(indexer)를 붙입니다. qIj는 indexer head j의 query, kI는 검색용 key, wI는 head 가중치이고, 이를 만드는 가중치가 WIQ, WIK, WIw입니다. 아래첨자 j는 주 attention의 head h와 다른, indexer head의 번호입니다. 그림 8처럼 세 가지를 만듭니다.
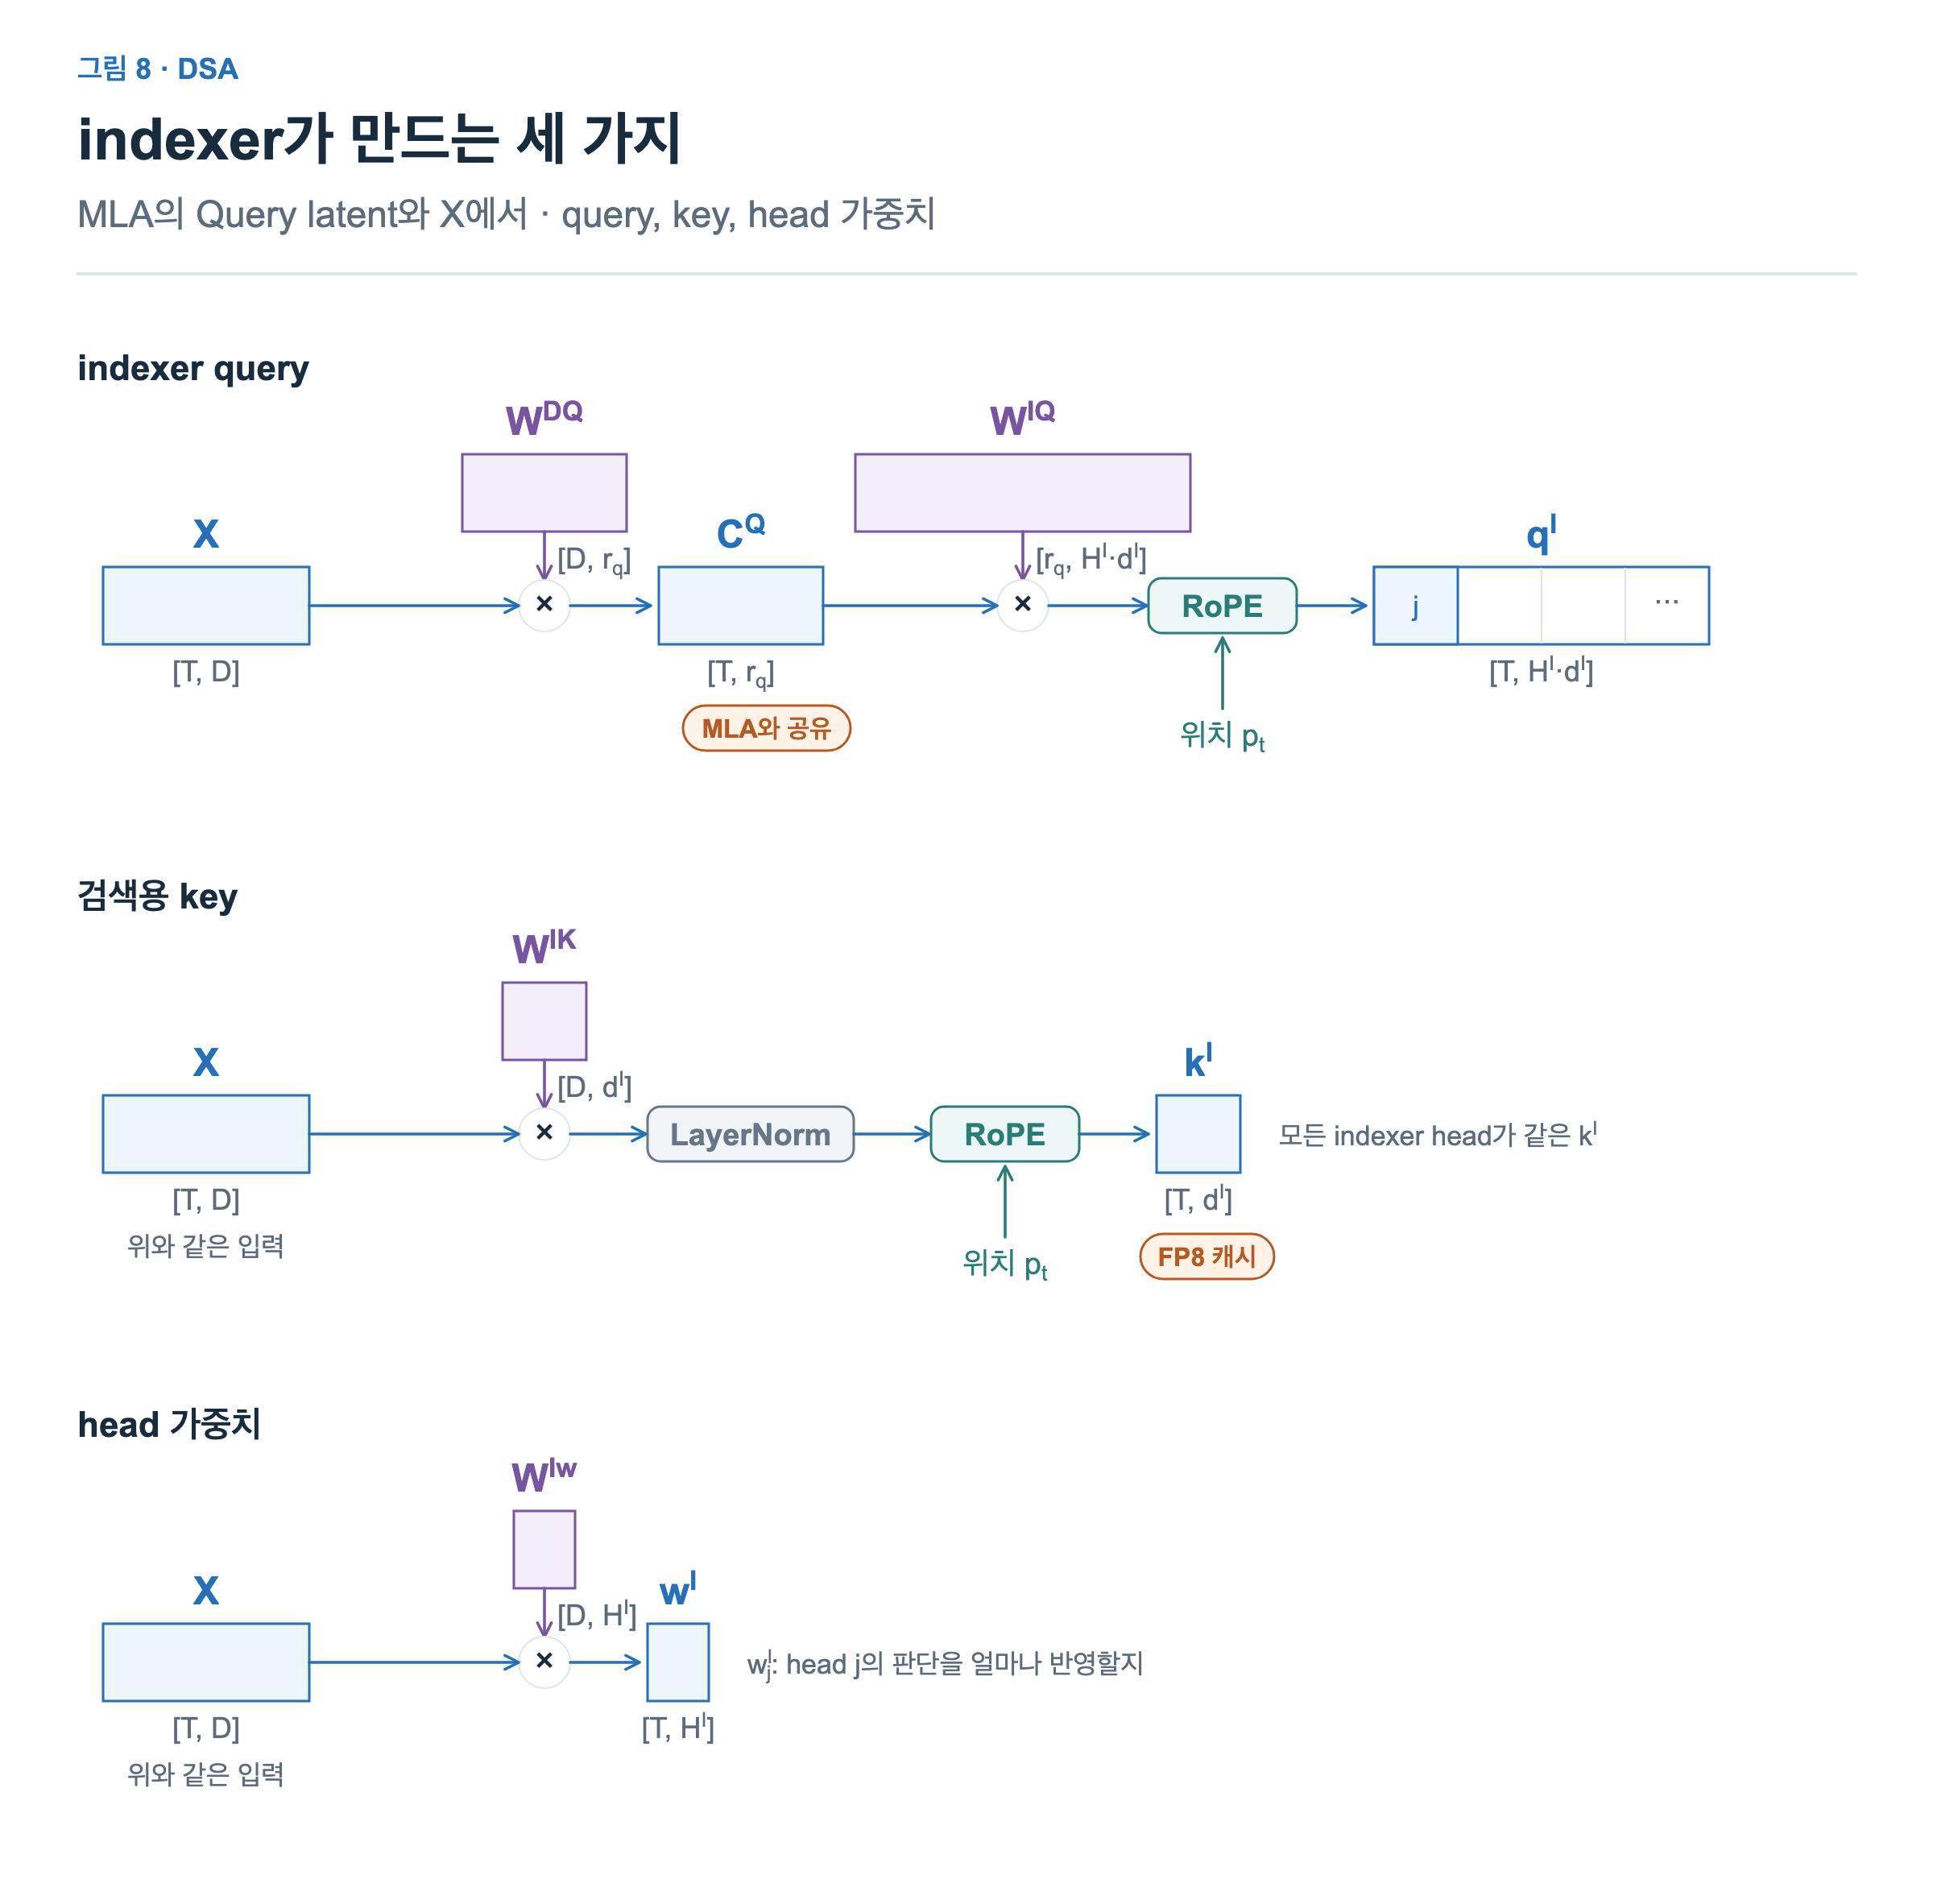
indexer query. qIj는 MLA의 Query latent CQ에서 head j마다 만듭니다(indexer head 수 HI = 64, head당 차원 dI = 128). 주 attention과 같은 latent를 다시 씁니다.
검색용 key(indexer key). kI는 입력 X에서 하나만 만들고 모든 indexer head가 공유합니다. 이 값은 캐시에 쌓입니다. 이후 토큰이 이전 위치를 평가하려면 그 위치의 kI가 필요하기 때문입니다. 그림의 RoPE는 128차원 중 64차원에만 적용하고, LayerNorm은 벡터의 평균과 분산을 맞추는 정규화입니다. 같은 정밀도로 비교하면, 이 추가 key 때문에 저장량이 늘어납니다.
head 가중치. wI는 X에서 만들며, 토큰마다 64개 head 각각의 판단을 얼마나 반영할지 정합니다.
위치를 고르는 점수
indexer가 만든 query, key, head 가중치를 합쳐, 각 query가 볼 위치의 순위를 정합니다. 그림 9는 모든 query의 점수를 [T, T] 행렬 하나로 그렸습니다. 행이 query, 열이 후보 위치입니다. ⊙는 원소별 곱이고, head 가중치 wIj는 query 행마다 값이 하나라서 그 행의 모든 후보 점수에 같은 값이 곱해집니다.
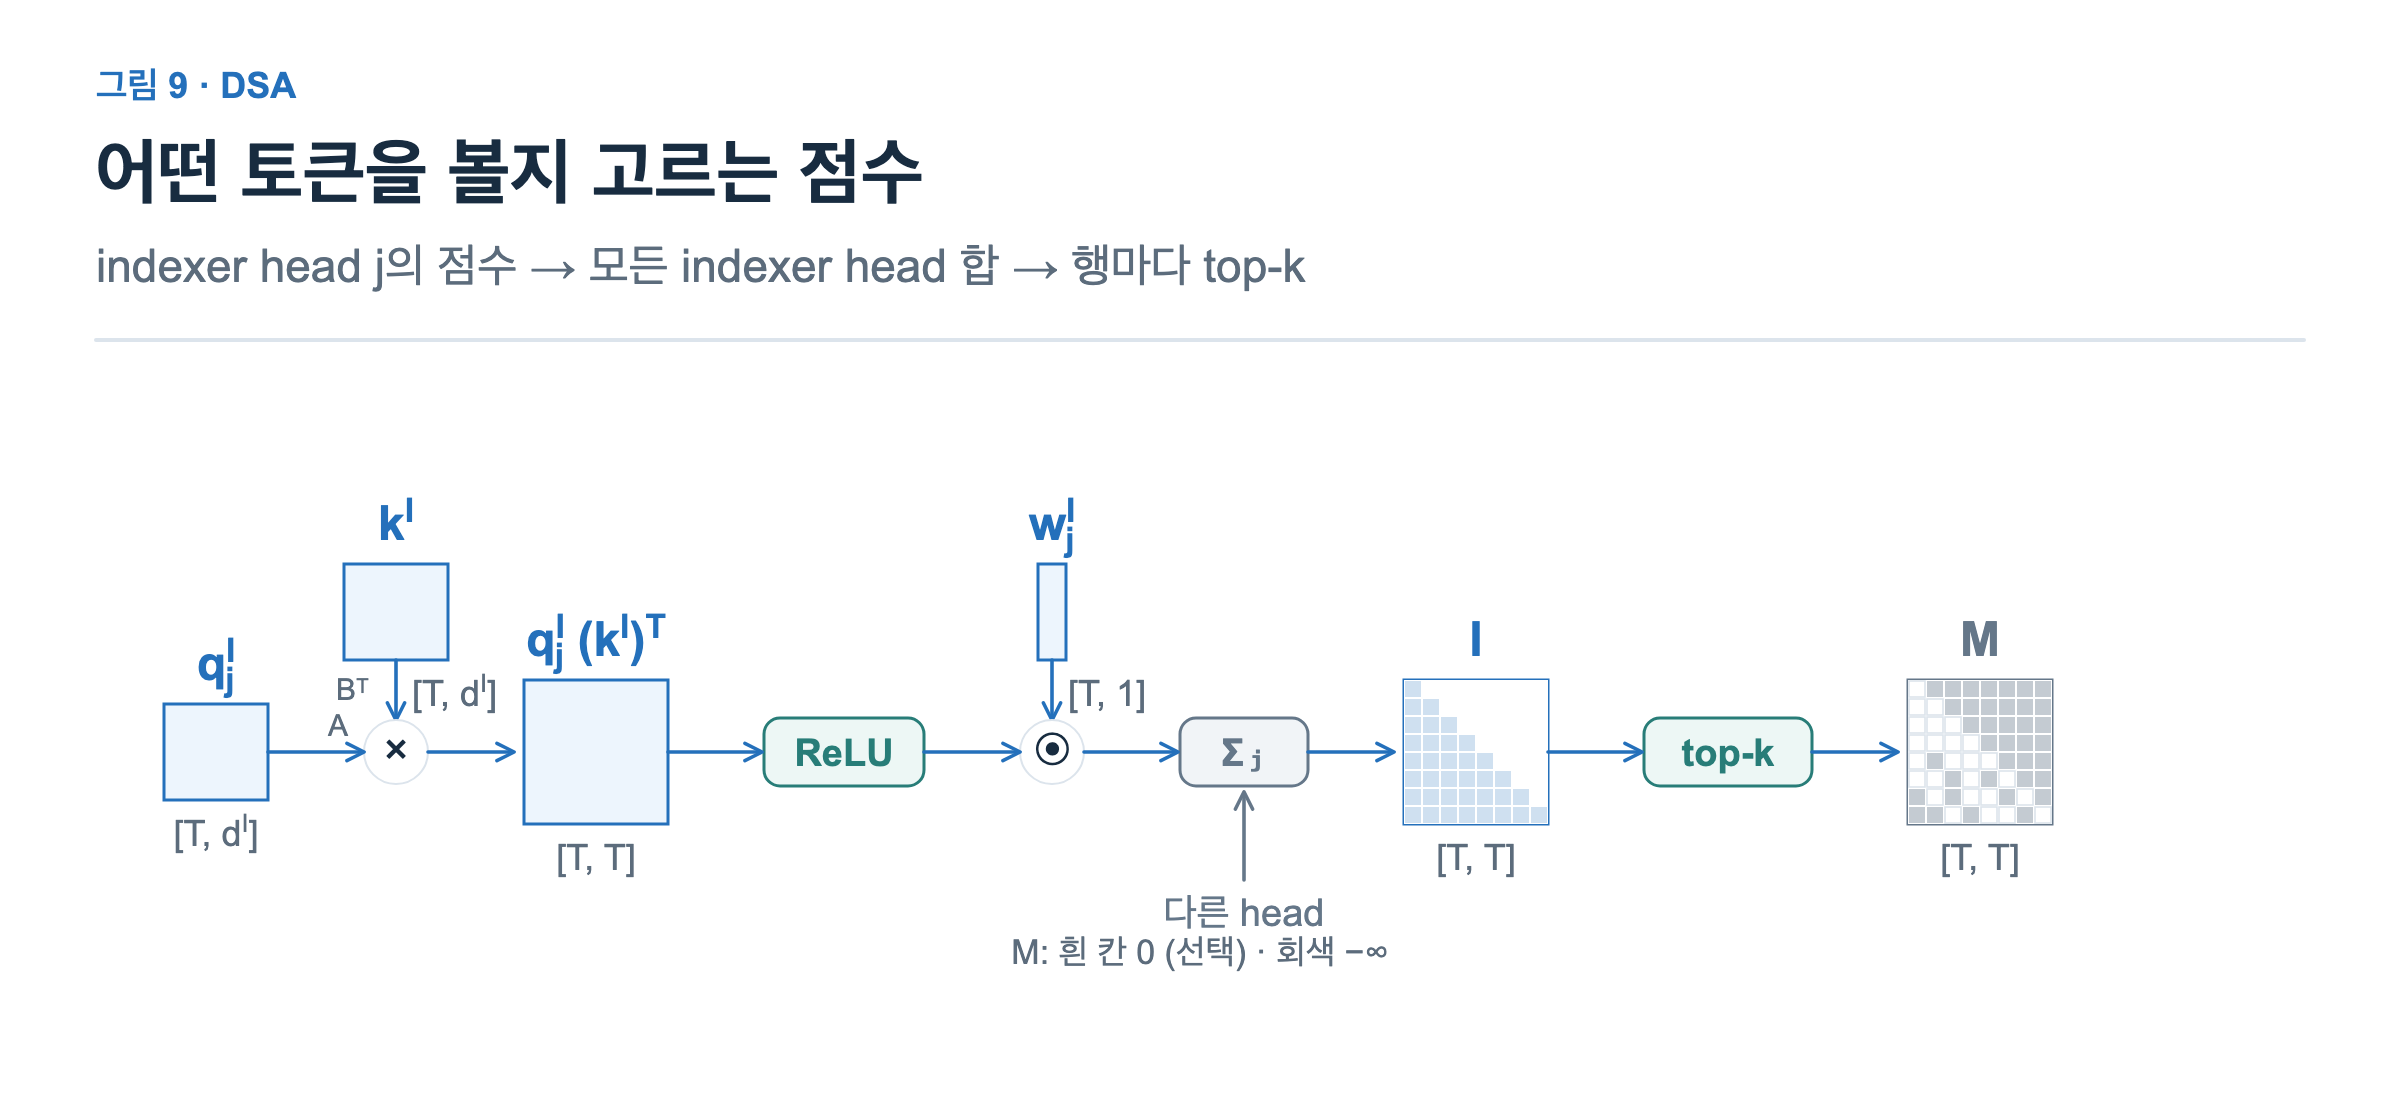
head마다 query와 공유 key를 내적하고 ReLU(음수를 0으로 만듦)를 거친 뒤 head 가중치를 곱해 모두 더합니다.
점수 I에서 행마다, 그 query가 볼 수 있는 위치(자기 자신 포함) 가운데 점수가 높은 위치를 최대 2,048개 고르고 선택 마스크 M을 만듭니다. 고른 위치는 0, 나머지는 −∞입니다.
보고서의 식으로는 다음과 같습니다.
I(t, s) = Σⱼ w^I(t, j) × ReLU( q^I(t, j) · k^I(s) )indexer에는 softmax가 없고, wI도 확률이 아닙니다. 점수는 순위를 정하는 데만 쓰입니다.
고른 위치만 보는 MLA
선택 목록이 정해지면 주 attention은 그 위치에만 확률을 남깁니다. 그림 10은 그림 5의 ②, 흡수된 MLA에 선택 마스크 M을 더한 모습입니다.
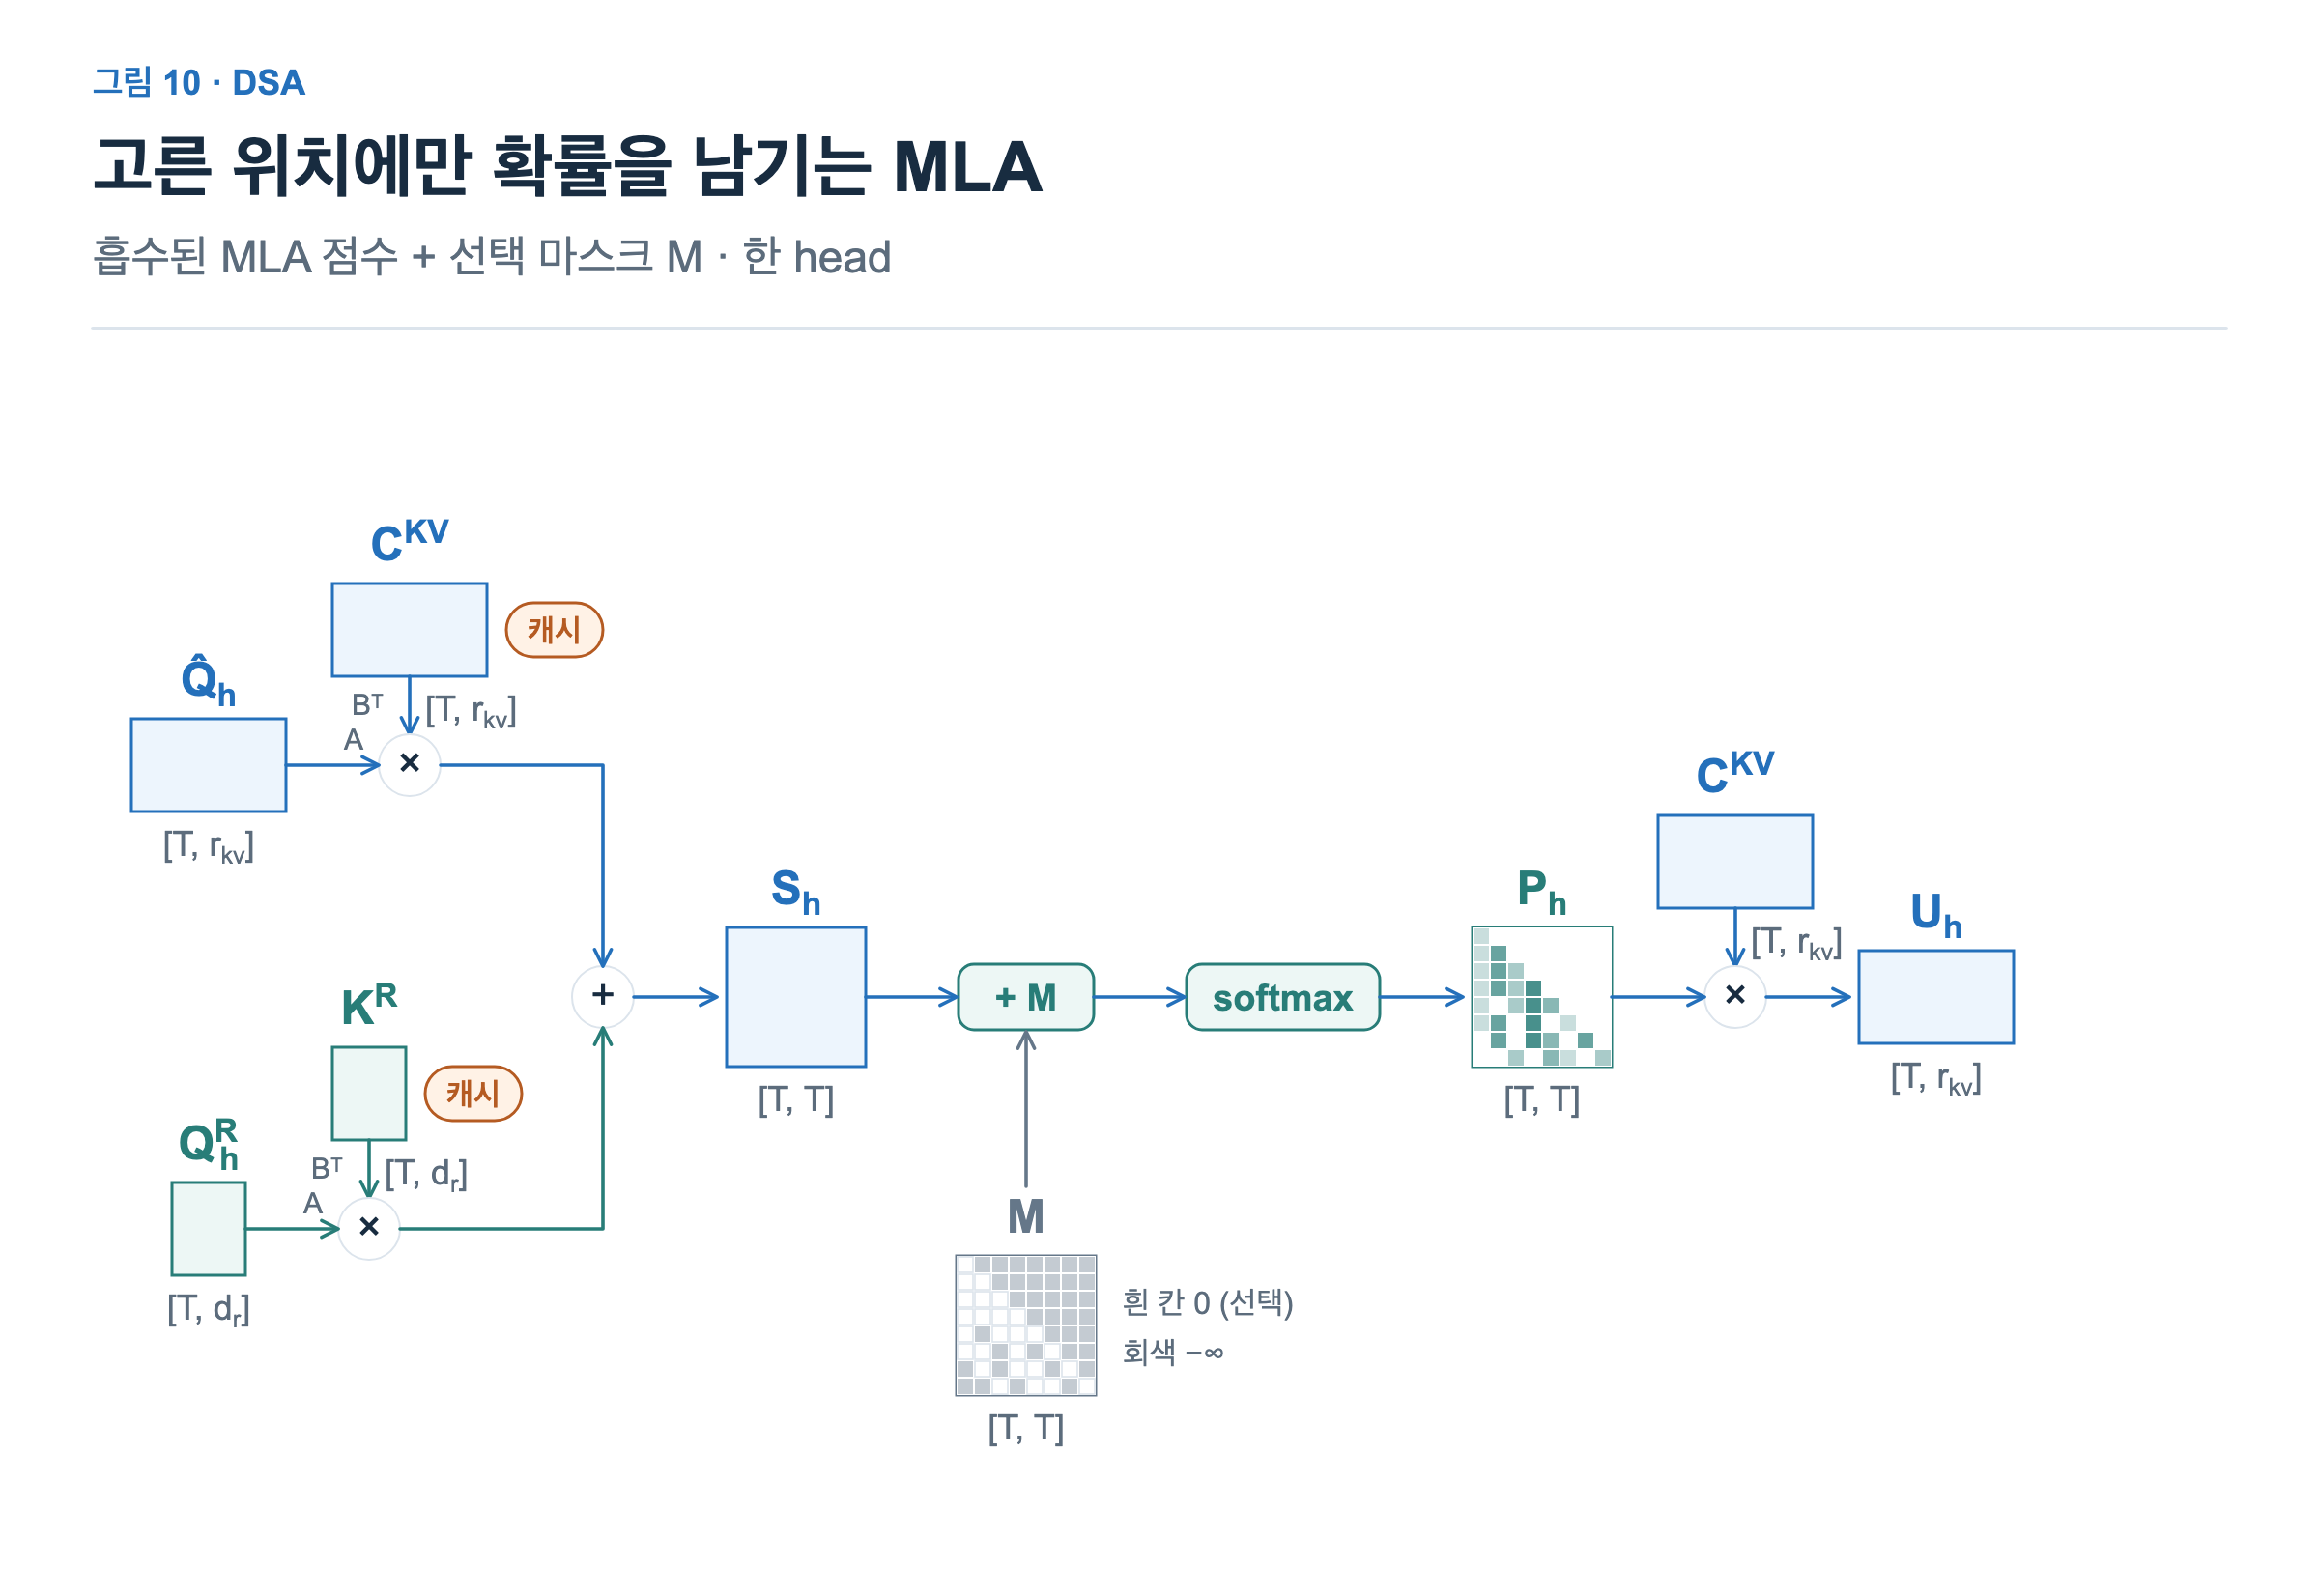
점수를 계산하는 부분은 흡수된 MLA 그대로입니다. 그림에서는 scale을 생략했습니다. M은 볼 수 있는 위치 가운데 고른 위치만 0이므로 causal mask 역할도 함께 합니다.
점수에 M을 더하면 선택되지 않은 위치는 softmax 뒤 확률이 0이 됩니다.
그림은 같은 결과를 마스크로 표현했을 뿐입니다. 실제 커널이 고른 위치만 골라 읽는지는 구현마다 다릅니다. 이 글의 읽는 양은 고른 2,048개 위치의 KV만 읽는 구현을 가정해 셉니다.
V3.2의 KV 캐시 계산하기
먼저 구조만 보겠습니다. 저장하는 값은 MLA의 576차원에 검색용 key 128차원이 더해진 704차원입니다. 모두 BF16으로 저장한다고 하면 61층 × 704 × 2 B = 85,888 B로, V3(70,272 B)보다 22% 늘어납니다. DSA는 저장량을 줄이는 기술이 아닙니다. 선택되지 않은 위치도 캐시에서 지우지 않습니다. 다음 토큰은 다른 위치를 고를 수 있기 때문입니다.
실제 배포에서는 정밀도를 낮춰 저장합니다. 토큰 하나, 층 하나에 저장하는 값은 두 묶음입니다.
주 KV 656 B. CKV 512차원은 원소마다 1 B인 FP8로 저장해 512 B입니다. FP8은 표현할 수 있는 범위가 좁기 때문에 값을 묶음마다 다시 맞추는 scale을 함께 저장합니다. 128차원마다 FP32 scale을 하나씩 두므로 4개 × 4 B = 16 B입니다. 위치용 Key KR 64차원은 양자화하지 않고 BF16 그대로 64 × 2 B = 128 B로 둡니다. 합치면 512 + 16 + 128 = 656 B입니다.
검색용 key 132 B. 검색용 key kI 128차원을 FP8로 128 B, 128차원 전체에 FP32 scale 하나를 4 B로 둡니다. 128 + 4 = 132 B입니다. 검색용 key는 RoPE를 적용하는 일부 차원까지 모두 FP8로 양자화하며, 주 KV처럼 BF16으로 남겨 두는 부분이 없습니다.
주 KV:       C^KV 512 × 1 B + scale 4 × 4 B + K^R 64 × 2 B = 512 + 16 + 128 = 656 B
검색용 key:  k^I 128 × 1 B + scale 1 × 4 B               = 128 + 4        = 132 B
V3.2: 61층 × (656 + 132) B = 48,068 B  (MHA의 약 1/82)
읽는 양으로 보면
DSA가 줄이는 것은 decode 한 단계가 읽는 양입니다. 그림 7의 오른쪽 그래프는 128K 문맥에서 토큰 하나를 생성할 때(decode 한 단계) 모든 층이 읽는 양입니다. 막대 하나를 attention이 읽는 KV(파랑)와 위치를 고르려고 읽는 검색용 key(빨강)의 비율대로 나눠 칠했습니다. 각 층이 참조하는 캐시 항목을 한 번씩 셌습니다. 여러 층이 공유하는 캐시는 읽는 층마다 다시 세고, 같은 층의 여러 head나 Key와 Value 두 역할 때문에 중복해서 세지는 않습니다. SWA와 scale, 캐시 항목 안의 패딩은 포함하고, 같은 값을 여러 번 읽는 것과 새 캐시 쓰기는 제외했습니다.
이 값은 선택된 KV와 검색 후보 key만 읽는다고 가정하고, 각 캐시 항목을 저장량과 같은 배포 캐시 형식의 bytes로 계산한 읽는 양입니다. 실제 메모리 트래픽은 아닙니다. 모두 BF16으로 저장했을 때의 값은 이 절 끝의 접기에 정리했습니다.
V3.2에서 attention이 읽는 KV는 61층 × 2,048 위치 × 656 B ≈ 82 MB입니다. 위치 선택은 층마다 읽는 위치를 131,072개에서 2,048개로, 64분의 1로 줄입니다. 여기에 주 KV를 낮은 정밀도로 저장하는 효과가 더해집니다. 대신 indexer가 모든 위치의 key를 훑습니다. 61층 × 131,072 × 132 B ≈ 1.06 GB입니다. 합계는 약 1.14 GB이고, 검색용 key가 약 93%를 차지합니다. 다만 이것만으로 위치 고르기가 실행 시간의 대부분이라고 결론 내릴 수는 없습니다. 계산량과 실제 메모리 접근 방식이 다르기 때문입니다.
그래도 주 attention으로 모든 위치를 읽는 것보다 indexer가 저렴한 이유는 key 하나가 작고(128차원, FP8), 모든 head가 같은 key를 읽으며, softmax 없이 ReLU와 가중합만 하기 때문입니다. 그러나 문맥 전체를 훑는다는 사실은 변하지 않습니다. 이 비용과 저장량을 함께 줄이는 것이 V4의 과제입니다. indexer의 원리는 sparse indexer 글에서 다뤘습니다.
더 알아보기: 모두 BF16으로 저장한다면
정밀도 차이를 빼려면 같은 항목 수에 BF16 크기를 적용하면 됩니다(scale과 패딩 제외). 층 수와 구조는 모델마다 그대로이므로, 구조 하나만 바꾼 비교는 아닙니다. V4·V4.1 식의 각 항은 뒤의 해당 절에서 설명합니다.
| 모델 | attention이 읽는 KV | 검색용 key | 합계 |
|---|---|---|---|
| 가상 MHA | 515 GB | — | 515 GB |
| V2 | 9.06 GB | — | 9.06 GB |
| V3.2 | 144 MB | 2.05 GB | 2.19 GB |
| V4-Flash | 37.6 MB | 176 MB | 214 MB |
| V4.1-Flash | 25.2 MB | 101 MB | 126 MB |
V3.2:       KV 61 × 2,048 × 1,152 B          검색용 key 61 × N × 256 B
V4-Flash:   KV (21 × 512 + 20 × N/128 + 43 × 128) × 1,024 B    검색용 key 21 × N/4 × 256 B
V4.1-Flash: KV (38 × 512 + 40 × 128) × 1,024 B    검색용 key (3 × N/2 + N + 4 × 16,384) × 256 B
N = 131,072
모두 BF16으로 저장하면 V3.2의 합계는 V2의 약 1/4입니다. 본문의 약 1/8과 다른 것은 정밀도 효과가 빠졌기 때문입니다.
DeepSeek-V4-Flash
V4는 토큰 방향으로 압축합니다. 여러 토큰의 KV를 합쳐 벡터 하나로 저장하며, 이 압축된 벡터 하나를 entry라고 부릅니다. 압축률이 다른 두 방식을 층마다 섞어 씁니다. CSA(Compressed Sparse Attention)는 겹치는 구간을 압축해 4토큰마다 entry 하나를 만들고, indexer로 골라 읽습니다. HCA(Heavily Compressed Attention)는 겹치지 않는 128토큰을 entry 하나로 압축하고, 완성된 entry를 모두 읽습니다. 최근 위치는 압축하지 않고 따로 보관합니다. 아래에서는 구조가 단순한 HCA부터 보고 CSA로 넘어간 뒤 숫자를 계산합니다. 그림 11은 그 효과를 보여 줍니다.
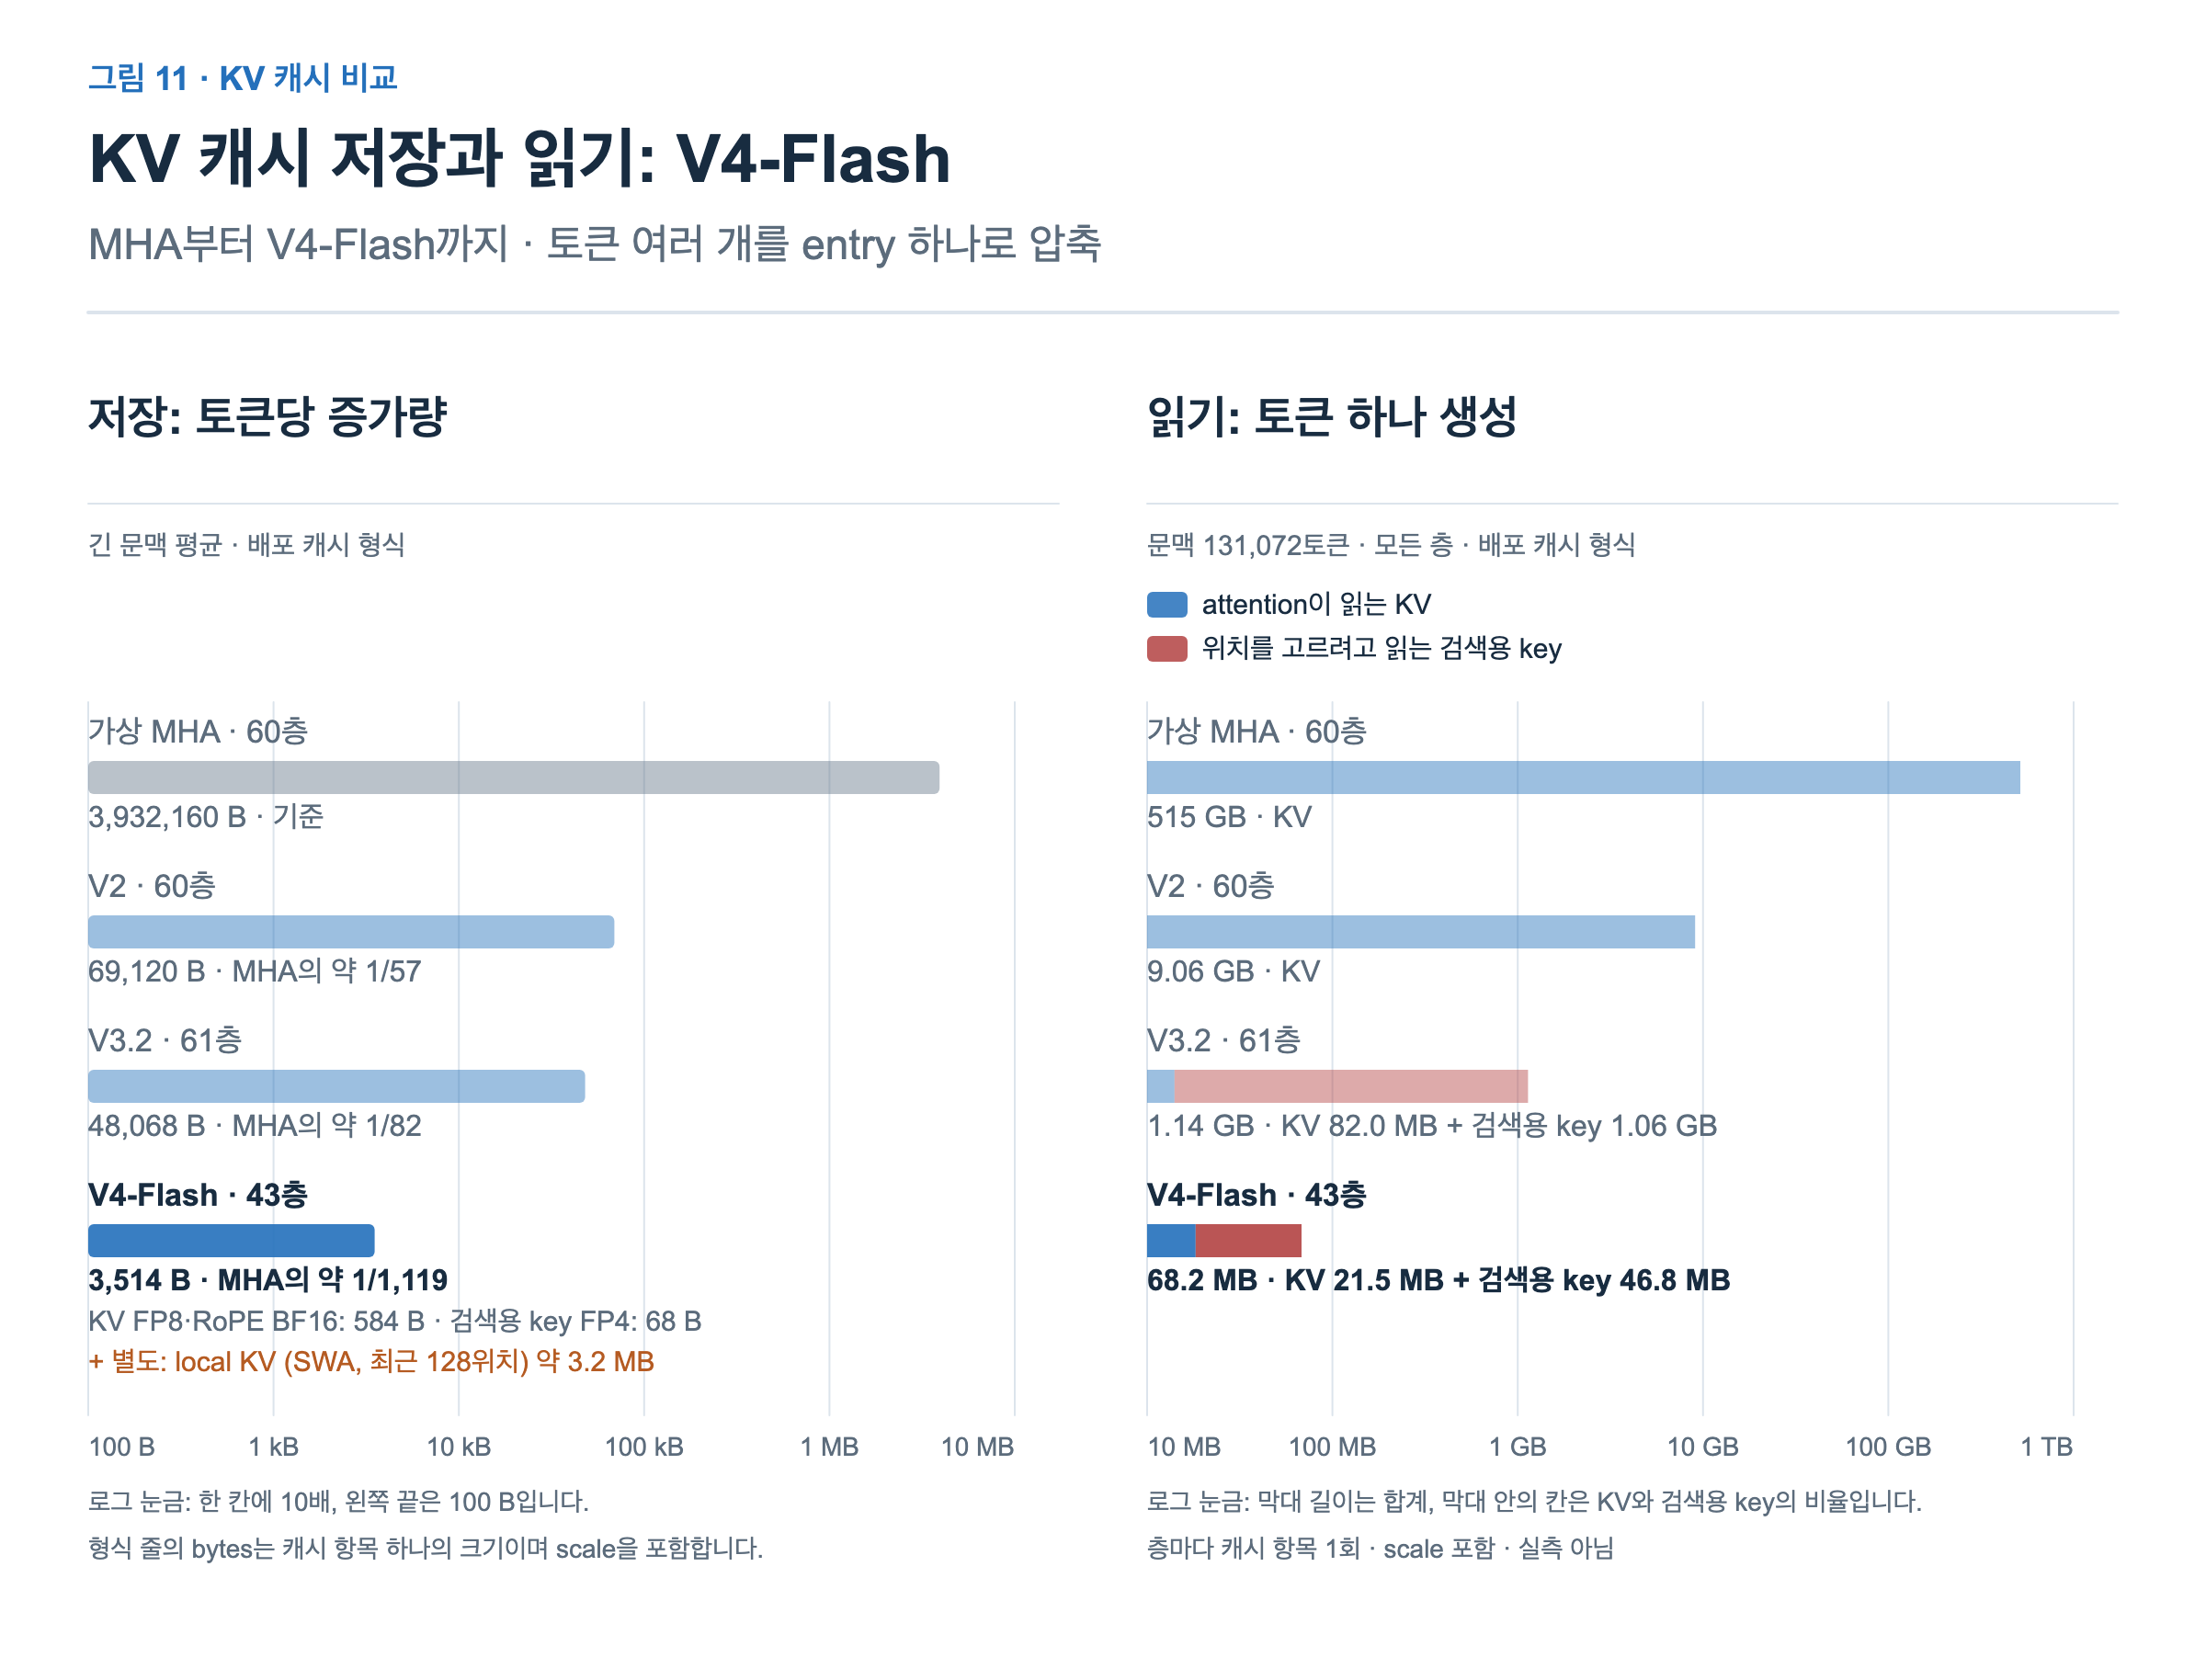
V4-Flash는 토큰당 약 3,514 B입니다. 최근 위치를 따로 보관하는 local KV는 주황색으로 따로 적었습니다.
같은 조건의 읽는 양은 약 68 MB입니다.
이 글은 V4-Flash를 기준으로 합니다. 43층 가운데 처음 2층은 최근 위치만 보는 SWA 층이고, CSA가 21층, HCA가 20층입니다. 또 V4는 MLA 위에 압축기를 더한 것이 아니라는 점을 먼저 짚어 두겠습니다. V4는 MLA처럼 head별 Key와 Value를 latent에서 펼치는 구조를 쓰지 않습니다. 하나의 512차원 entry를 모든 head가 Key와 Value로 함께 씁니다. MLA의 WUK·WUV처럼 Key와 Value를 펼치는 가중치가 없고, 각 head의 Query가 entry와 직접 곱해집니다(그림 15).
HCA: 128개 토큰을 하나로
이 글에서는 최근 128위치의 압축하지 않은 KV를 **local KV(SWA)**라고 부르겠습니다. SWA(sliding window attention)는 최근 위치만 읽는 attention입니다. 압축해서 긴 문맥에 걸쳐 쌓이는 쪽은 둘로 나뉩니다. attention이 실제로 읽는 압축 KV가 main KV이고, 뒤에서 볼 CSA에는 읽을 위치를 고르는 검색용 key가 더해집니다. main KV와 검색용 key를 합쳐 global KV라고 부릅니다. 여기서 local은 최근 위치라는 범위를 뜻합니다. V4 보고서는 최근 위치를 읽는 갈래를 sliding window attention으로 설명하고, local KV·main KV·global KV라는 이름은 V4.1 보고서가 씁니다.
V4부터는 표기가 조금 달라집니다. cQ는 MLA의 CQ처럼 작은 Query latent입니다. WKVwin은 최근 window(win)의 local KV를 만드는 가중치, WKVcomp는 압축(compression)할 후보를 만드는 가중치입니다. 여기서 C는 MLA의 내용 성분이 아니라 압축할 후보 값이고, Z는 MLA의 head 출력이 아니라 후보마다 매기는 softmax 전 점수입니다. 압축이 끝난 entry는 CComp(compressed)로 씁니다.
그림 12의 c는 entry 하나의 폭(512)이고, 이 폭의 entry가 Key와 Value를 겸합니다. nh는 head 수입니다. Ewin은 최근 window의 local KV entry입니다. RMSNorm은 벡터의 크기를 일정하게 맞추는 정규화입니다. 그림 12는 RoPE 단계를 생략했고, RoPE까지 마친 모양은 그림 13의 ’비교’에 있습니다.
HCA 층은 입력 X에서 세 갈래를 만듭니다.
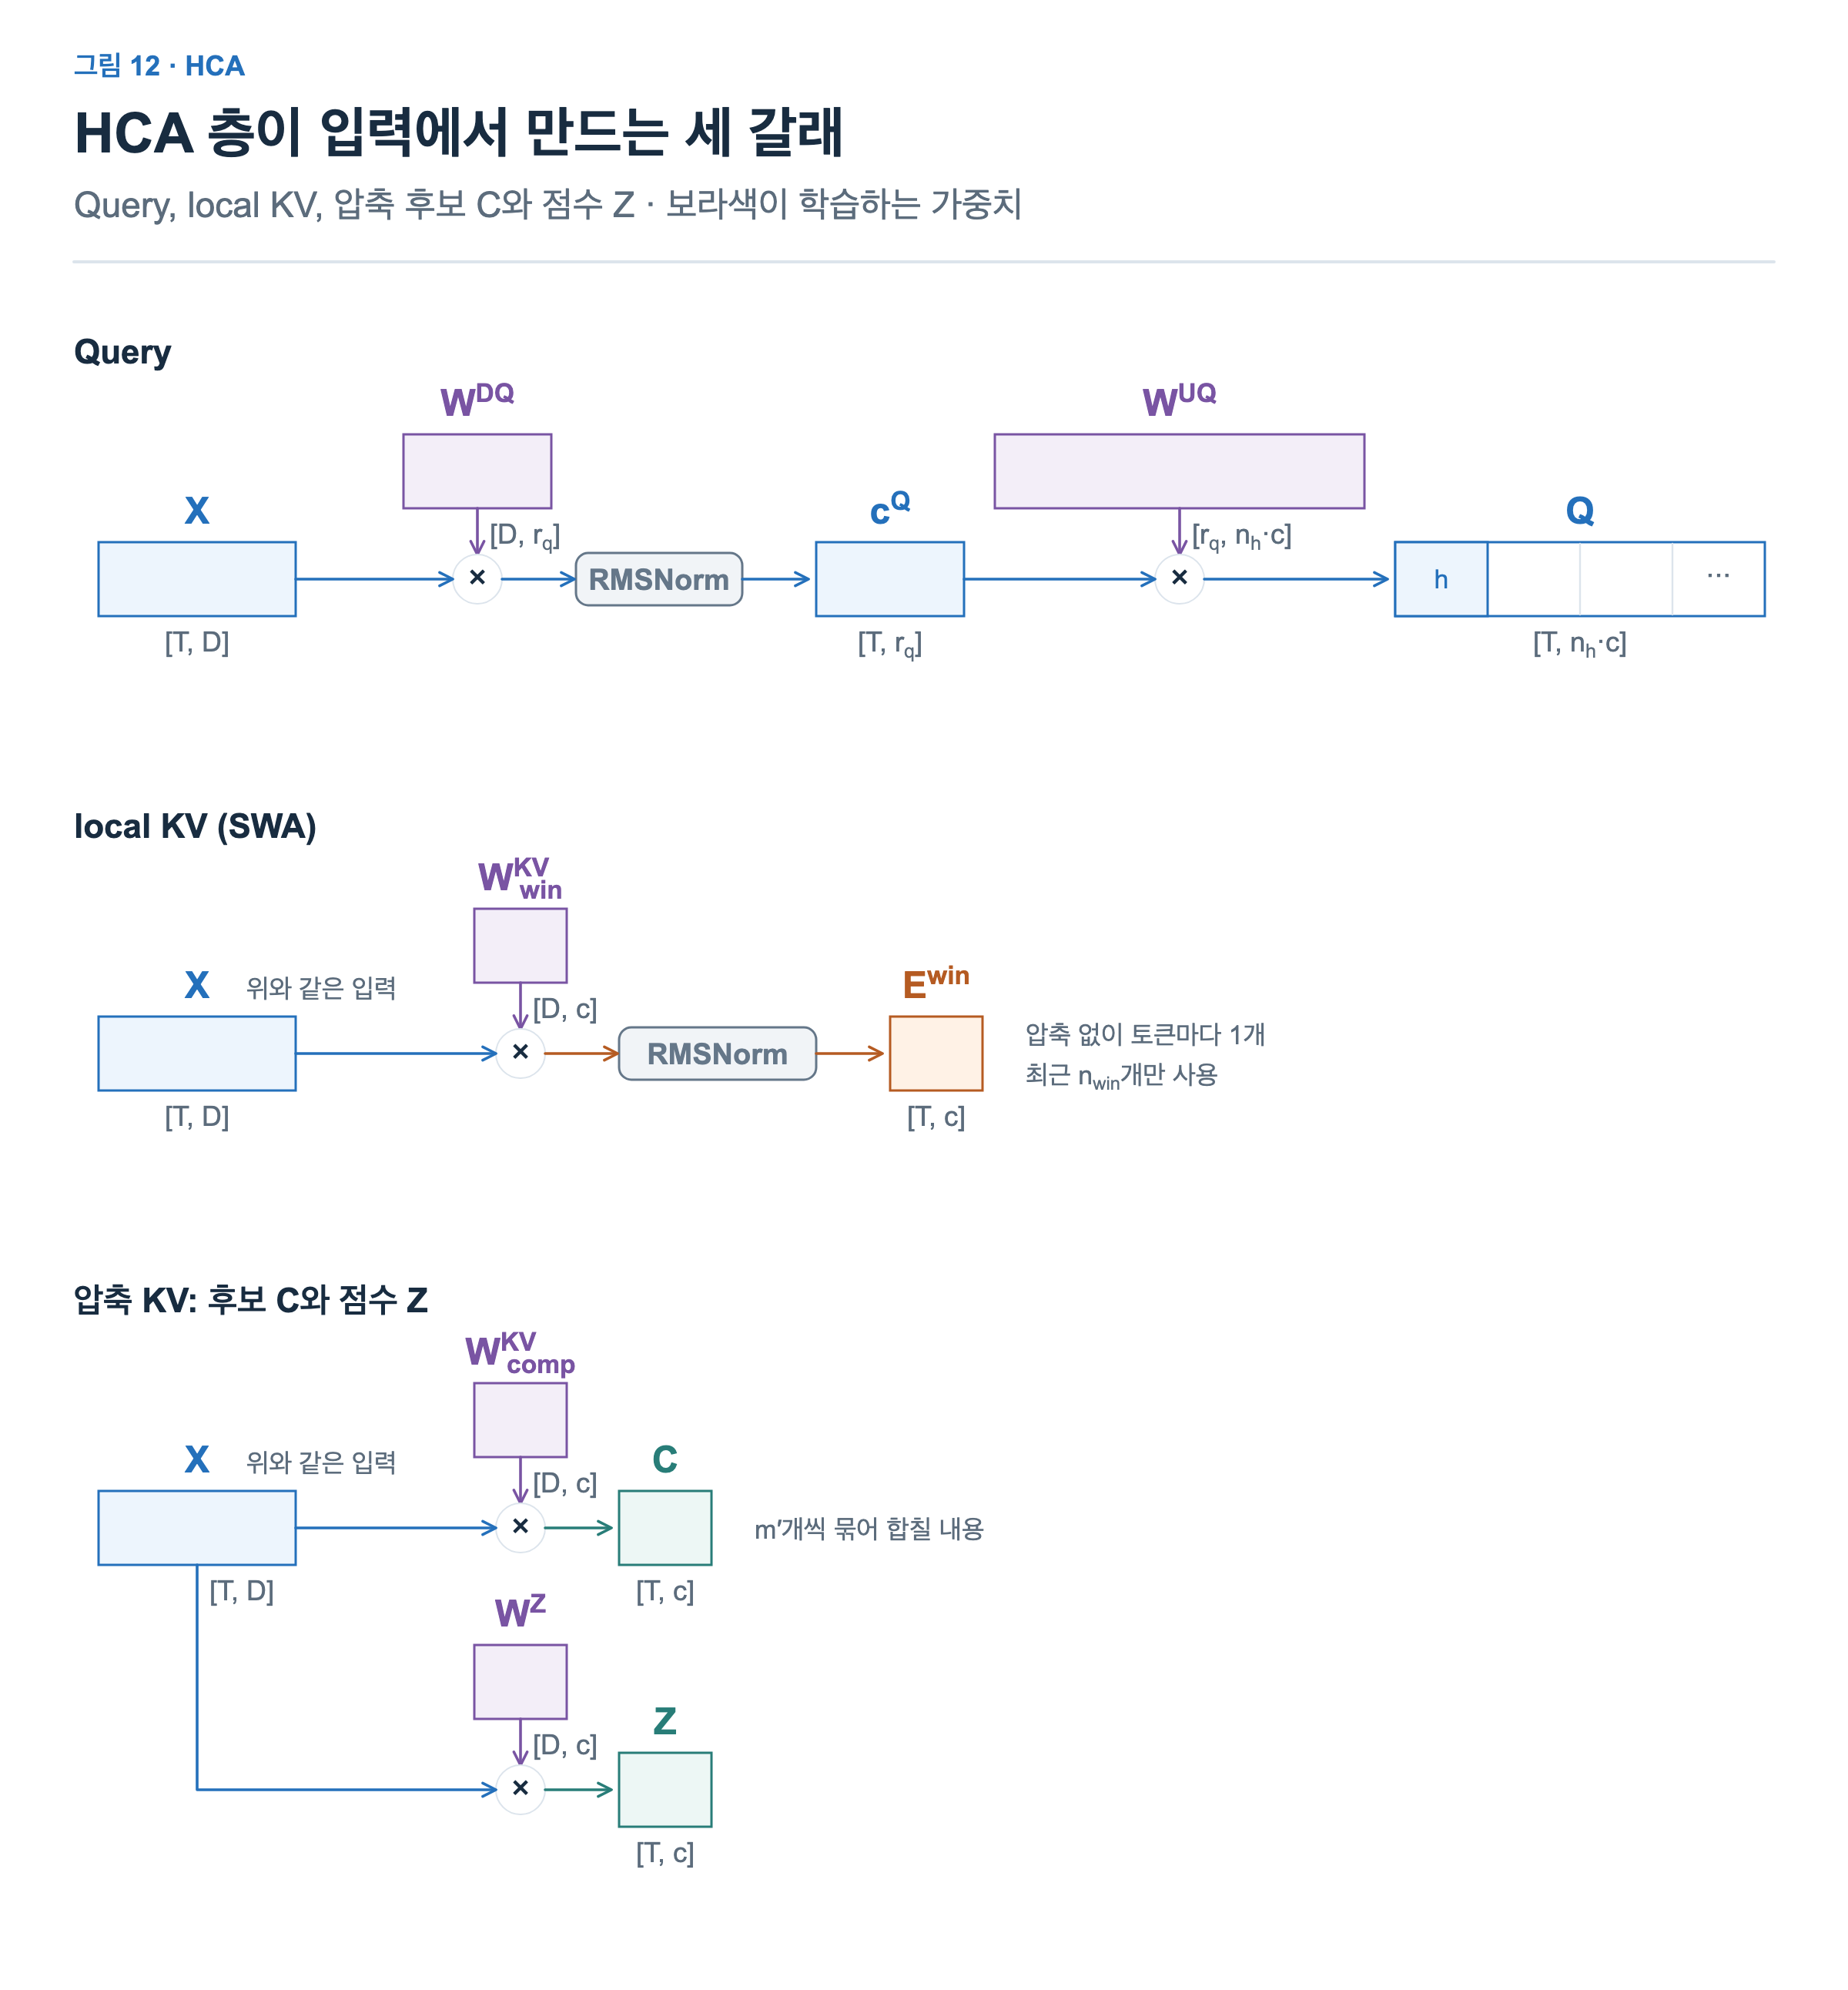
Query. MLA처럼 latent cQ를 거쳐 만듭니다.
local KV. 압축하지 않고 토큰마다 하나씩 만들어 최근 128개만 유지합니다.
압축 KV. 후보 C와 점수 Z를 만들어, 토큰 m′개를 하나의 entry로 합칩니다.
압축은 채널(특징 열 하나)마다 따로 하는 가중 평균입니다. 그림의 아래첨자 b는 블록(함께 압축하는 토큰 m′개 묶음) 번호이고, Sb는 softmax로 정한 비중, ub는 합친 한 행입니다. 교육용으로 m′ = 4로 줄였으며, 실제 HCA 층은 m′ = 128입니다.
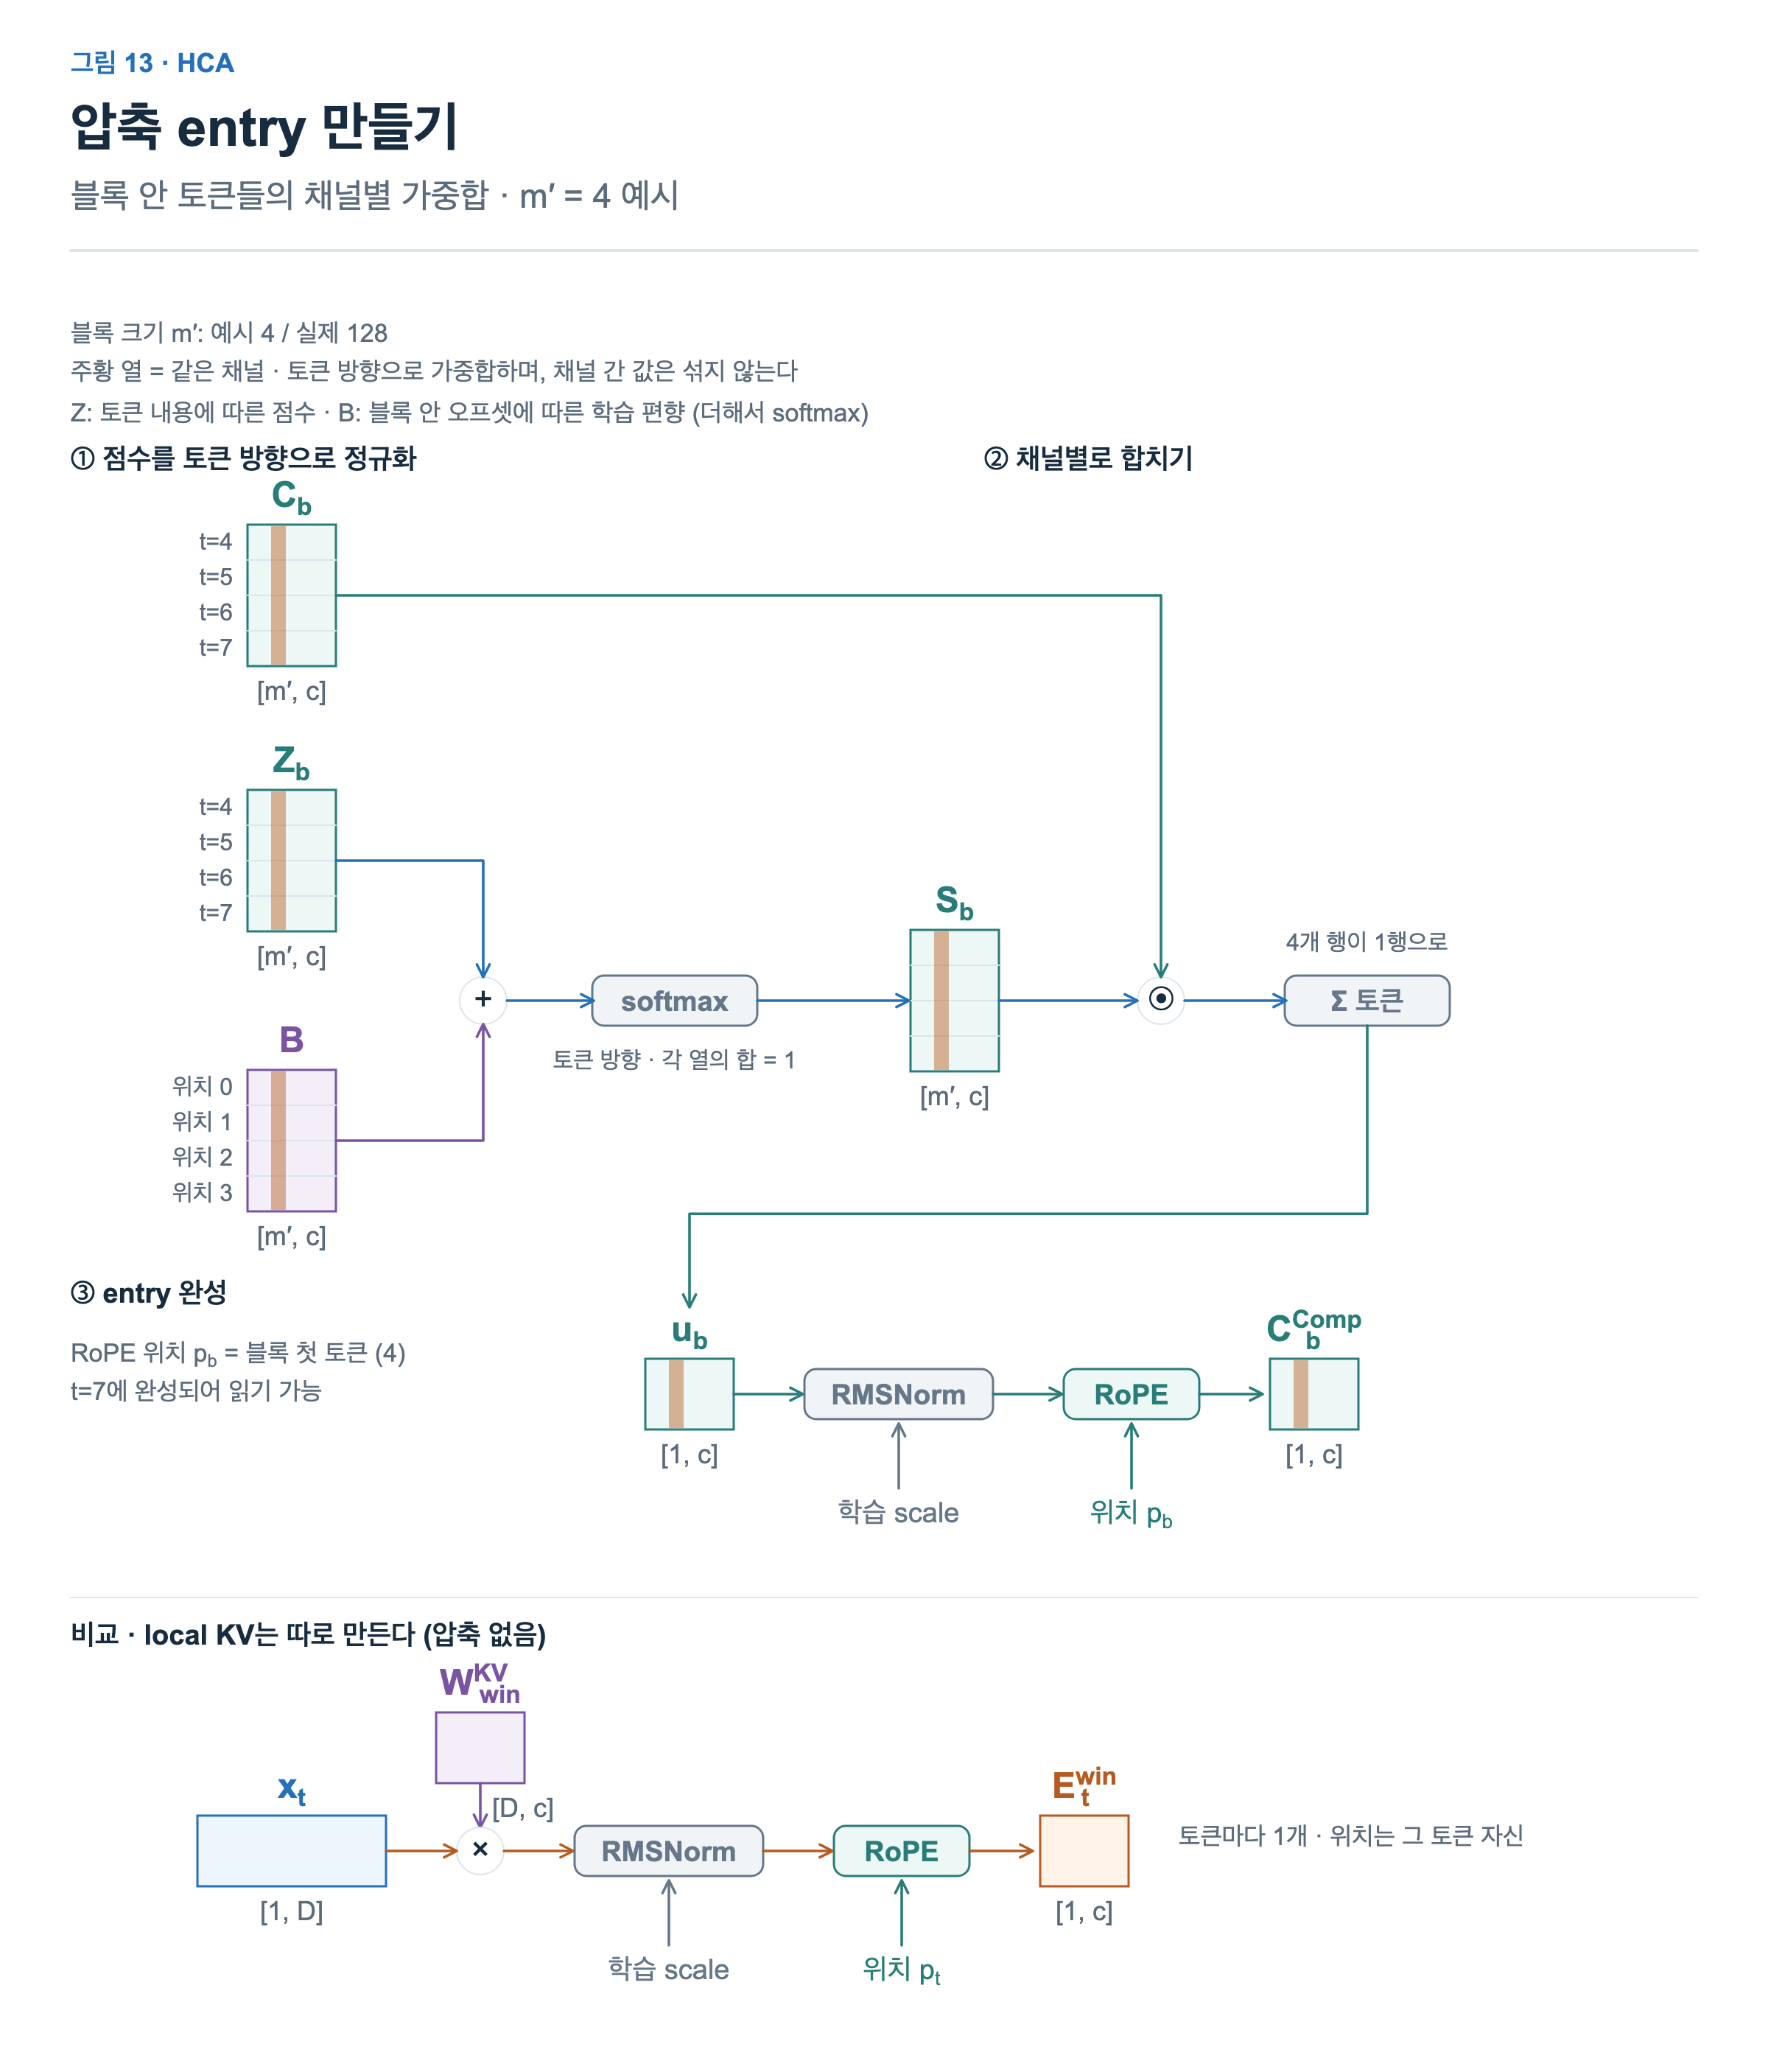
①② 비중 정하고 합치기. 블록 안 토큰들의 점수 Z에 위치 편향 B를 더하고, 토큰 방향으로 softmax해 비중을 정합니다. B는 블록 안의 위치(오프셋)마다 학습한 값으로, 모든 블록이 같은 B를 씁니다. 그 비중으로 후보 C를 채널마다 합치면 한 행이 남습니다.
③ entry 완성. 합친 행이 RMSNorm과 RoPE를 거쳐 entry가 됩니다. 그림의 ’학습 scale’은 RMSNorm 뒤에 곱하는 학습 가중치로, FP8 저장에 쓰는 scale과는 다릅니다. RoPE는 entry의 마지막 64차원에만 적용합니다. 블록이 다 차야 entry가 완성됩니다.
비교. local KV는 압축하지 않고 토큰마다 따로 만듭니다.
압축 entry는 블록이 다 차야 읽을 수 있습니다. 토큰이 하나 늘 때 읽을 수 있는 entry가 어떻게 바뀌는지 그림 14로 보겠습니다.
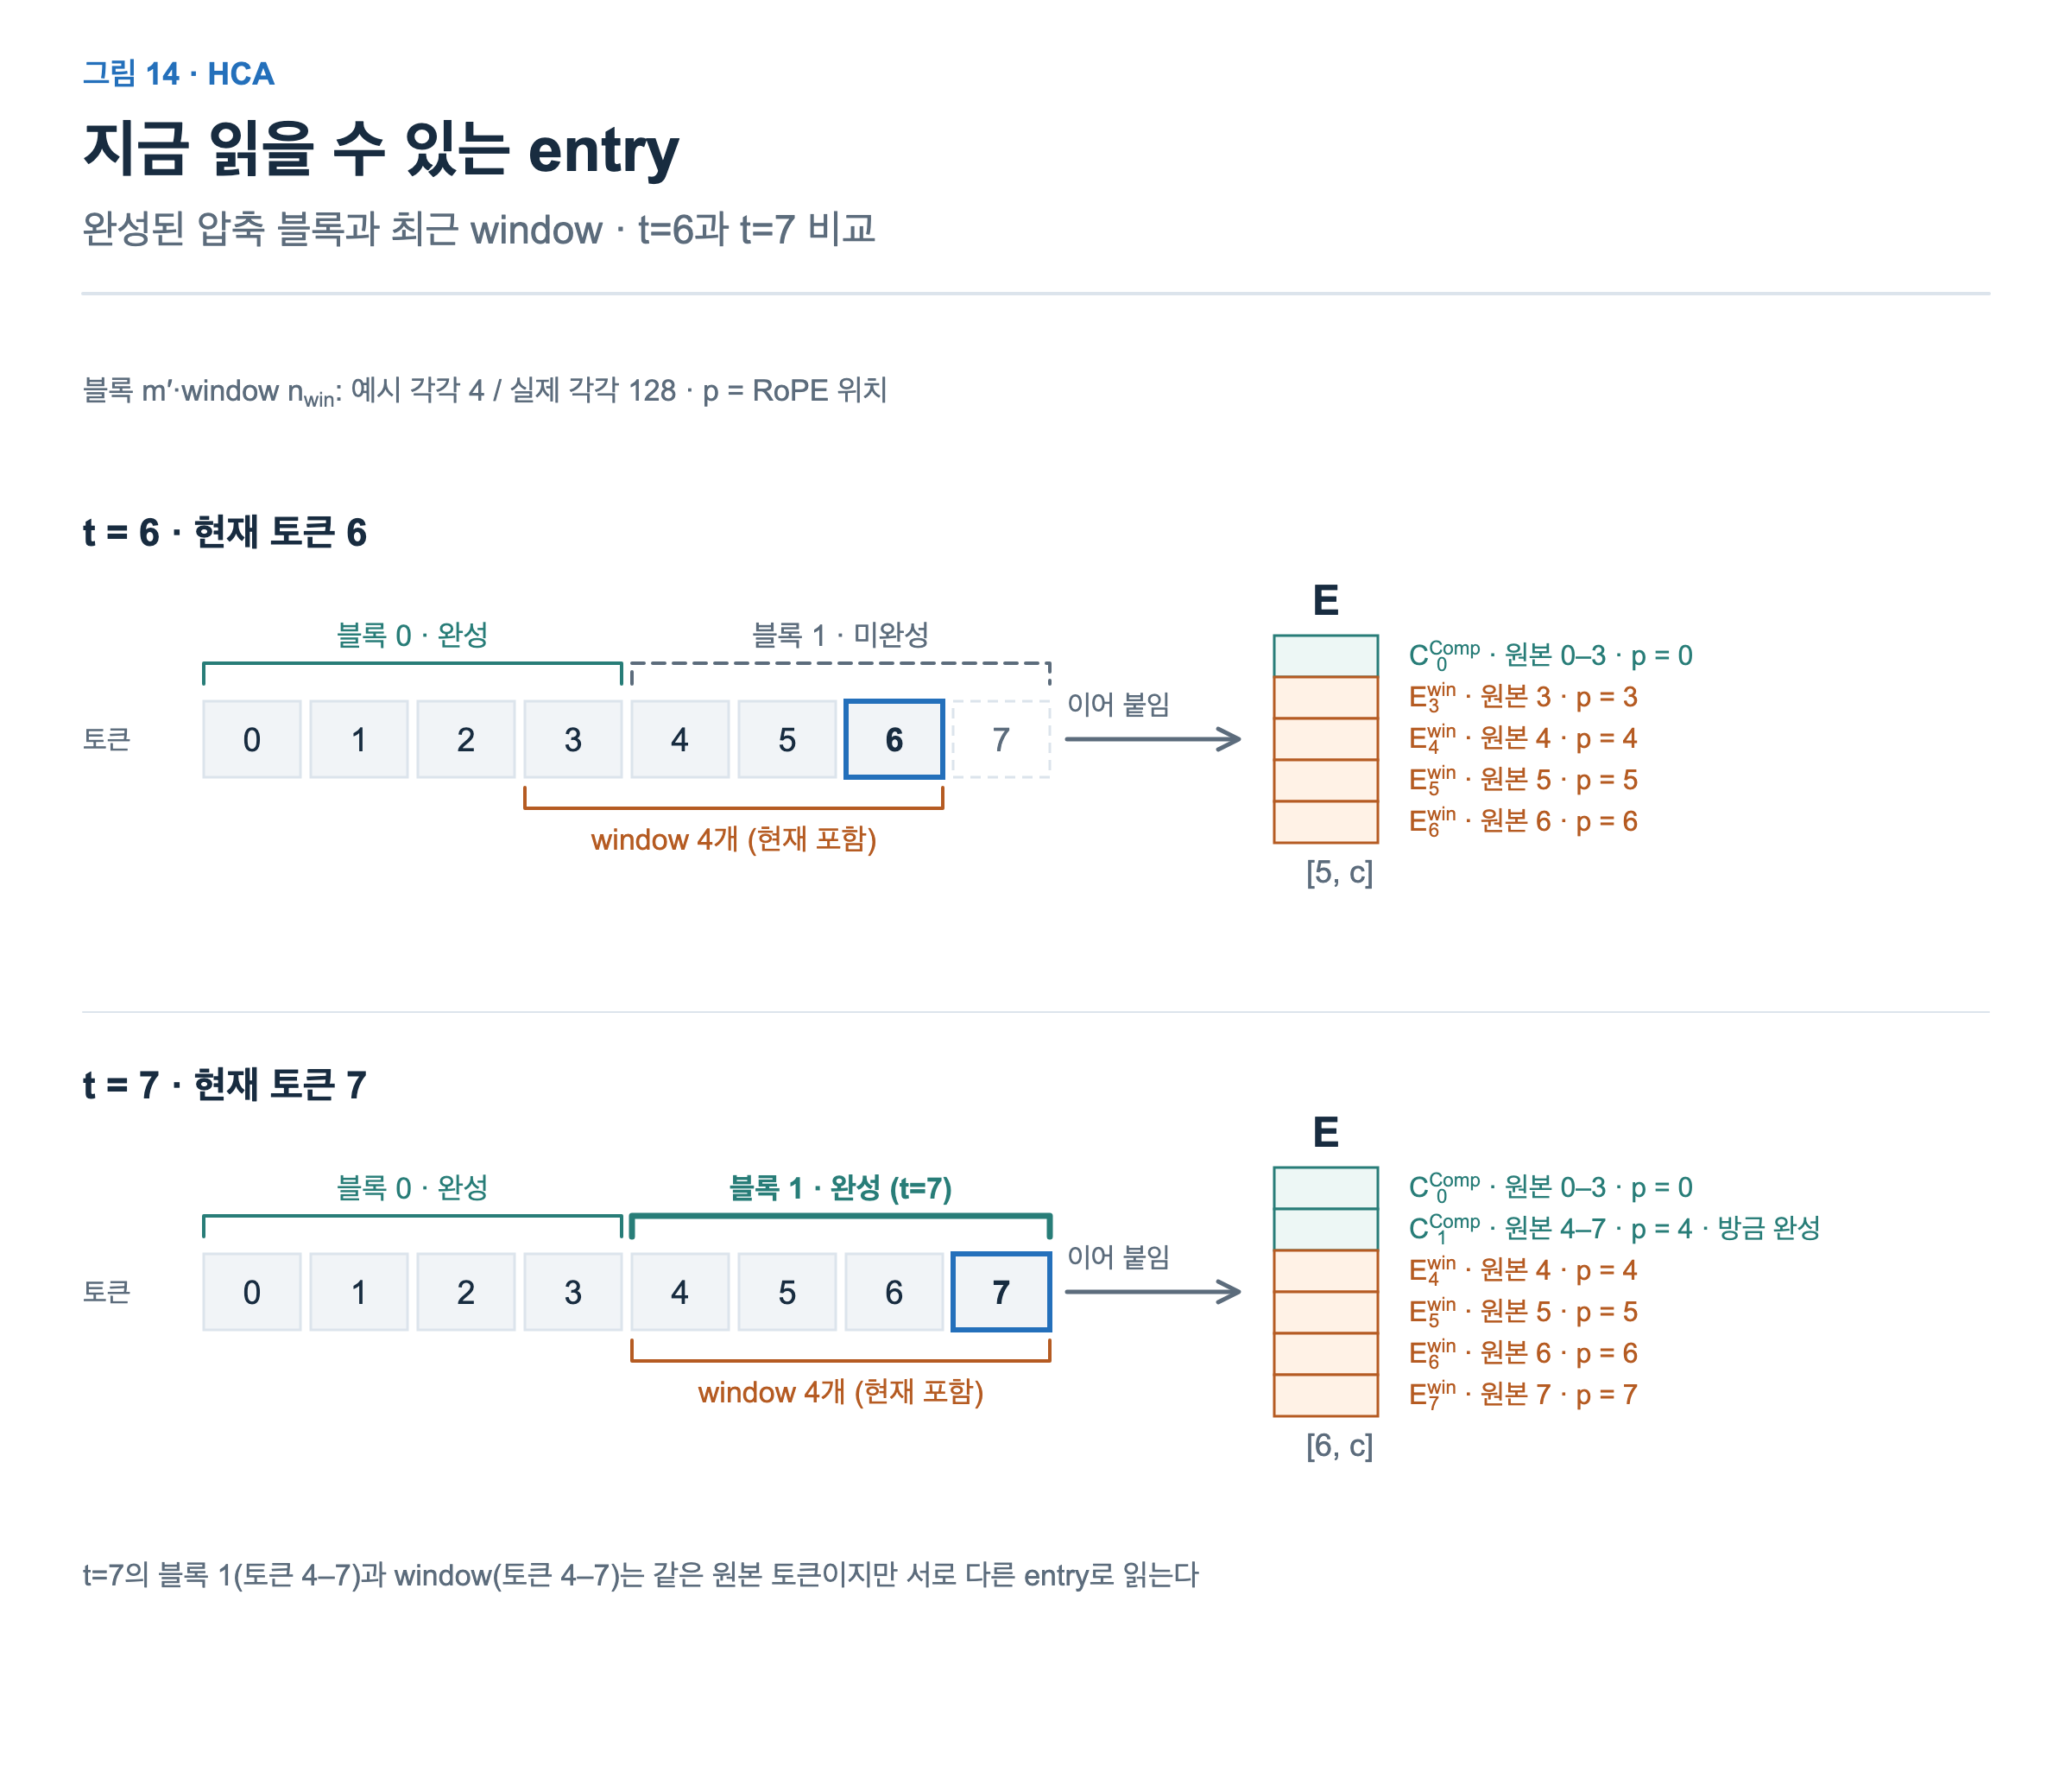
t = 6. 토큰 t는 완성된 압축 entry 전부와 현재 토큰을 포함한 최근 window를 이어 붙여 읽습니다. 여기서는 블록 0만 완성됐고, 아직 미완성인 블록 1의 최근 토큰은 window로 읽습니다.
t = 7. 블록 1도 완성돼 압축 entry가 하나 늘어납니다. window도 함께 읽으므로, 같은 원본 토큰이 압축 entry와 window entry에 동시에 들어갈 수 있습니다.
이렇게 모은 entry를 attention이 Key와 Value로 함께 씁니다.
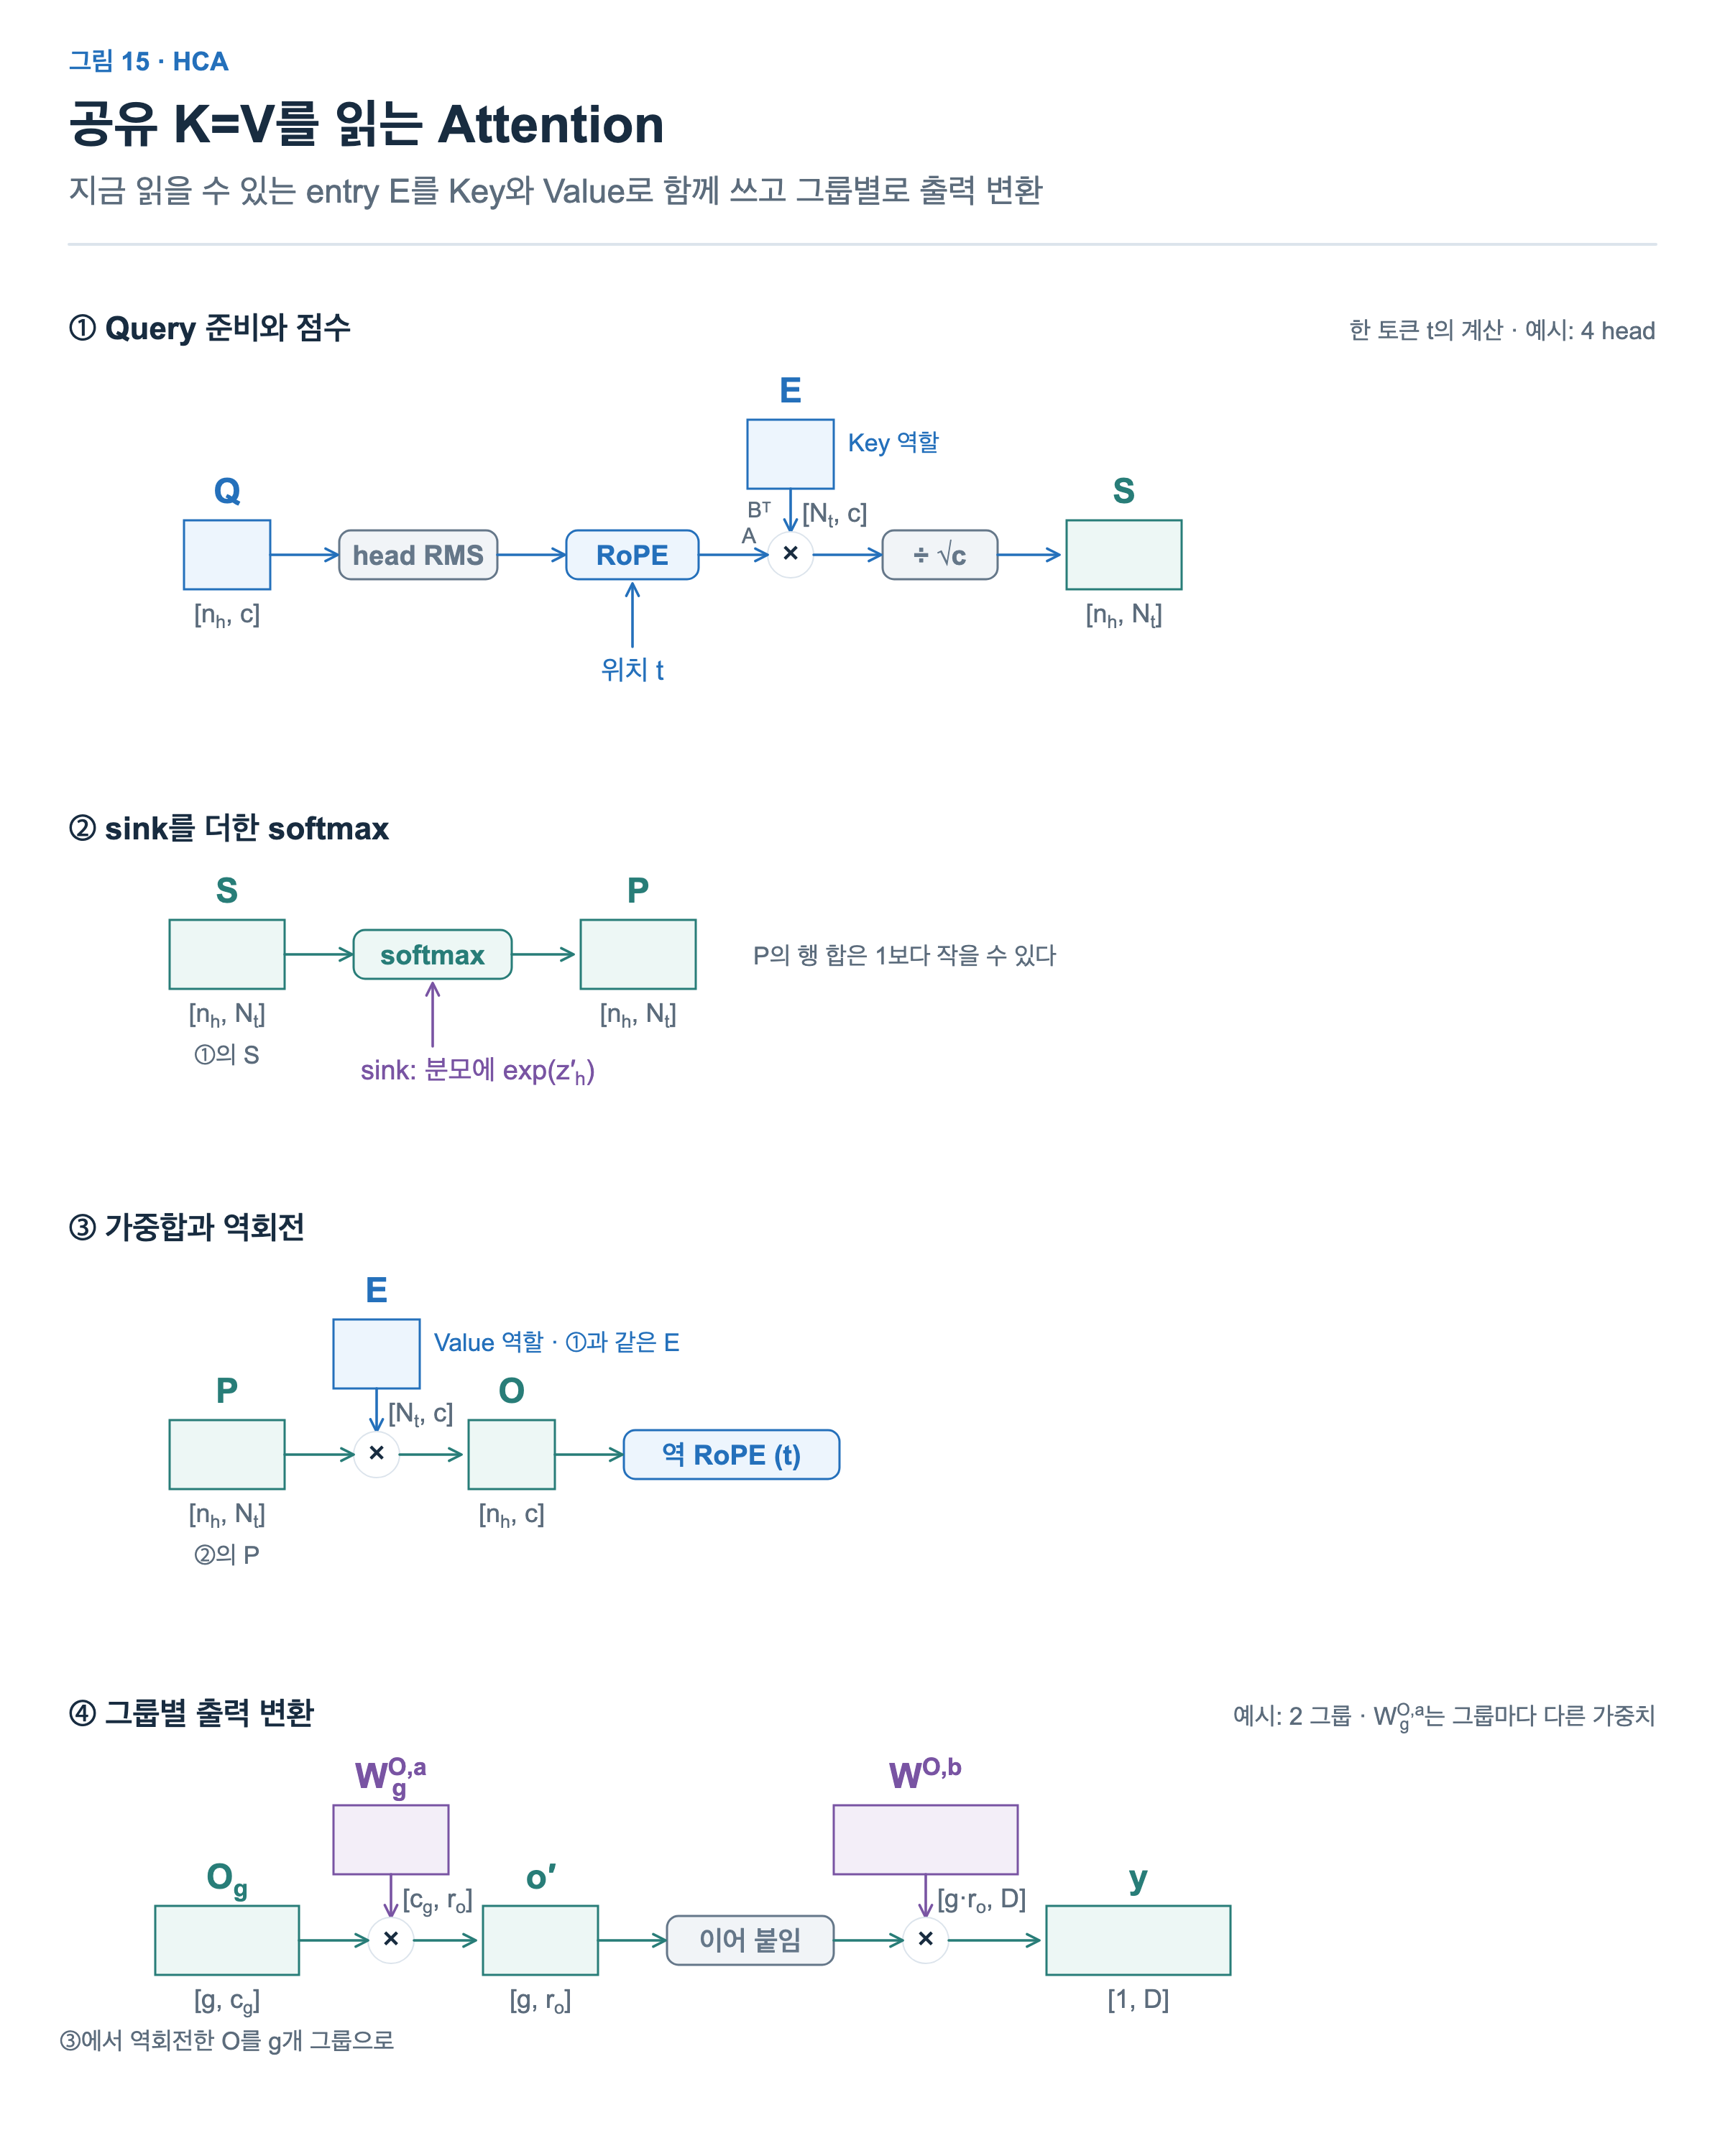
① Query 준비와 점수. Query를 head마다 RMSNorm으로 정규화(head RMS)하고 위치 t의 RoPE를 적용한 뒤, 그림 14에서 모은 Nt개의 entry E와 곱해 점수 S를 만듭니다. 여기서 E는 Key 역할을 합니다. head별로 Key와 Value를 펼치는 가중치가 없습니다.
② sink를 더한 softmax. head마다 학습한 값 z′ₕ로 exp(z′ₕ)를 softmax 분모에 더합니다. 그래서 실제 entry들의 가중치 합이 1보다 작아질 수 있습니다. 어느 entry에도 주의를 덜 줄 여지를 남기는 장치이며, 이 값을 sink라고 합니다.
③ 가중합과 역회전. 확률 P로 같은 E를 Value로 가중합해 head 출력 O를 만듭니다. E는 RoPE를 적용한 채 Value로도 쓰이므로, 출력의 마지막 64차원을 현재 query 위치 t만큼 반대로 회전합니다(역회전). 위치 s의 entry는 s만큼 회전돼 있었으므로, 역회전 뒤에는 각 entry의 기여가 s − t만큼, 즉 절대 위치가 아니라 상대 거리만큼 회전된 값이 됩니다. 원리는 V2 절의 ‘RoPE의 회전과 위치 차이’ 접기에 있습니다.
④ 그룹별 출력 변환. ③에서 역회전한 O의 head를 g개 그룹으로 묶습니다. 그룹 하나의 폭 cg는 그 그룹 head들의 출력을 이어 붙인 폭입니다. 그룹마다 서로 다른 WO,ag로 폭 ro로 줄인 뒤 이어 붙이고, 공통 WO,b로 hidden 차원 D로 되돌립니다.
Key와 Value가 같은 entry이므로 저장도 한 번이면 됩니다.
CSA: 겹쳐서 압축하고 골라 읽기
CSA는 HCA와 같은 틀에 두 가지를 더합니다. 압축 구간을 겹치게 하고, indexer로 entry를 골라 읽습니다.
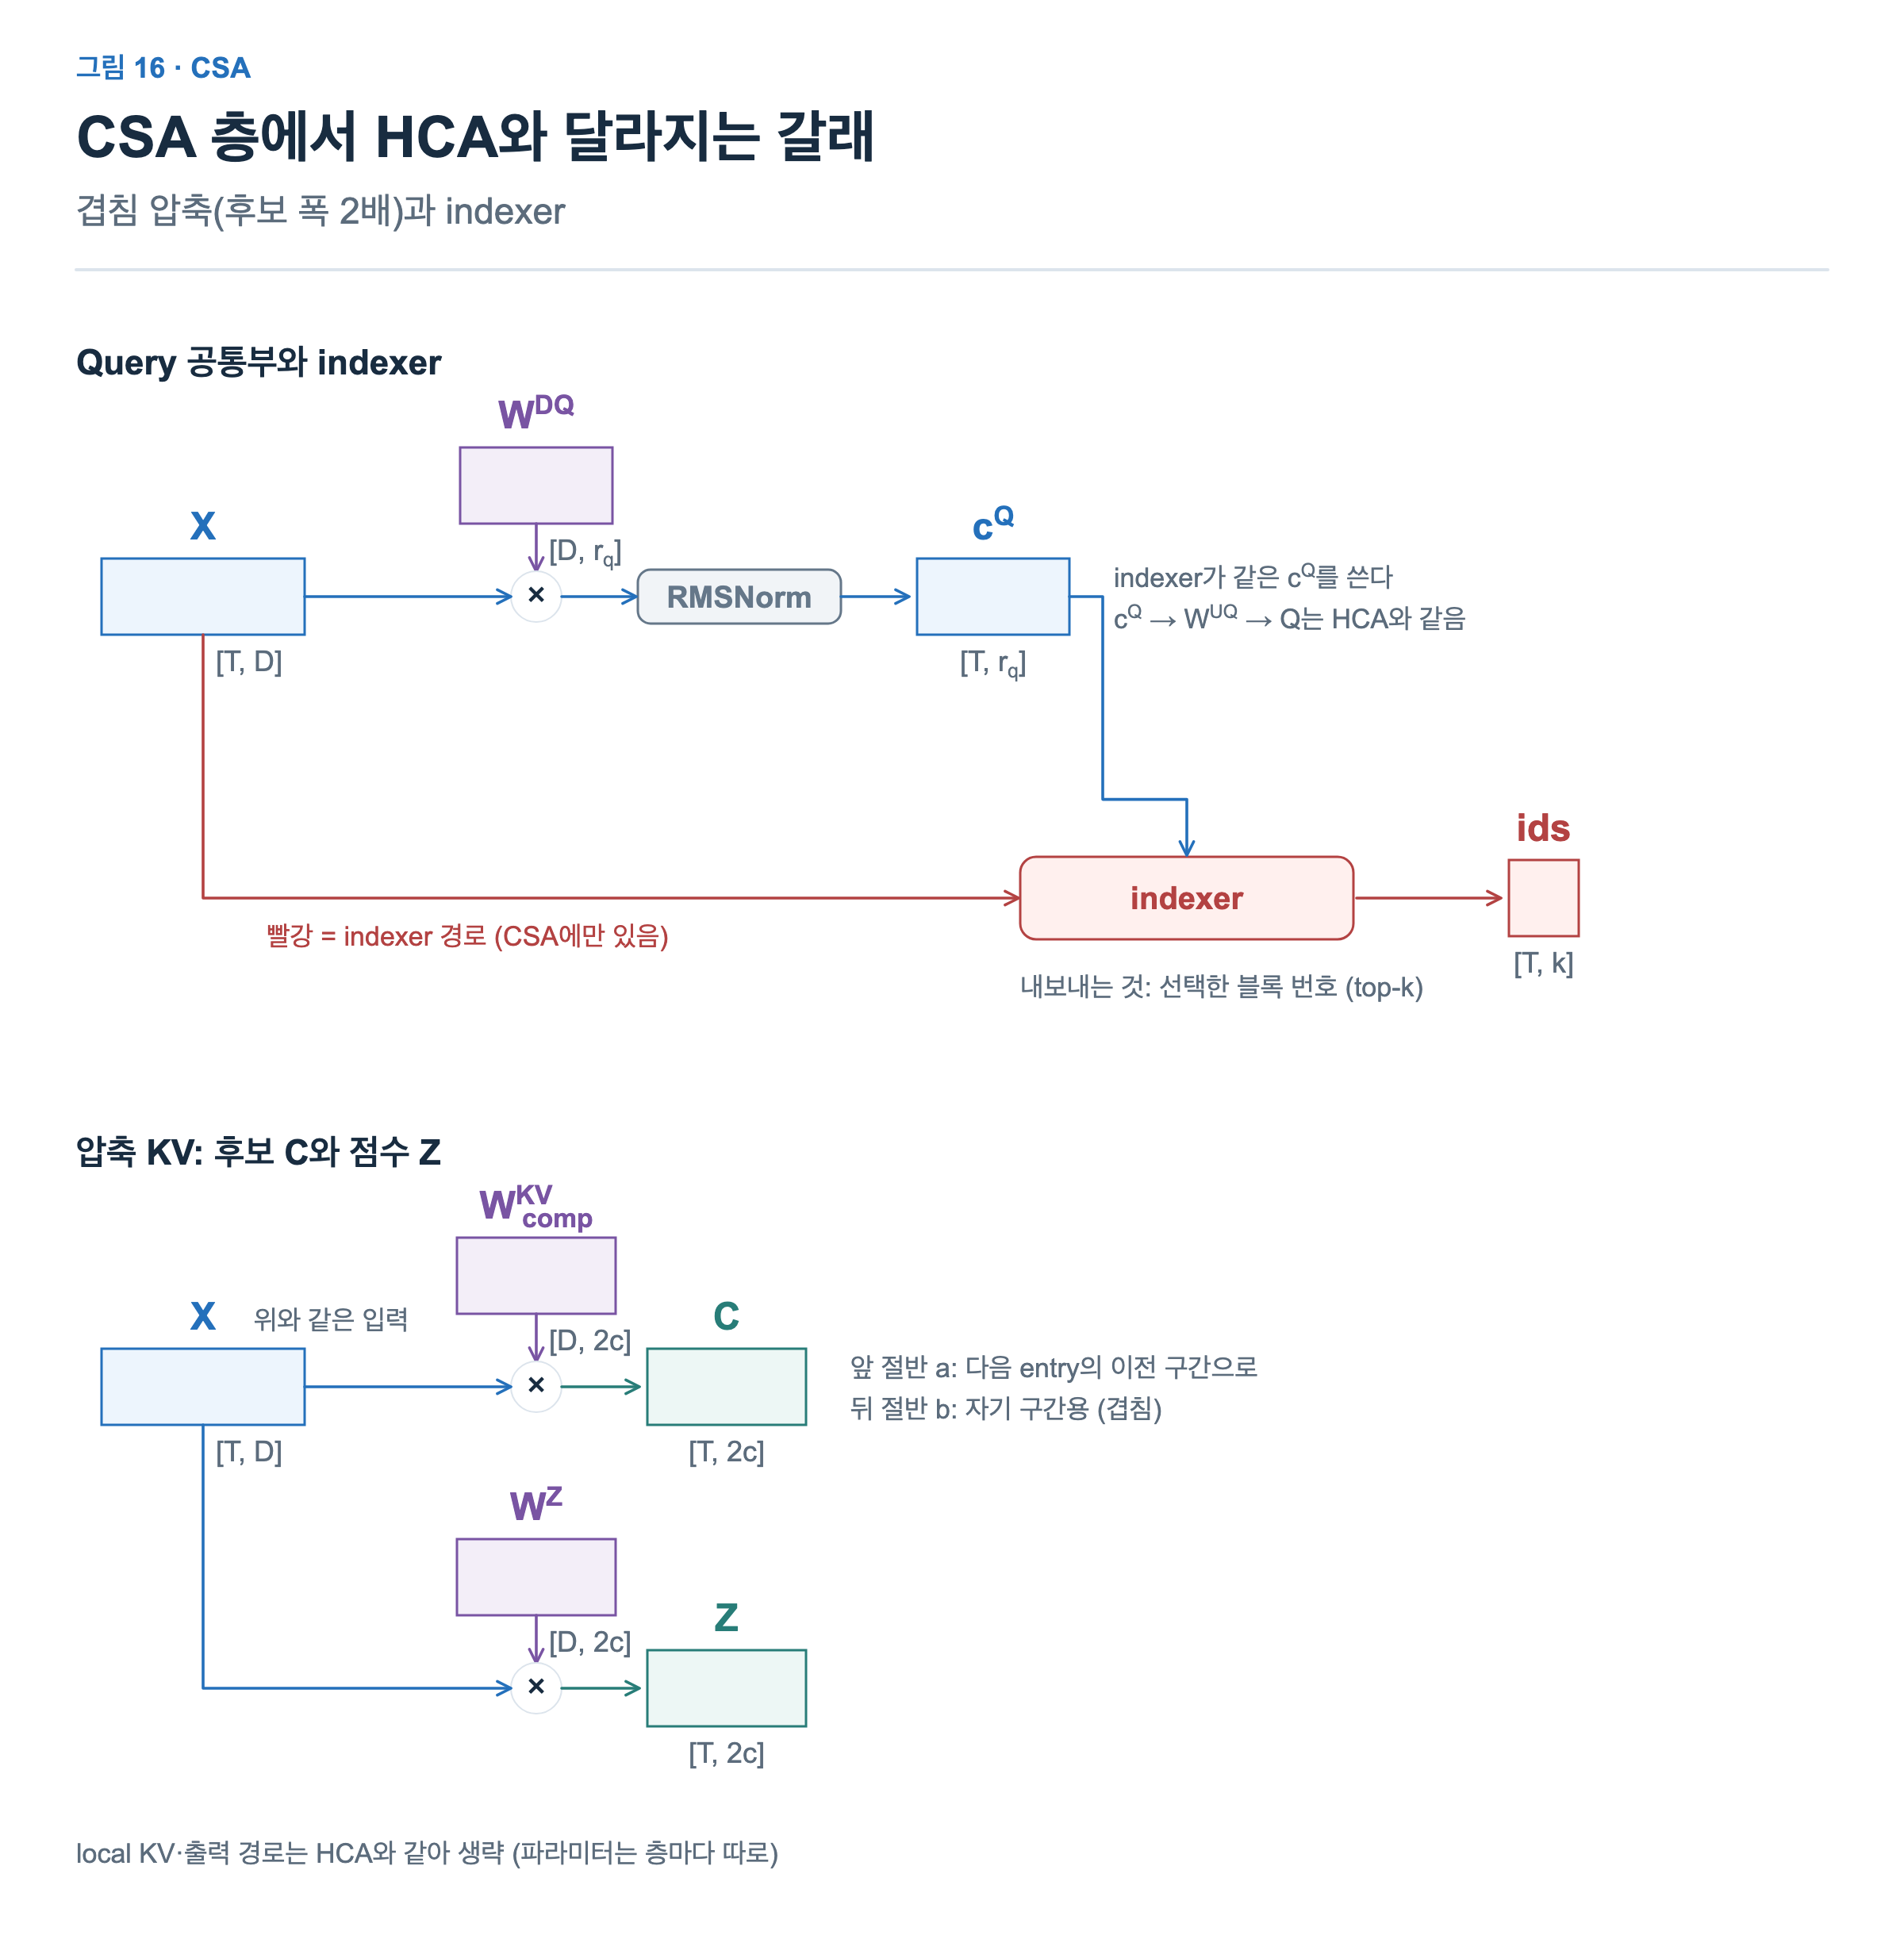
Query와 indexer. Query 경로는 HCA와 같습니다. 새로 생긴 indexer는 주 attention과 공유하는 Query latent를 투영해 indexer query를 만듭니다.
압축 KV. 후보 C와 점수 Z의 가중치 폭이 HCA의 두 배입니다. 이웃 구간과 겹쳐 압축하기 때문입니다.
압축 후보를 만드는 가중치 폭이 두 배인 이유는 entry 하나를 만드는 방식에서 드러납니다. WKVcomp와 WZ는 토큰마다 폭 2c의 후보와 점수를 만들고, 이것을 앞 절반 a와 뒤 절반 b로 나눠 씁니다. 뒤 절반 b는 그 토큰이 속한 구간의 entry에 들어가고, 앞 절반 a는 다음 구간의 entry를 만들 때 ’이전 구간’으로 들어갑니다. 그래서 entry 하나는 이전 구간 4토큰의 a와 자기 구간 4토큰의 b, 모두 8행을 모아 HCA와 같은 방식으로 합칩니다. 8행의 점수에 위치 편향을 더해 softmax한 비중이 곧 압축에 쓰는 가중치입니다.
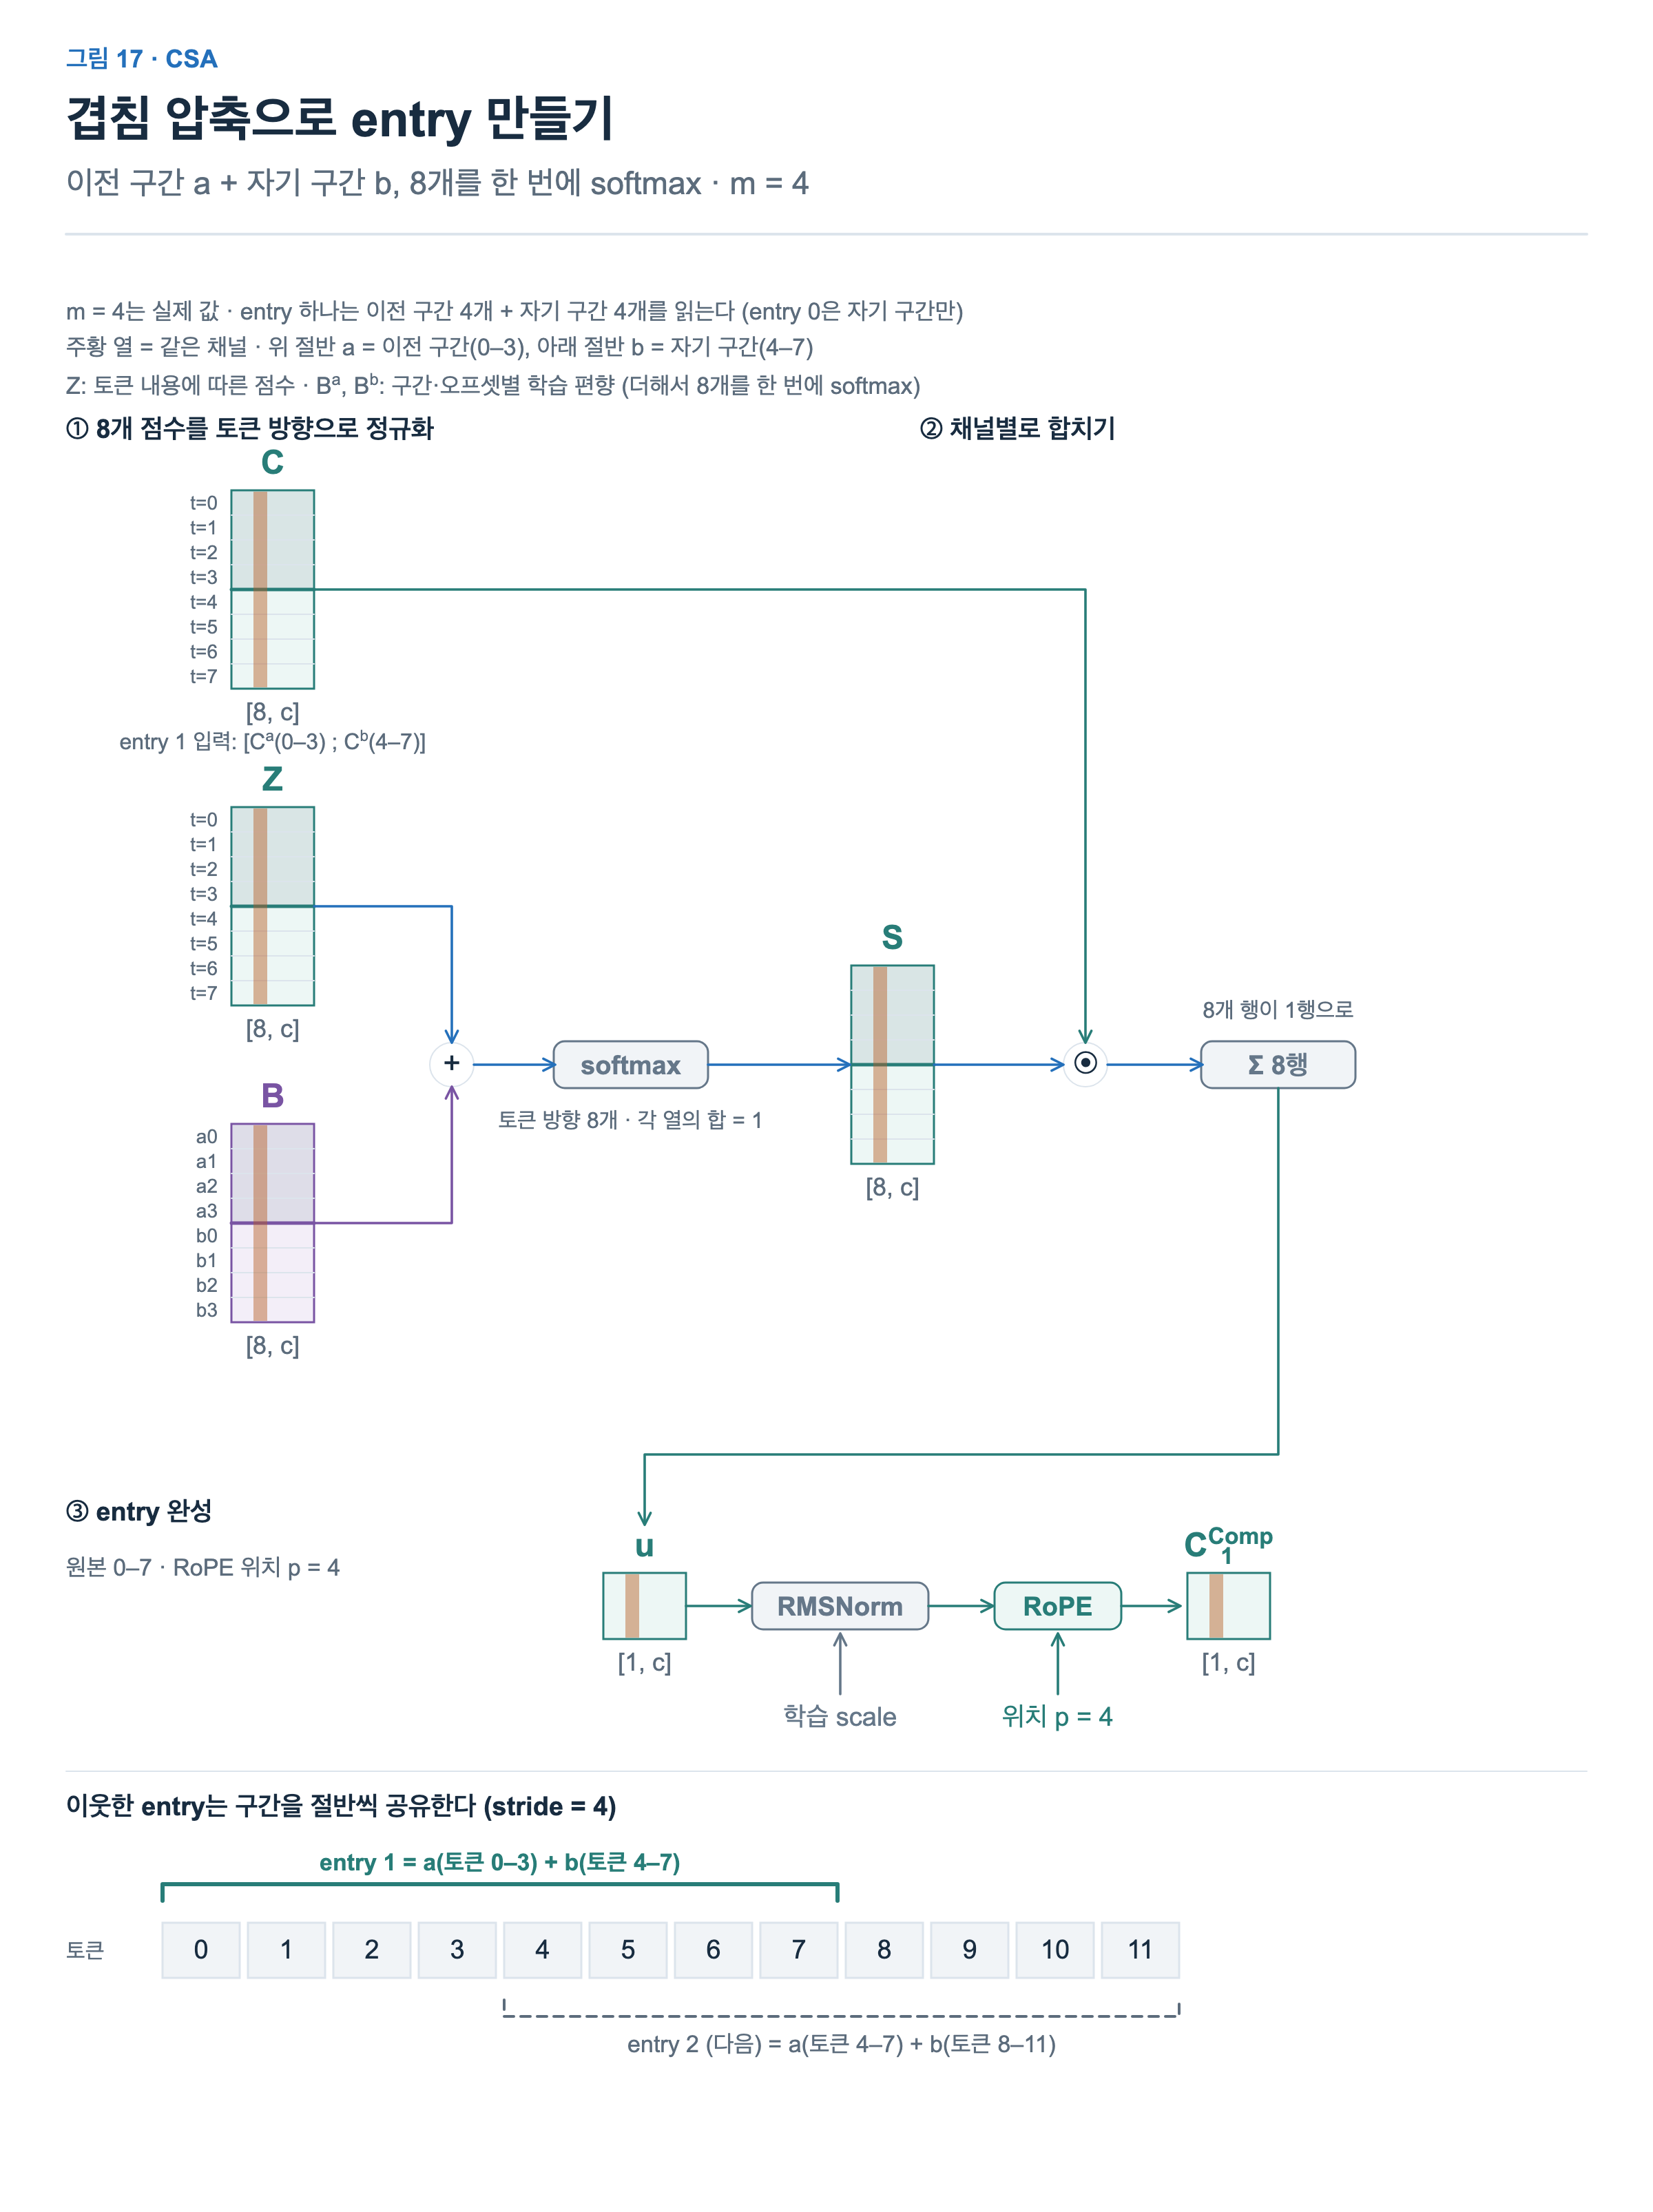
①② 8개 토큰으로 entry 하나. CSA의 entry 하나는 자기 구간 4개 토큰(b)과 이전 구간 4개 토큰(a), 모두 8개를 읽어 만듭니다. m = 4는 CSA의 실제 값입니다.
③ entry 완성. 그래도 entry는 4개 토큰마다 하나씩 생깁니다. 압축 비율은 4, 즉 저장하는 entry 수가 토큰 수의 1/4입니다. entry의 RoPE 위치는 HCA와 마찬가지로 자기 구간의 첫 토큰 위치입니다(그림의 p = 4). 이전 구간을 함께 읽어도 기준은 자기 구간입니다.
이웃 entry. 이웃한 entry가 원본 토큰 구간을 절반씩 공유하므로, 블록 경계 양쪽의 정보를 함께 반영할 수 있습니다. 가중 압축이므로 정보를 그대로 보존한다는 뜻은 아니며, 첫 entry에는 이전 구간이 없습니다.
CSA는 압축 entry 가운데 일부만 읽으므로, 고를 entry를 정하는 indexer가 필요합니다.
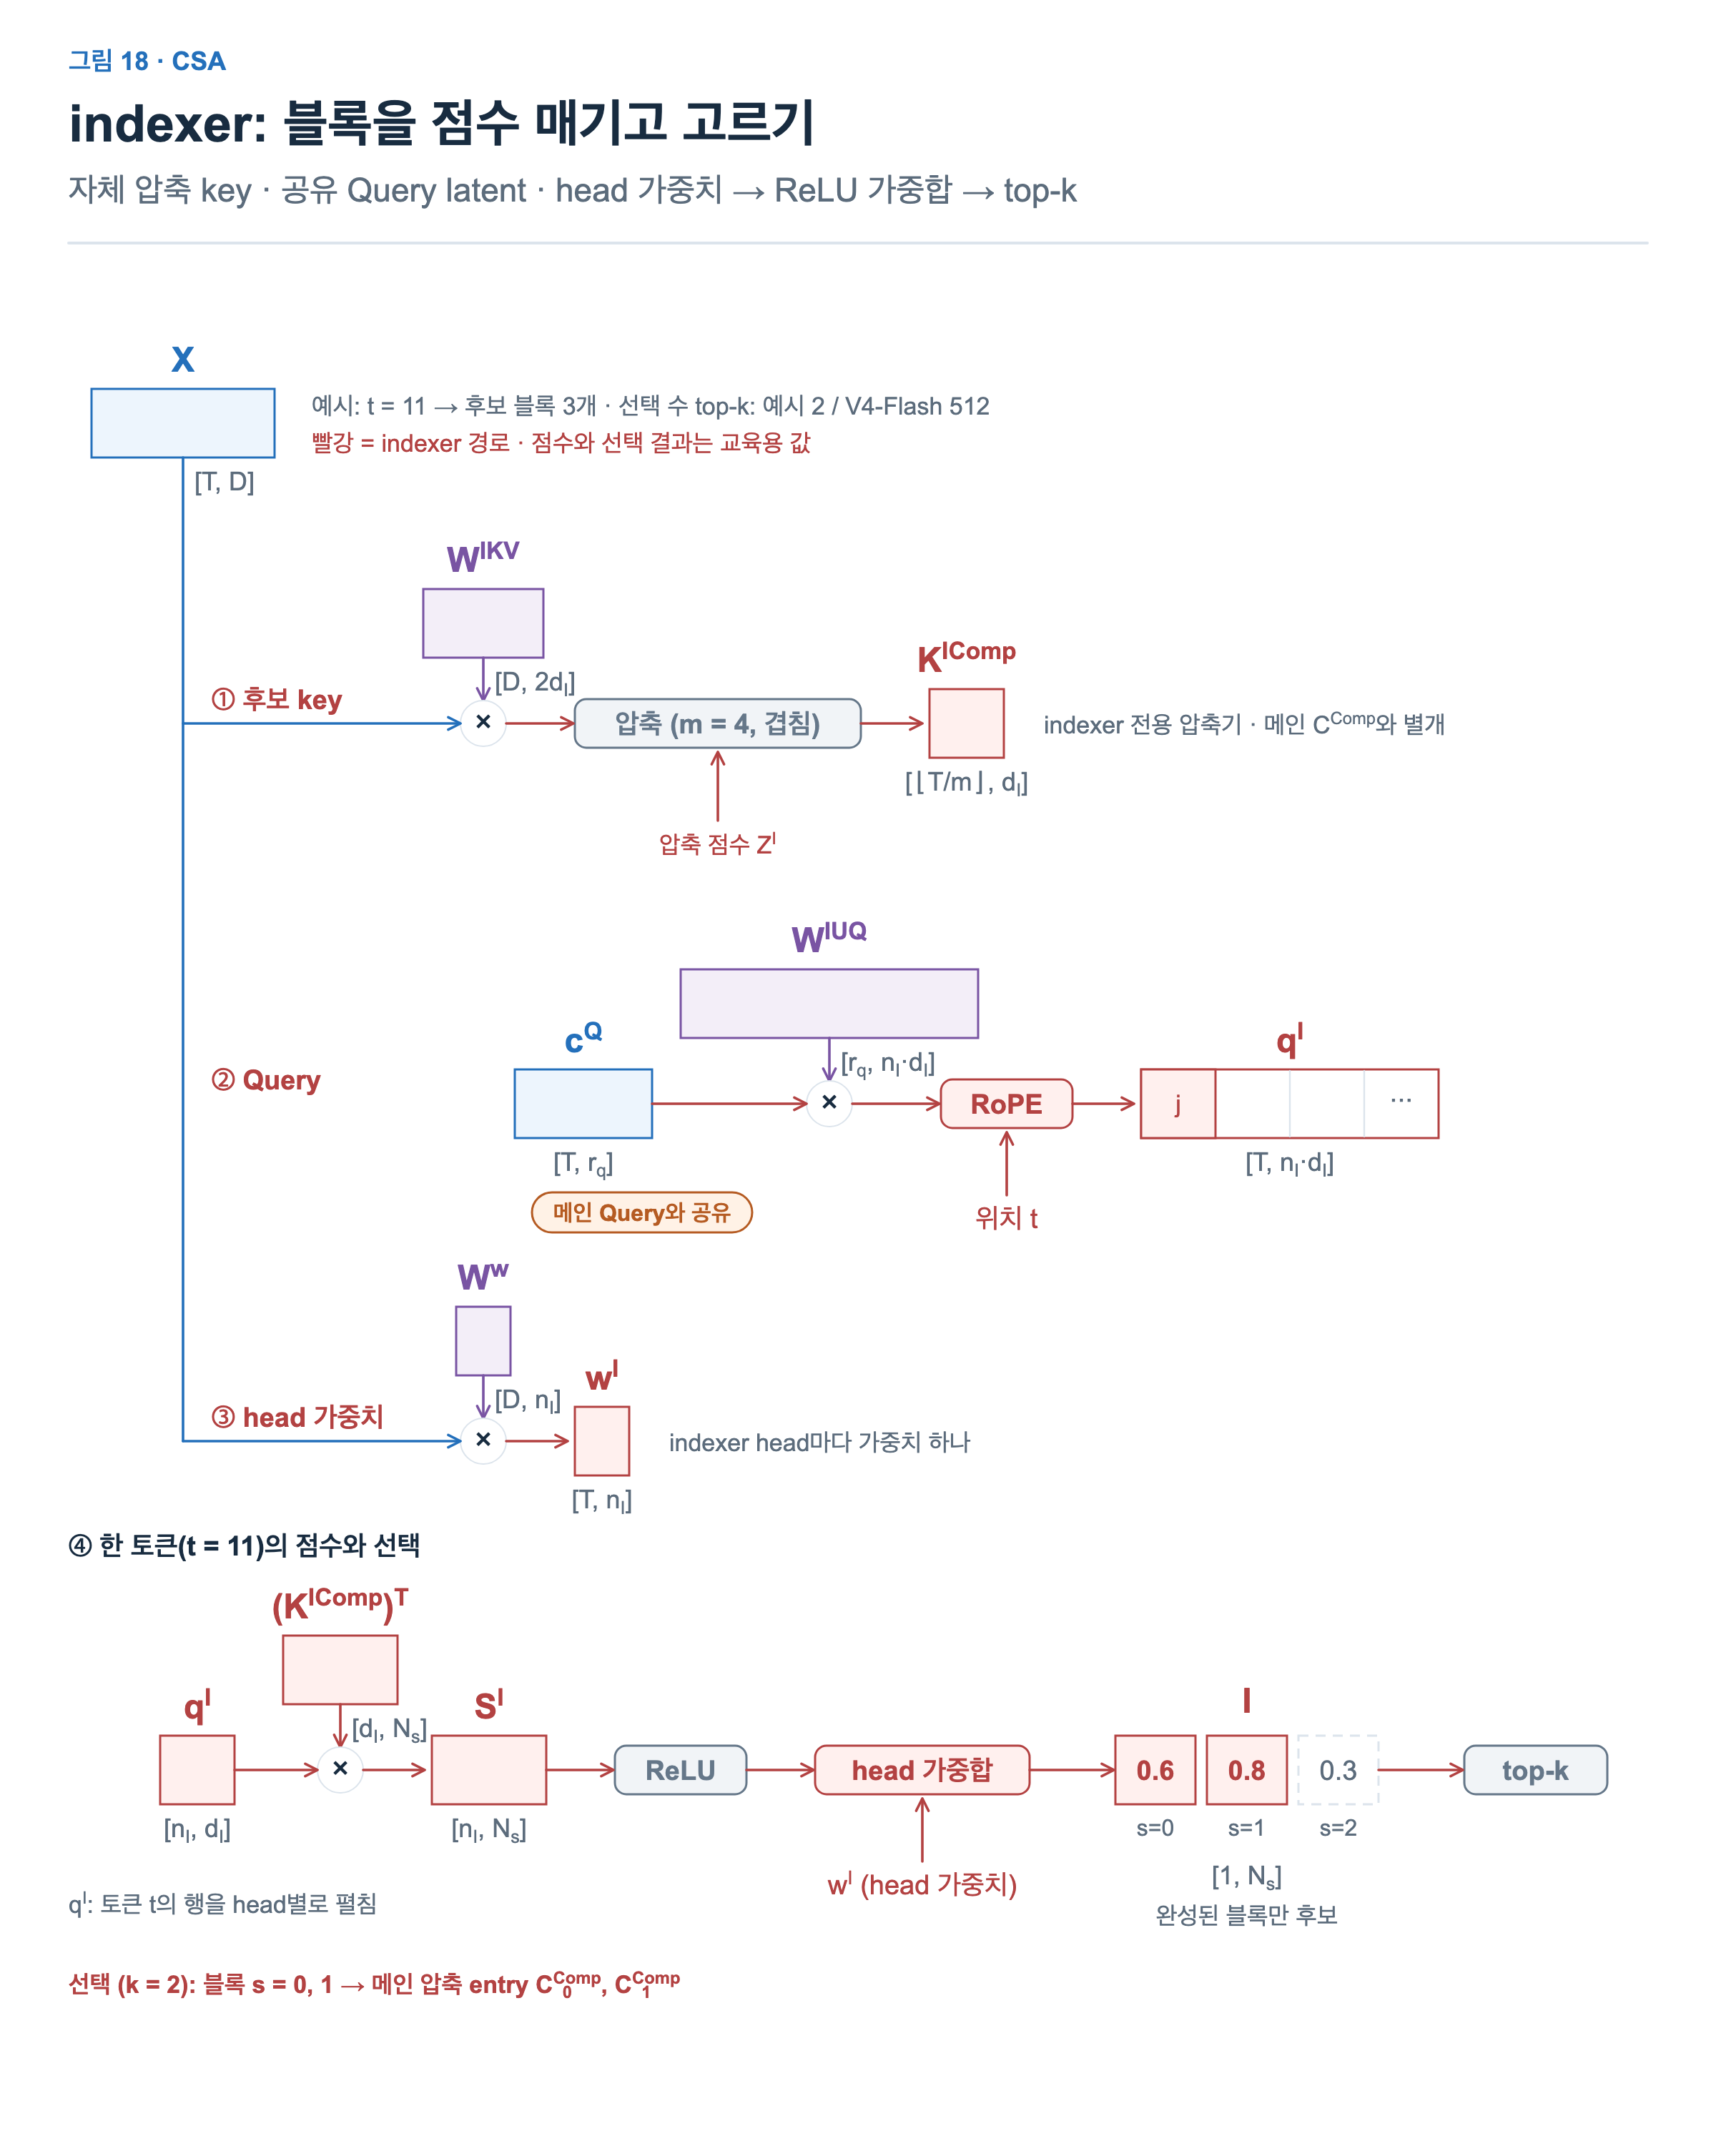
①②③ key, query, head 가중치. 그림의 nI는 indexer head 수, dI는 head당 차원(V3.2의 HI, dI와 같은 뜻), Ns는 지금까지 완성된 압축 entry 수입니다. CSA의 indexer는 V3.2의 indexer와 같은 점수 식을 쓰지만, key를 별도의 압축기로 만듭니다. 그래서 검색용 key도 4개 토큰마다 하나씩, 128차원으로 저장됩니다. 이 압축기는 주 압축기와 같은 방식으로 X에서 자기 후보와 점수 ZI를 만들고, 같은 겹침 방식으로 4토큰마다 entry를 만듭니다. 그래서 검색용 key s번과 main entry s번은 같은 원본 구간을 대표합니다.
④ 점수와 선택. head 가중치로 점수를 합치고, 토큰마다 점수가 높은 블록을 고릅니다. 그 query 위치까지 아직 완성되지 않은 블록은 후보가 아닙니다.
고른 압축 entry에 최근 window를 더하면, 이번 토큰이 읽을 대상이 정해집니다.
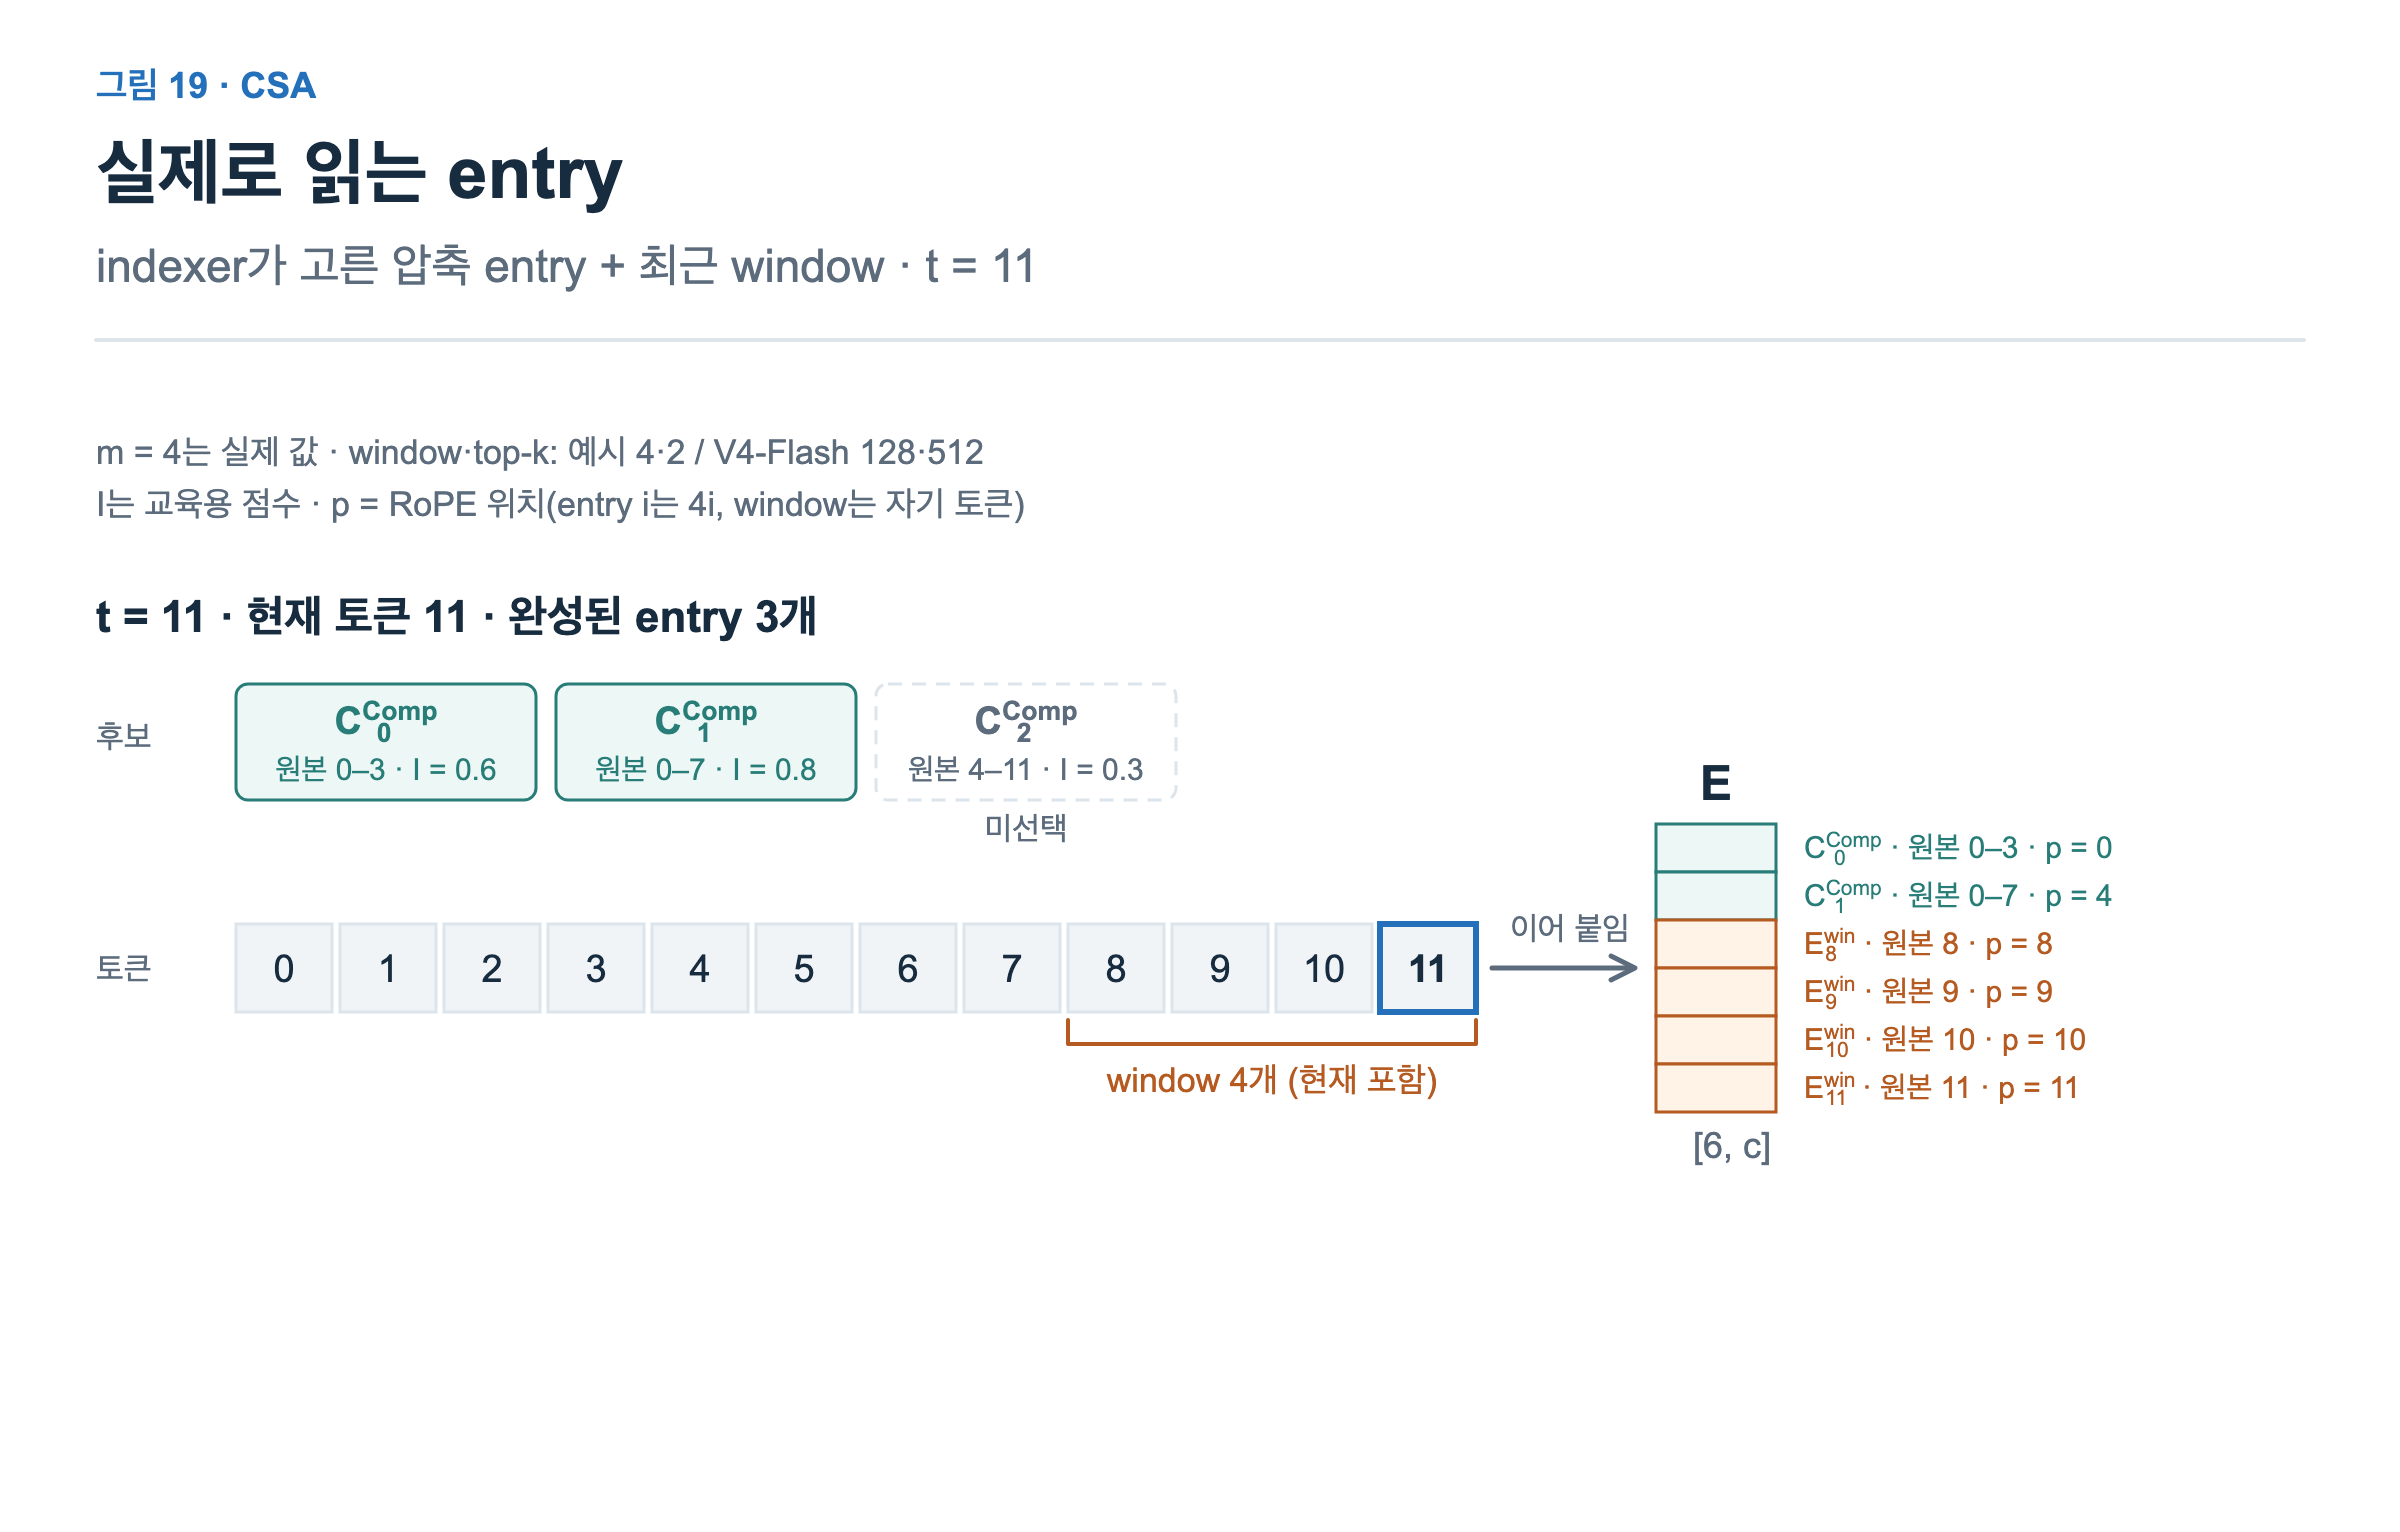
토큰 t는 indexer가 고른 압축 entry k개와 최근 window를 읽습니다. HCA가 압축 entry를 모두 읽는 것과 다릅니다.
HCA는 128배 압축이라 entry 수가 적으므로 모두 읽어도 됩니다. CSA는 4배 압축이라 entry가 많아, 골라 읽습니다.
V4-Flash의 KV 캐시 계산하기
CSA 층은 4개 토큰마다 main KV entry 512차원과 검색용 key 128차원을, HCA 층은 128개 토큰마다 main KV entry 512차원을 저장합니다.
구조만 보면, 모두 BF16으로 저장해도 21 × 640 × 2 B ÷ 4 + 20 × 512 × 2 B ÷ 128 = 6,880 B로 V2보다 10배 작습니다. 저장 벡터의 폭(512)은 MLA의 576과 비슷한데, 토큰 4개, 128개를 entry 하나로 압축했기 때문입니다.
배포 형식에서는 main KV entry를 대부분 FP8로, 검색용 key를 FP4로 저장합니다. 이 글에서 쓰는 배포 형식은 main KV 항목당 584 B, 검색용 key 항목당 68 B입니다.
V4-Flash: 21층 × (584 + 68) B ÷ 4 + 20층 × 584 B ÷ 128 ≈ 3,514 B (MHA의 약 1/1,119)더 알아보기: V4-Flash 캐시 형식의 구성
main KV entry: RoPE 아닌 448차원 × 1 B (FP8 E4M3) + RoPE 64차원 × 2 B (BF16)
              + 64채널마다 UE8M0 scale 1 B × 7 + 패딩 1 B = 584 B
검색용 key:  128차원 × 0.5 B (FP4 E2M1) + 32채널마다 UE8M0 scale 1 B × 4 = 68 B
형식 이름의 E와 M 뒤 숫자는 지수와 가수의 비트 수이고, UE8M0은 2의 거듭제곱만 나타내는 8비트 scale입니다.
여기에 local KV 캐시가 별도로 있습니다. 43층 모두 최근 128개 위치의 KV를 압축 없이 보관합니다. 배포 형식으로 43 × 128 × 584 B ≈ 3.2 MB입니다. 이 값은 최근 128위치가 찬 뒤에는 더 늘지 않습니다. 그러나 토큰당 증가량이 작아진 만큼 상대적으로 커졌습니다. global KV를 토큰당 증가량 × 문맥 길이로 근사하면, 둘이 비슷해지는 문맥 길이는 약 900토큰입니다. 그보다 짧은 문맥에서는 local KV 캐시가 더 큽니다. 압축 블록의 반올림과 압축 중간 상태는 제외한 근사입니다.
읽는 양(그림 11의 오른쪽 그래프)도 줄었습니다. attention이 읽는 KV는 약 21.5 MB, indexer가 읽는 key는 약 46.8 MB입니다. KV는 (CSA 21층 × (고른 512 + window 128) + HCA 20층 × (N/128 + 128) + SWA 2층 × 128)개 캐시 항목에 항목당 584 B를 곱한 값입니다. 압축 entry와 압축하지 않은 window 위치가 같은 형식으로 저장되기 때문입니다. 검색용 key가 4배 압축되고, indexer를 쓰는 층이 21개뿐이며, key 하나도 132 B에서 68 B로 작아져서 V3.2의 1.06 GB보다 훨씬 작습니다. HCA 층은 압축 entry를 모두 읽으므로, 이 부분은 문맥에 비례해 계속 늘어납니다.
DeepSeek-V4.1-Flash
V4.1은 CSA2로 압축과 선택을 바꾸고, 층 사이에서 KV와 선택 목록을 공유합니다. 이로써 global KV를 저장하는 층이 네 개로 줄었고, main KV를 FP4로 저장하는 것도 저장량 감소에 기여합니다. 또 CED(Causal Encoder–Decoder) 구조와 최근 구간을 다시 계산하는 근사 방식으로 prompt 처리 계산을 줄입니다. V4.1-Flash의 40층은 앞의 20층(encoder)과 뒤의 20층(decoder)으로 나뉩니다. 번역 모델의 encoder–decoder와는 다른 구조로, CED 절에서 자세히 봅니다. 그림 20은 그 효과를 보여 줍니다.
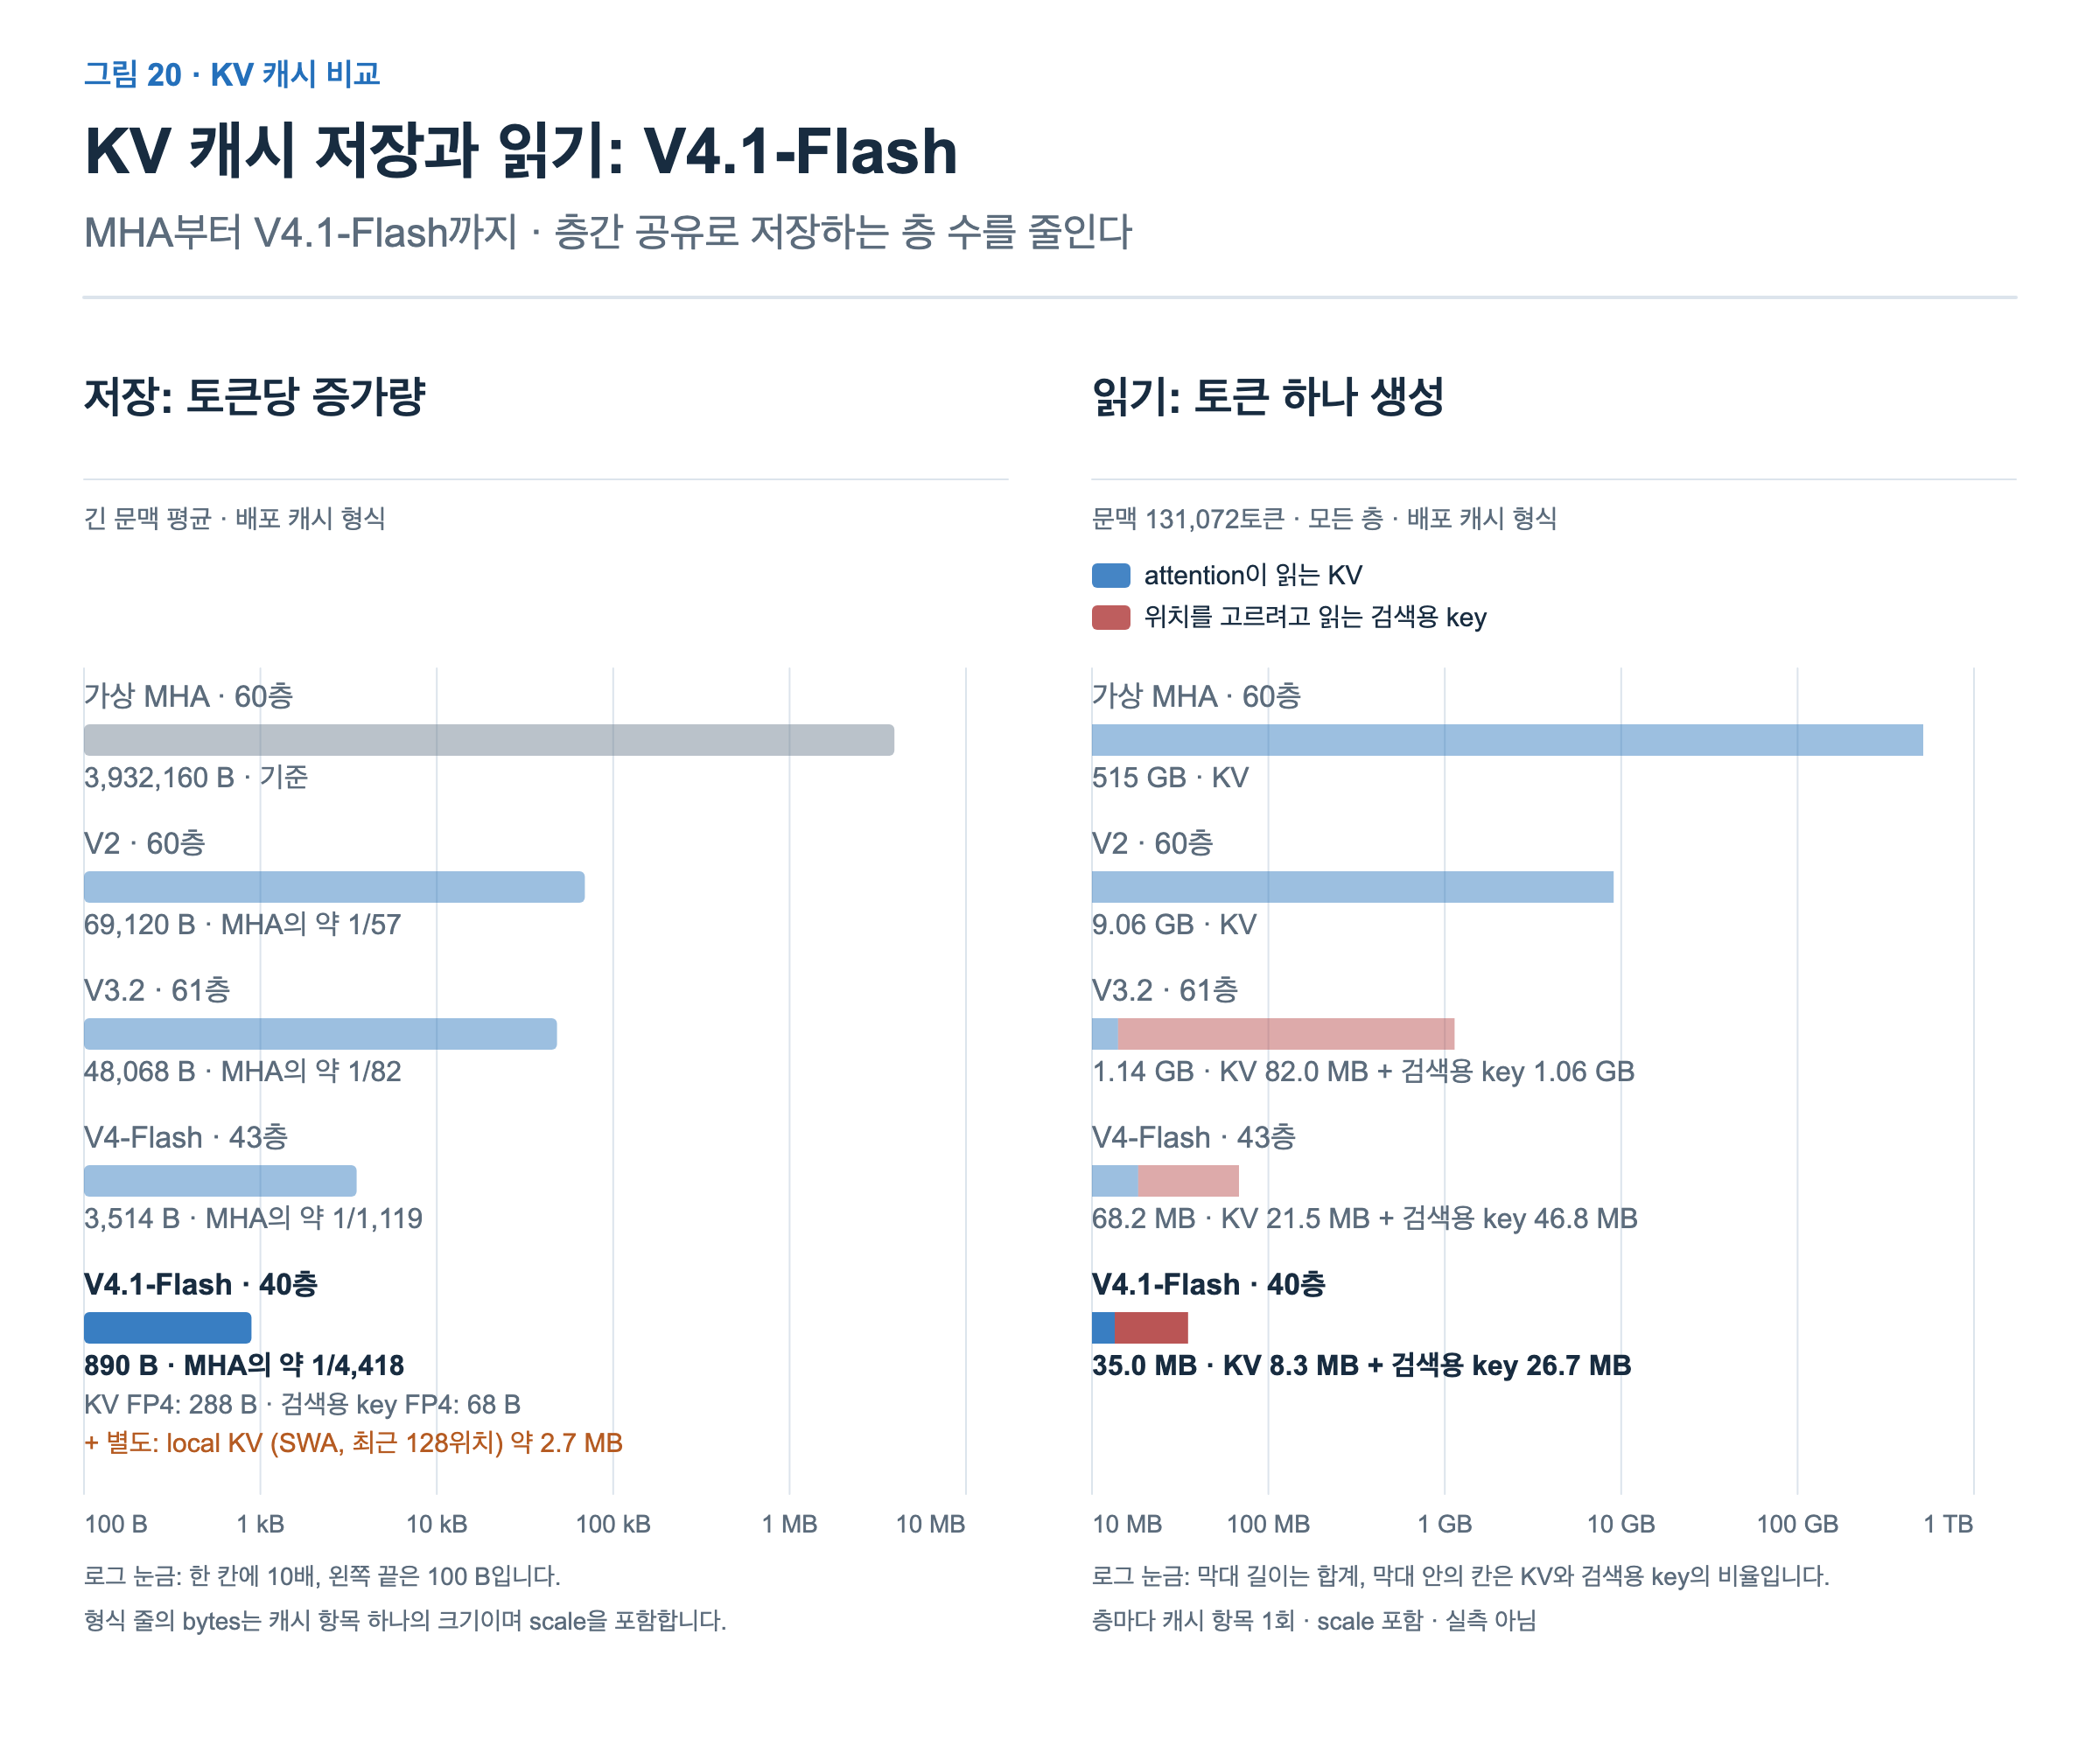
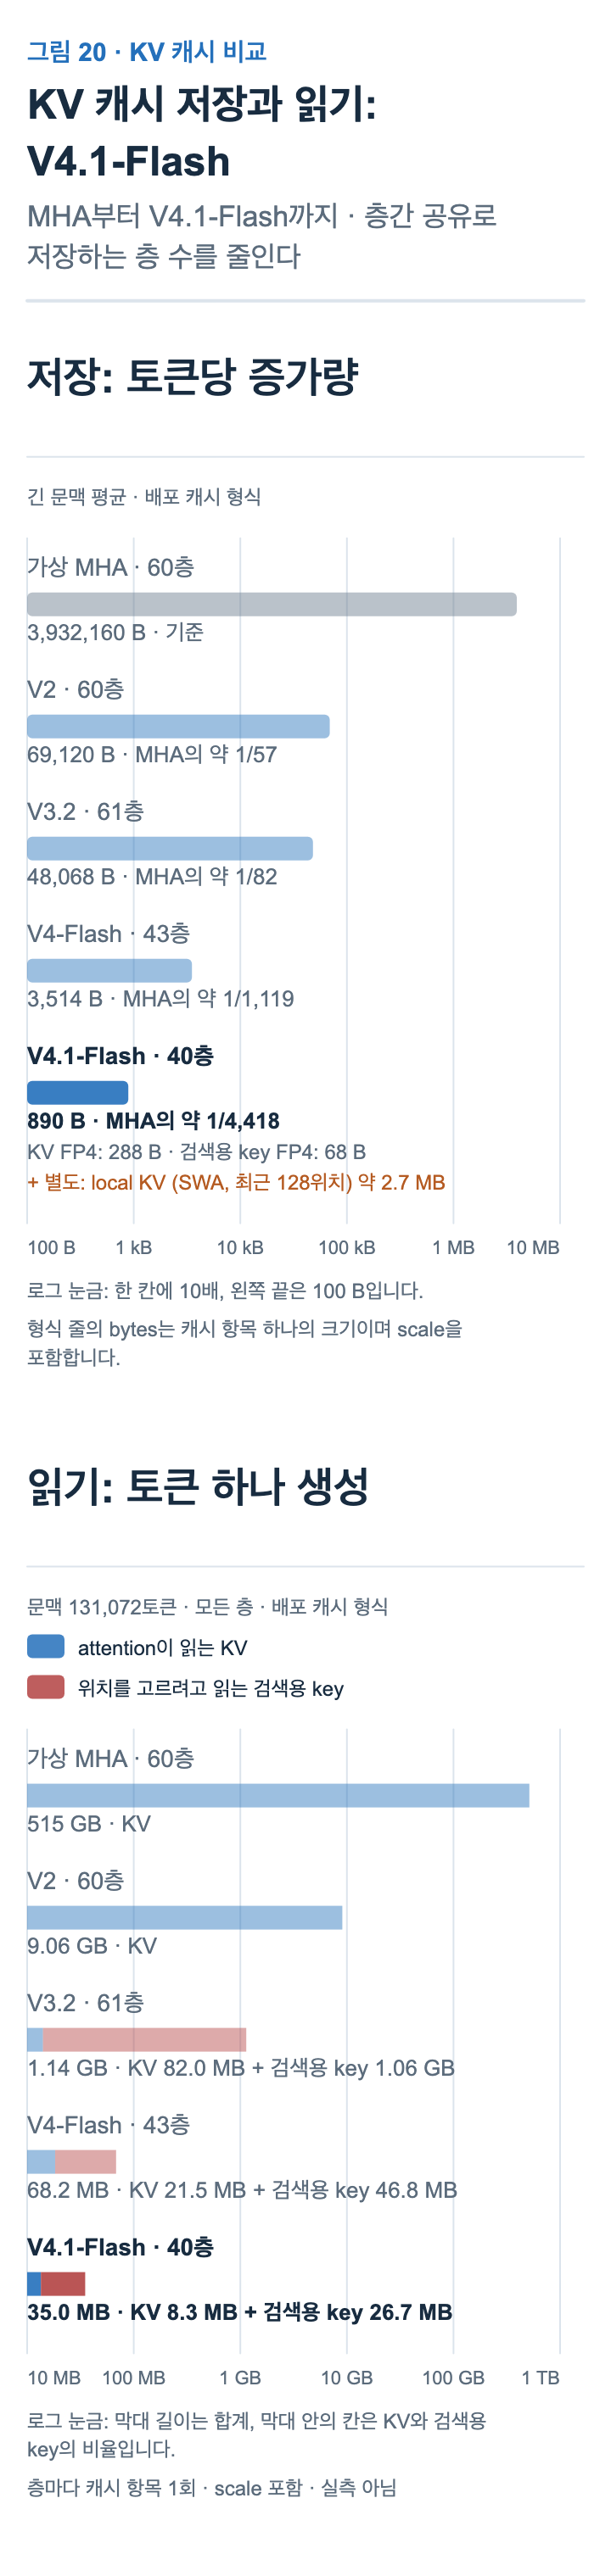
V4.1-Flash는 토큰당 890 B로 가상 MHA의 약 1/4,400입니다.
같은 조건의 읽는 양은 약 35 MB입니다.
CSA2: 겹침 없는 압축과 검색용 key
CSA2는 한 층 안에서 두 가지가 바뀌었습니다. 압축 구간이 겹치지 않게 되었고, 검색용 key를 별도 압축기 대신 main KV에서 만듭니다.
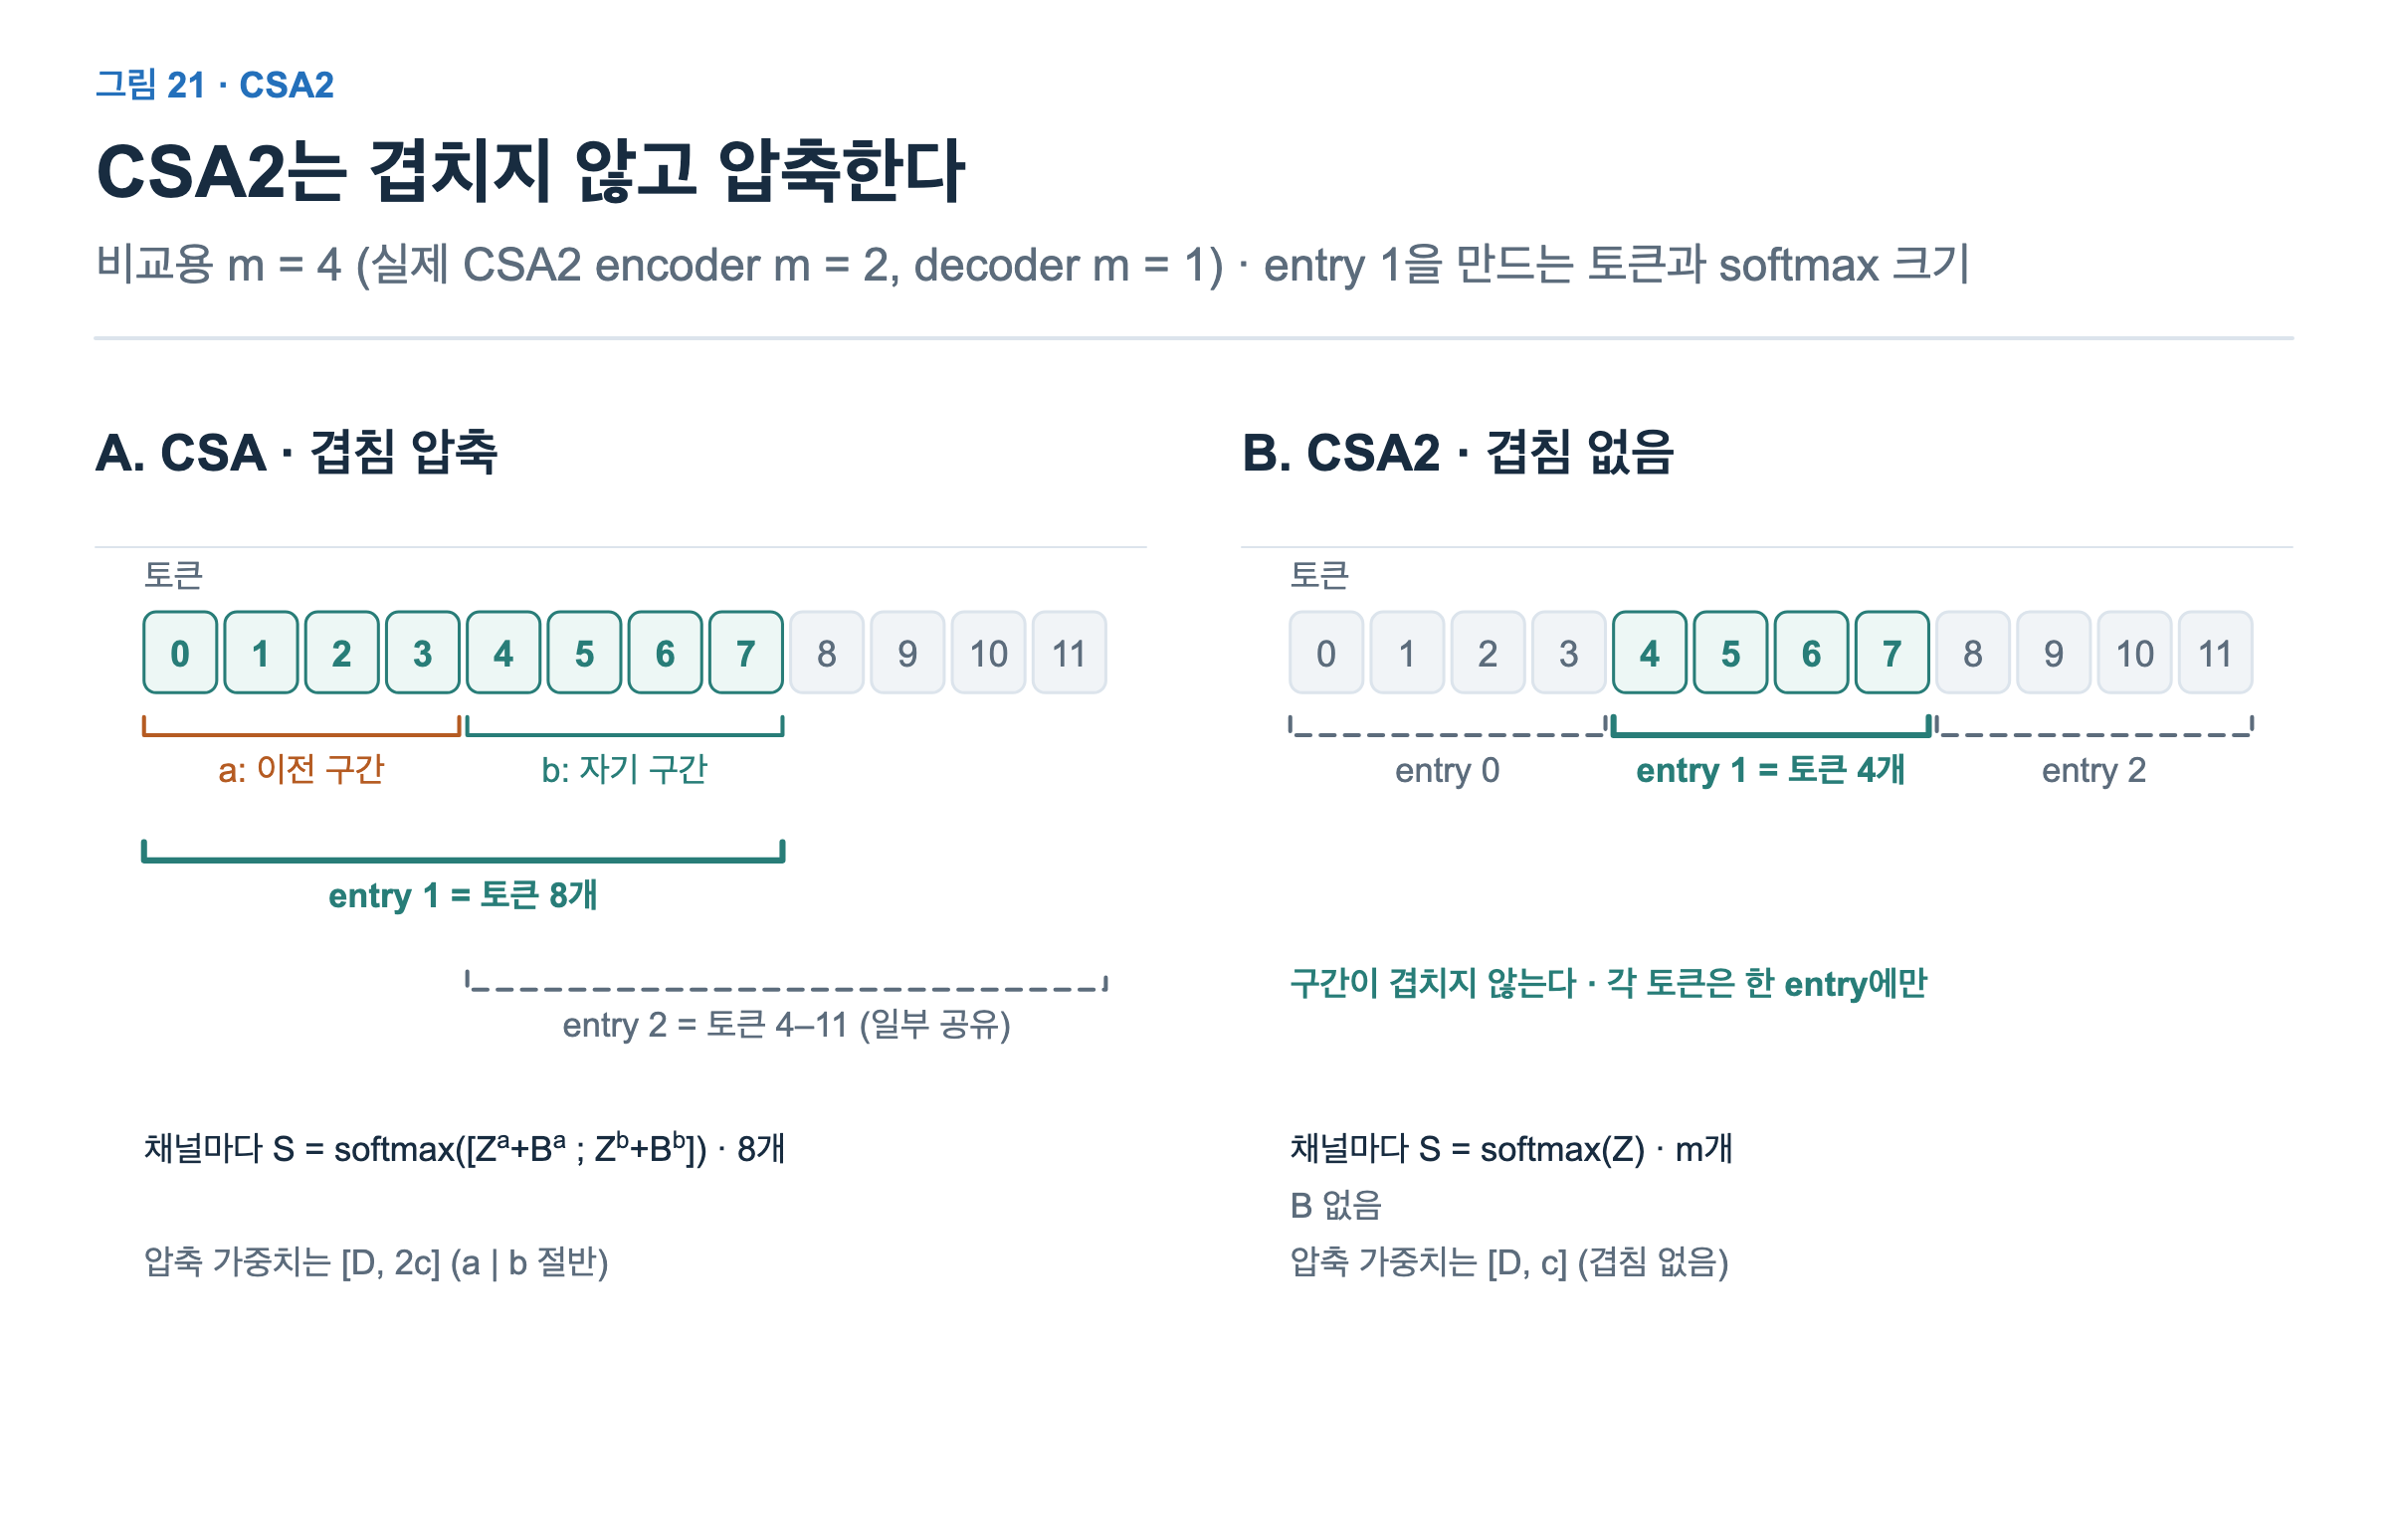
CSA. entry 하나가 자기 구간과 이전 구간을 함께 읽어, 이웃 entry와 토큰을 절반씩 공유합니다.
CSA2. 구간이 겹치지 않아 각 토큰은 entry 하나에만 들어갑니다. 압축기 안의 위치 편향 B도 없앴습니다.
압축률도 낮아졌습니다. 실제 CSA2의 encoder 층은 토큰 2개를 하나로(m = 2), decoder 층은 압축 없이 토큰마다 하나씩(m = 1) entry를 만듭니다. 그림 22의 ’풀링’은 그림 13에서 본 채널별 가중 평균과 같은 압축입니다. m = 1이면 풀링할 토큰이 하나뿐이라, 그림 22의 풀링 단계는 그 토큰을 그대로 통과시킵니다.
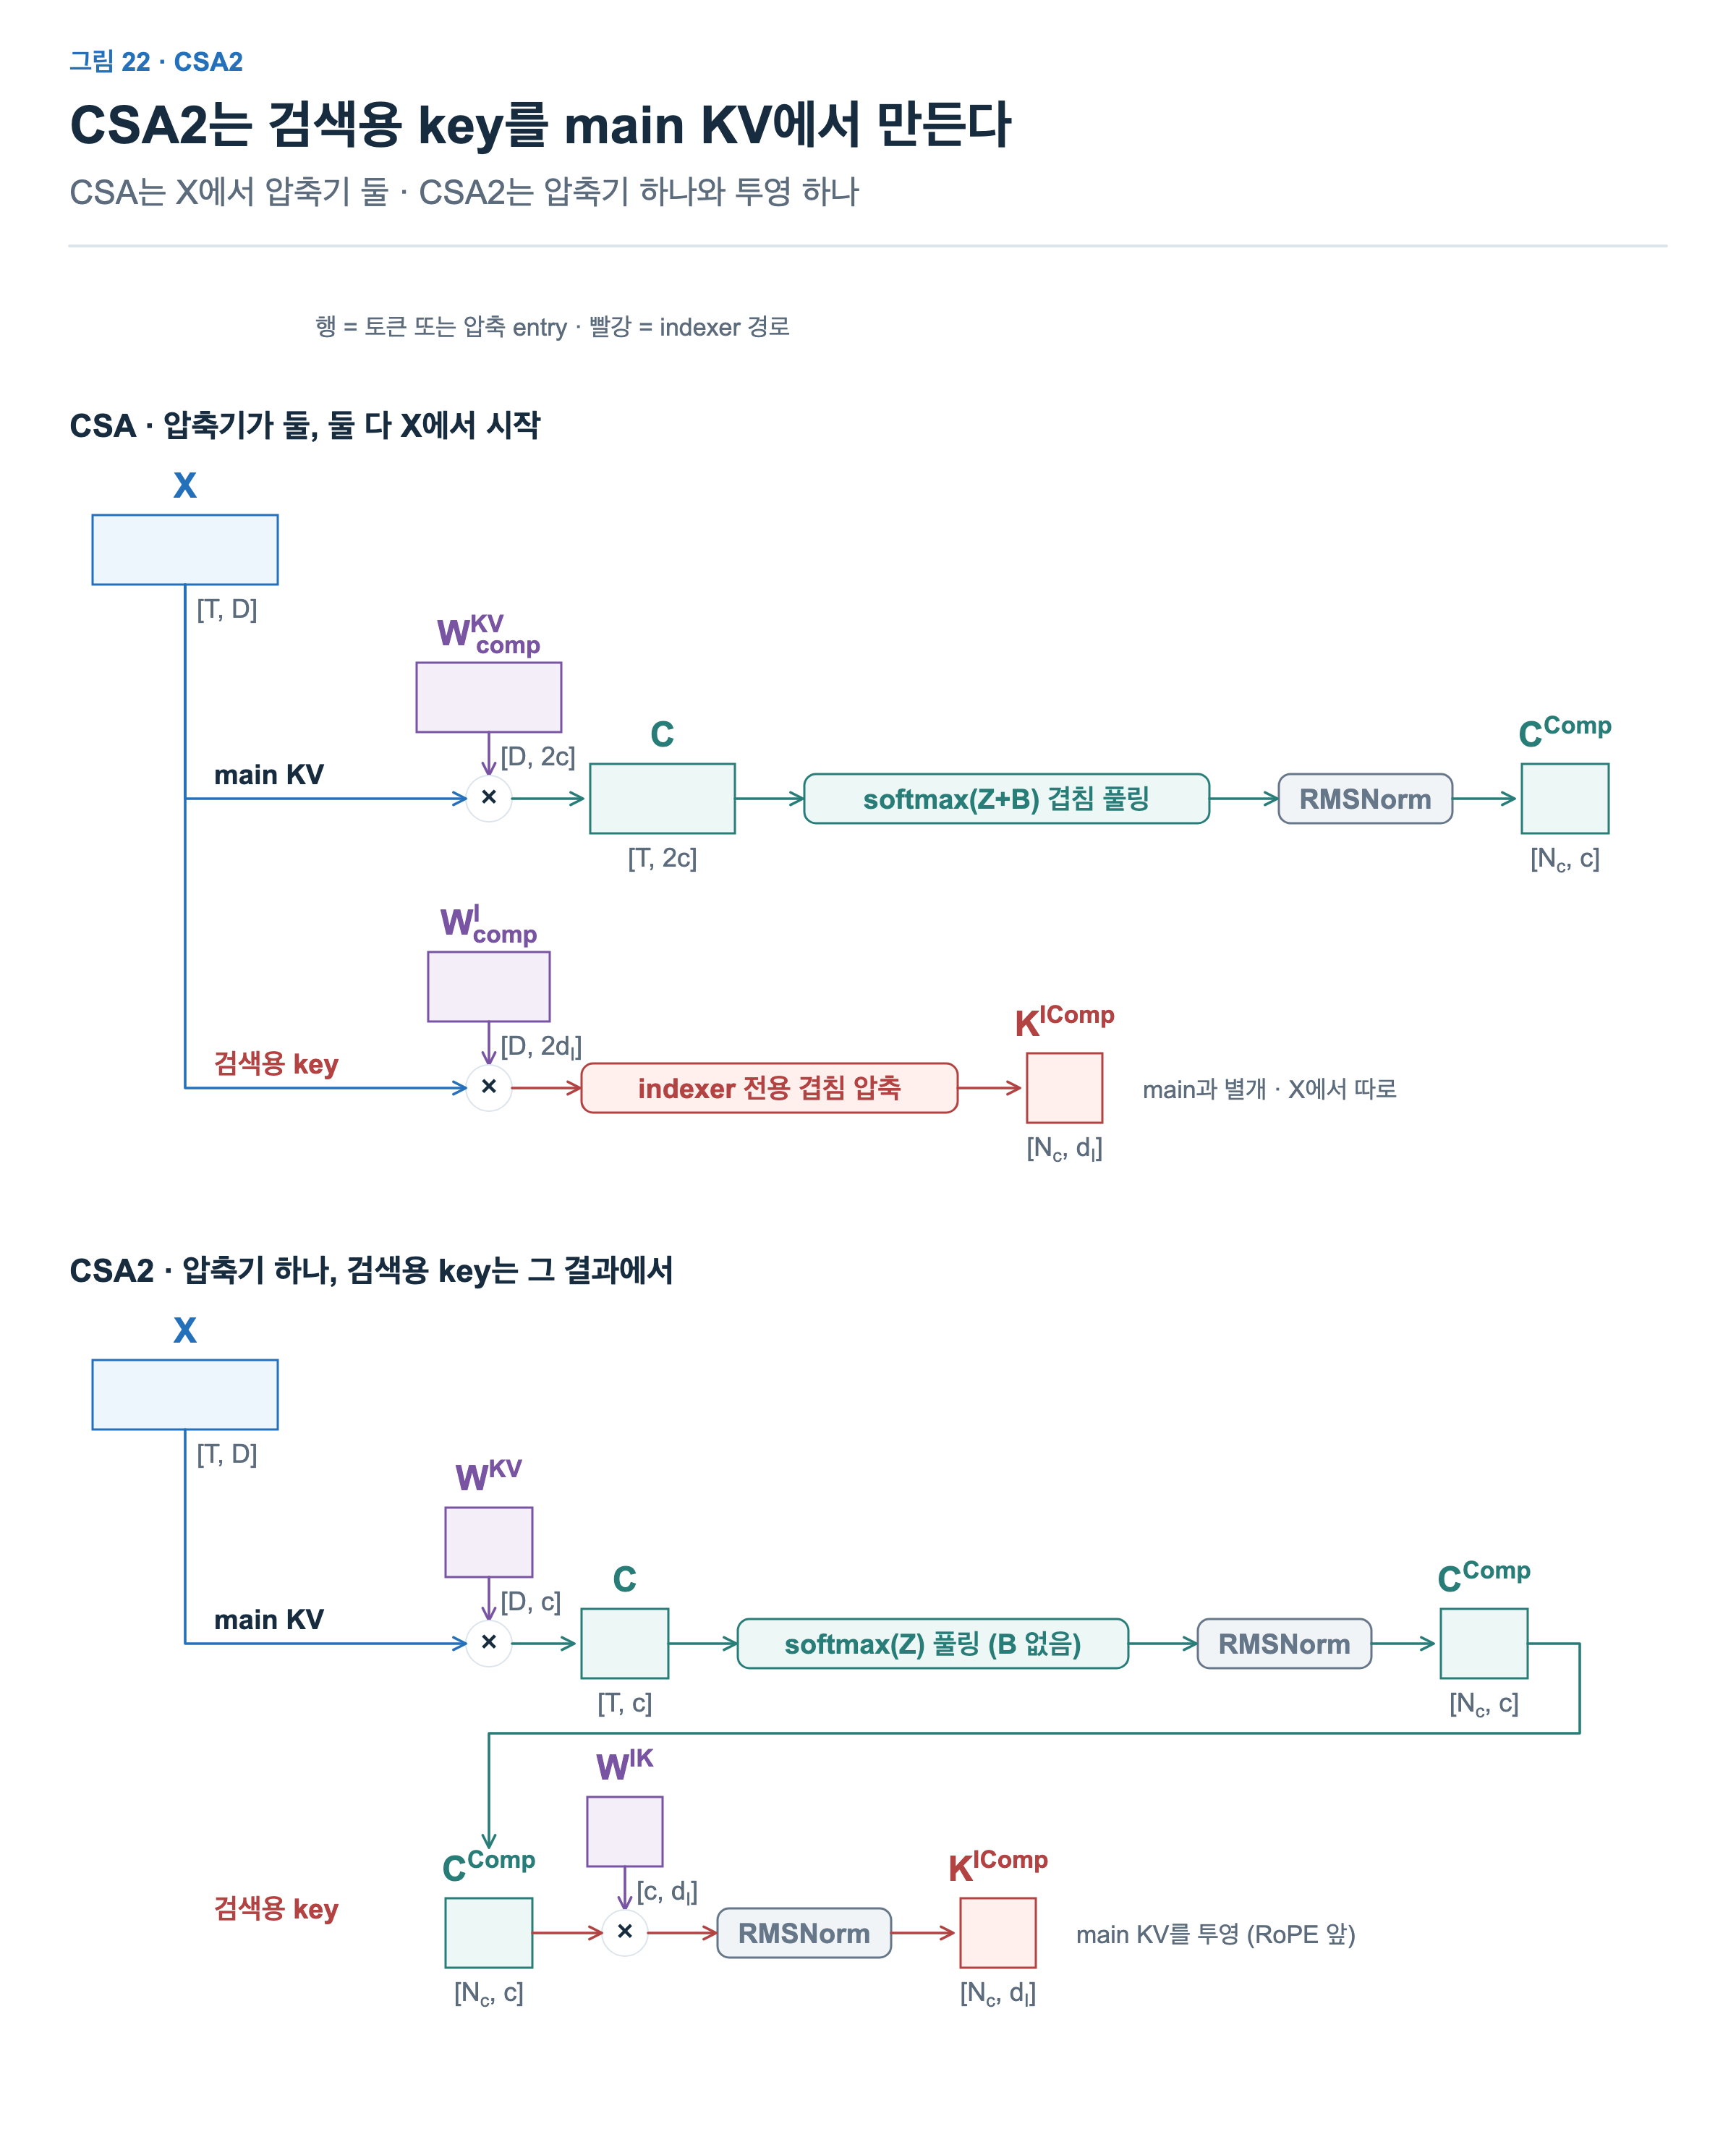
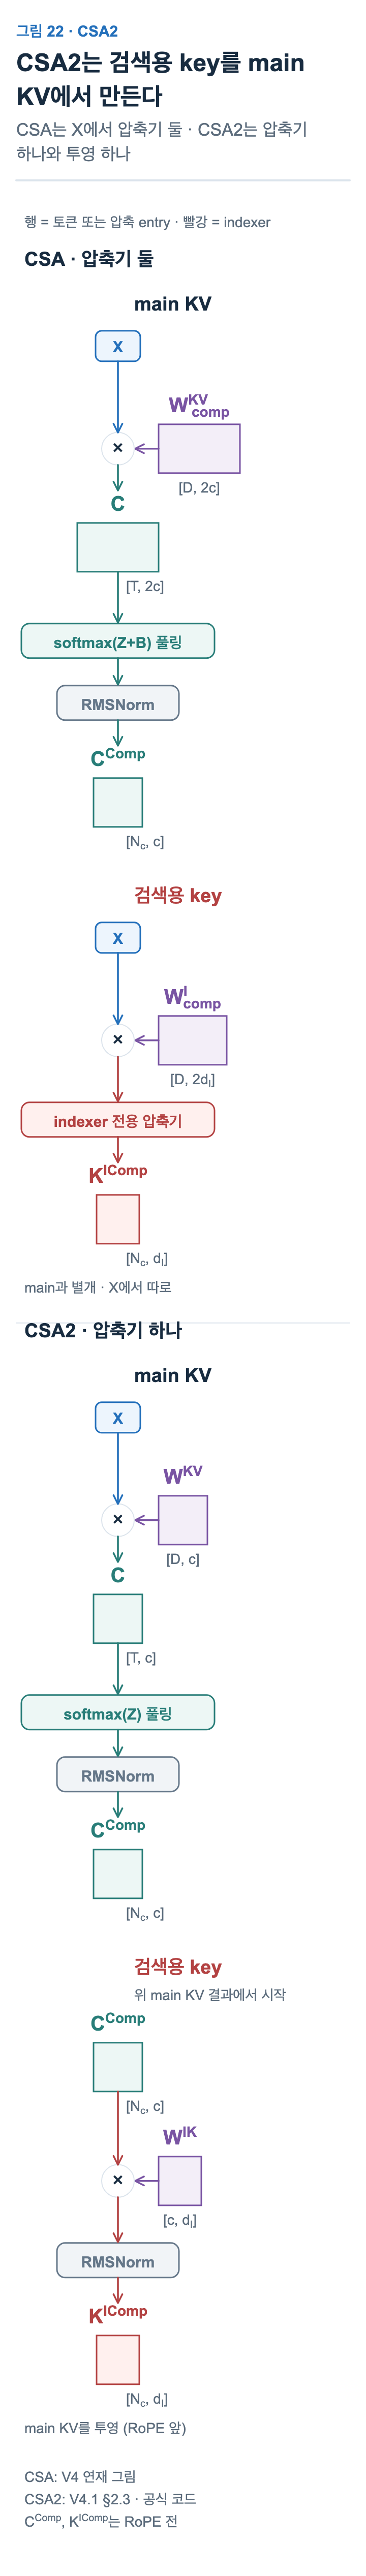
CSA. 같은 입력에서 압축기를 두 번 돌려 main KV와 검색용 key를 따로 만들었습니다.
CSA2. 압축기를 하나만 두고, 압축과 RMSNorm을 마친 RoPE 적용 전 값을 투영하고 정규화해 검색용 key를 만듭니다. 그 뒤 main KV와 검색용 key에 각각 RoPE를 적용합니다. 그림의 Nc는 완성된 압축 entry 수로, 그림 18의 Ns와 같은 뜻입니다. 그래서 그림 22의 CComp만 RoPE 적용 전 값이고, 다른 그림의 CComp는 RoPE까지 마친 entry입니다.
두 값이 같은 entry에서 나오므로, 뒤에서 볼 층간 공유에서 함께 넘기기 쉬워집니다.
층끼리 KV 나눠 쓰기: Full, Reindex, Reuse
지금까지는 층마다 자기 KV를 저장했습니다. V4.1-Flash에서는 네 Full 층이 global KV를 만들어 저장하고, 나머지 CSA2 층은 이를 공유합니다. 처음 두 층은 SWA만 쓰며, local KV는 40층 모두 각자 만듭니다.
CSA2의 각 층은 세 모드 중 하나로 고정되어 있습니다.
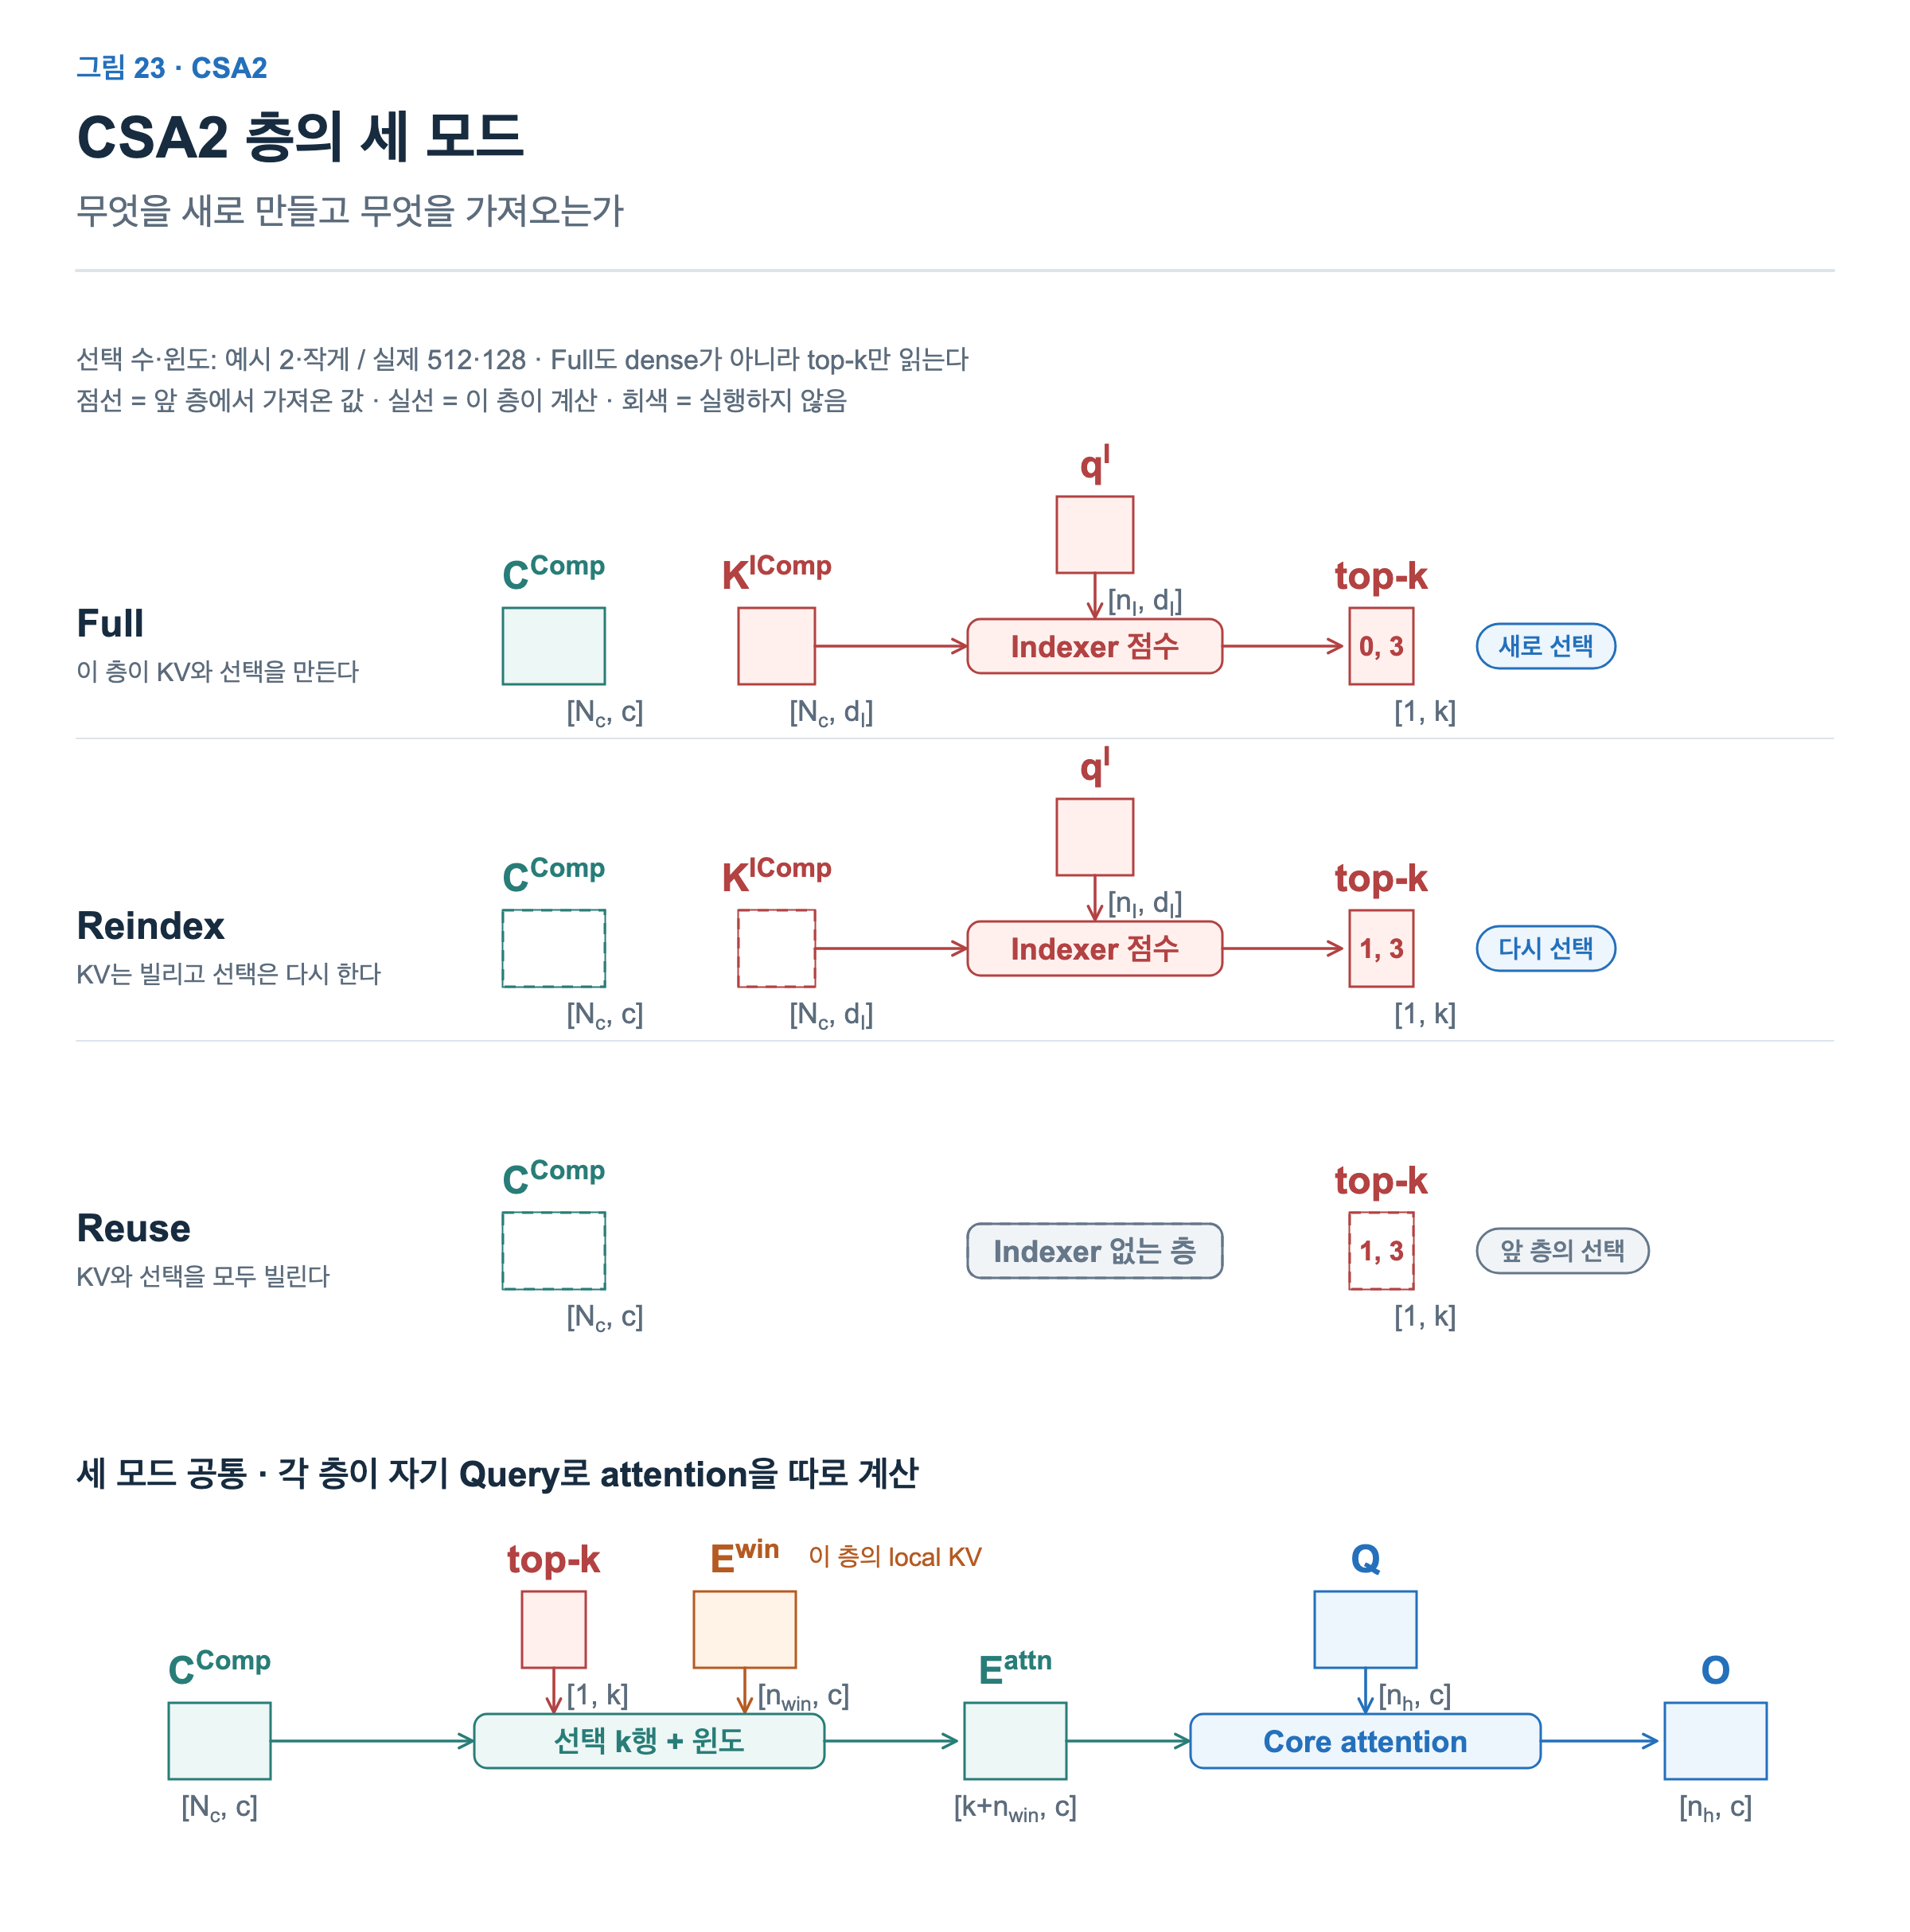
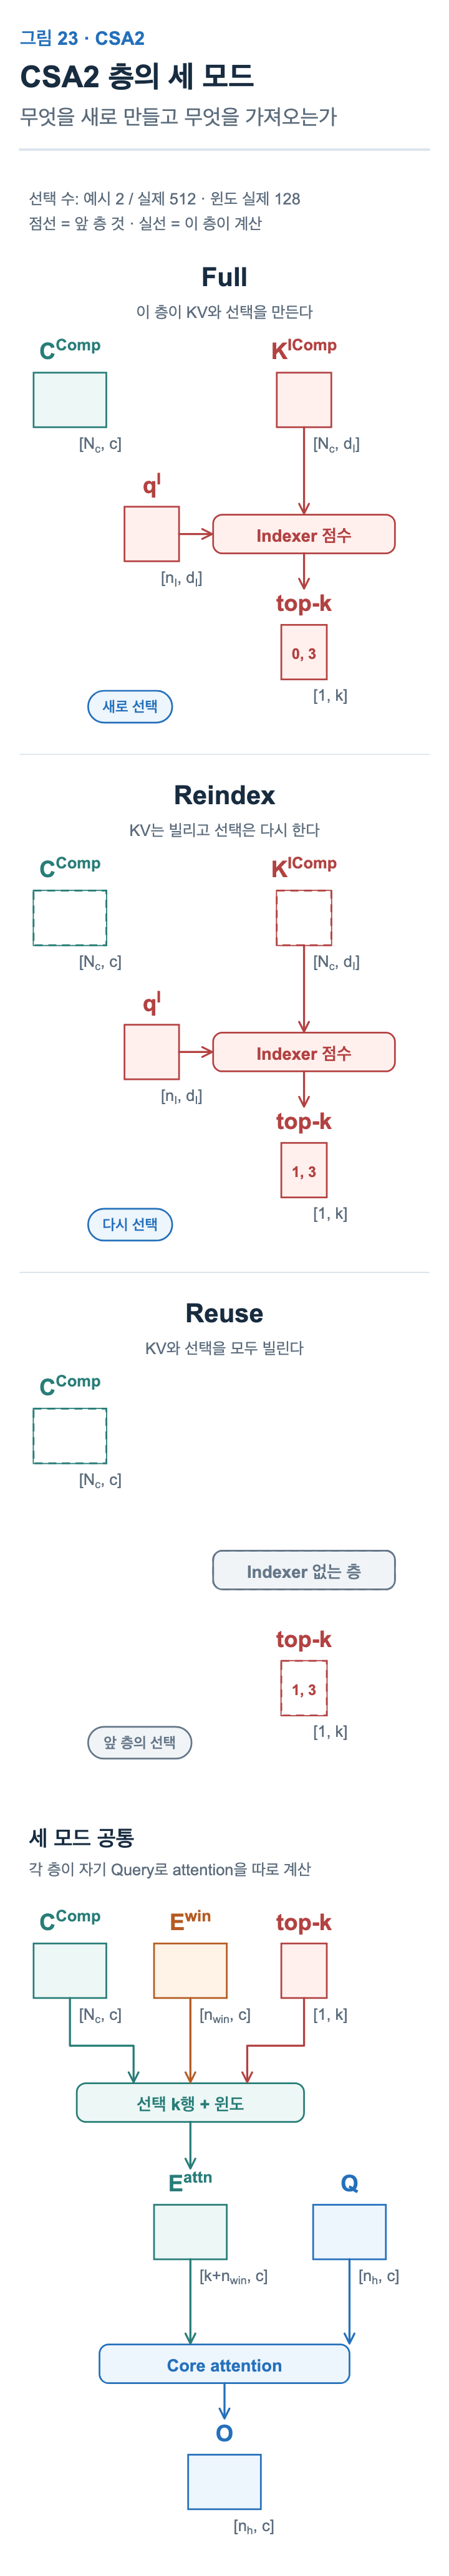
Full 층은 main KV와 검색용 key를 새로 만들고, 자기 indexer로 top-k를 고릅니다. global KV를 저장하는 층은 Full 층뿐입니다. Full도 모든 위치를 읽는 dense attention이 아니라 top-k만 읽습니다.
Reindex 층은 가까운 Full 층의 main KV와 검색용 key를 빌리고, 자기 indexer query로 위치를 다시 고릅니다.
Reuse 층은 indexer가 없습니다. main KV와 선택 목록을 모두 앞 층에서 빌립니다.
세 모드 공통. 고른 main KV 행과 이 층의 local KV를 이어 붙이고, 이 층의 Query로 attention을 계산합니다. 그림은 한 번만 그렸지만 모든 층이 각자 계산합니다.
공유하는 것은 global KV와 선택 목록이지 attention의 결과가 아닙니다. 층마다 표현이 다른데도 공유가 성립하는 것은, 모델이 처음부터 이 공유 구조로 학습되기 때문입니다. 층간 공유의 원리는 층간 KV 공유 글에서 다뤘습니다.
앞에서 말한 encoder 20층과 decoder 20층의 배치는 그림 24와 같습니다.
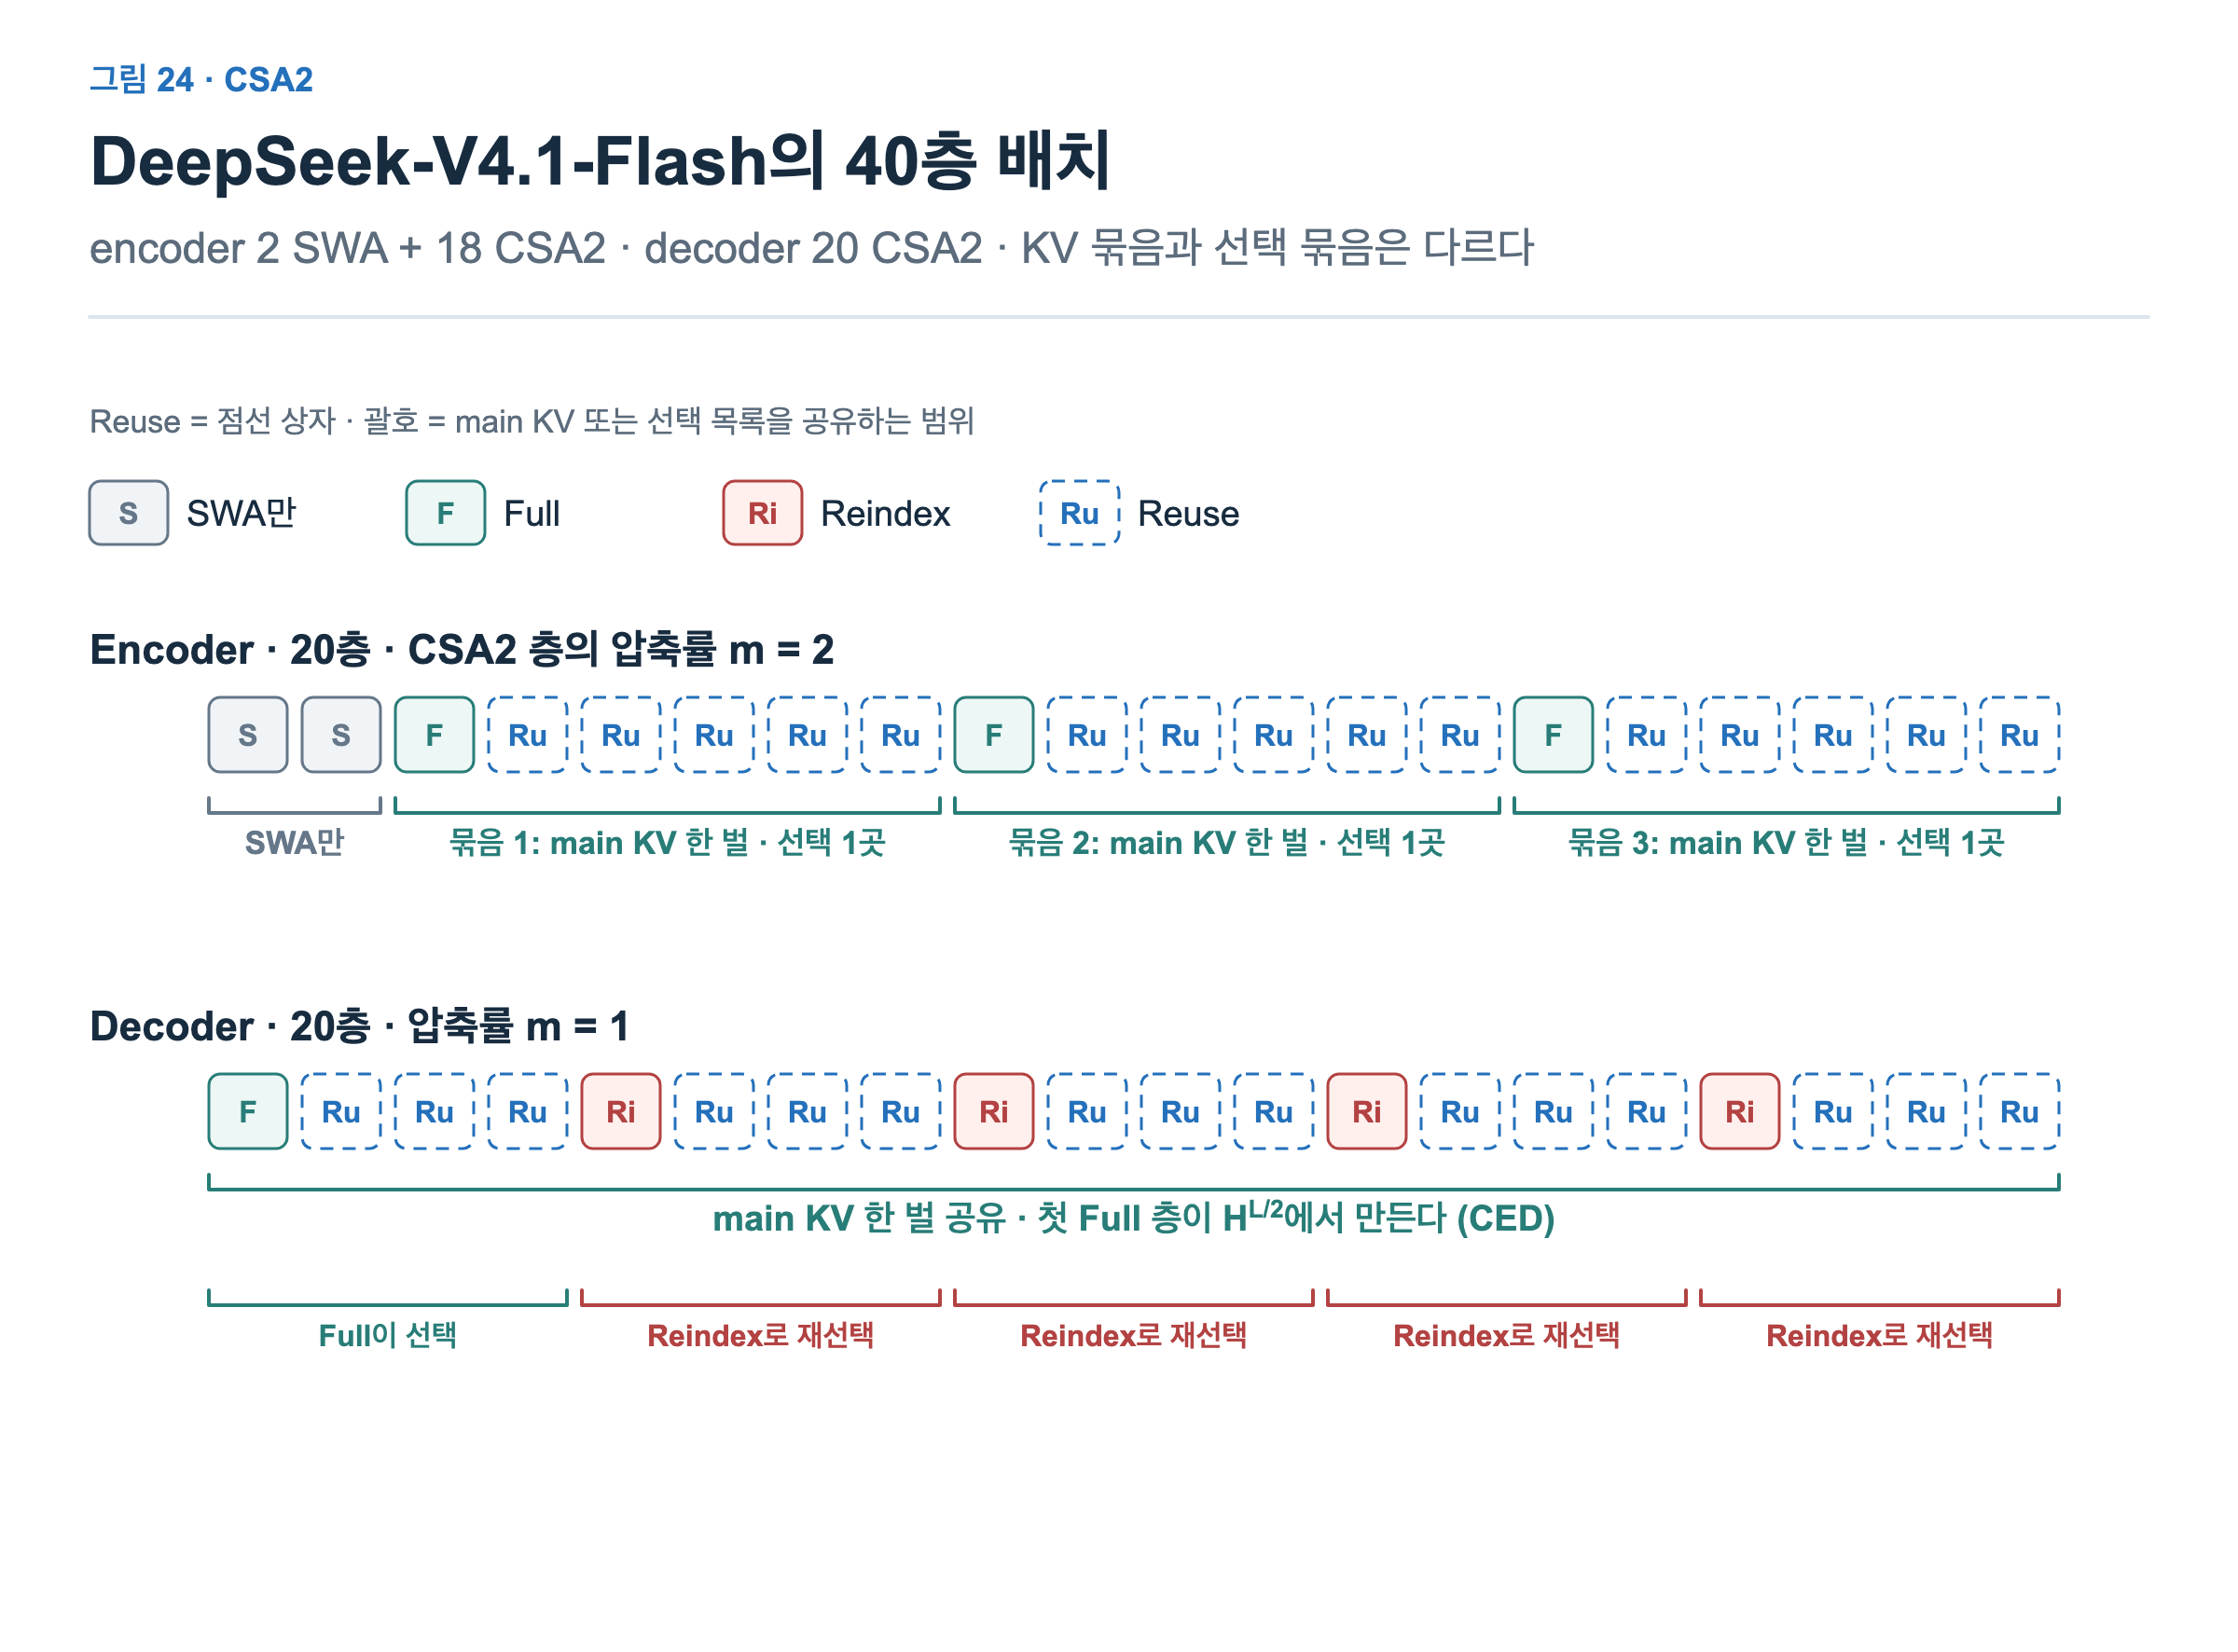
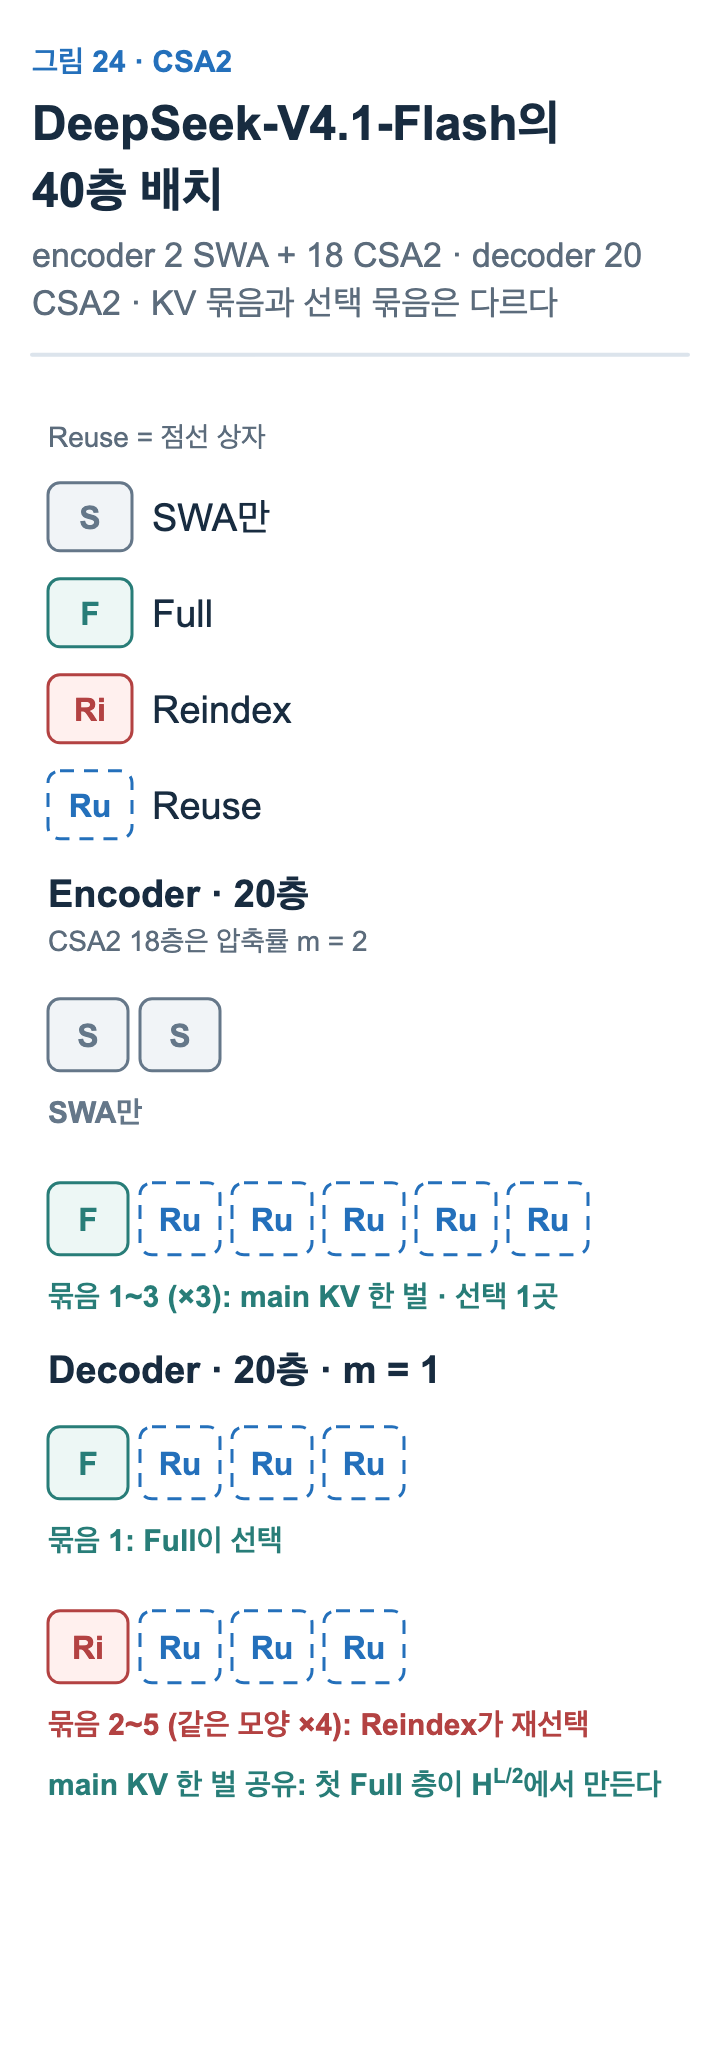
encoder. 처음 2층이 SWA만 쓰고, 나머지 18층이 [Full, Reuse×5] 묶음 세 개입니다.
decoder. 20층의 global KV를 첫 Full 층 하나만 만들고, 네 Reindex 층이 위치를 다시 고릅니다. 그림의 HL/2는 encoder 20층을 지난 출력입니다.
결국 global KV를 저장하는 층은 encoder의 Full 3개와 decoder의 Full 1개, 모두 4개입니다. decoder에서는 계층형 indexer로 고르는 비용도 묶어 둡니다. 그림 25는 보고서가 후속 학습에서 도입한 계층형 선택 방식을 보여 줍니다. 여기서 블록은 압축이 아니라 검색을 위한 묶음입니다. decoder의 main KV는 토큰마다 entry 하나(m = 1)이고, 연속한 8개 entry를 한 블록으로 묶어 블록 안 최댓값 점수로 후보를 고릅니다.
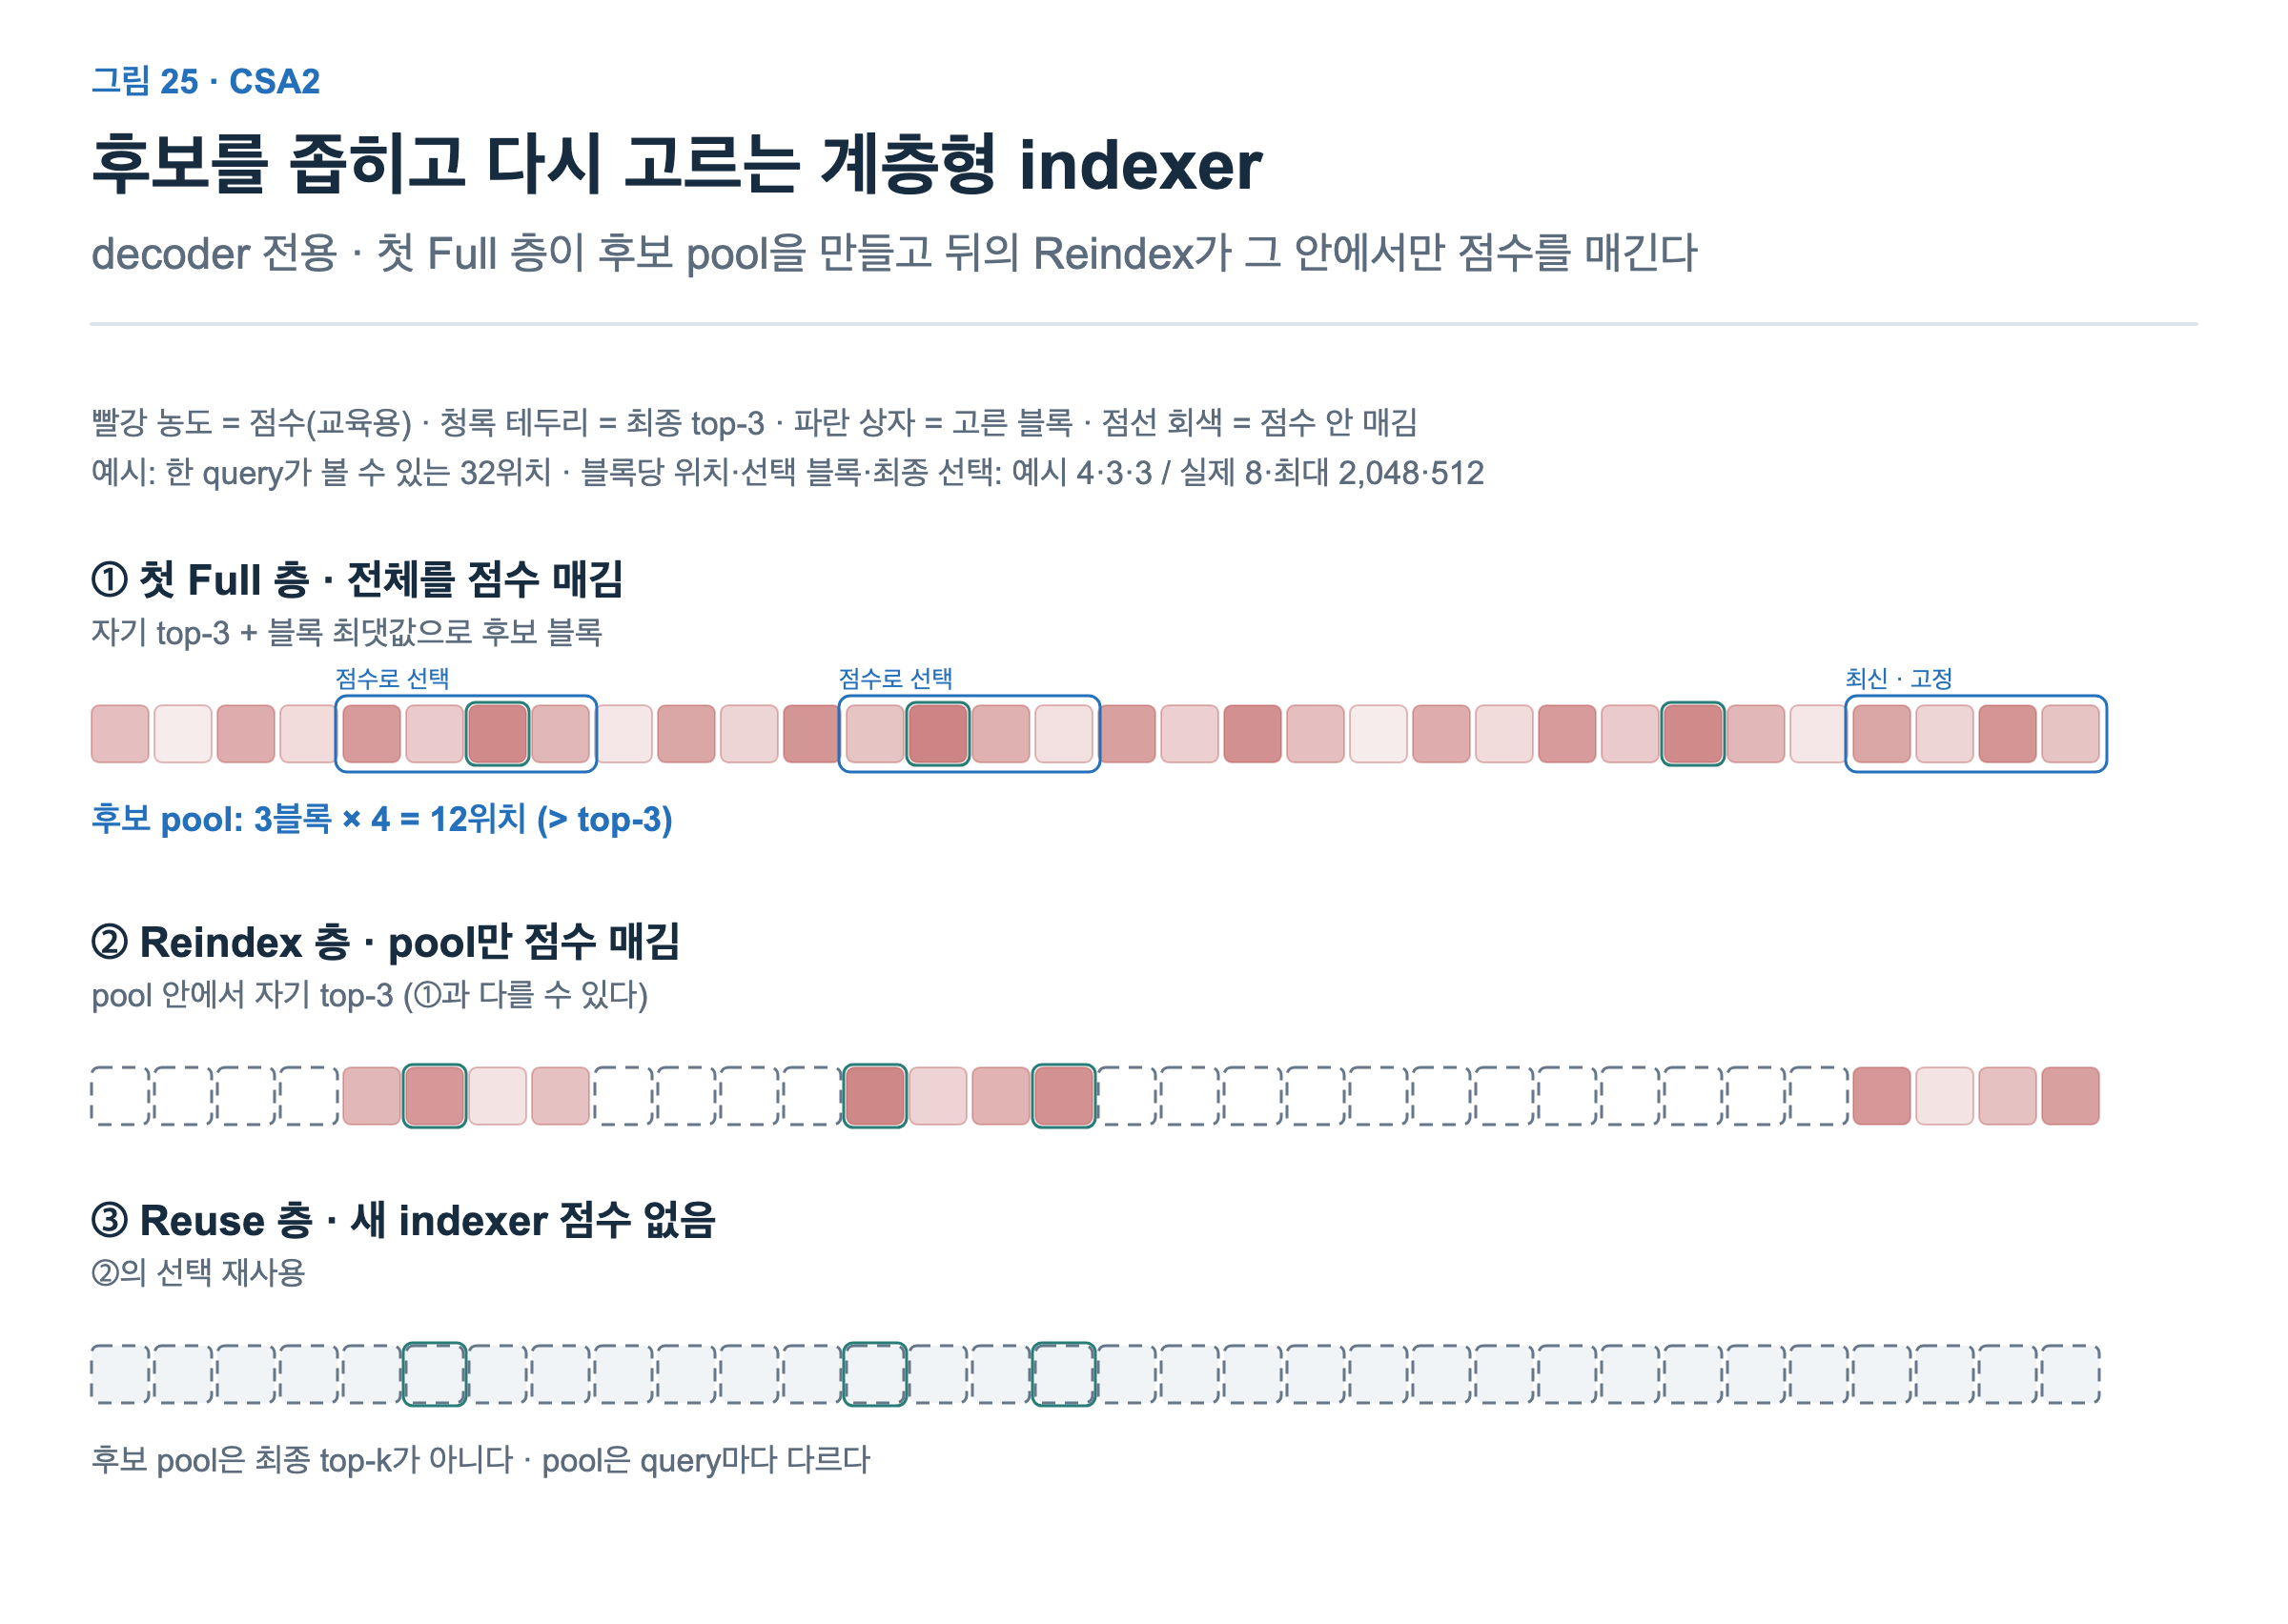
① 첫 Full 층. 모든 위치를 점수 매기며 자기 top-512를 고르고, 동시에 점수가 높은 블록을 골라 후보 pool(query마다 최대 2,048블록 × 8위치 = 16,384위치)을 만듭니다. 그림에서 ’최신 · 고정’으로 표시한, query의 가장 최근 위치가 든 블록은 점수와 관계없이 항상 후보에 넣습니다. 이 블록도 최대 2,048블록 안에 들어갑니다(그림에서는 3블록 중 하나). 첫 Full 층의 top-512는 모든 위치에서 따로 고르므로, 뒤 층에 넘기는 후보 pool 밖의 위치를 포함할 수 있습니다.
② Reindex 층. 이 pool 안에서만 점수를 매깁니다. 문맥 전체를 다시 훑지 않습니다.
③ Reuse 층. 이 예시의 Reuse 층은 ② Reindex 층의 선택을 그대로 씁니다. 일반적으로는 가장 최근 Full 또는 Reindex 층의 선택을 재사용합니다.
첫 Full 층이 전체를 훑는 비용은 남습니다.
CED: decoder의 global KV는 encoder에서
V4.1의 encoder와 decoder는 둘 다 같은 토큰열을 인과적으로 처리합니다. decode에서는 현재 토큰이 encoder 20층을 지난 뒤 decoder 20층을 차례로 지납니다. 이 구조를 CED(Causal Encoder–Decoder)라고 부릅니다. 차이는 decoder 층이 읽는 KV를 어디서 만드느냐에 있습니다.
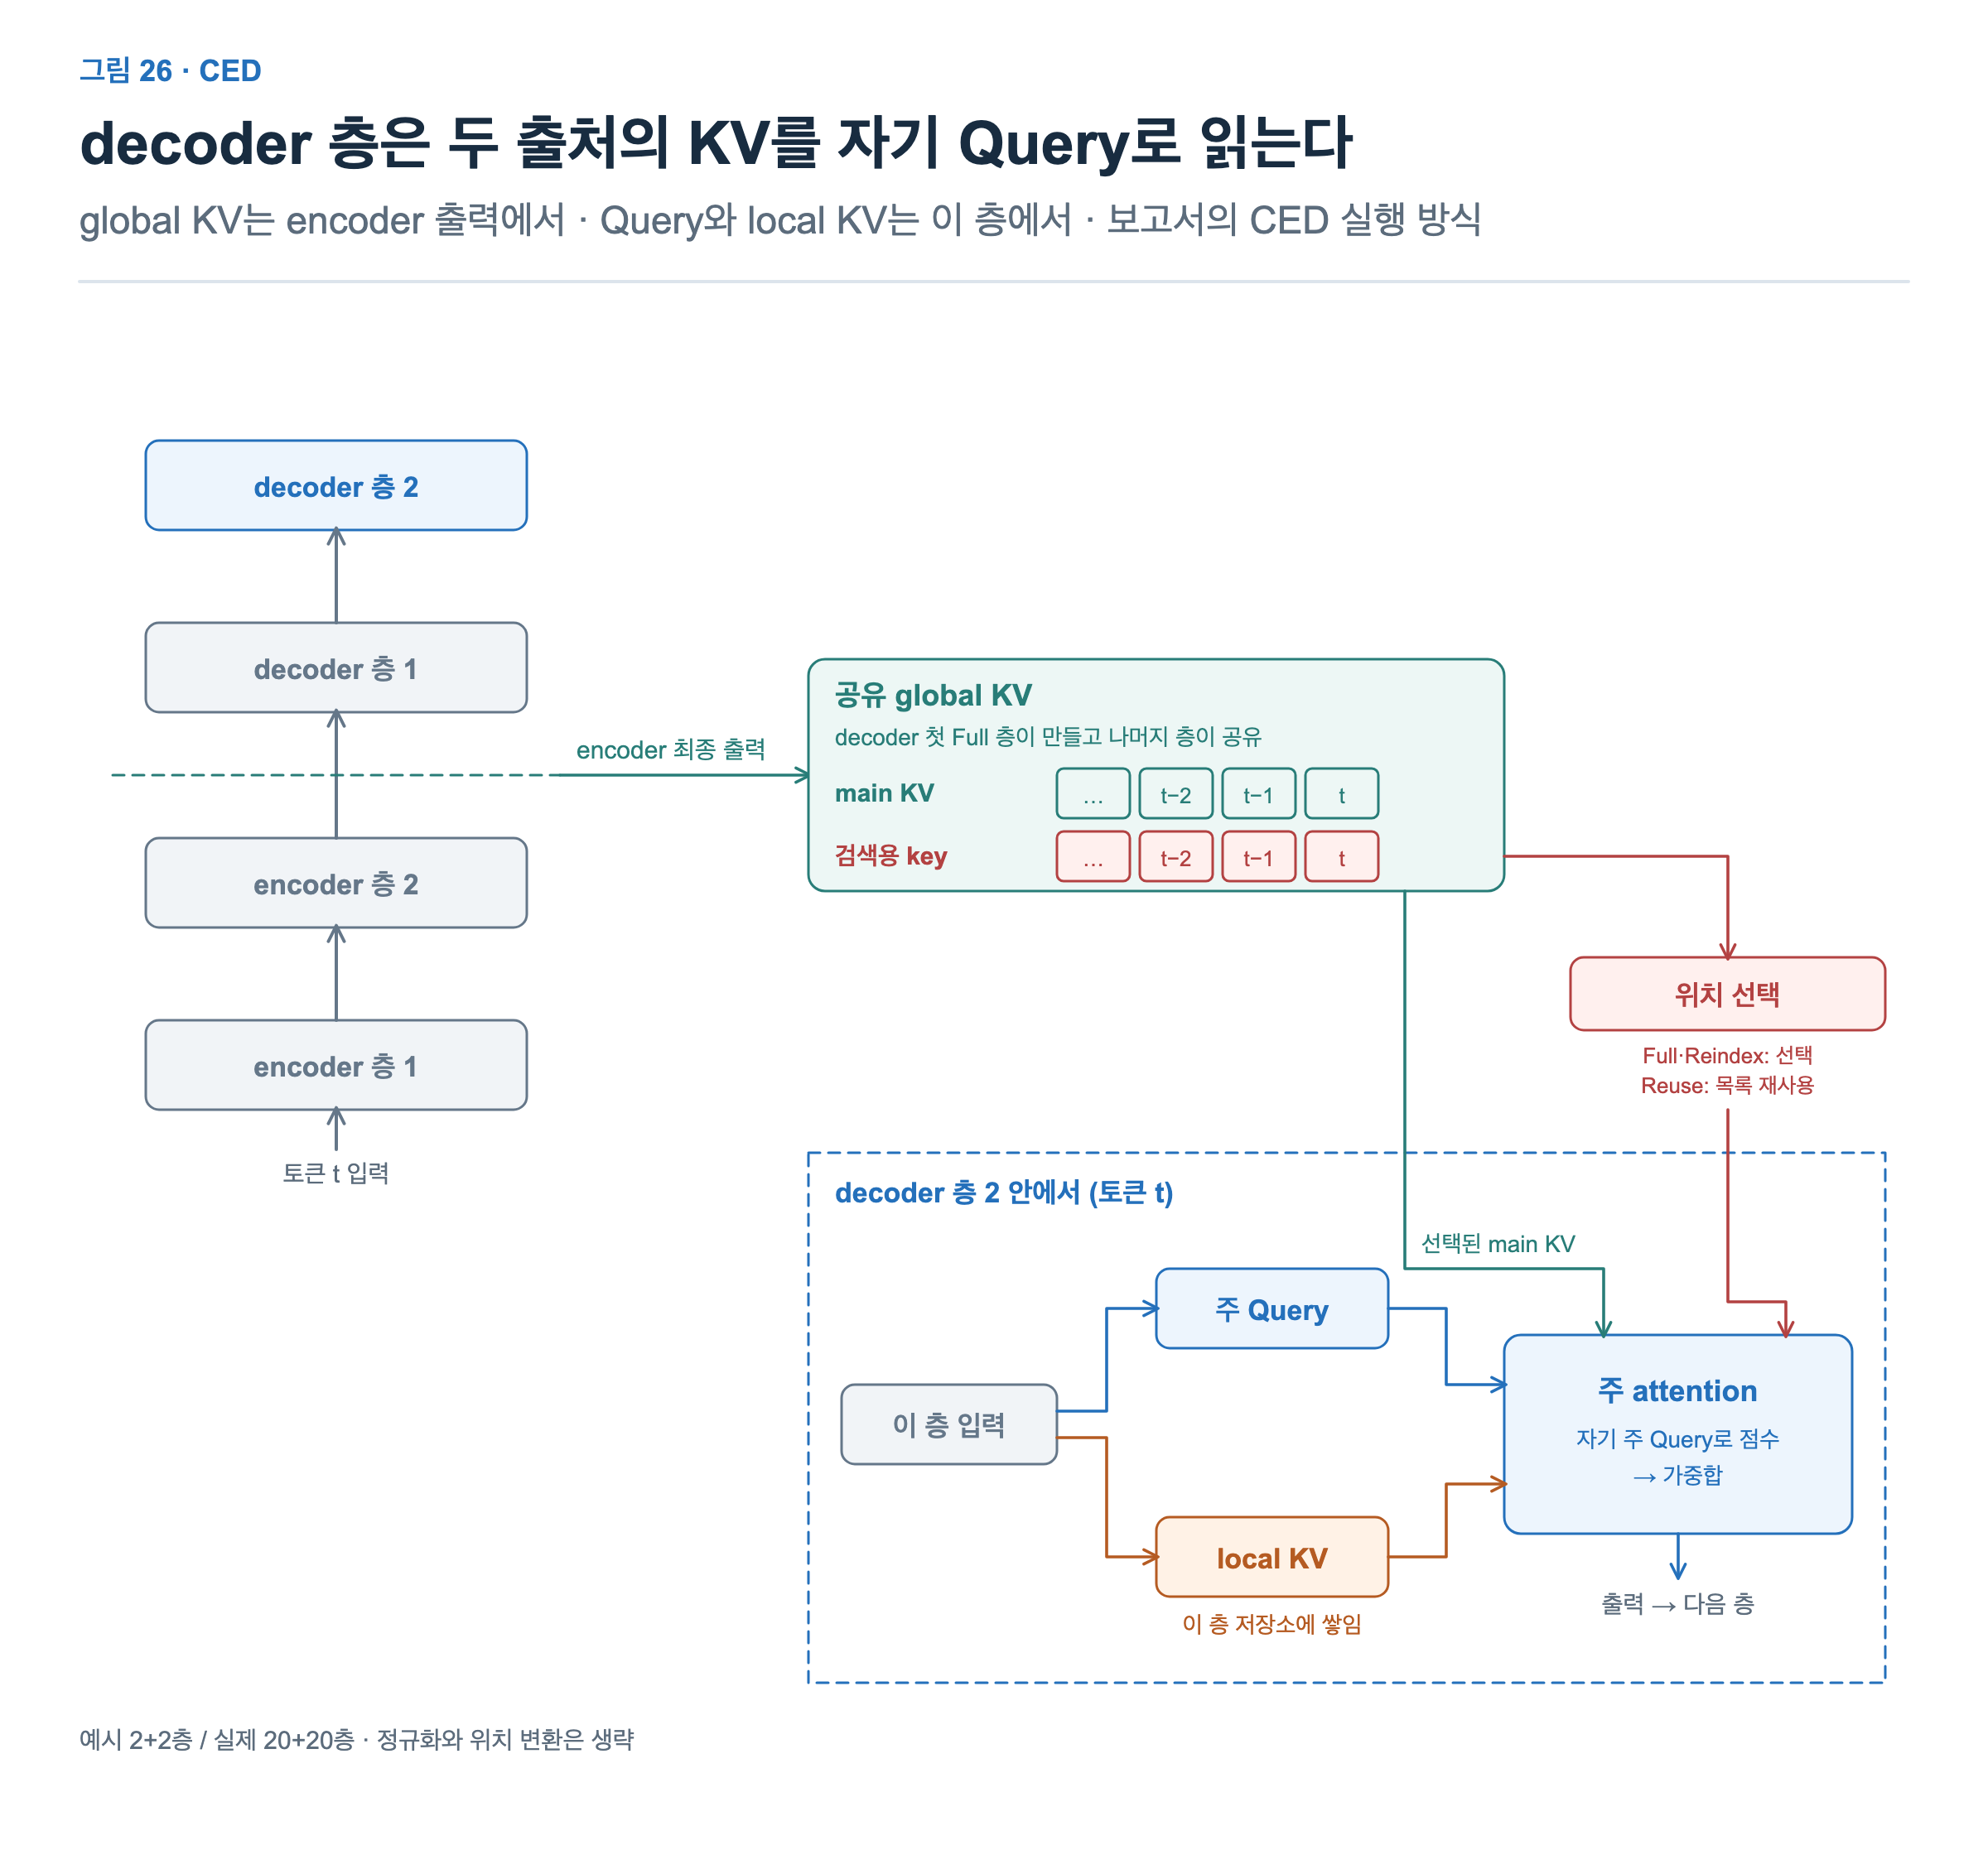
왼쪽: 층 스택. 토큰 t가 아래에서 위로 층을 지납니다. decoder의 global KV(main KV와 검색용 key)는 decoder 자신의 hidden이 아니라 encoder 최종 출력에서 만듭니다. decoder 첫 Full 층이 이 출력을 투영해 만들고, 나머지 decoder 층은 공유합니다.
오른쪽: decoder 층 하나의 안. 이 층은 자기 입력에서 주 Query와 local KV를 만듭니다. 그리고 검색용 key로 고른 위치의 main KV와 자기 local KV를 이어 붙여, 자기 주 Query로 점수를 매기고 가중합합니다. 위치를 고르는 점수는 이와 별도로 Full·Reindex 층이 자기 indexer query로 매깁니다.
global KV를 여러 층이 공유해도 읽는 Query는 층마다 다릅니다.
이 구분 덕분에 prompt를 처리하는 prefill에서 계산을 줄일 수 있습니다.
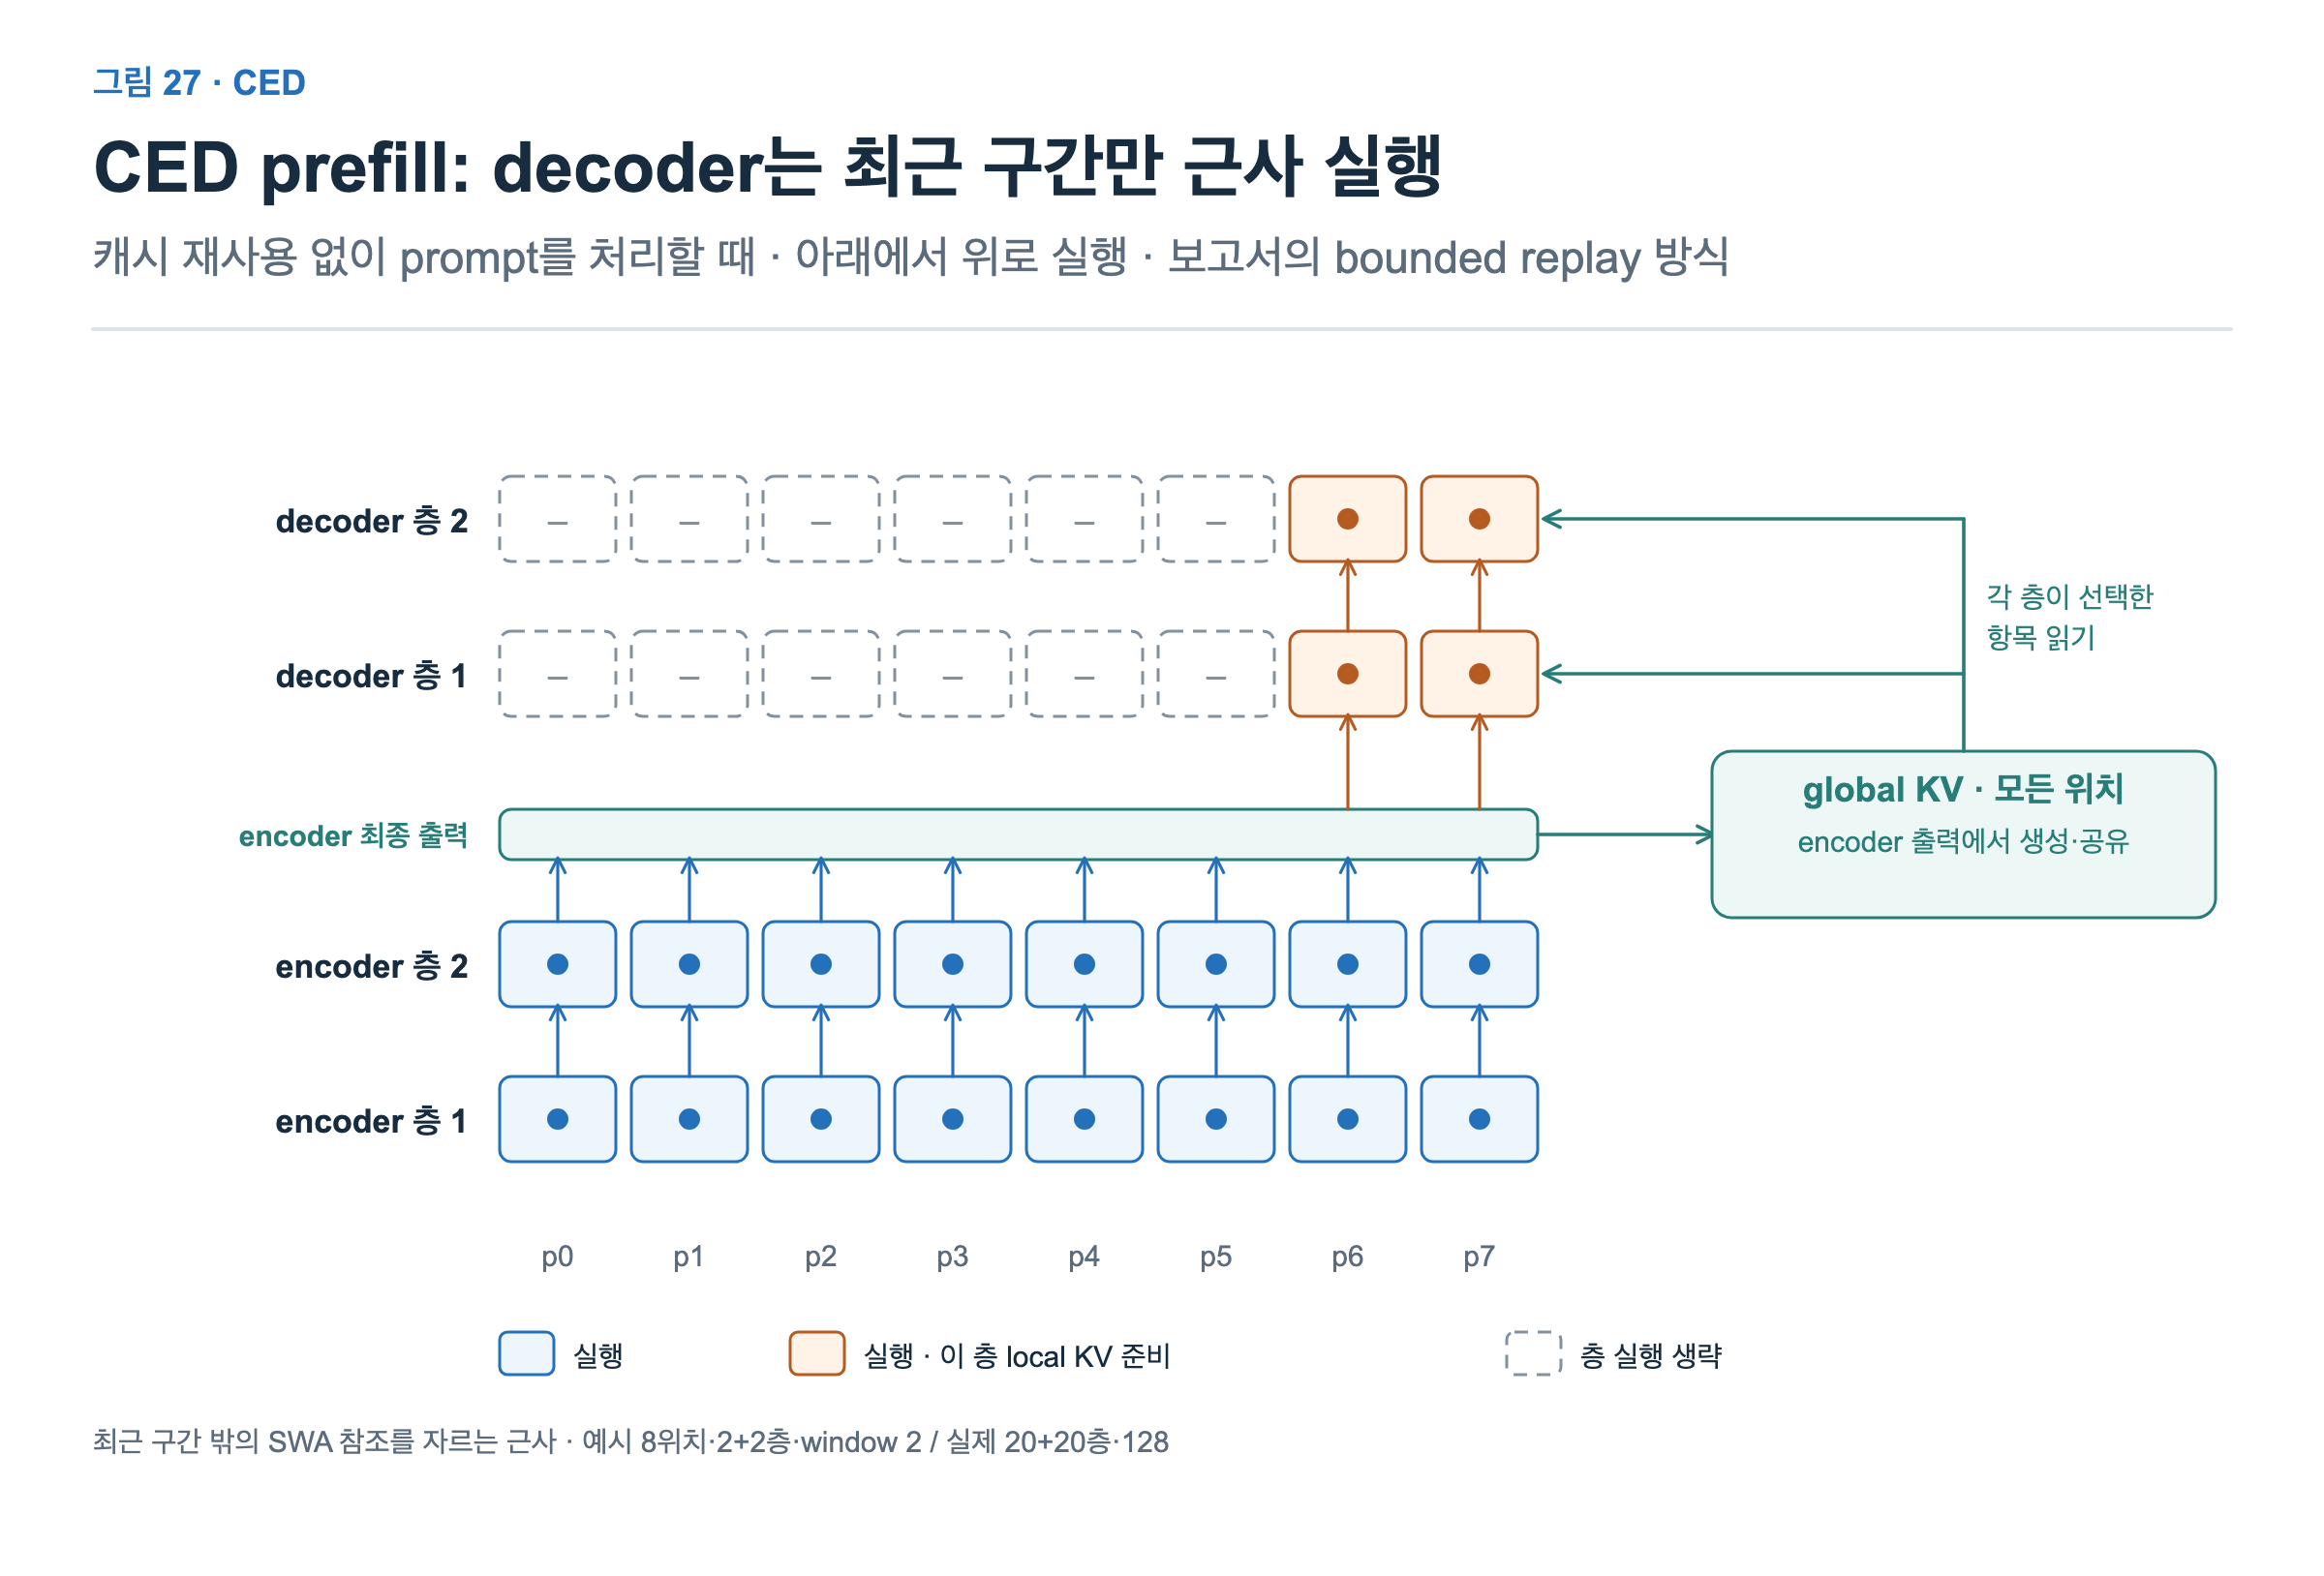
encoder 층은 prompt의 모든 위치를 실행합니다. 그 출력에서 decoder가 읽을 global KV가 모든 위치에 대해 만들어집니다.
그러면 decoder를 실행해 추가로 준비해야 하는 캐시는 각 decoder 층의 local KV뿐이고, local KV는 최근 128위치만 필요합니다. 그래서 decoder 층은 최근 window의 위치만 실행합니다. 보고서는 이 실행을 replay라고 부릅니다. decoder가 그 위치들을 앞서 지난 적은 없지만, 최근 구간만 decoder로 흘려보낸다는 뜻입니다. prompt 마지막 위치의 decoder 출력으로 첫 토큰을 만들고, 그 뒤 decode에서는 40층을 모두 실행합니다.
replay는 KV를 투영만 하는 것이 아니라, 최근 위치들을 decoder 층에 차례로 통과시키며 attention과 FFN까지 실행합니다. 첫 decoder 층은 그 위치의 encoder 출력을, 다음 층은 바로 아래 decoder 층의 출력을 받고, 실행하는 동안 global KV에서 선택한 항목도 읽습니다.
긴 prompt에서는 prefill에서 실행하는 (위치, 층) 칸 수가 약 절반으로 줄어듭니다(decoder 20층을 prompt 전체가 아닌 최근 구간에만 실행하므로). 이것은 KV 캐시가 아니라 prefill 계산을 줄이는 효과이고, 칸 수의 비율이지 시간의 비율도 아닙니다.
또 replay는 근사입니다. 최근 구간 첫 위치의 hidden을 정확히 얻으려면 그보다 앞 위치의 local KV도 필요한데, replay는 그 참조를 자릅니다. 이 절약은 prefill에만 해당합니다. 새 토큰을 생성하는 decode에서는 encoder와 decoder를 합친 40층을 모두 실행합니다.
이 실행 방식은 보고서가 설명한 것이며, 이 글에서 검토한 공개 참조 코드에는 따로 구현되어 있지 않습니다. CED는 CED 글에서 더 자세히 다뤘습니다.
V4.1-Flash의 KV 캐시 계산하기
global KV를 저장하는 층은 4개입니다. encoder의 Full 3층은 토큰 2개마다, decoder의 Full 1층은 토큰마다 entry를 하나씩 저장합니다. entry 하나는 main KV 512차원과 검색용 key 128차원입니다.
구조만 보면, 모두 BF16으로 저장하면 (3 ÷ 2 + 1) × (512 + 128) × 2 B = 3,200 B로 V4-Flash의 절반 정도입니다. 압축률은 오히려 낮아졌지만(4 → 2, 1), global KV를 저장하는 층이 41개(CSA 21 + HCA 20)에서 4개로 줄었기 때문입니다.
배포 형식에서는 main KV entry를 FP4로 저장합니다. 512차원 × 0.5 B = 256 B에, 16채널마다 FP8(E4M3) scale 1 B씩 32 B를 더해 288 B입니다. RoPE 부분도 함께 양자화합니다. 검색용 key는 V4와 같은 68 B입니다.
V4.1-Flash: (3 ÷ 2 + 1) × (288 + 68) B = 2.5 × 356 = 890 B (MHA의 약 1/4,418)local KV 캐시는 40층 모두 최근 128위치를 보관합니다. 배포 형식(RoPE 부분까지 512차원 모두 FP8, 32채널마다 UE8M0 scale, 토큰당 528 B)으로 40 × 128 × 528 B ≈ 2.7 MB입니다. 같은 근사로 토큰당 890 B와 비교하면, 둘이 비슷해지는 문맥 길이는 약 3,038토큰입니다. 그보다 짧은 문맥에서는 최근 위치를 보관하는 비용이 오히려 주된 저장량입니다.
읽는 양(그림 20의 오른쪽 그래프)은 attention이 읽는 KV가 약 8.3 MB, indexer가 읽는 key가 약 26.7 MB입니다. KV 읽기는 main KV 5.6 MB(entry당 288 B)와 local KV 2.7 MB(528 B)의 합입니다. 검색용 key는 encoder Full 3층이 N/2개씩, decoder Full 1층이 N개, Reindex 4층이 후보 16,384개씩 읽어, (3 × N/2 + N + 4 × 16,384) × 68 B입니다. KV를 공유해도 각 층은 attention을 계산하므로, 38개 CSA2 층이 각각 512개 main entry를 읽습니다. 저장량은 한 벌이지만 읽기는 층마다 일어납니다.
무엇을 줄였고 무엇이 남았나
다섯 모델을 다시 정리하면, 세대마다 서로 다른 요소를 줄였습니다.
| 모델 | 바뀐 것 | 줄인 요소 | 토큰당 KV (배포 형식, local KV 별도) |
|---|---|---|---|
| 가상 MHA | 기준 | — | 3,932,160 B (BF16 가정) |
| V2 | MLA | 저장 벡터의 폭 | 69,120 B (BF16) |
| V3.2 | DSA, FP8 KV | 읽는 위치 (구조상 저장은 늘어남) | 48,068 B |
| V4-Flash | CSA·HCA, K=V 공유 | 토큰 방향 압축(4개·128개를 하나로) | 3,514 B |
| V4.1-Flash | CSA2, FP4 KV (CED는 prefill 계산 감소) | global KV를 저장하는 층 수 | 890 B |
정밀도도 세대마다 함께 내려갔습니다. BF16에서 FP8, FP4로 가면서 같은 구조라도 저장량이 절반, 다시 절반 가까이 줄었습니다.
남는 비용도 분명합니다. 첫째, local KV 캐시는 최근 128위치가 찬 뒤에는 고정된 크기로 남고, 토큰당 증가량이 작아질수록 상대적으로 커집니다. 둘째, 위치를 고르는 비용입니다. 그림 1의 오른쪽 그래프에서 sparse 모델의 읽는 양은 대부분 검색용 key가 차지합니다. 셋째, 압축과 선택, CED의 replay에는 근사가 들어갑니다. 압축과 선택은 모델이 그 구조로 학습되고, replay는 prefill을 실행하는 방식의 근사입니다. 어느 쪽이든 MHA와 같은 품질을 낸다고 가정할 수는 없고, 품질은 보고서의 평가로 판단해야 합니다.
마지막으로, 저장량이 1/4,400이 되었다고 decode가 4,400배 빨라지는 것은 아닙니다. 실제 속도는 계산량, 커널 구현, 메모리 배치, 배치 크기에 따라 달라집니다.
출처
모델 구조와 보고서
- DeepSeek-V2 보고서 §2.1. 가상 MHA는 표 1의 attention 방식별 저장량 비교와 같은 방식으로 계산했습니다. 초록의 “KV 캐시 93.3% 감소”는 DeepSeek 67B와의 비교라서 이 글의 배수와 다릅니다. https://arxiv.org/abs/2405.04434
- DeepSeek-V3.2 공식 추론 코드(Indexer, KV 캐시). decode에서는 흡수(②) 경로를 씁니다. https://huggingface.co/deepseek-ai/DeepSeek-V3.2/tree/main/inference
- DeepSeek-V4 보고서 §2.3, §4.2.1과 V4-Flash config: https://arxiv.org/abs/2606.19348 · https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash
- DeepSeek-V4.1-Flash 보고서 §2.2–2.4, §3.2.2, §4.2.1과 config. 초록의 global KV 캐시 890 B/토큰은 본문의 계산과 같습니다. 계층형 indexer는 보고서가 후속 학습에서 도입한 구조입니다. 그림 26·27의 CED와 bounded replay도 보고서의 실행 방식이며, 이 글에서 검토한 공개 참조 코드에는 이 실행 경로가 따로 구현되어 있지 않습니다. https://arxiv.org/abs/2609.19969
저장량 계산에 쓴 캐시 형식
- V3.2 주 KV: FlashMLA의 FP8 KV cache 형식(토큰마다 FP8 값 512 B, scale 16 B, RoPE 128 B, 추가 패딩 없음). https://github.com/deepseek-ai/FlashMLA/blob/ba89a3466e9470ad08ab39738d4e7bb66989e1e7/README.md#fp8-kv-cache
- V3.2 검색용 key: SGLang IndexKeyCache(64토큰 페이지에 값과 scale을 나눠 8,448 B). HF 참조 코드는 CKV를 BF16 버퍼에 두므로, 그 코드대로 계산하면 61 × (1,152 + 132) = 78,324 B입니다. https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/mem_cache/index_key_cache.py
- V4·V4.1: SGLang의 DeepSeek-V4 커널 형식과 메모리 풀(V4 584 B·페이지 정렬, V4.1 FP4 288 B, 검색용 key 68 B). 엔진과 옵션에 따라 형식이 다를 수 있습니다. V2도 FP8 KV 옵션으로 배포할 수 있고, V4에는 RoPE까지 FP8로 저장하는 TensorRT-LLM 경로도 있습니다. https://github.com/sgl-project/sglang/blob/main/python/sglang/kernels/ops/attention/dsv4/kv_layout.py · https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/mem_cache/deepseek_v4_memory_pool.py
읽는 양 계산
- 각 층이 attention에 쓰는 KV와 위치 선택에 필요한 검색용 key를 한 번씩, 저장량과 같은 배포 캐시 형식으로 계산한 읽는 양입니다. scale과 캐시 항목 안의 패딩을 포함합니다. 접기의 BF16 값은 같은 항목 수에 BF16 크기를 적용했습니다. V3.2 참조 코드의 주 attention과 V4.1 참조 코드의 Reindex는 전체 점수를 계산한 뒤 마스크를 적용하므로, 그 코드의 실제 접근량과는 다릅니다.